Program dnia
- 09:30 – Malte Landwehr: ChatGPT Shopping: Lessons from 1M Products
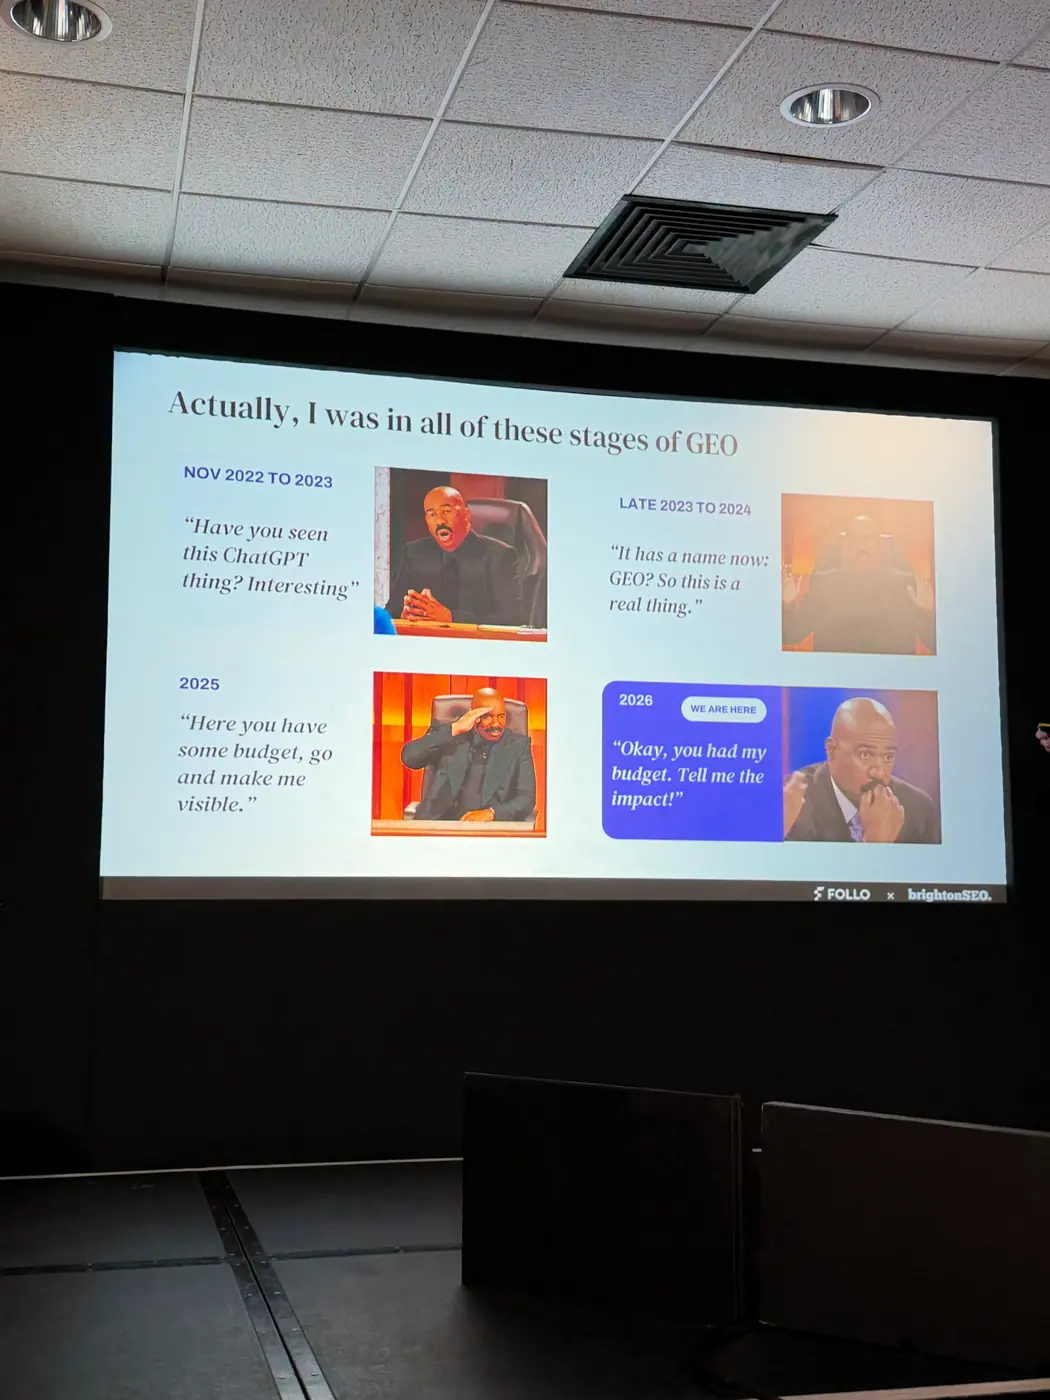
- 09:50 – Stijn Bergmans: 7 Tactics for Agentic Search and Shopping
- 10:10 – Greta Koivikko: PDPs Over PLPs
- 10:30 – Adam Preston: The Biggest Factors in AI Visibility for Retailers
- 11:20 – Chris Willow: Building an Agency Like a SaaS
- 11:40 – Tanya Kant: AI Literacy: What It Is and Why Your Workforce Needs It
- 12:00 – Vishal Mahida: Selling GEO: What Clients Actually Want and How to Close the Deal
- 12:20 – Eilish Hughes: We Didn’t Build a GEO Team
- 14:00 – Michael Holloway: Stop Teaching Juniors to Audit Like Robots
- 14:20 – Chima Mmeje i Anu Ramani: Write With AI / Big Idea Content Strategy
- 14:20 – Vittoria Rinaldi: Ecommerce Tech SEO Audits 2026
- 15:30 – Jess Atkinson: SERP Psychology
- 15:50 – Chloe Blades: The Algorithm Got You Seen, Psychology Gets You Remembered
- 16:10 – Giulia Panozzo: Decision Distance
Malte Landwehr: ChatGPT Shopping: Lessons from 1M Products
09:30
Streszczenie
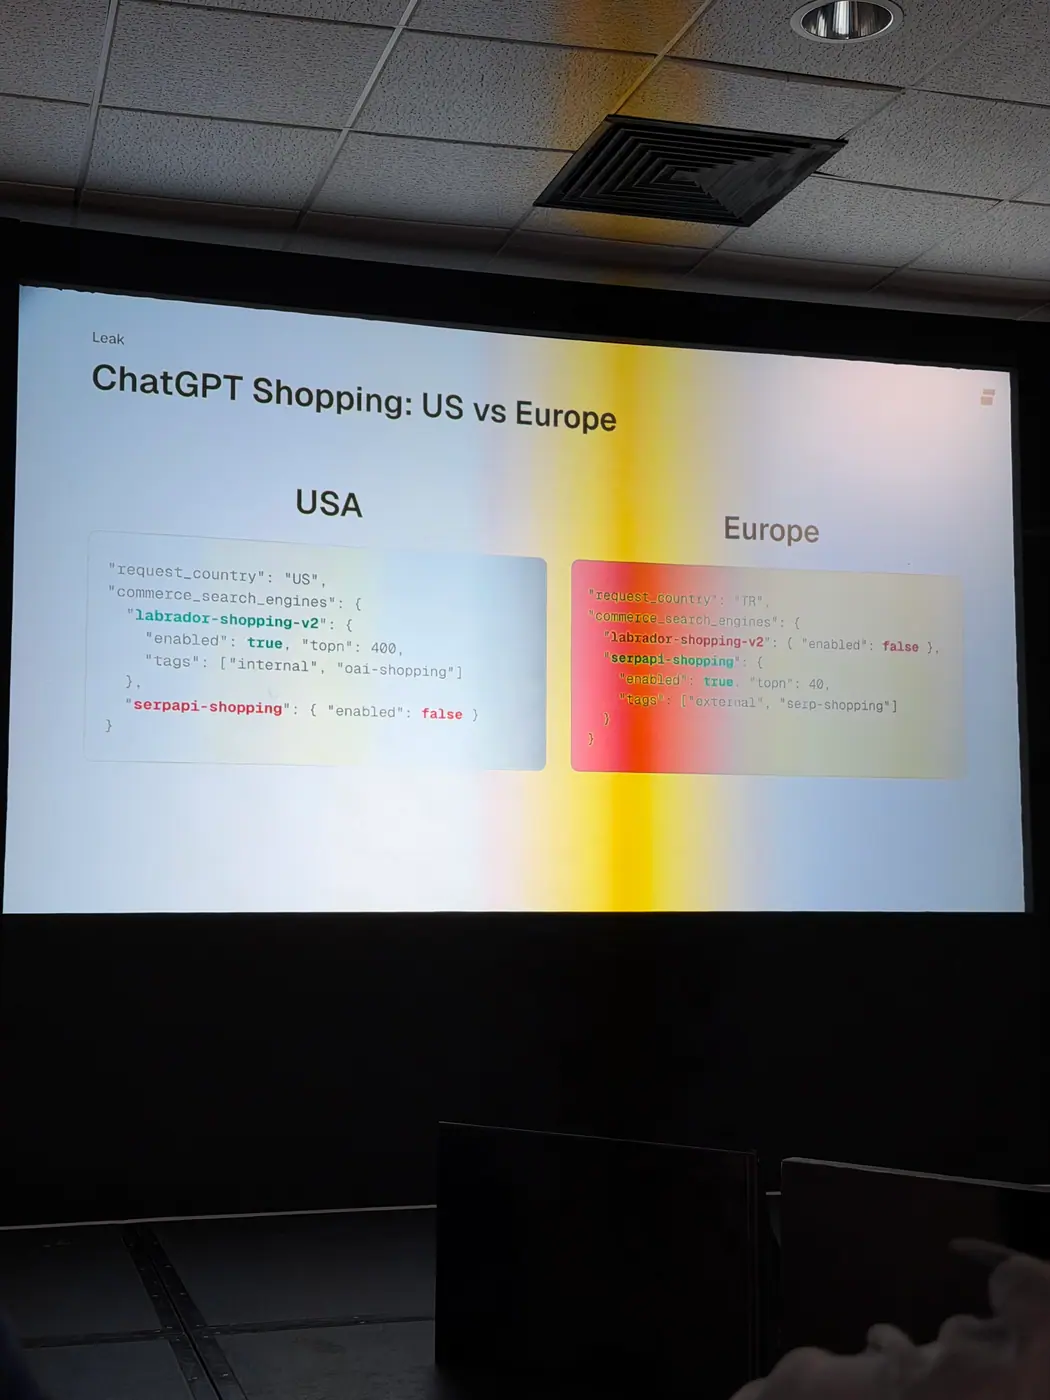
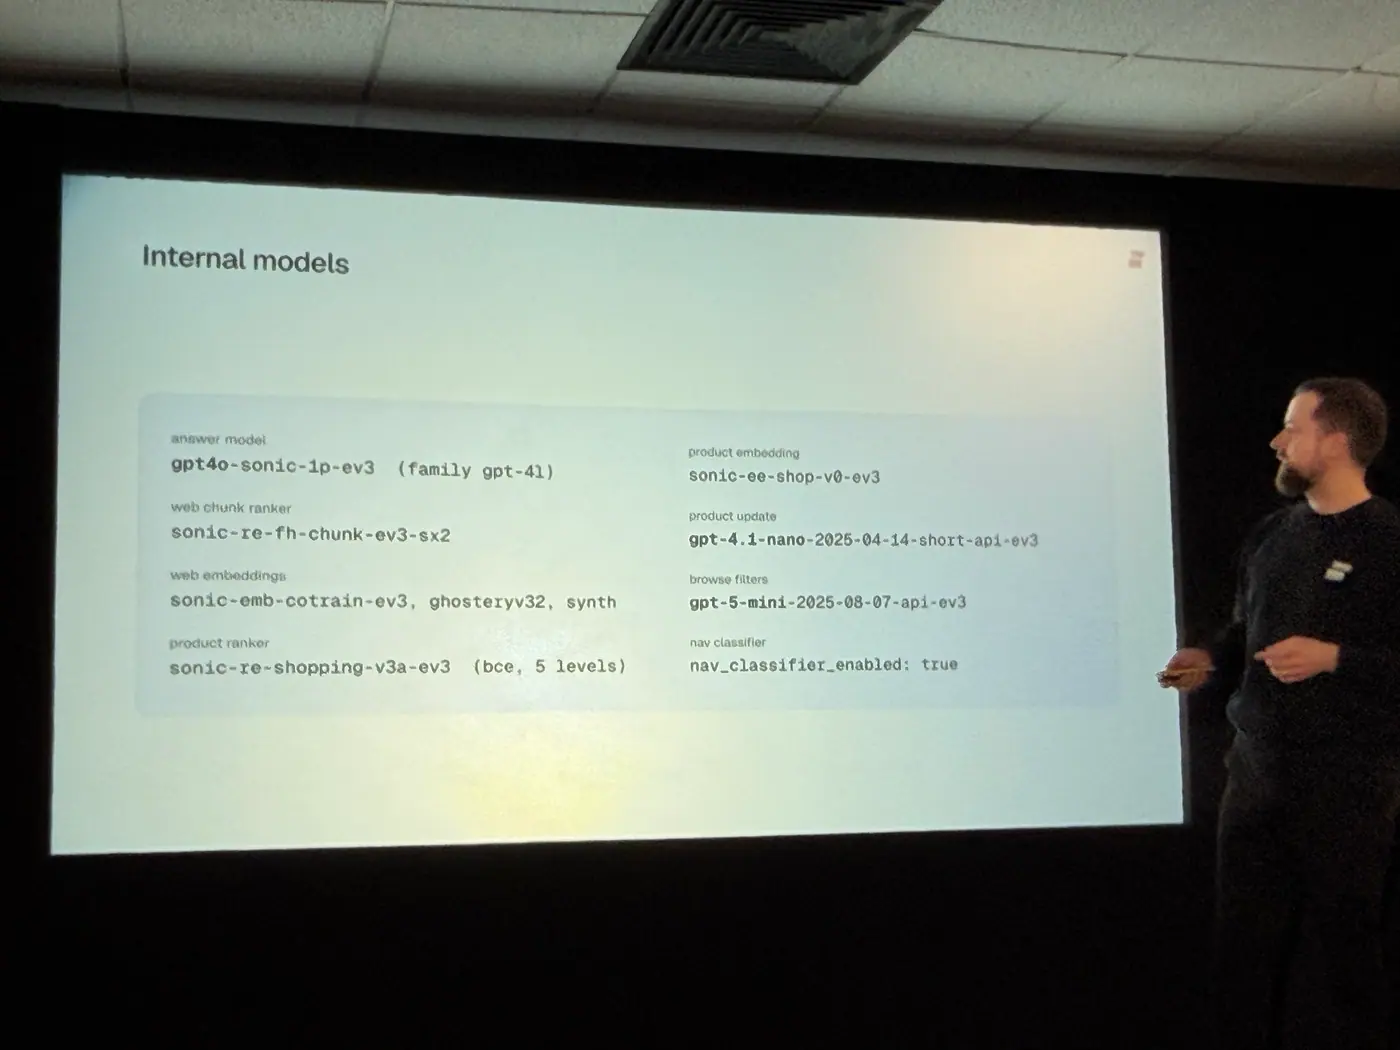
Na brightonSEO 9 października 2026 r. Malte Landwehr przedstawił dwa różne mechanizmy działania ChatGPT Shopping. W opisywanym przez niego systemie Europa korzystała z wyników Google Shopping, a Stany Zjednoczone z własnego indeksu Labrador i feedów, czyli ustrukturyzowanych danych produktowych.
Prelegent połączył analizę mechanizmu pobierania produktów z badaniem źródeł wykorzystywanych w odpowiedziach zakupowych. Pokazał, jak na widoczność wpływały dane produktowe, status sprzedawcy, szczegółowość pytania oraz obecność marki w zapytaniach pomocniczych.
Najważniejszy wniosek: obecność produktu w karuzeli, wskazanie sklepu jako sprzedawcy i cytowanie strony w odpowiedzi to trzy różne rodzaje widoczności. Wymagają osobnego pomiaru i innych działań.
Najważniejsze wnioski
Rynek decydował o sposobie pozyskiwania produktów. W Europie system łączył wyniki kilku zapytań do Google Shopping, pobierając je naprzemiennie z kolejnych list. W Stanach Zjednoczonych korzystał z feedów, oceny dopasowania tekstowego i semantycznego oraz weryfikacji sprzedawców.
Dostępność danych nie gwarantowała wyświetlenia produktu. W analizowanym amerykańskim przykładzie brak statusu zweryfikowanego sprzedawcy eliminował ofertę. Jeden sklep dostarczył 25 produktów do listy kandydatów, ale żaden nie znalazł się w końcowym wyniku. Landwehr powiązał to z niskim zaufaniem do sklepu.
Feed wymagał innego podejścia niż struktura stron sklepu. Prelegent rekomendował przekazywanie każdego rzeczywistego wariantu produktu osobno. Argumentował, że zwiększało to obecność oferty na etapie selekcji kandydatów. Nie była to rekomendacja tworzenia osobnych stron dla każdego rozmiaru.
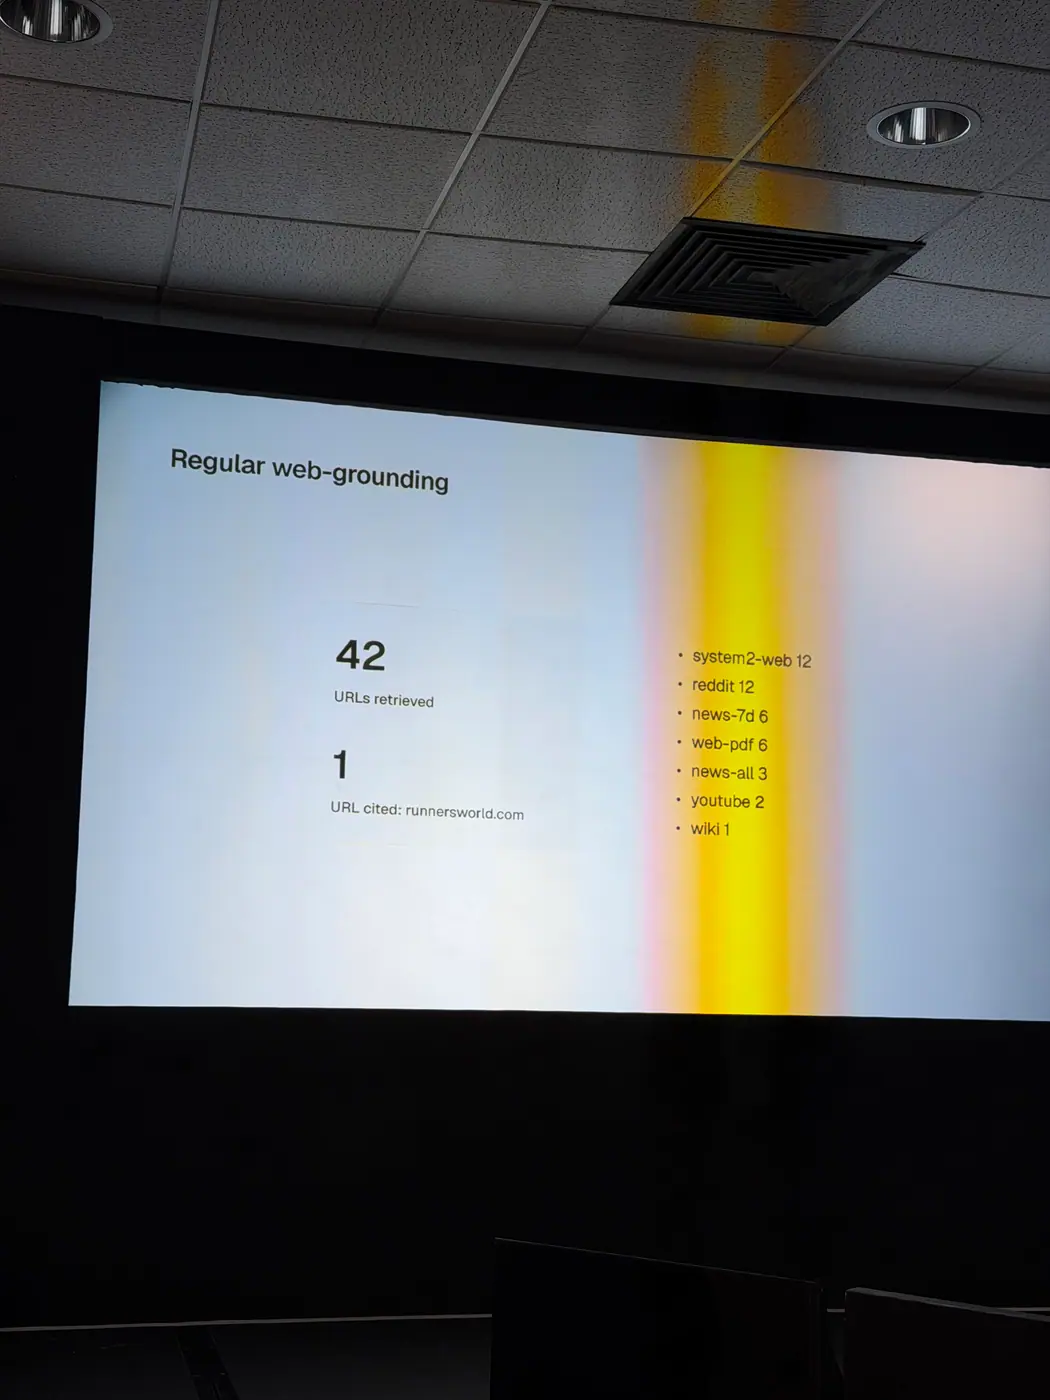
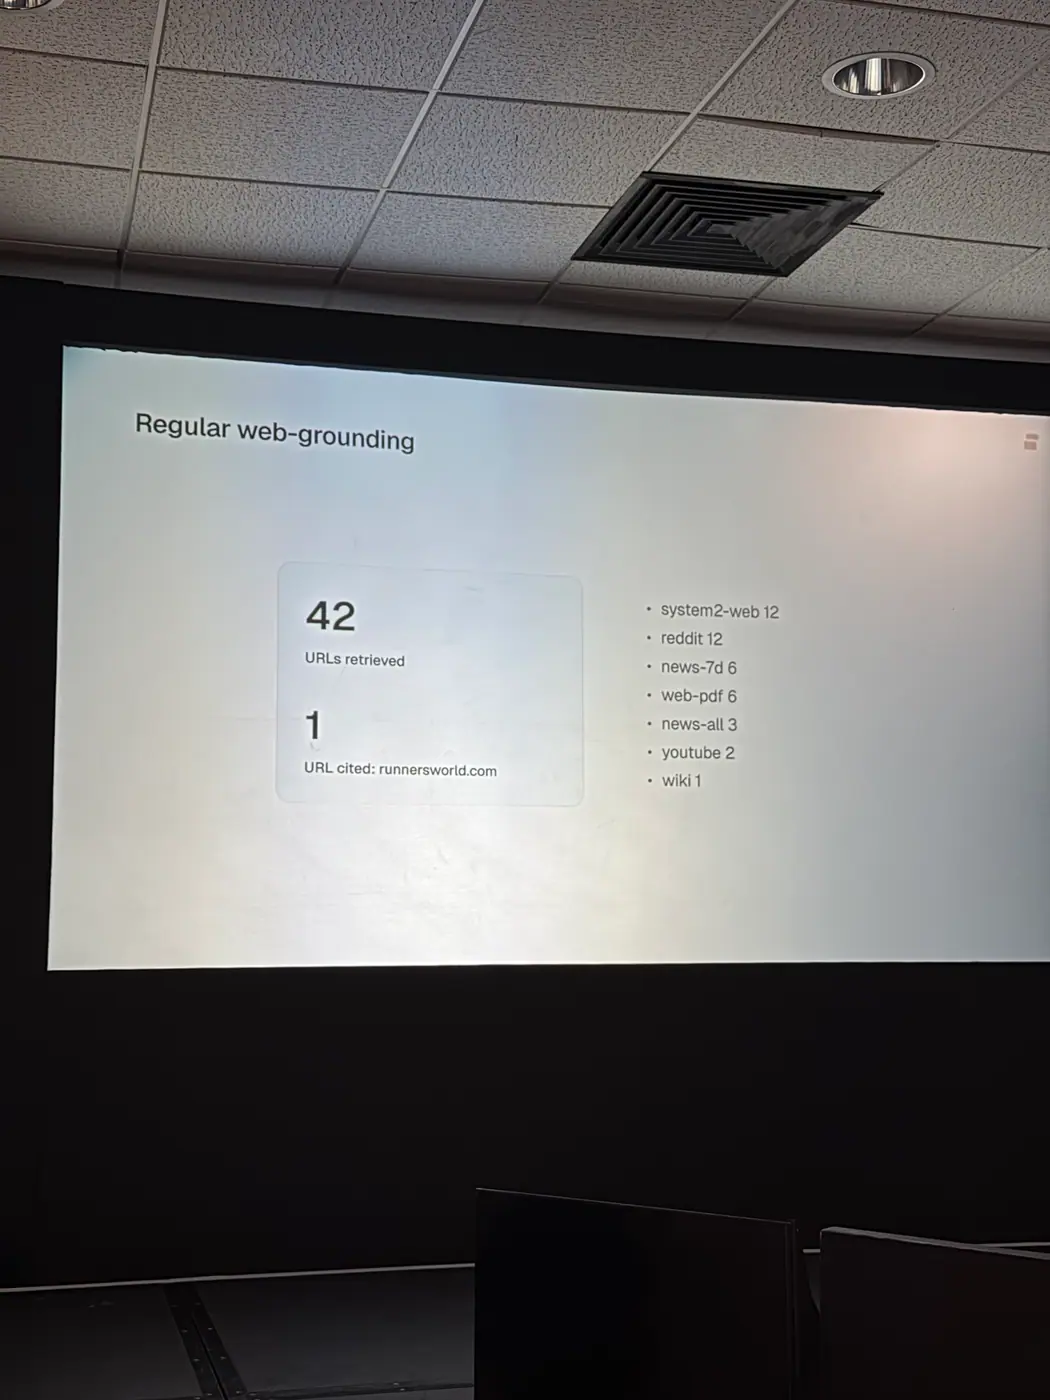
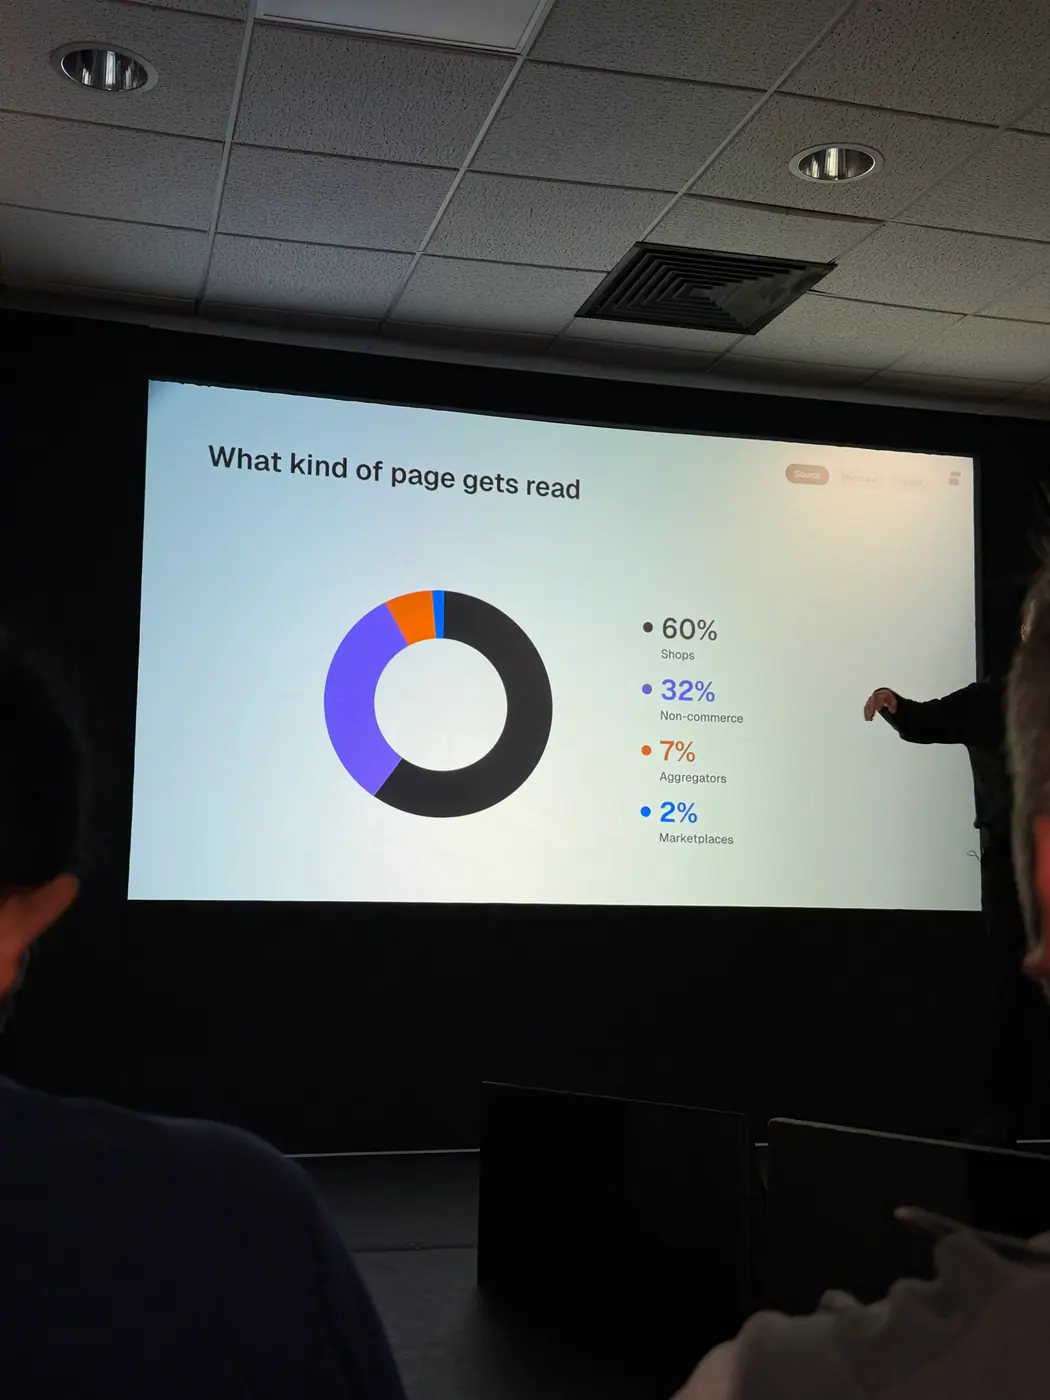
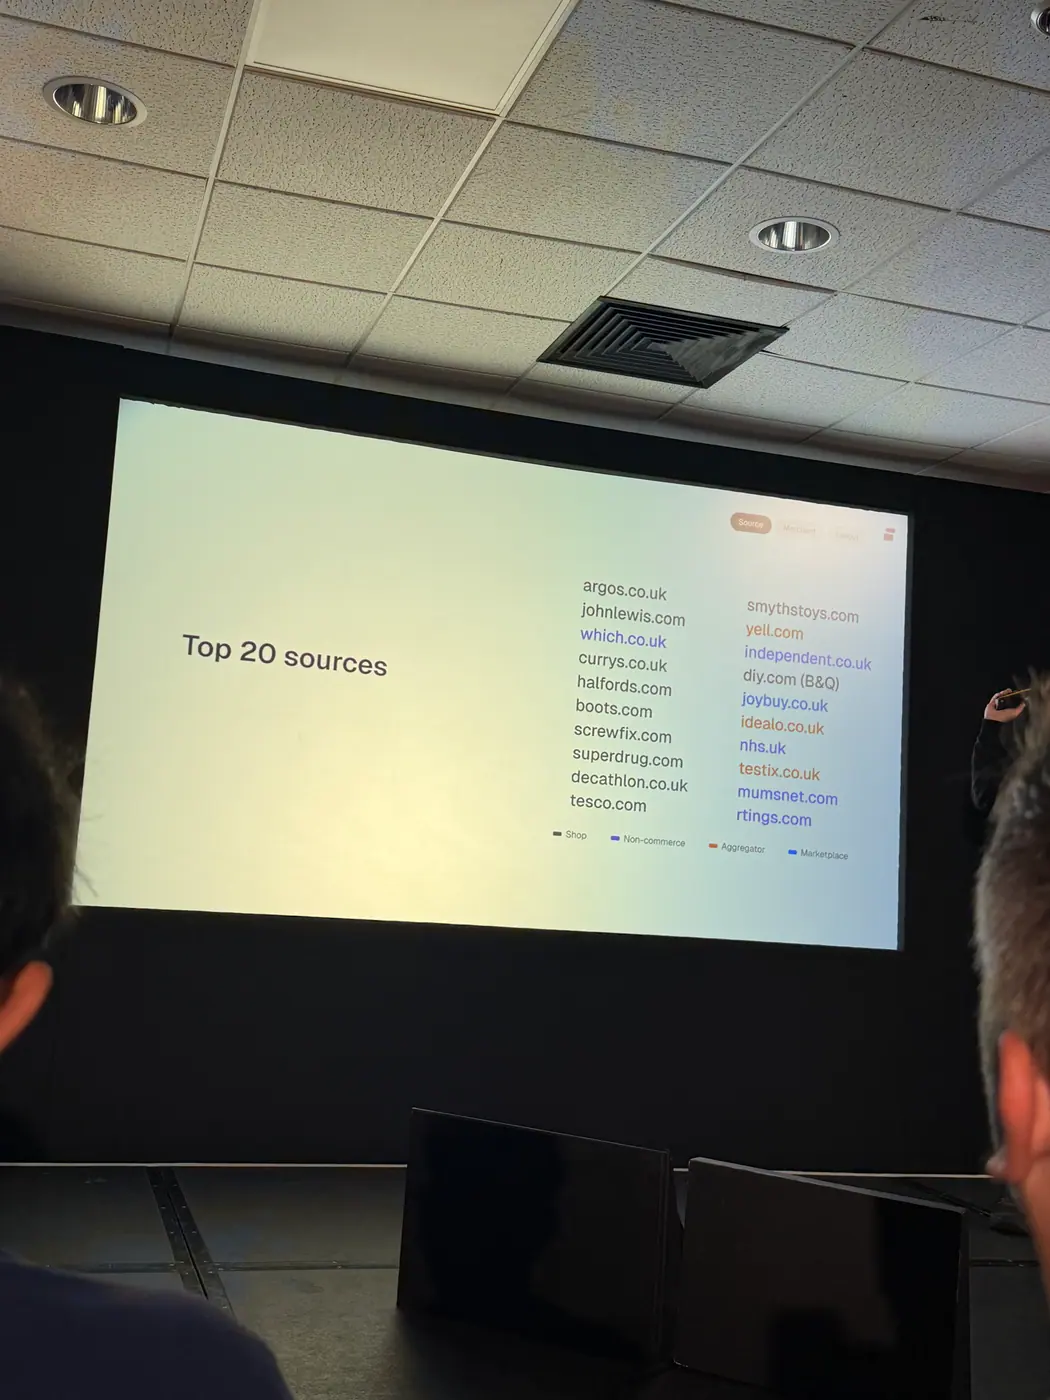
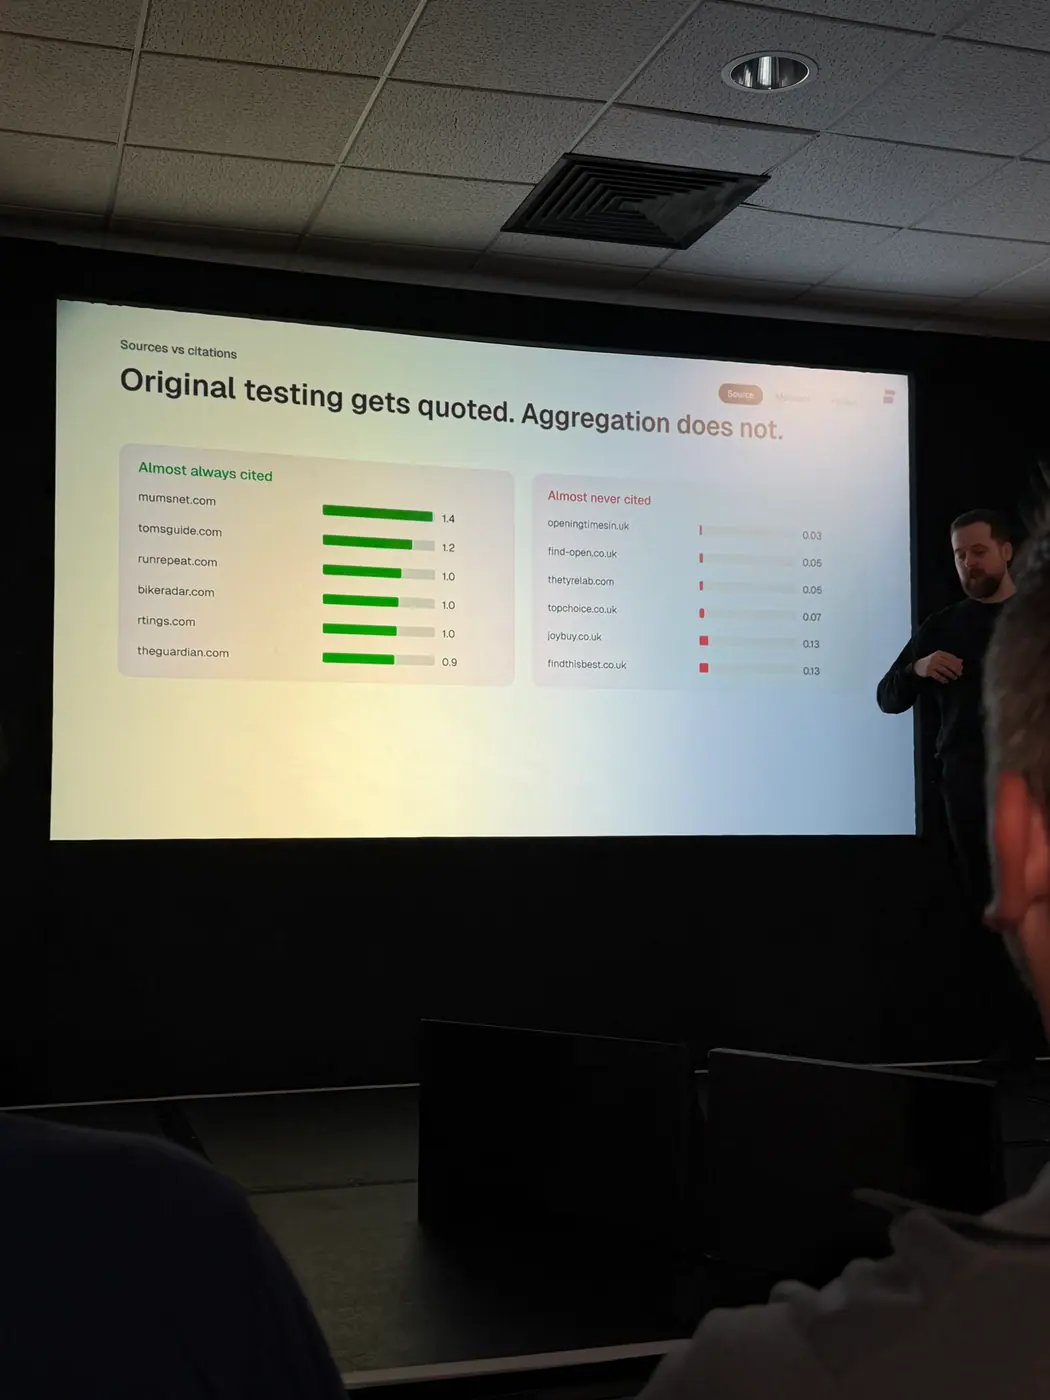
Źródło pobrane przez system nie musiało zostać zacytowane. W danych z Wielkiej Brytanii sklepy dominowały wśród dodatkowych źródeł odpowiedzi. Jednak strony niebędące sklepami, jeśli już trafiały do źródeł, częściej otrzymywały cytowanie w tekście. Platformy handlowe i agregatory były rzadziej pobierane, a następnie rzadziej cytowane.
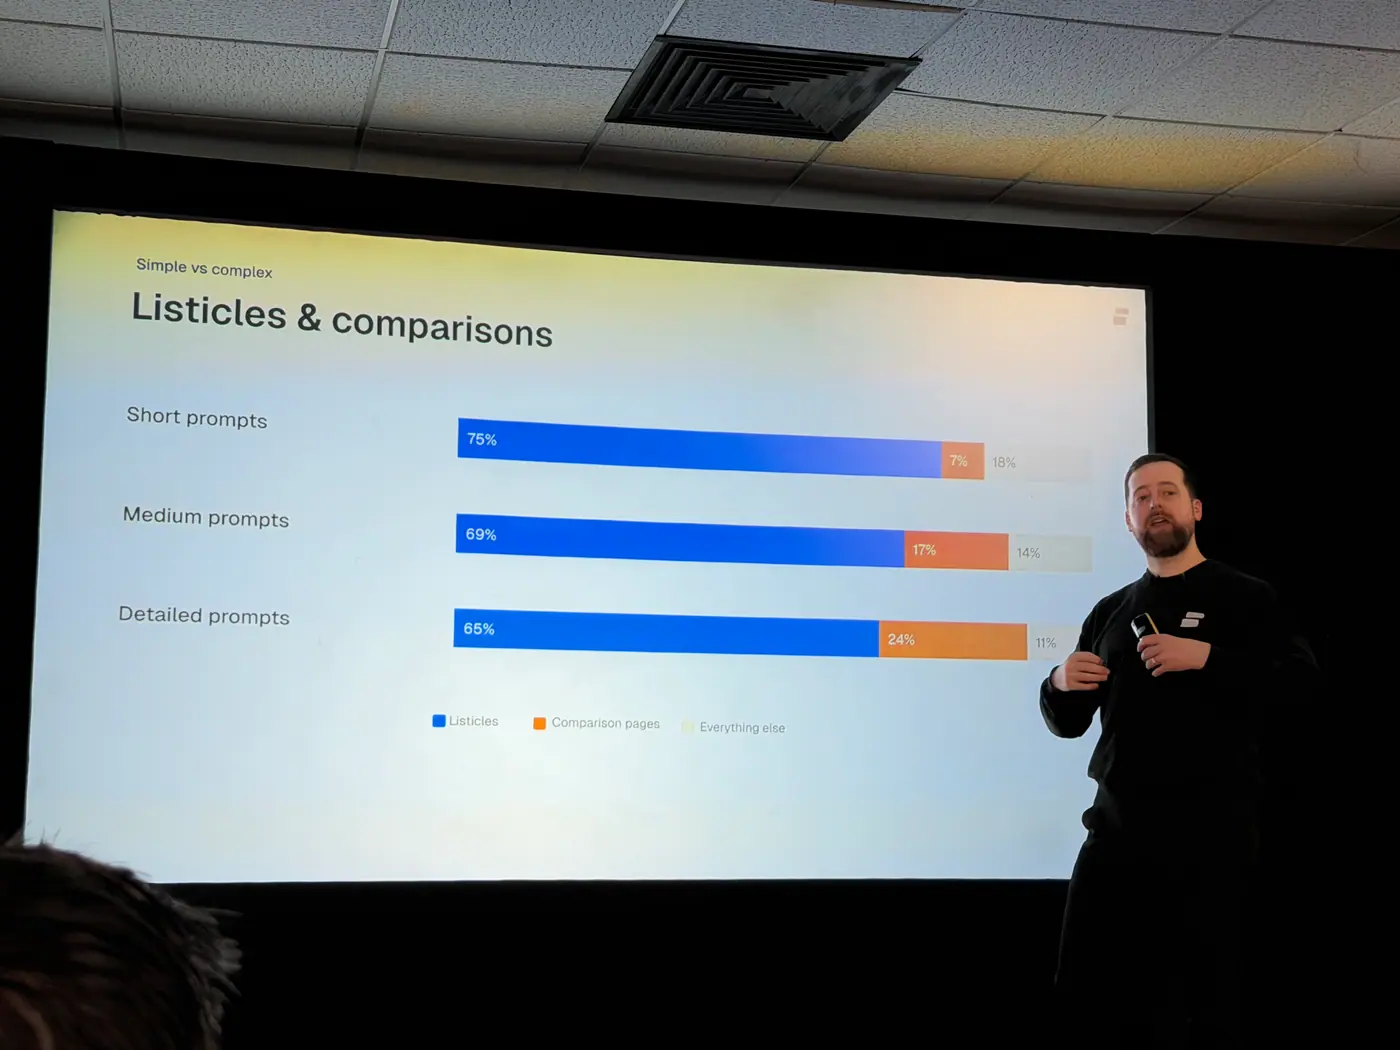
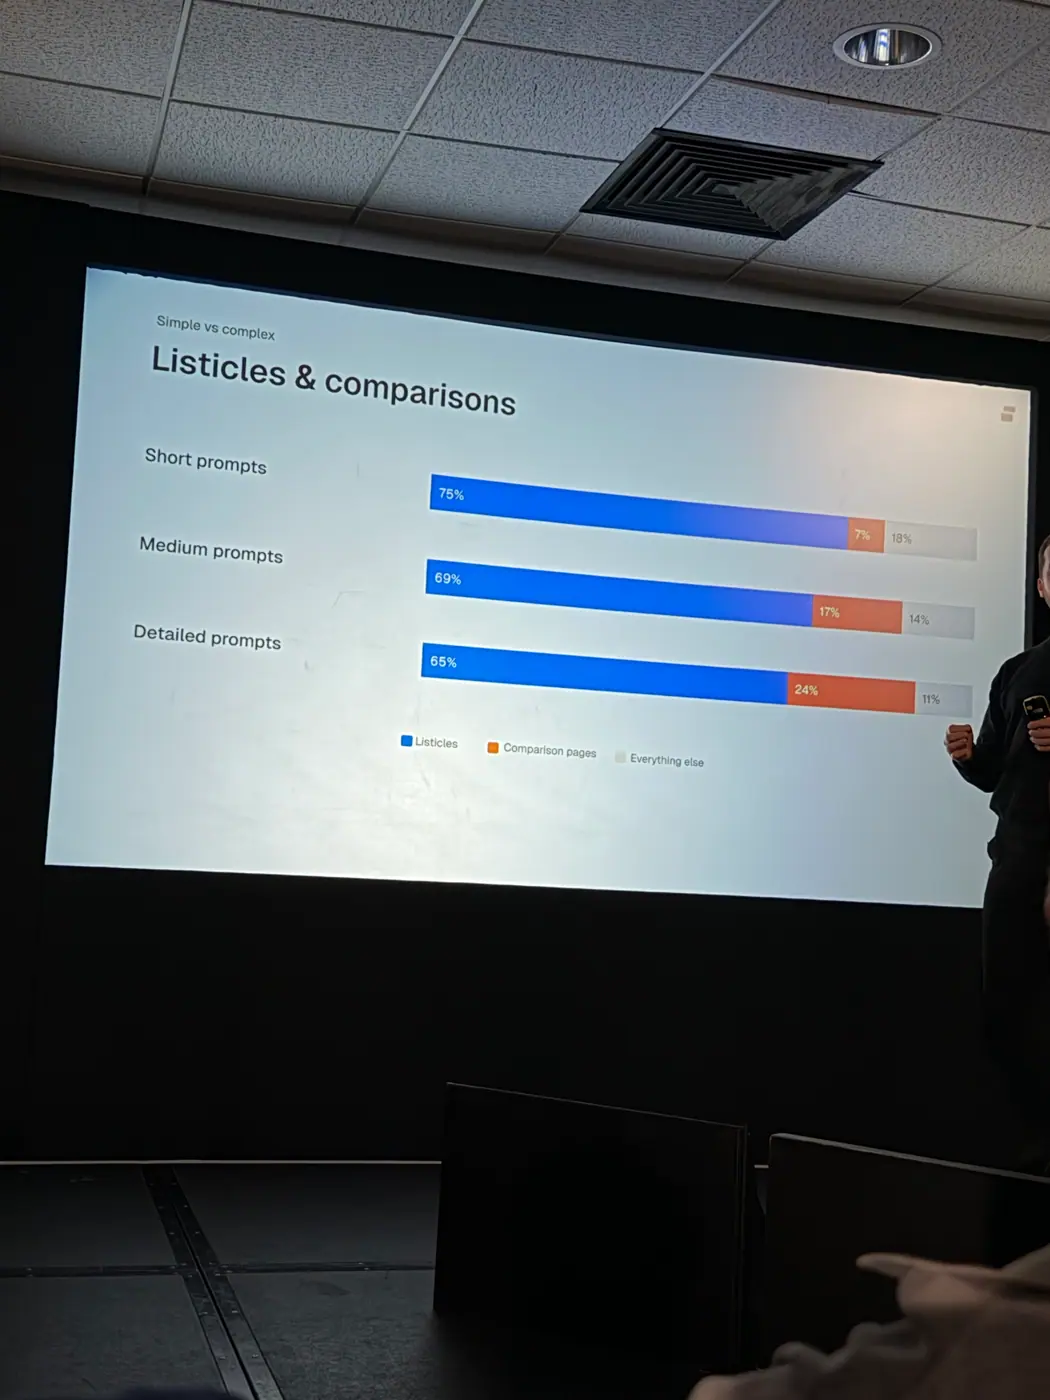
Szczegółowość pytania zmieniała zestaw przydatnych treści. W amerykańskim teście wraz z uszczegóławianiem promptów malał udział sprzedawców w źródłach. Zyskiwały porównania, a traciły ogólne artykuły listowe. Osobno, w analizie zmian w czasie, Landwehr odnotował wzrost udziału stron produktowych i spadek udziału zestawień, które nadal pozostawały ważnym formatem.
Marka mogła uzyskać przewagę jeszcze przed wyborem źródeł. W zapytaniach zakupowych marki częściej niż sprzedawcy trafiały do fan-out queries, czyli zapytań pomocniczych rozwijających pytanie użytkownika. Nazwy sprzedawców pojawiały się przede wszystkim przy pytaniach o miejsce zakupu.
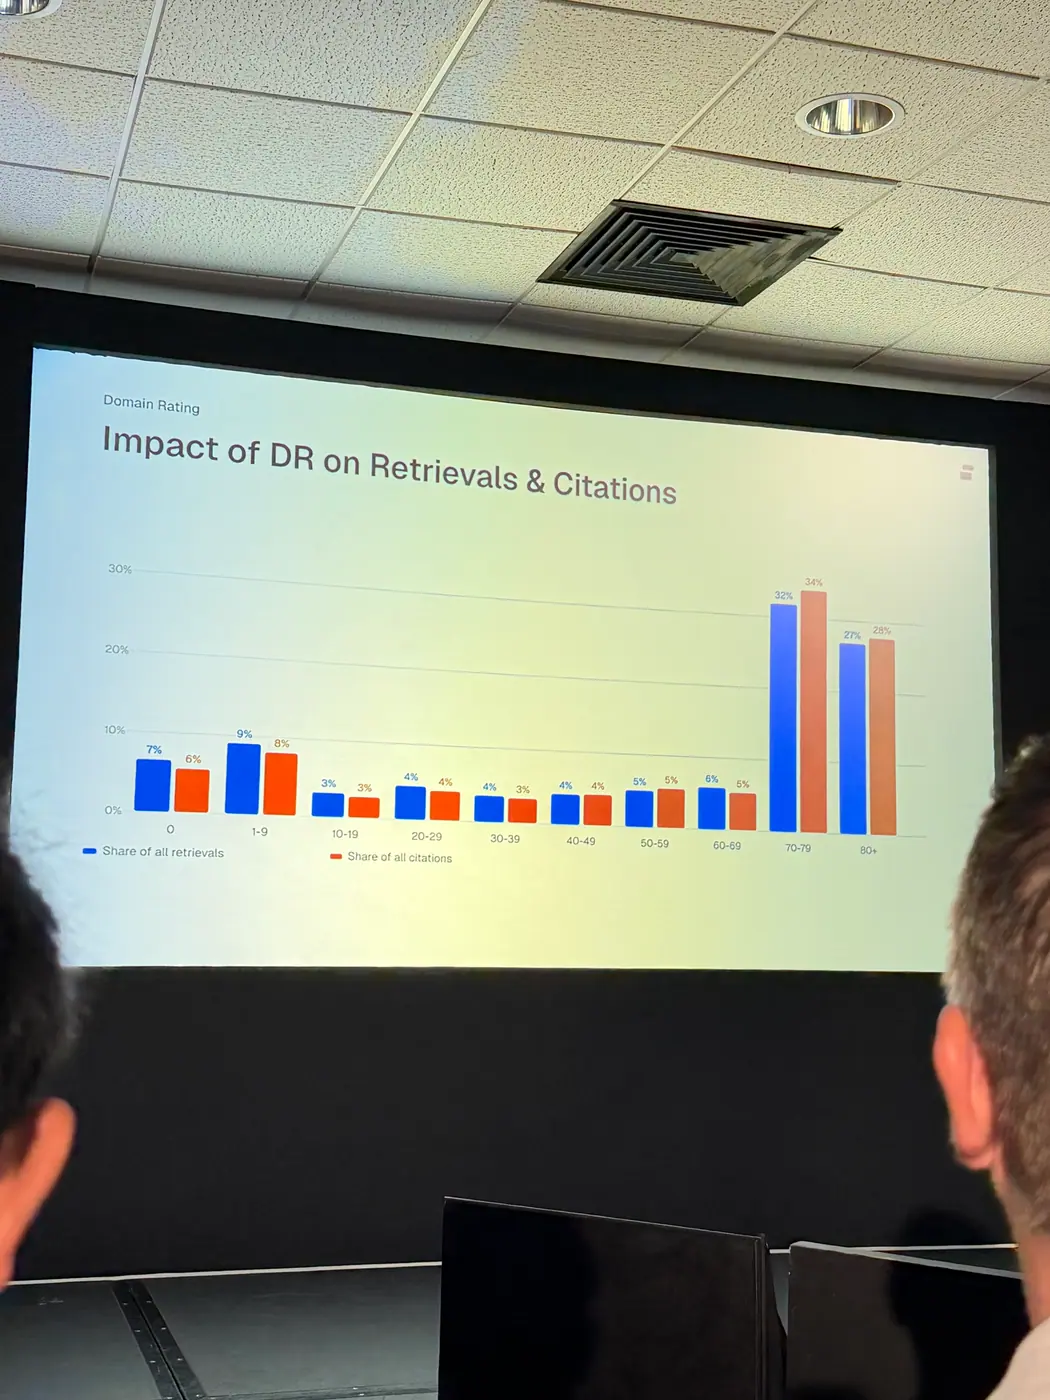
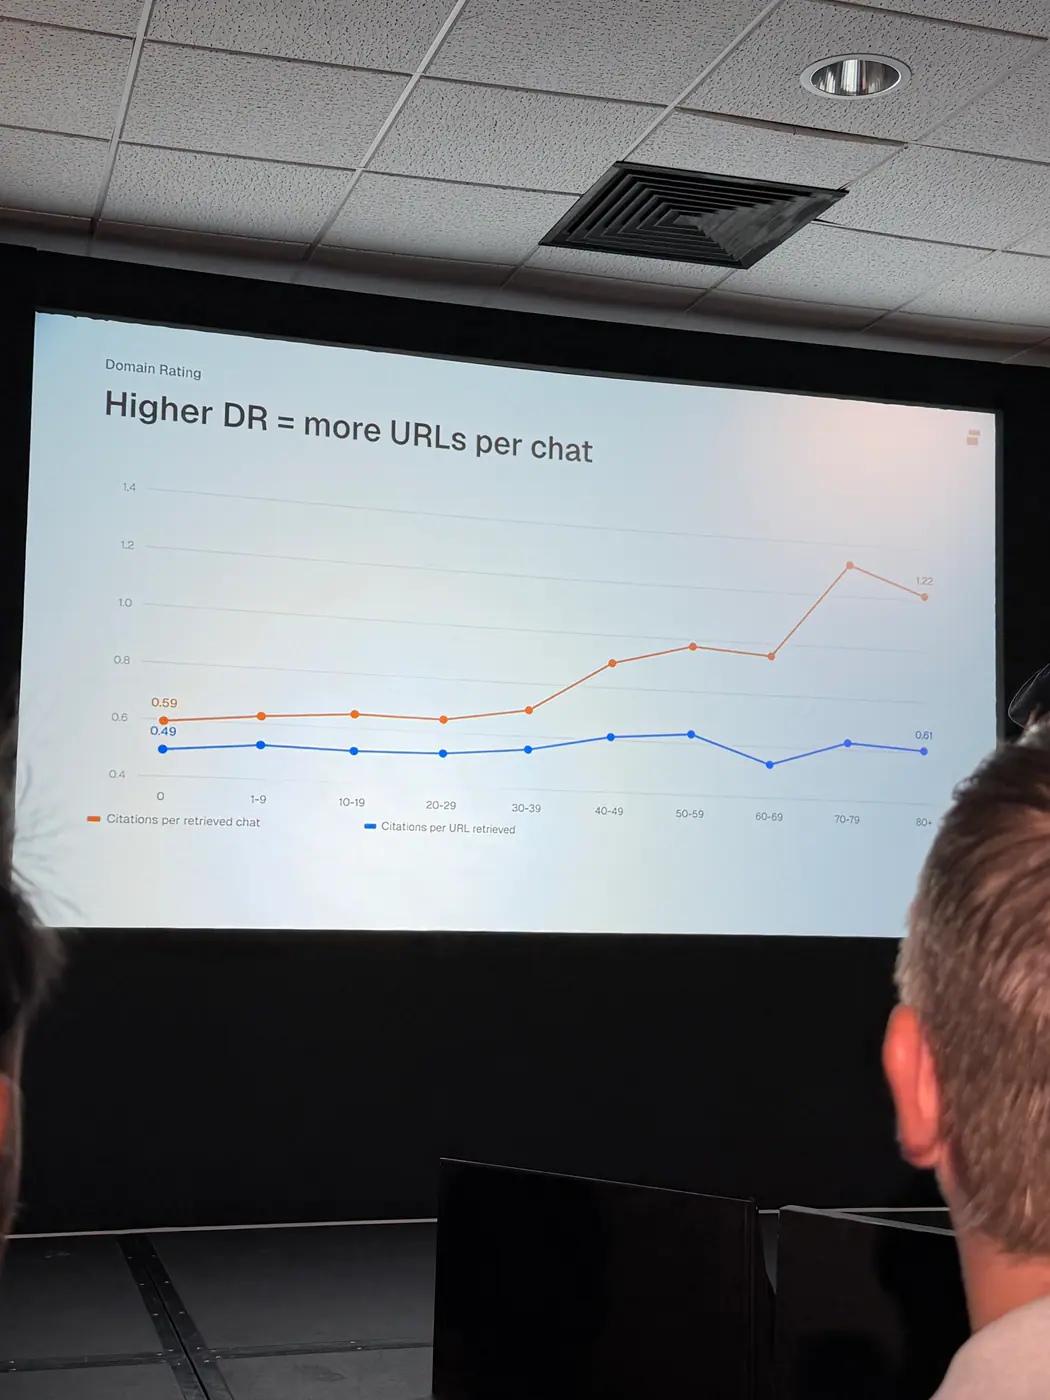
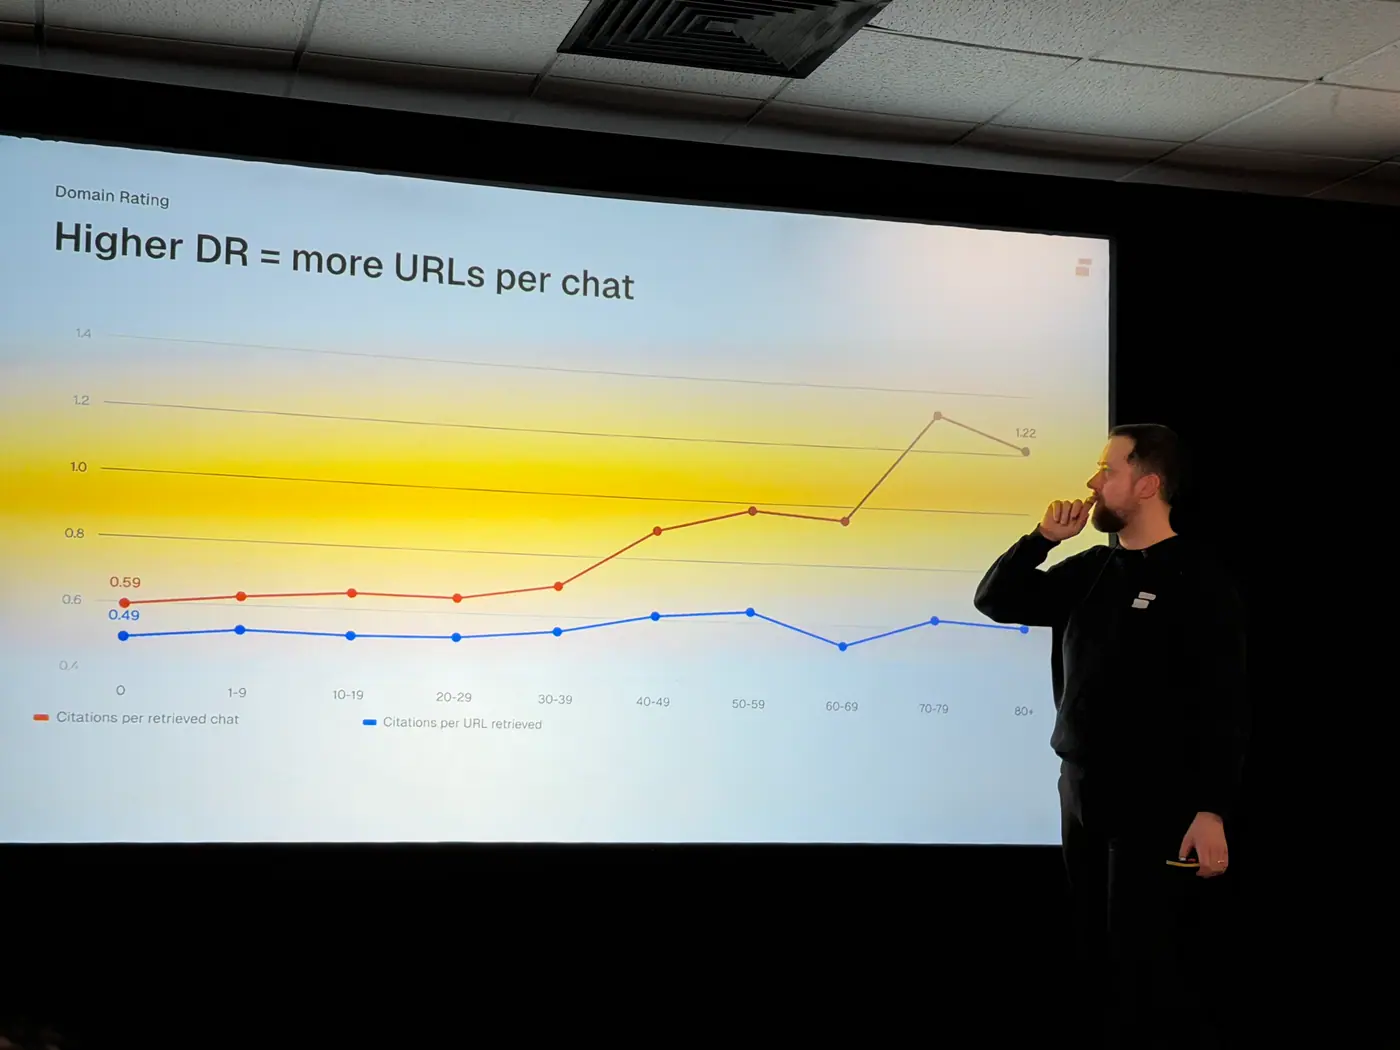
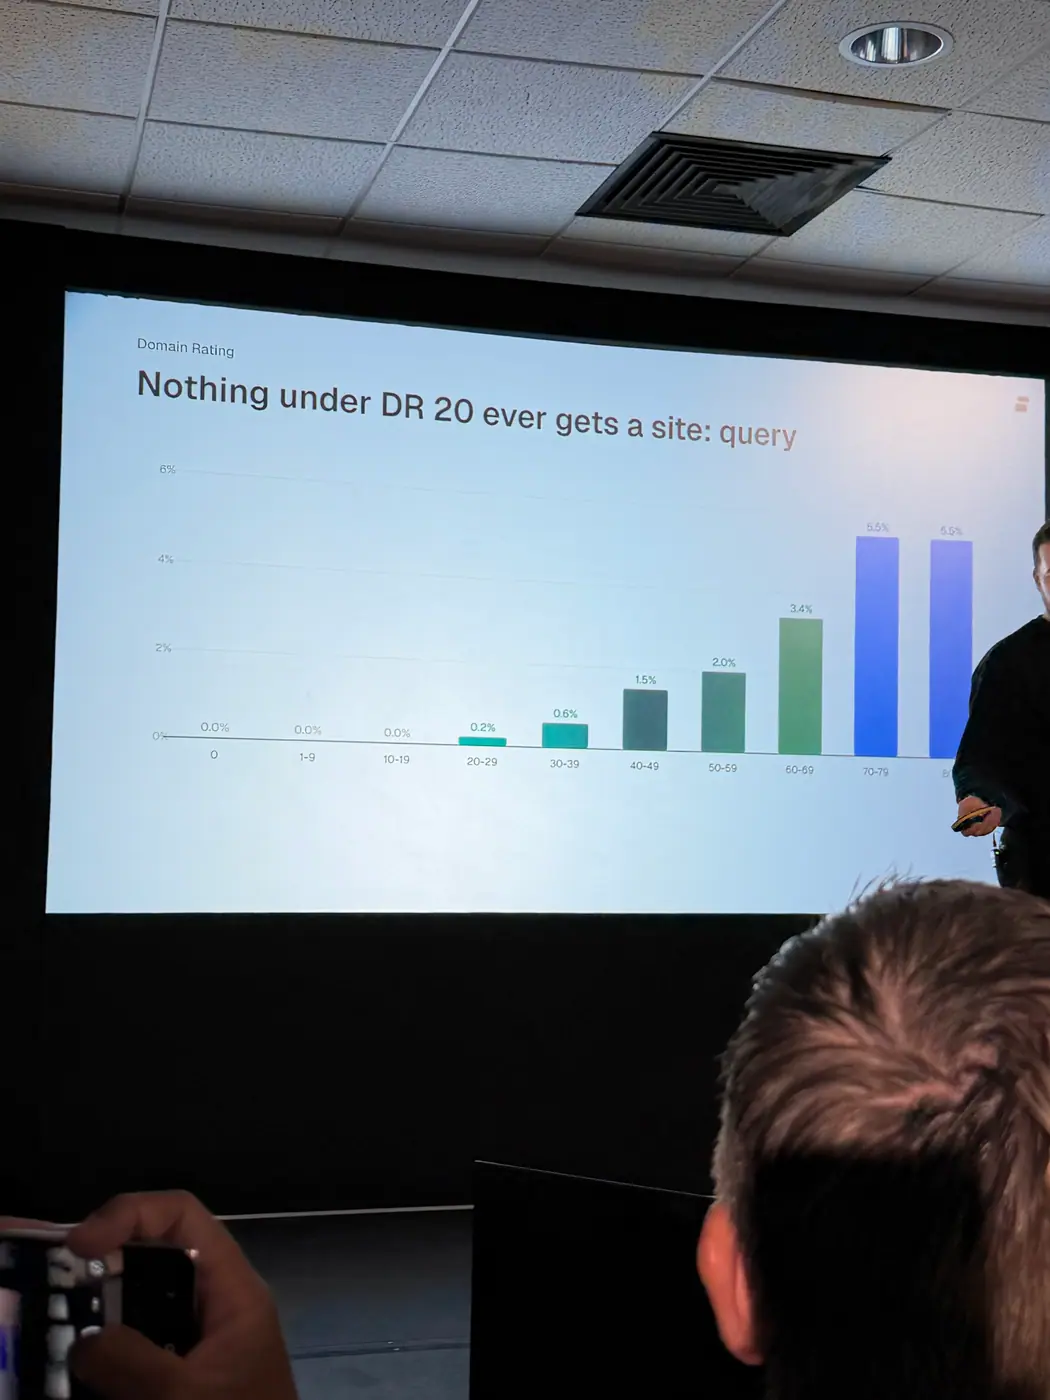
Wysoki wskaźnik domeny nie wyjaśniał całej przewagi w cytowaniach. Domeny z wysokim DR (Domain Rating / wskaźnik siły profilu linków domeny w Ahrefs) miały więcej stron wśród pobranych źródeł. Po przejściu na poziom pojedynczej strony różnice w szansie cytowania były znacznie mniejsze.
Prognozy należało oddzielić od wdrożeń. Landwehr przewidywał, że ewentualne przejście Europy na Labrador mogłoby istotnie zmienić układ widoczności. W amerykańskim kodzie wskazał również test A/B „No Amazon”, sprawdzający wariant zakupów bez wyników tej platformy. Był to test, nie ogłoszona zmiana całej usługi.
Dane liczbowe i przykłady
| Obszar | Dane przedstawione przez prelegenta |
|---|---|
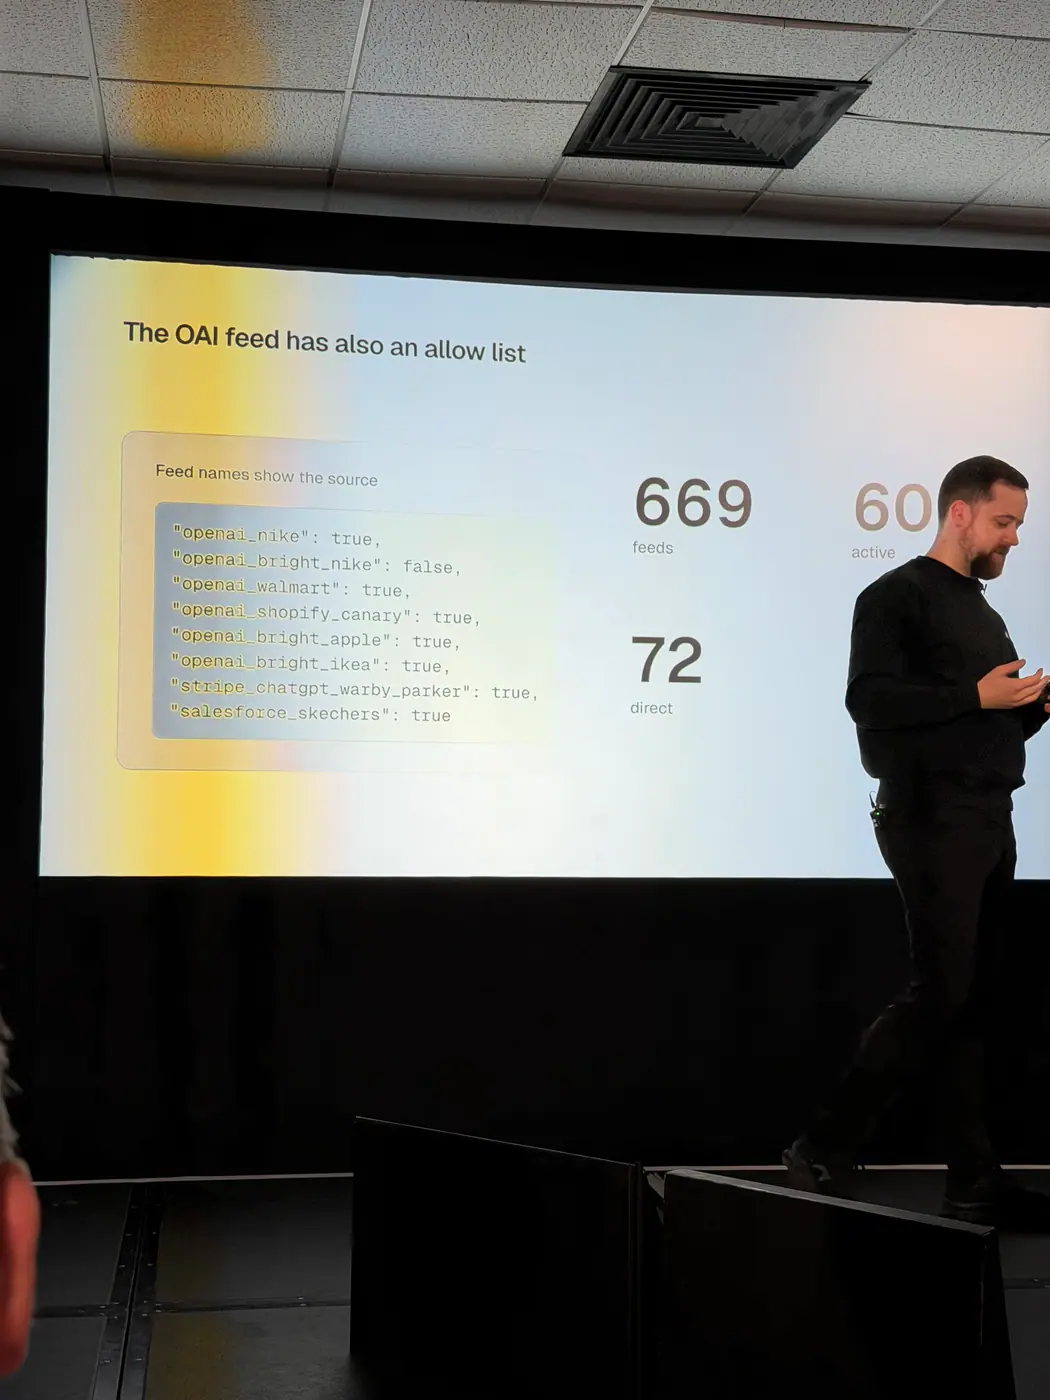
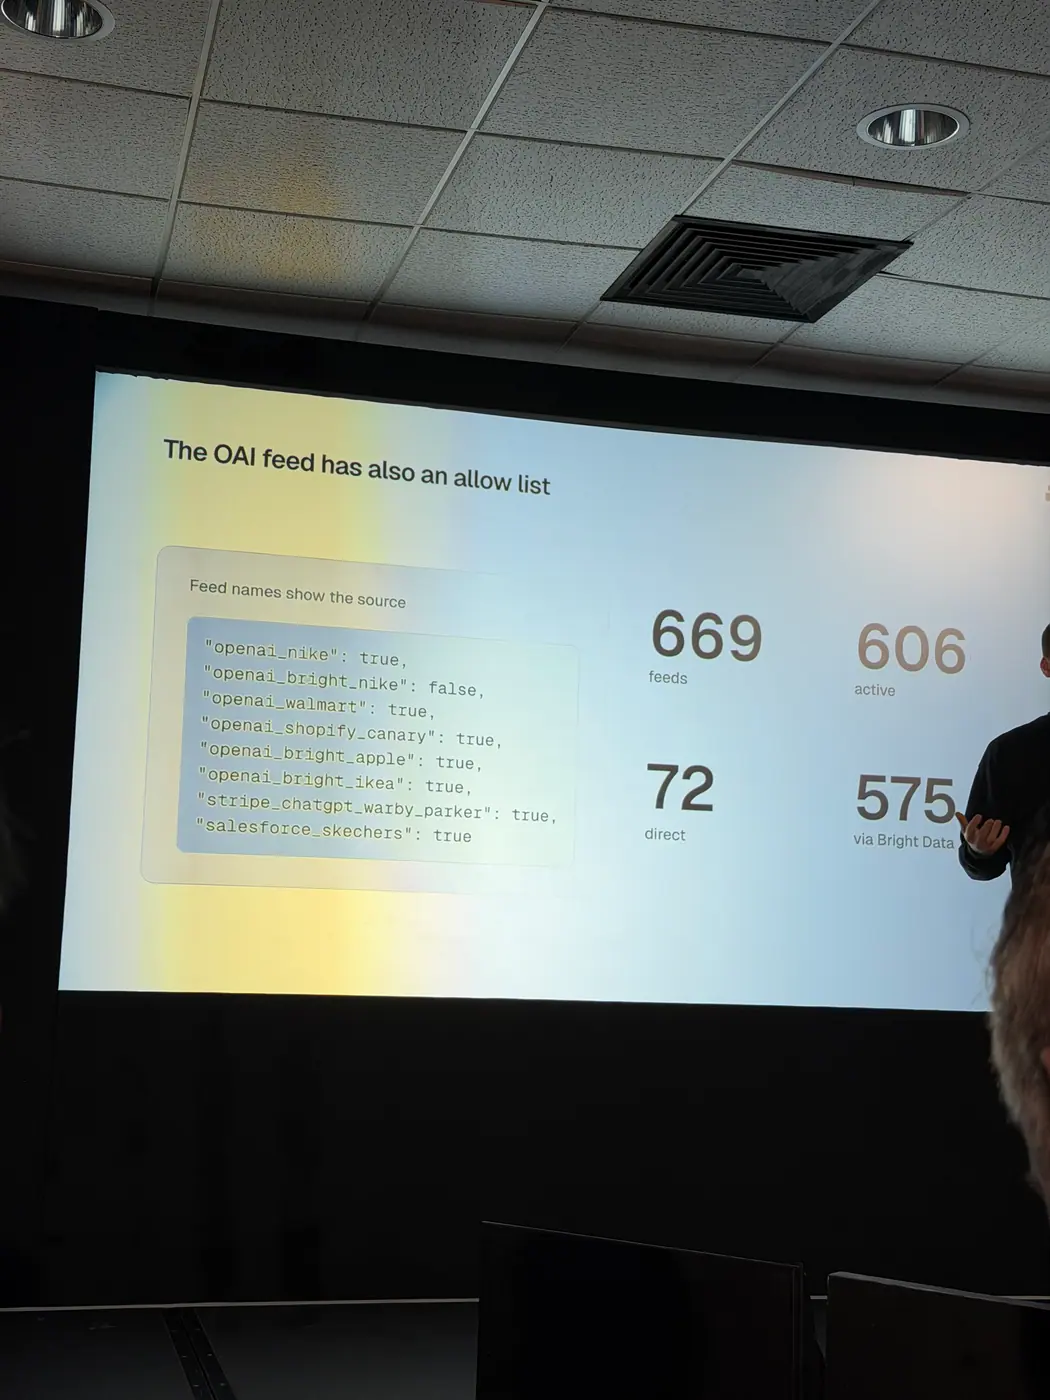
| Feedy w Stanach Zjednoczonych | 669 feedów, z czego 606 aktywnych. Około 70 bezpośrednich partnerstw i około 500 feedów pozyskiwanych przez scraping. Był to stan obserwowany kilka tygodni przed wystąpieniem. |
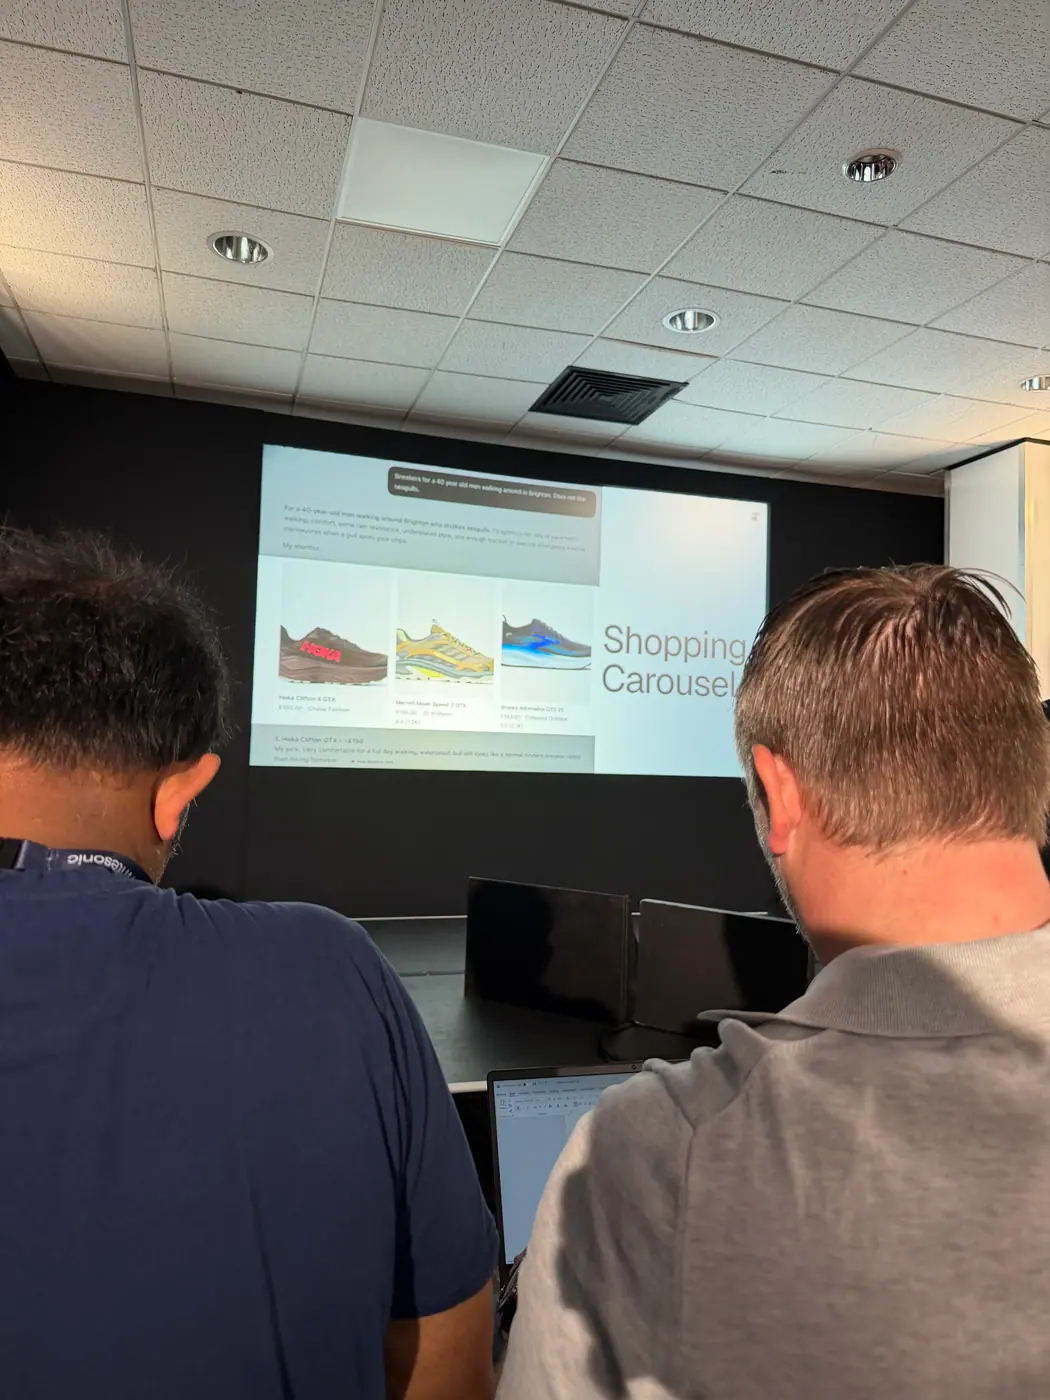
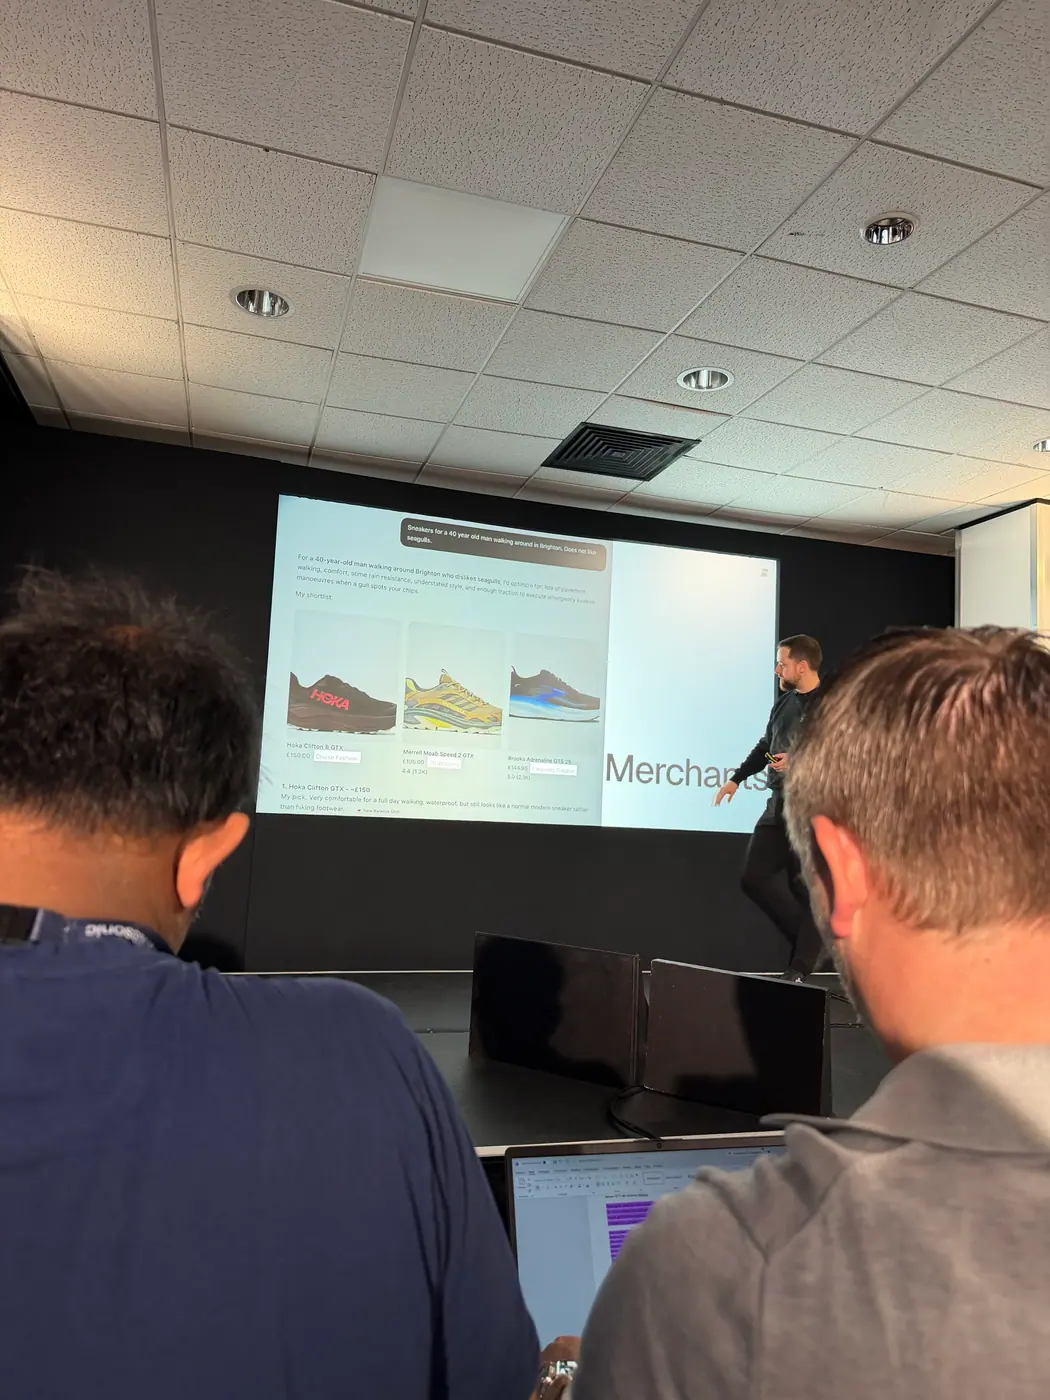
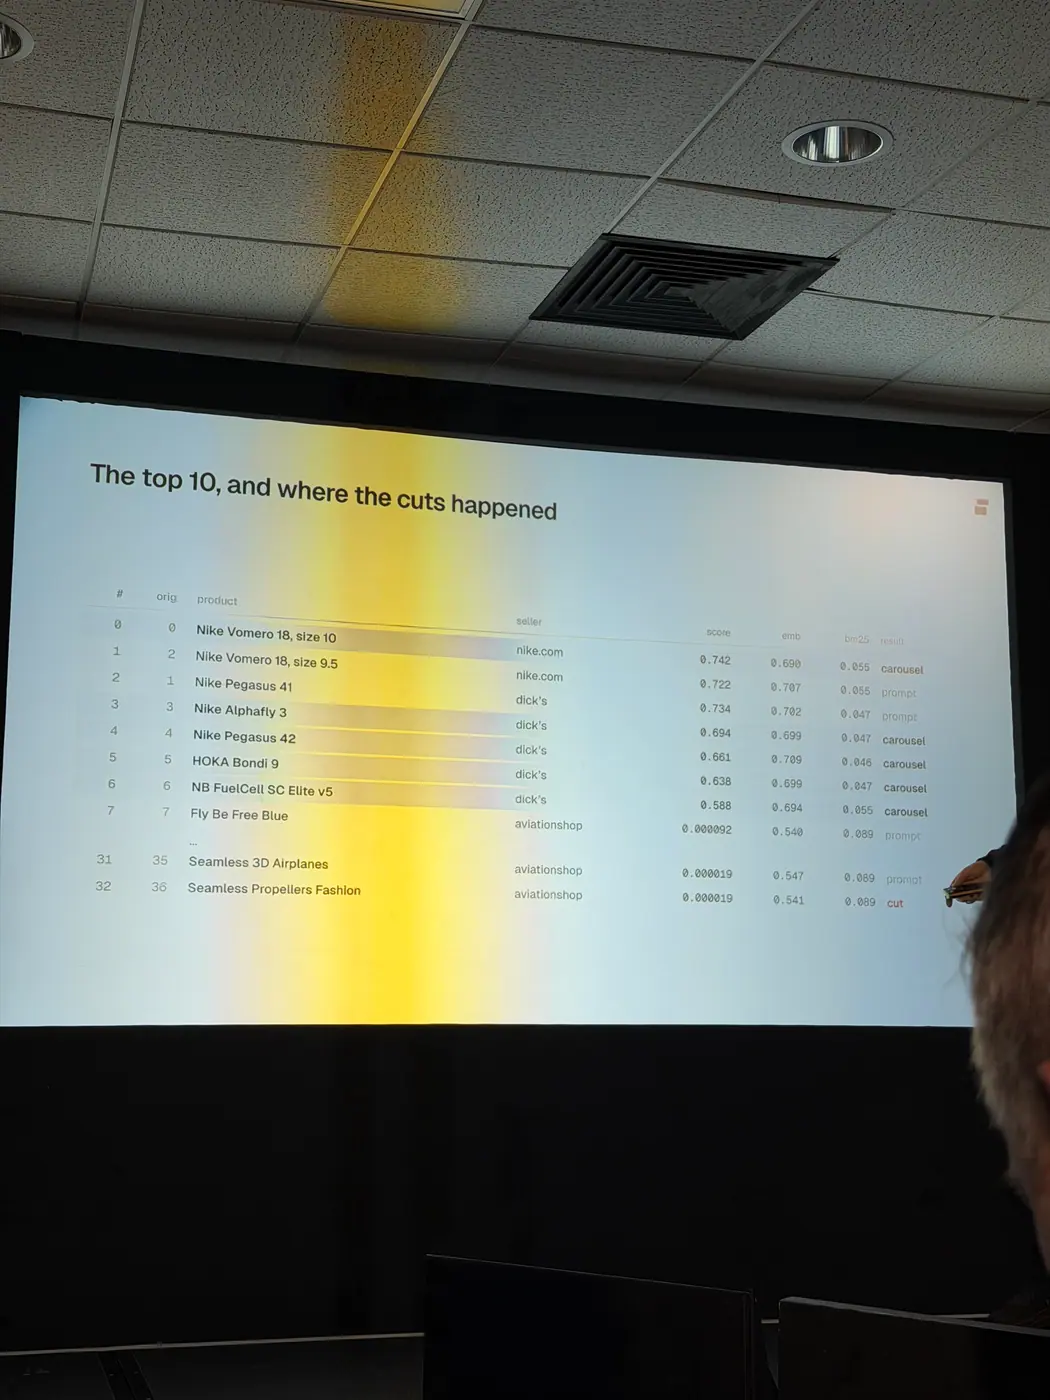
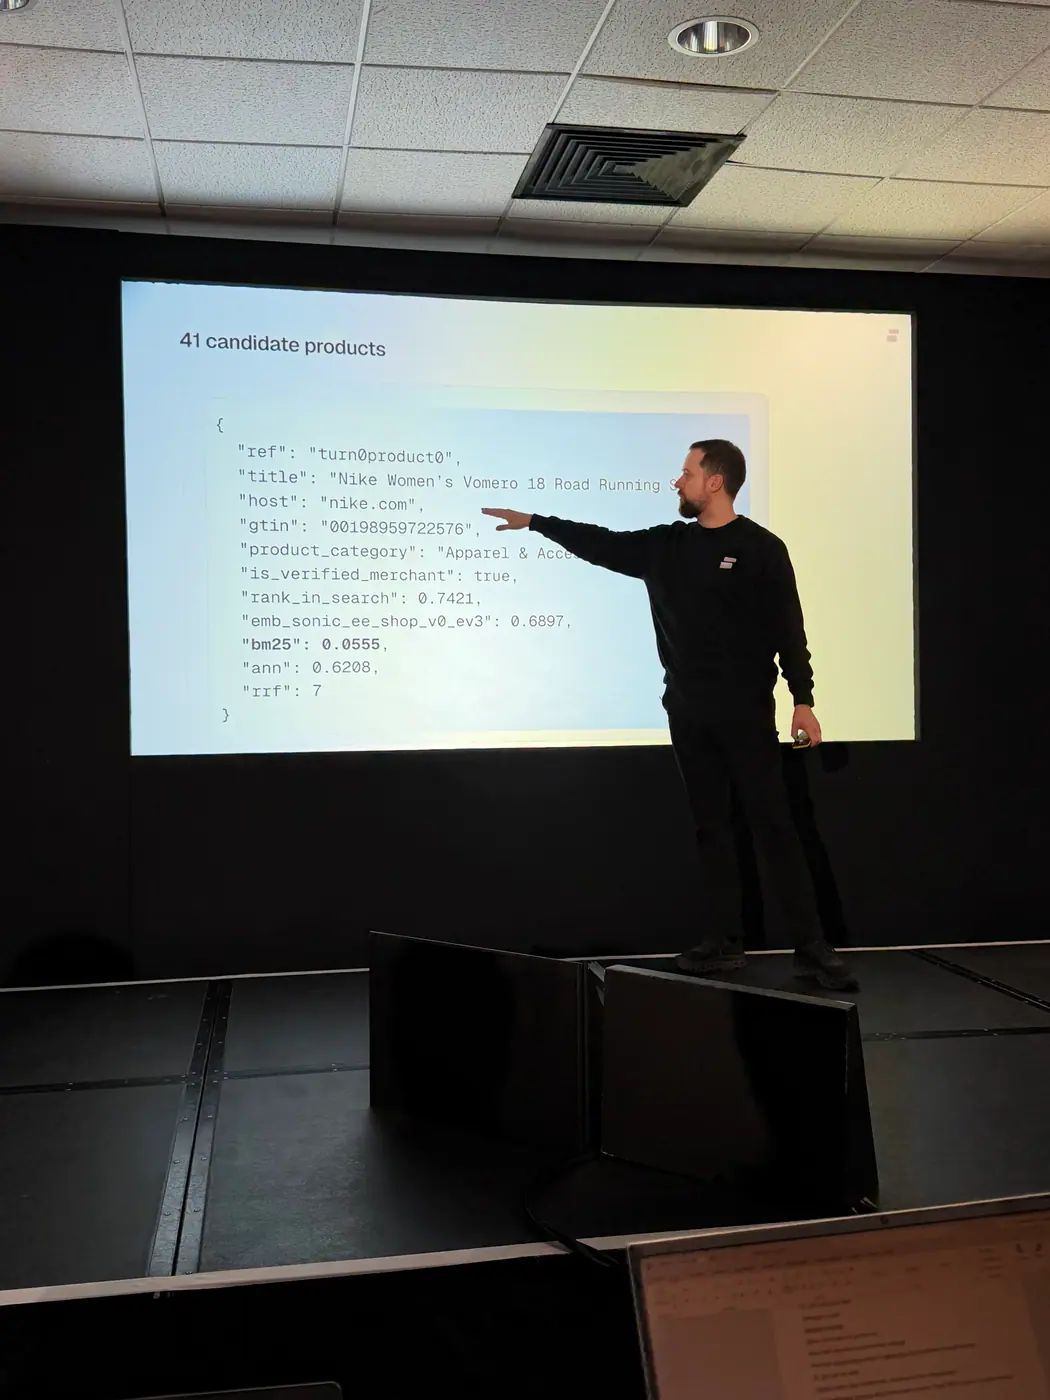
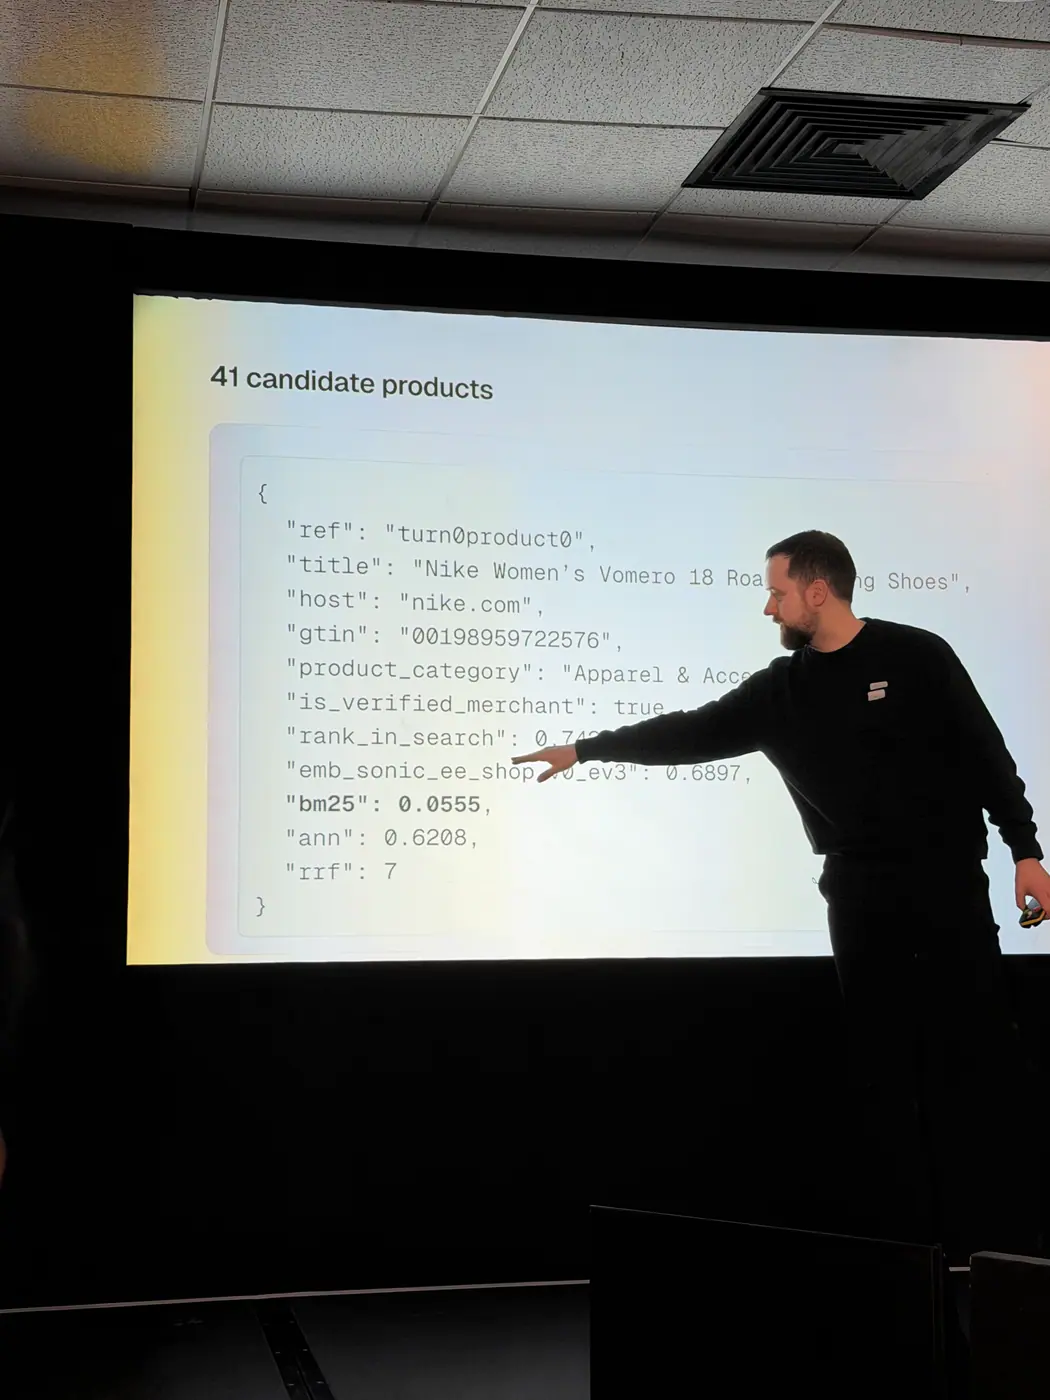
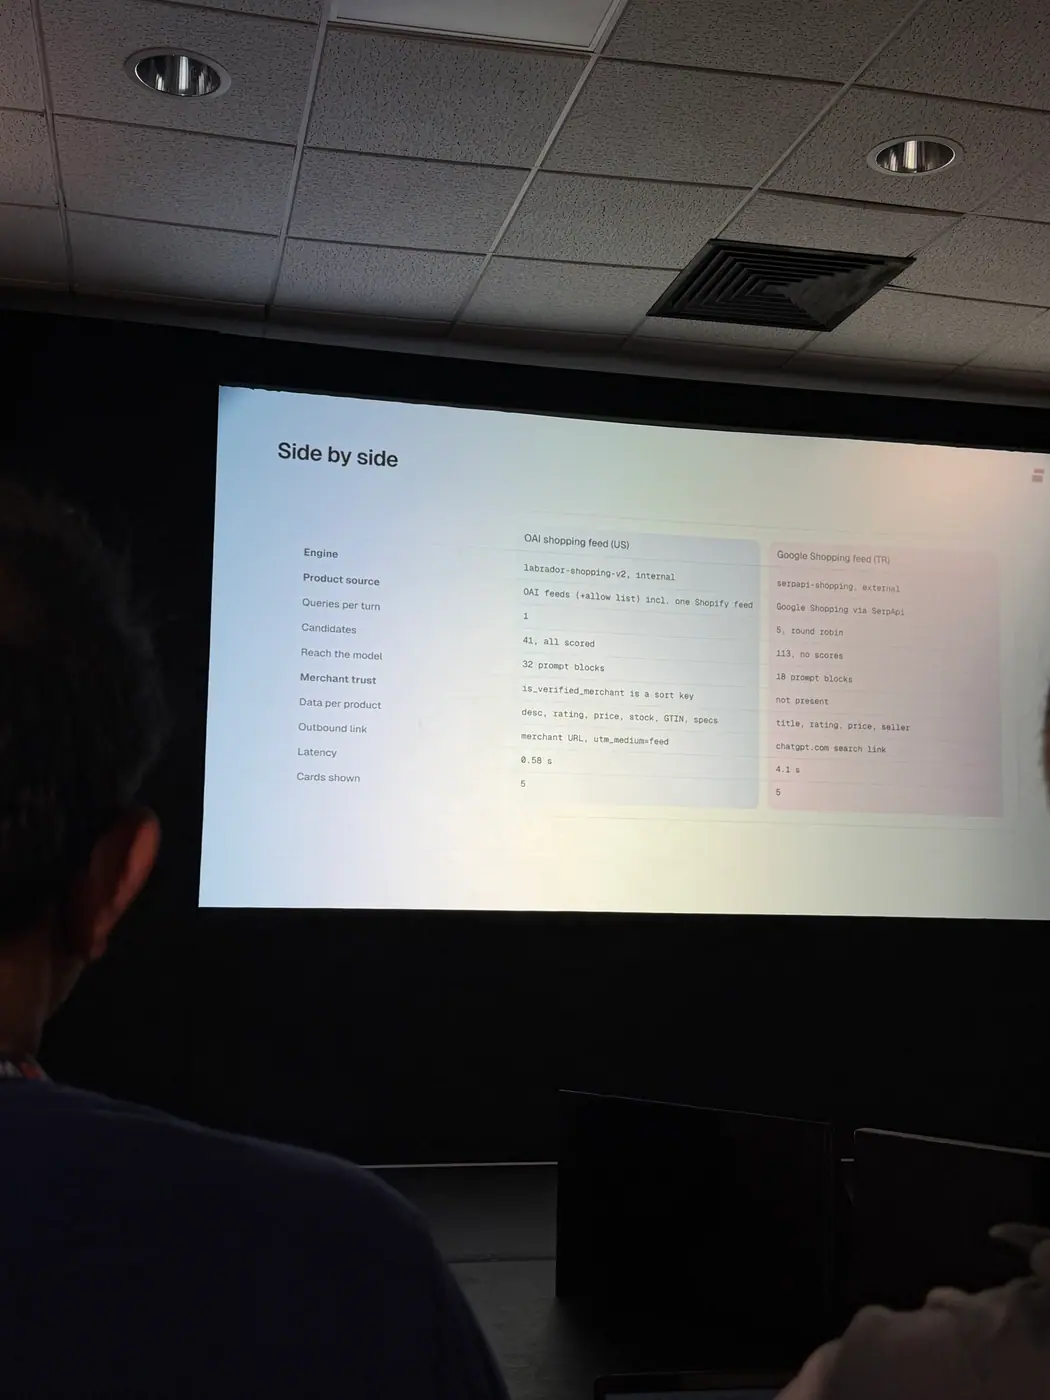
| Przykład selekcji butów do biegania | 41 produktów → 32 bloki danych przekazane do dalszego wyboru → 5 wyświetlonych produktów. |
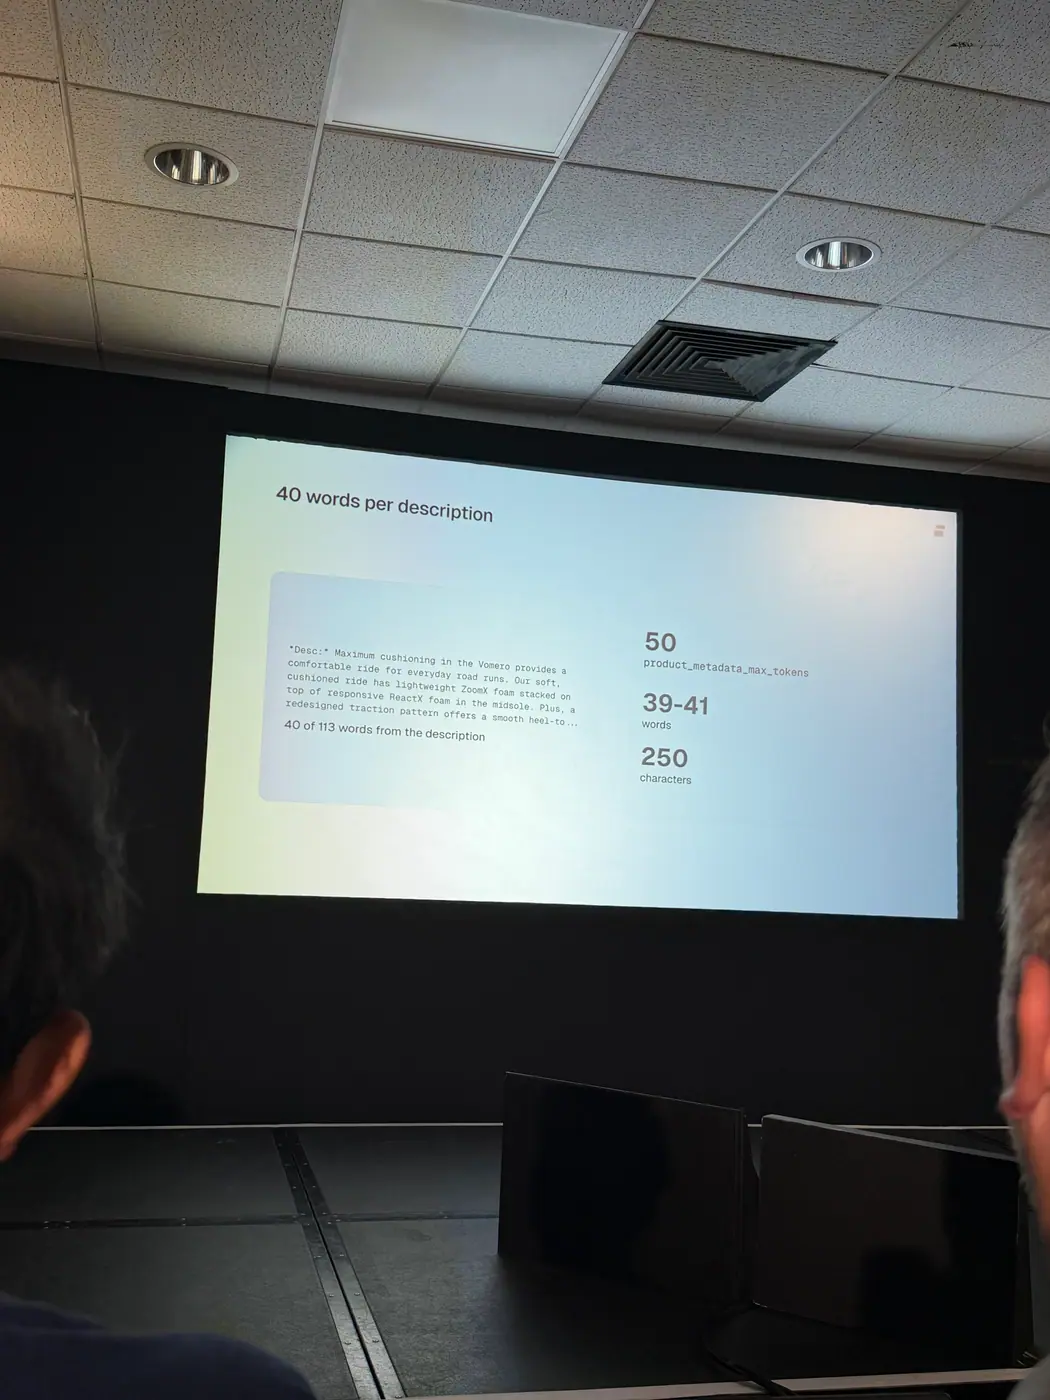
| Opis produktu na analizowanym etapie oceny | 50 tokenów. Według Landwehra odpowiadało to około 39–41 słowom w języku angielskim. Dalsza część opisu była odcinana. |
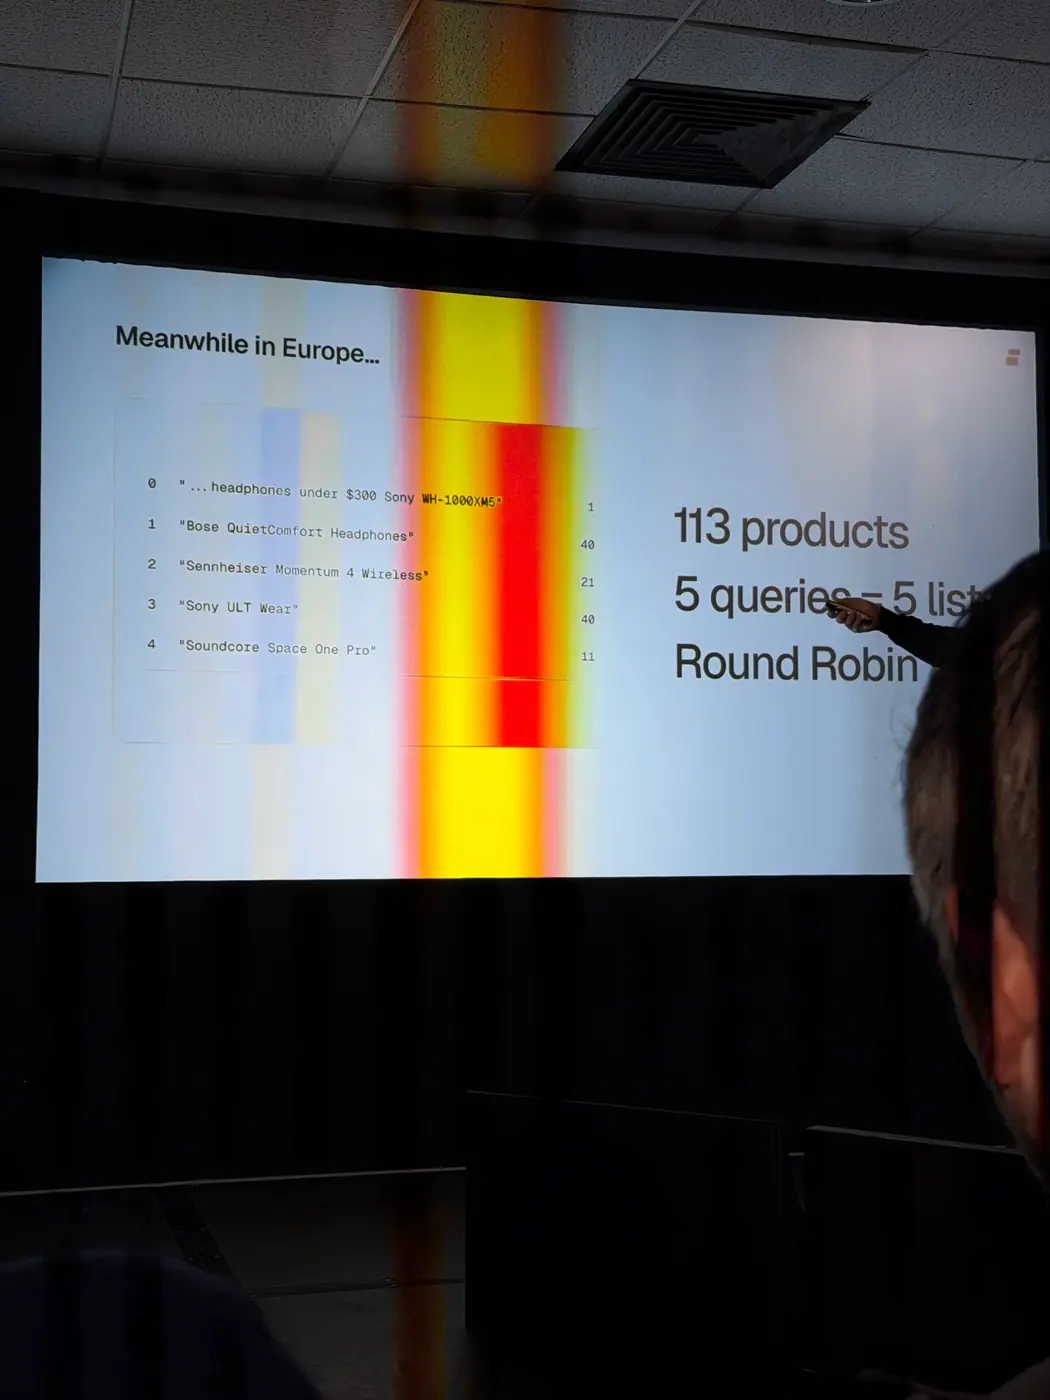
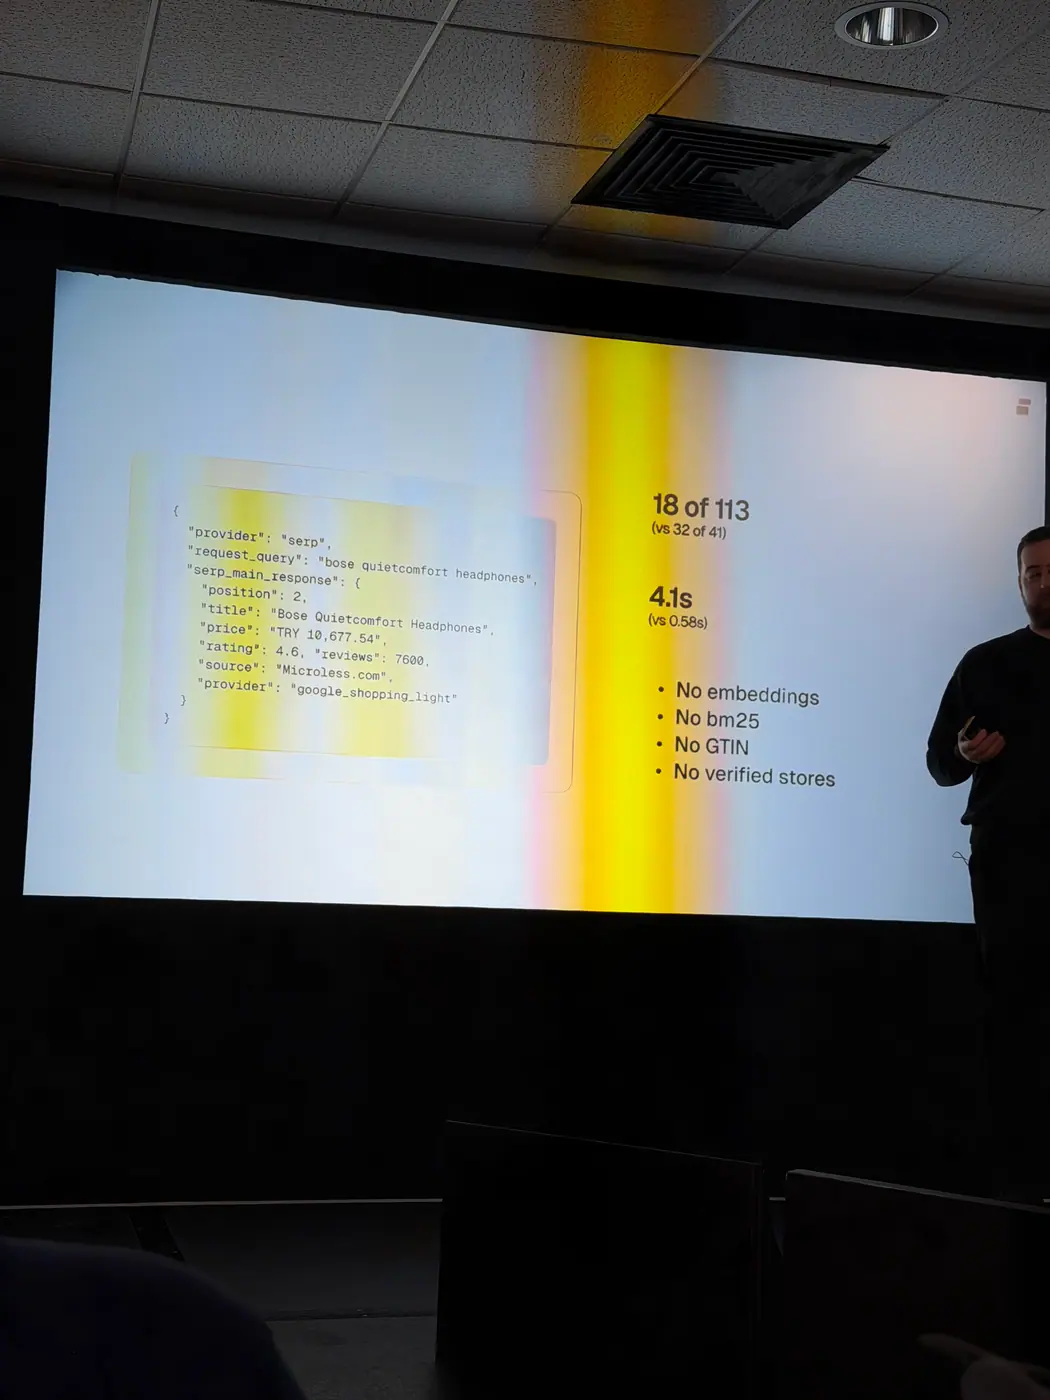
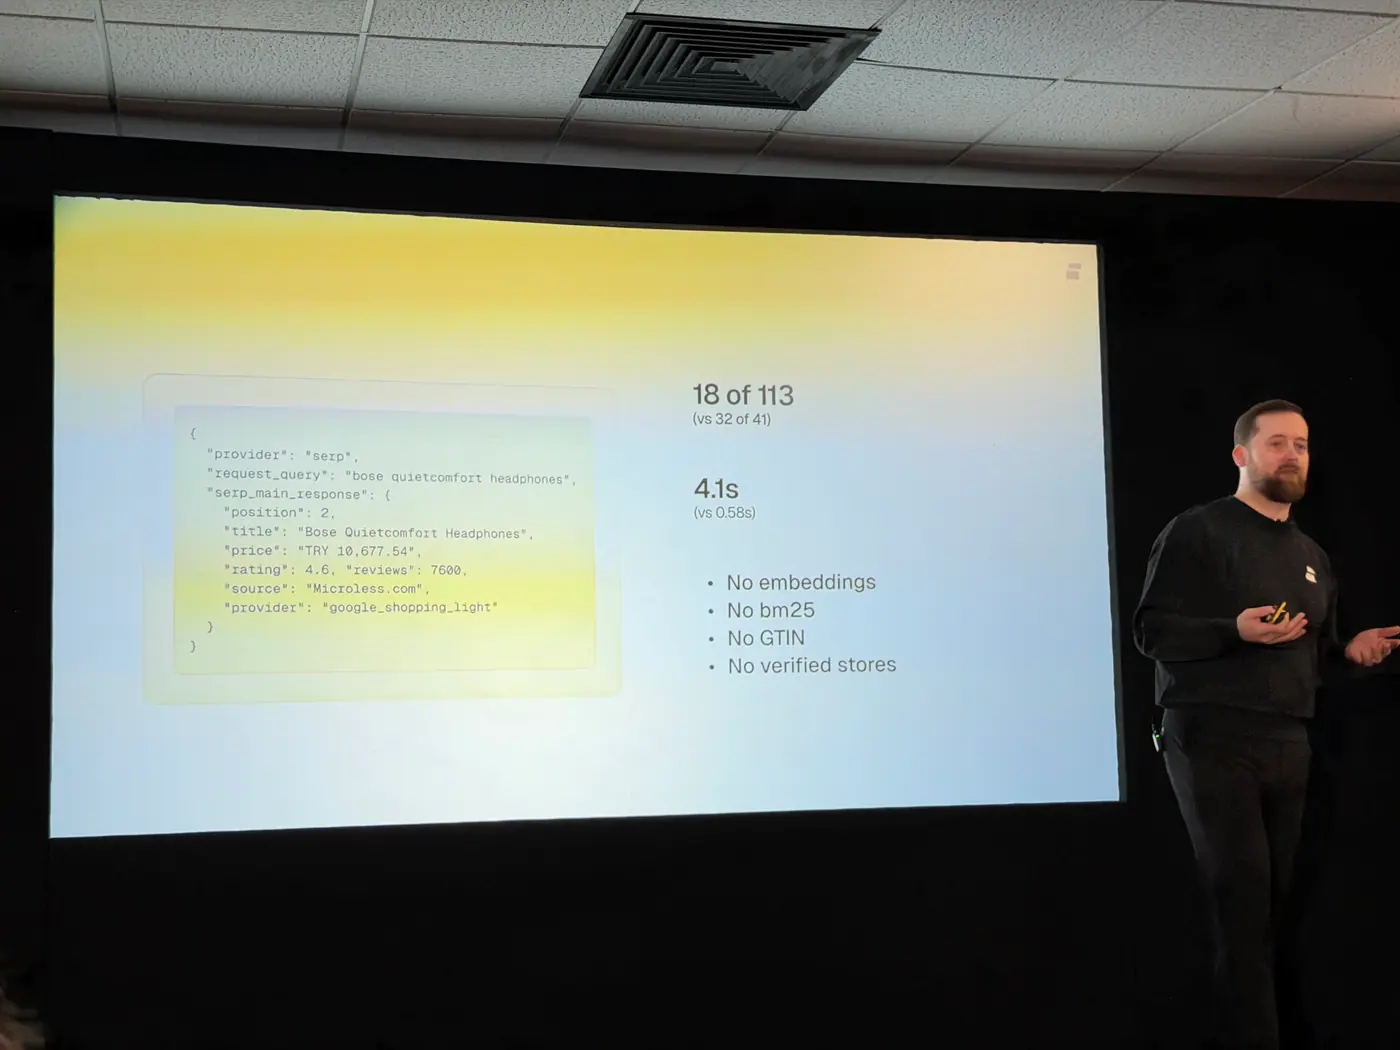
| Europejski przykład pobierania produktów | 5 zapytań pomocniczych → 113 produktów → 18 wybranych do dalszego etapu. |
| Czas pobierania produktów | Około 4 sekund dla mechanizmu opartego na Google Shopping i 0,6 sekundy dla Labrador, w pokazanych przykładach dotyczących różnych zapytań. |
| Liczba produktów w karuzeli | Najczęściej 4 produkty. Wyniki z więcej niż 7 produktami występowały bardzo rzadko. |
| Niski DR | Domeny z DR poniżej około 20 były w badanym zbiorze rzadko cytowane. To obserwacja, nie wskazany próg kwalifikacji do systemu. |
Praktyczne rady
Audytuj widoczność osobno dla każdego rynku. Dobry wynik w Europie mógł wynikać z obecności w Google Shopping. Nie dowodził przygotowania sklepu do mechanizmu opartego na bezpośrednich feedach.
Przenieś najważniejsze cechy produktu na początek opisu w feedzie. Typ produktu, kluczowe parametry i zastosowanie powinny poprzedzać ogólny wstęp. Liczby około 40 słów nie należy traktować jako stałego limitu dla języka polskiego.
Sprawdź kompletność rzeczywistych wariantów i dopasowanie opisów do zapytań. Landwehr wskazał możliwość lokalnego testowania BM25 (Best Matching 25 / funkcja oceny dopasowania tekstowego). Taki test może pomóc ocenić trafność tekstu, ale nie odtwarza całego mechanizmu wyboru produktów.
Rozbudowuj treści o warunki wyboru i konkretne zastosowania. Oprócz ogólnego rankingu potrzebne mogą być porównania odpowiadające na pytania o wygodę, dopasowanie, ograniczenia czy użytkowanie w określonej sytuacji.
Rozdziel raportowanie produktu, sprzedawcy i cytowanego źródła. Dodatkowo porównuj obecność własnej marki i konkurentów w zapytaniach pomocniczych. Dla zespołów SEO (Search Engine Optimization / optymalizacja pod kątem wyszukiwarek) to sposób na odróżnienie problemu z treścią od problemu z samym wejściem do zbioru rozważanych źródeł.
Knowledge bombs
1. ChatGPT Shopping w USA i w Europie to dwa różne systemy: własny indeks z feedami kontra scraping Google Shopping.
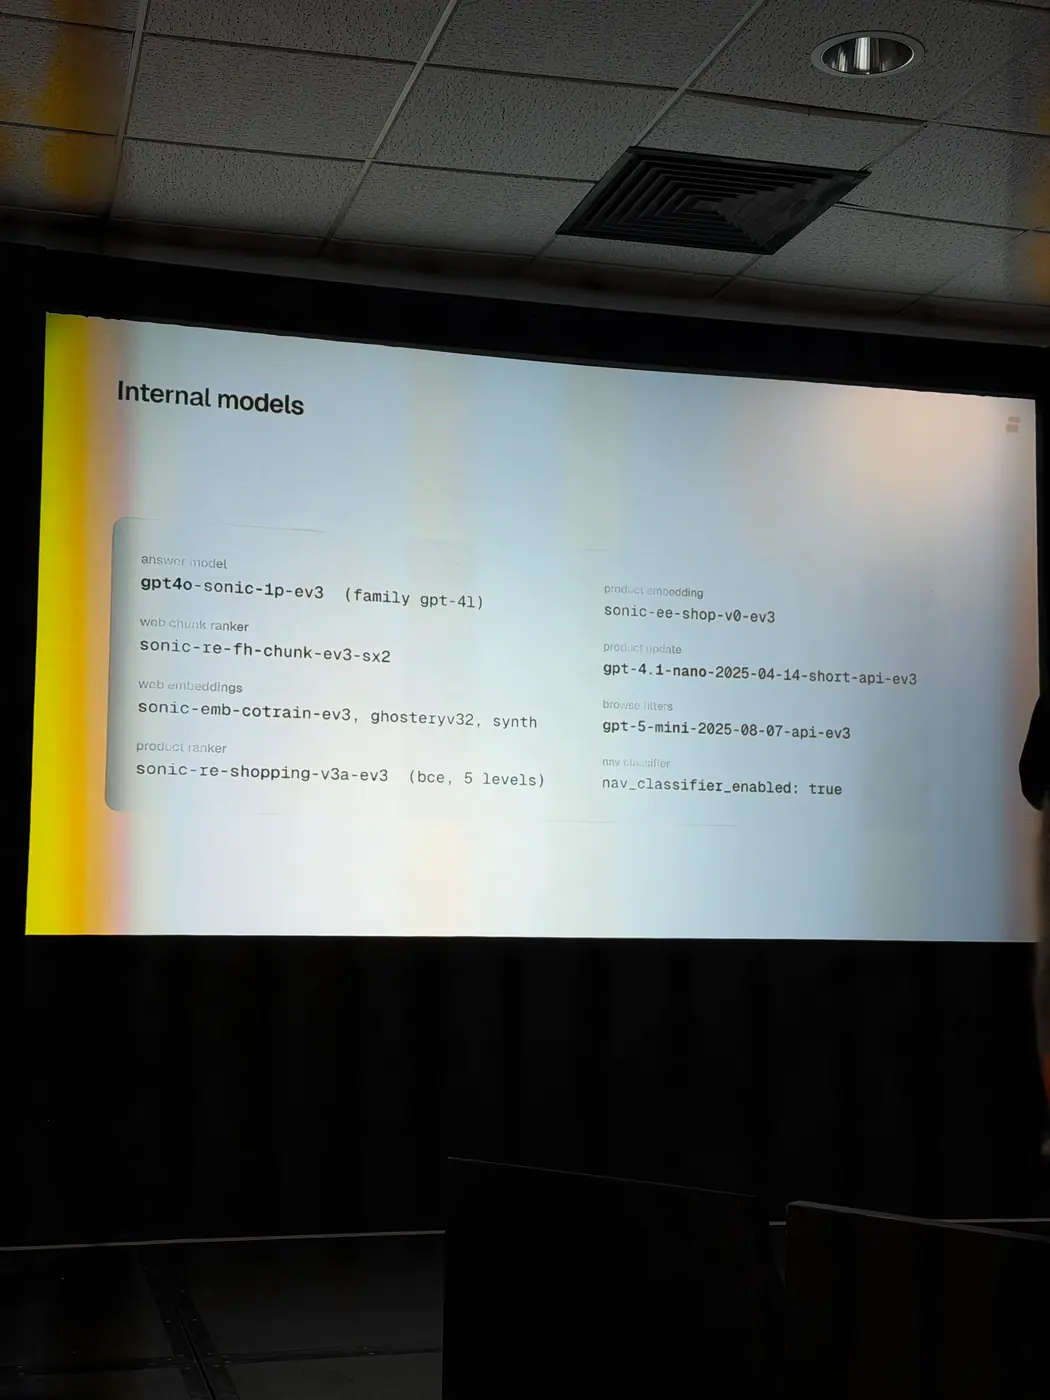
W Stanach OpenAI uruchomiło własny system wyszukiwania produktów (Labrador), do którego sklep musi dostarczyć feed bezpośrednio albo przez Shopify; w Europie karuzela produktowa nadal powstaje ze scrapowania organicznych wyników Google Shopping przez SERP API. Landwehr widzi to w kodzie debugowym OpenAI: dla USA flaga Labrador Shopping jest włączona, dla Europy wyłączona. Dla sklepu w Polsce oznacza to, że dzisiejsze wyniki w ChatGPT to pochodna Google Shopping, ale trzeba być gotowym na zmianę zasad, gdy Labrador trafi do Europy.
„Because in Europe, the whole thing is still based on scraping Google Shopping via SERP API. But in the U.S., they have rolled this out with their own index and retrieval system, Labrador, where you now have to supply a feed directly to them or to be on Shopify to have that feed in there.”
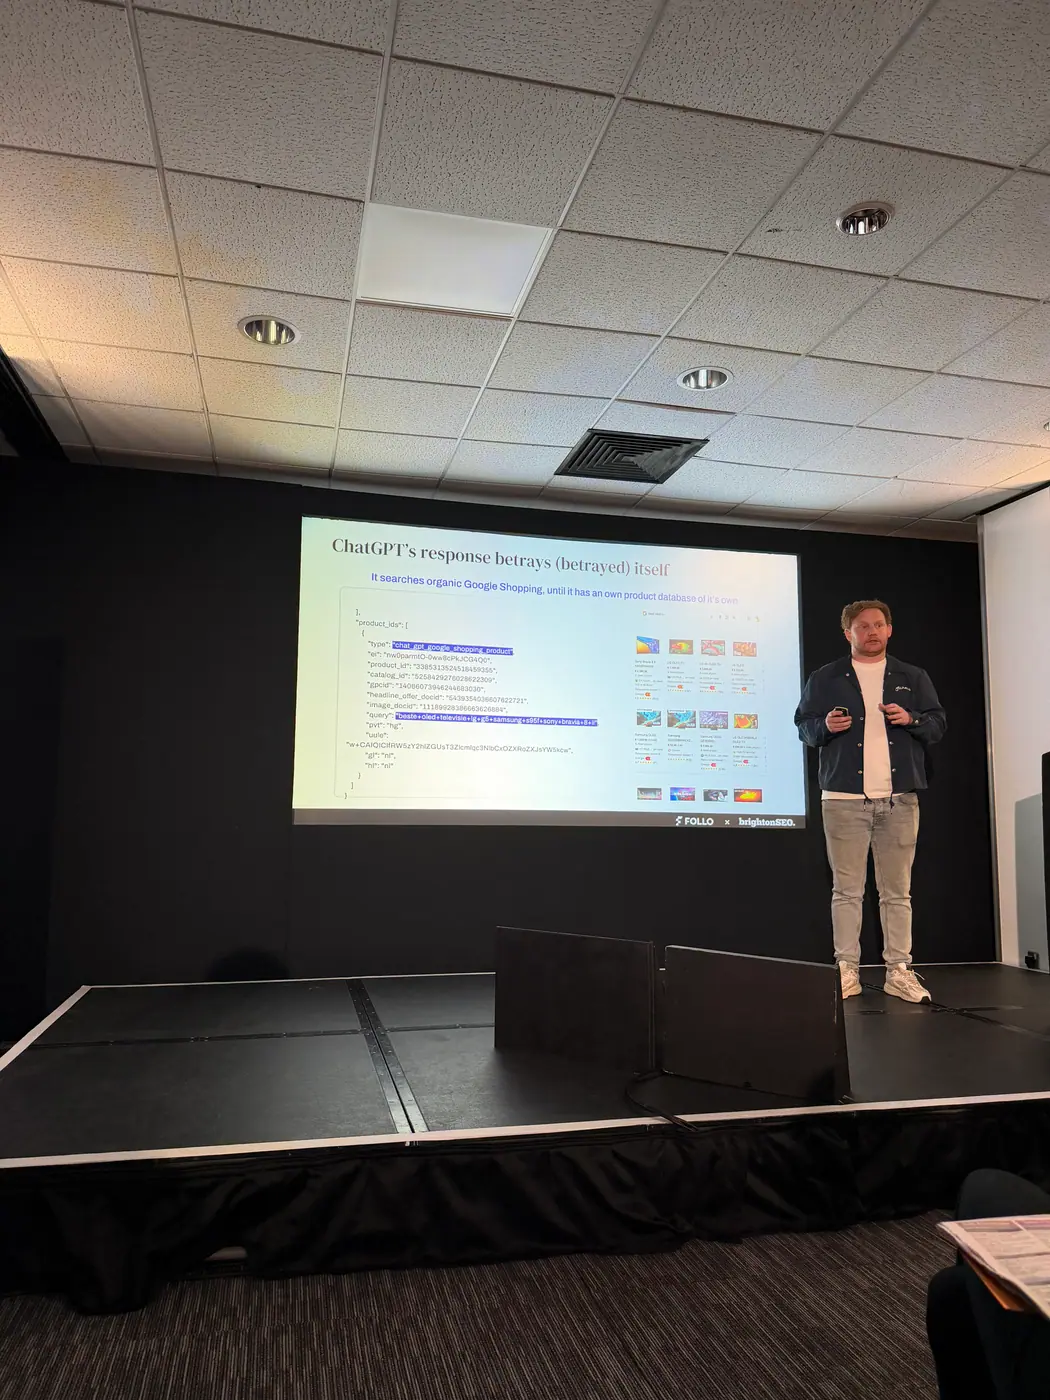
2. W europejskiej wersji nie ma embeddingów, BM25, GTIN ani weryfikacji sklepu – liczy się wyłącznie pozycja w Google Shopping.
Europejski przepływ to pięć zapytań fan-out (zapytań pomocniczych, które model wysyła w tle) do Google Shopping, łączonych metodą round-robin w listę ok. 113 produktów, z której zostaje 18; całość trwa ok. 4 s wobec 0,6 s dla Labradora. Żaden sygnał relewancji ani zaufania nie jest liczony po stronie OpenAI, więc dobre wyniki w ChatGPT Shopping w Europie to po prostu dobre wyniki w Google Shopping. Landwehr radzi mimo to już teraz liczyć lokalnie BM25 dla opisów produktów, bo w systemie amerykańskim jest to jeden z podscore’ów.
„And they didn’t use embeddings, they don’t use BM25, they don’t look at the GTIN, like nothing of this is in here, and there is no check for verified stores. So any store that is in Google Shopping they believe is trustable.”
3. Opis produktu w feedzie jest obcinany do dokładnie 50 tokenów – najważniejsze słowa muszą być w pierwszych 40 wyrazach.
Na etapie budowania „bloków promptu” dla każdego kandydata system amerykański bierze tytuł, opis, oceny, GTIN itd., ale z opisu zostaje tylko 50 tokenów (ok. 39–41 słów po angielsku, ok. 250 znaków); reszta nie wpływa na scoring. To odwrotność praktyki rozbudowanych opisów SEO: w feedzie do OpenAI terminy decydujące o dopasowaniu trzeba umieścić na samym początku.
„because every single product has 50 tokens, exactly 50 tokens for the description. Anything that is longer is cut off. […] So if you send a feed to OpenAI, please put your most important terms in the first 40 words because the rest is cut for this stage of the scoring.”
4. Każdy wariant produktu wysyłaj do feedu osobno – wbrew nawykowi „jedna strona na model buta”.
W teście dla butów do biegania Dick’s Sporting Goods zajął cztery z pięciu miejsc w karuzeli, bo deduplikacja usuwa tylko ten sam but w różnych rozmiarach, a nie różne pozycje tego samego sklepu. Logika feedowa nagradza więc wysyłanie każdej pozycji i każdego wariantu oddzielnie: więcej kandydatów to więcej miejsca na górze i realna szansa wypchnięcia konkurencji z wyników.
„you should send every single item and every single variance individually in the feed because then you can take up more space on top and can potentially push out competitors out of the results.”
5. Bez atrybutu „verified seller” sklep wypada z wyników całkowicie, niezależnie od liczby produktów.
W tym samym teście jeden sklep miał 25 z 41 kandydatów, ale jako sklep o najniższym zaufaniu nie dostał ani jednego miejsca w karuzeli. Landwehr nie zdołał jeszcze ustalić, skąd OpenAI bierze ten atrybut, ale jego brak działa jak filtr zero-jedynkowy, więc warto to sprawdzić zanim zacznie się optymalizować opisy.
„there is this verified seller true attribute and some shops don’t have it. And if you don’t have it, you just get out of the results completely.”
6. Lepiej być sklepem niż marketplace’em lub agregatorem: te drugie rzadko trafiają do źródeł, a jeśli trafią, najrzadziej dostają cytowanie inline.
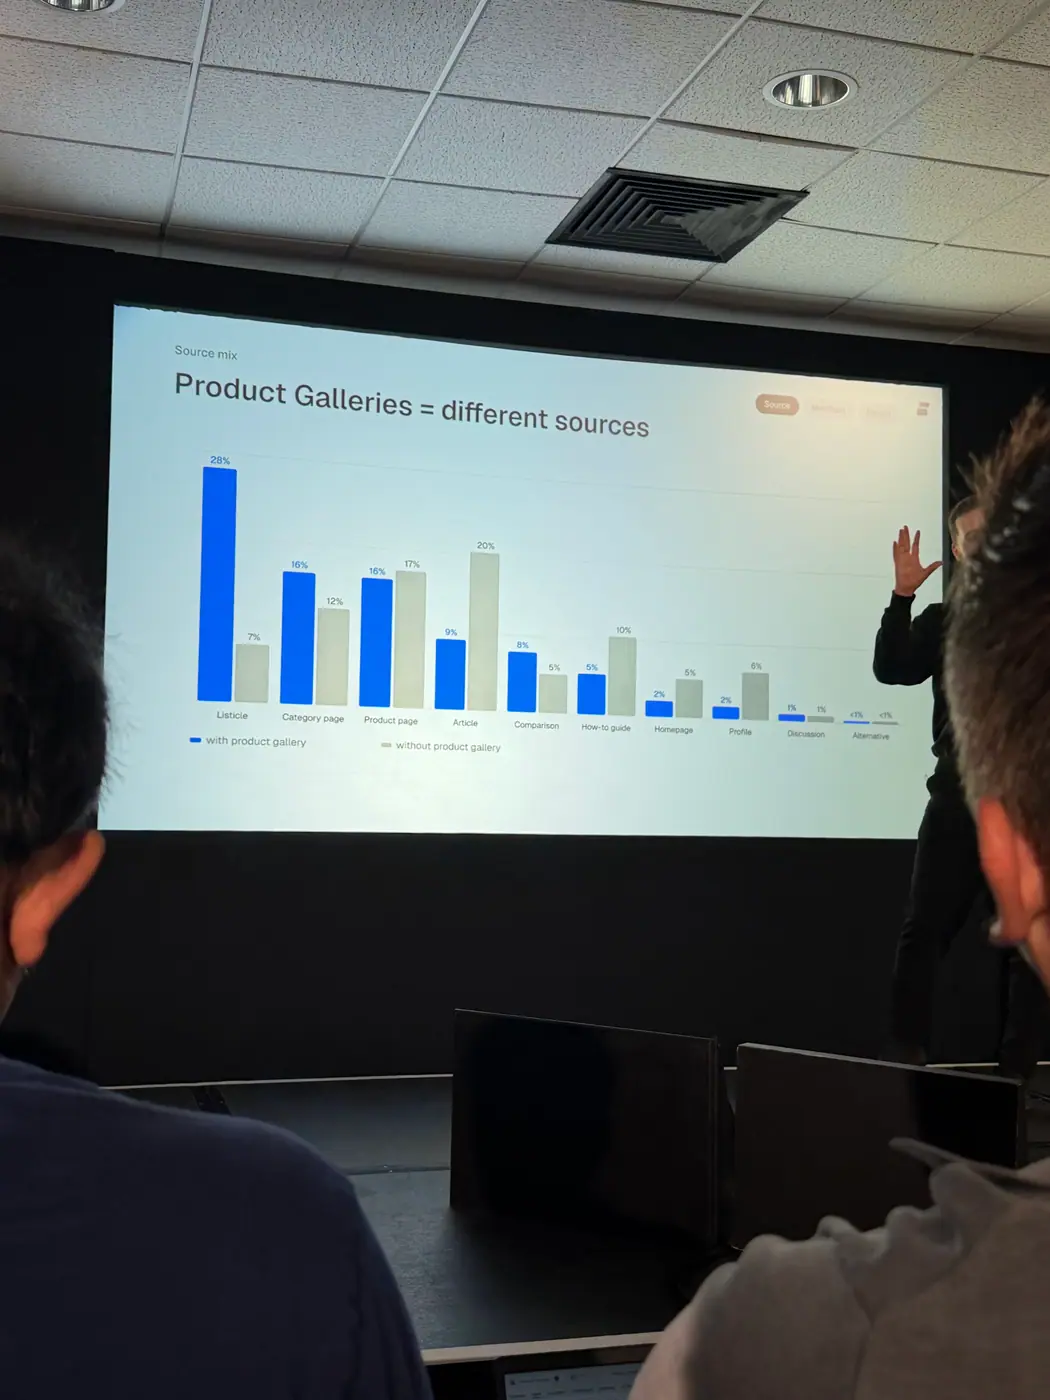
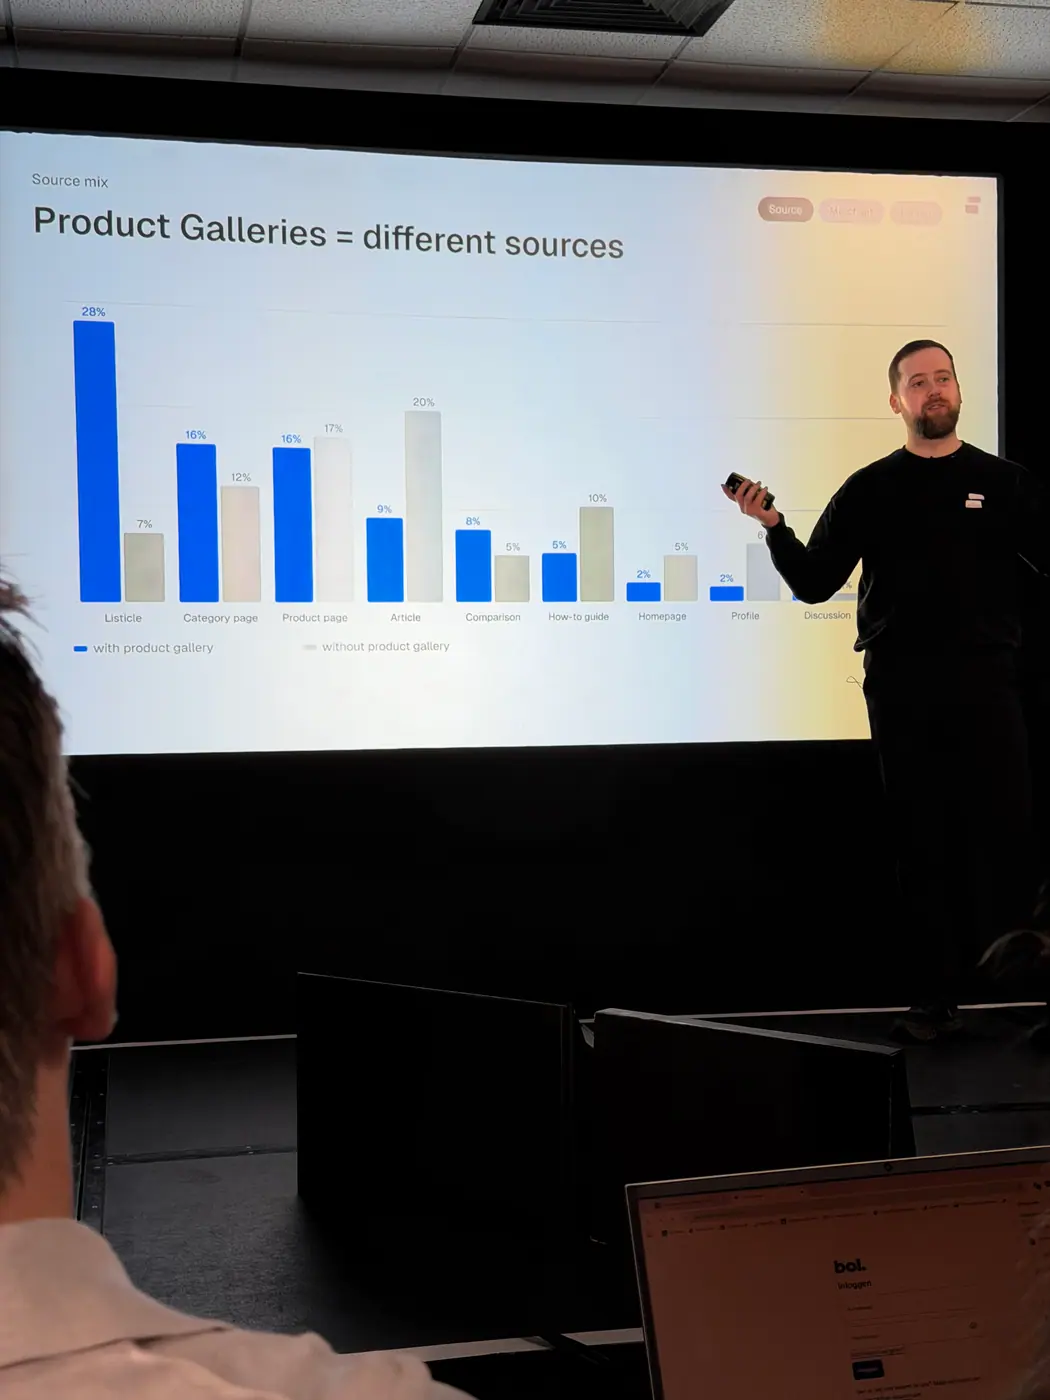
Dane z milionów czatów w Wielkiej Brytanii: w odpowiedziach z galerią produktów źródłami tekstu są głównie sklepy, potem serwisy niekomercyjne (recenzje, producenci), które przy obecności w źródłach najczęściej są cytowane w treści. Agregatory i marketplace’y są niedoreprezentowane na obu etapach. Dla sklepu to argument, by inwestować we własne listicle i strony kategorii, bo przy galerii produktów właśnie te formaty są częściej używane jako źródła.
„and then what I found surprising is that aggregators and marketplaces, who are already very much underrepresented in the sources, are also the least likely, if they are in the sources, to get the inline citation, so I would very much prefer to be a shop right now than to be a marketplace or aggregator.”
7. Jeśli ChatGPT dopisuje twoją markę do zapytań fan-out, masz niemal gwarantowane 10 slotów źródłowych – i to jest metryka do monitorowania.
Przy obecnym widgecie produktowym do zapytań pomocniczych dużo częściej dopisywana jest marka niż sprzedawca (sprzedawcy pojawiają się głównie przy pytaniach „gdzie kupić”). Na to, czy model uznaje markę za istotną, wpływa się długofalowo, ale jeśli konkurent o podobnej popularności jest dopisywany do fan-outów częściej niż ty, to sygnał, że coś w postrzeganiu marki przez model wymaga zbadania.
„And of course, if your brand is added to a fan-out query, that’s a massive advantage, right, because you are almost guaranteed to get 10 of these potential source slots, if JTB is specifically searching something related to your brand.”
8. Wysoki Domain Rating nie zwiększa szansy na cytowanie per URL, ale poniżej DR 20 cytowania praktycznie nie ma.
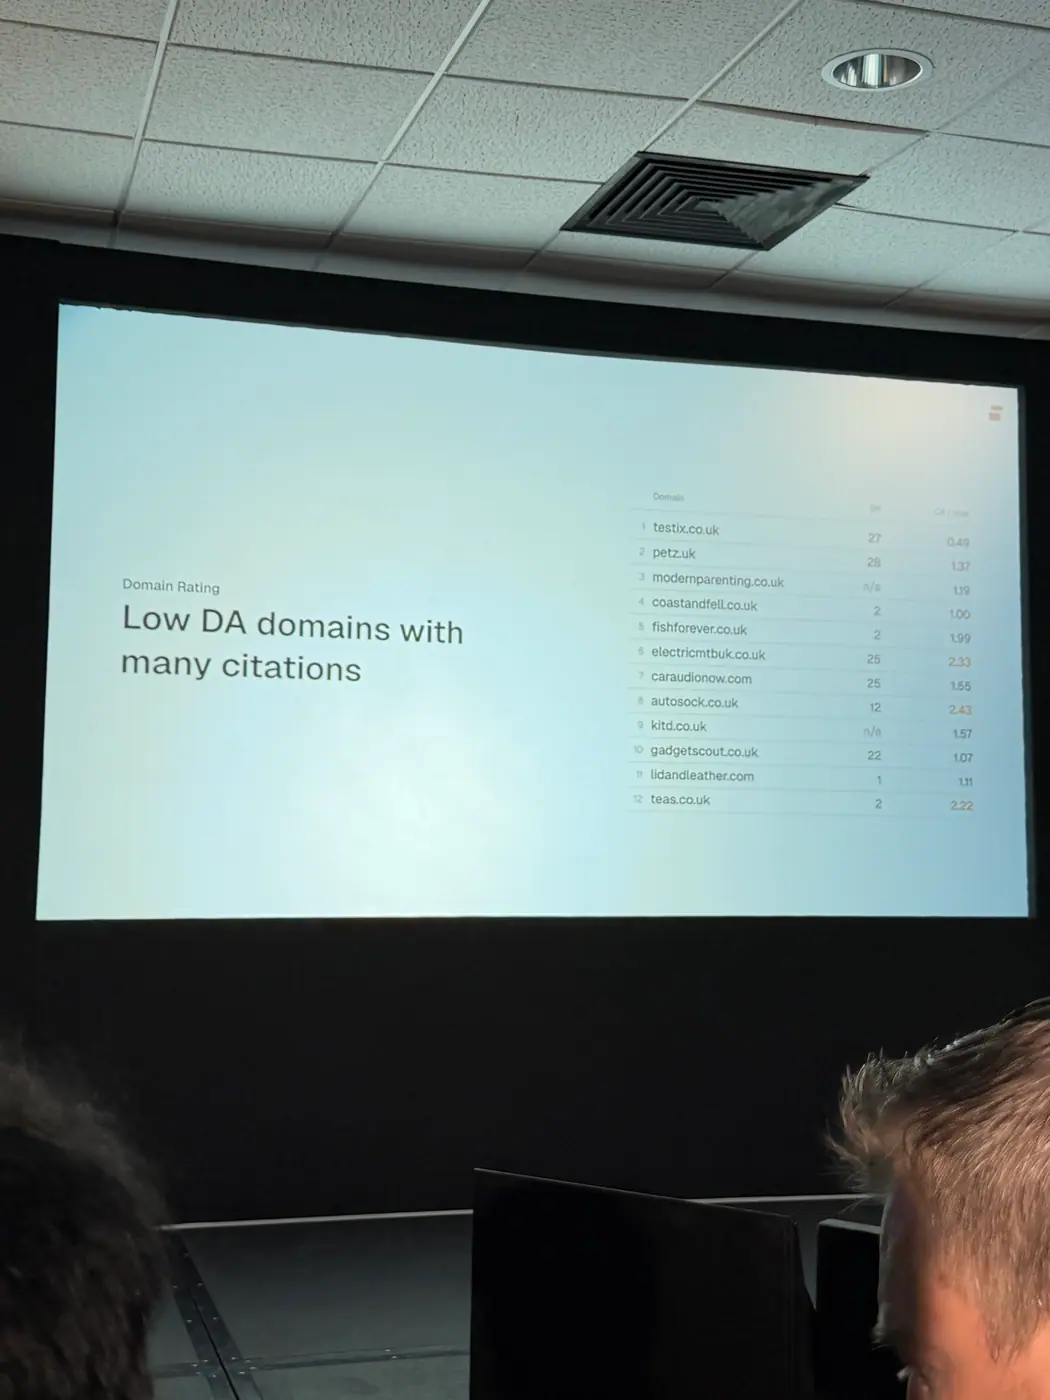
Na pierwszy rzut oka cytowane są domeny o wysokim DR (dane Ahrefs), ale wynika to tylko z tego, że mają więcej adresów w źródłach. Liczone per URL, szanse są podobne w całym zakresie powyżej progu ok. 20; poniżej domena ani nie jest cytowana, ani nie rankuje na zapytania fan-out. Najciekawsze do analizy są domeny o bardzo niskim DR z wysokim wskaźnikiem cytowań, bo coś w ich strukturze treści lub marce daje im przewagę.
„high DR domains just have the advantage that they have more URLs in the sources, but otherwise the high DR is not an advantage. If you look at it per URL, it’s actually quite similar, but if you are below like a DR of 20, you are very unlikely to be cited”
Zdjęcia: Malte Landwehr
36 kadrów · Fot. Robert Nowaczyk
Stijn Bergmans: 7 Tactics for Agentic Search and Shopping
09:50
Streszczenie
Stijn Bergmans przedstawił siedem kierunków pracy nad GEO (Generative Engine Optimization / optymalizacja widoczności w wyszukiwarkach generatywnych). Połączył pomiar wpływu na sprzedaż, analizę rekomendacji i cytowanych źródeł oraz optymalizację danych produktowych.
Główna teza: same kliknięcia nie pokazują całego wpływu odpowiedzi AI (Artificial Intelligence / sztuczna inteligencja), a sama obecność marki w odpowiedzi nie oznacza, że została ona polecona.
Prelegent opierał wystąpienie na obserwacjach z własnej agencji, przykładach analiz oraz relacjonowanych testach. Jego szacunki i rekomendacje strategiczne należy odróżnić od wyników dotyczących konkretnych klientów.
Najważniejsze wnioski
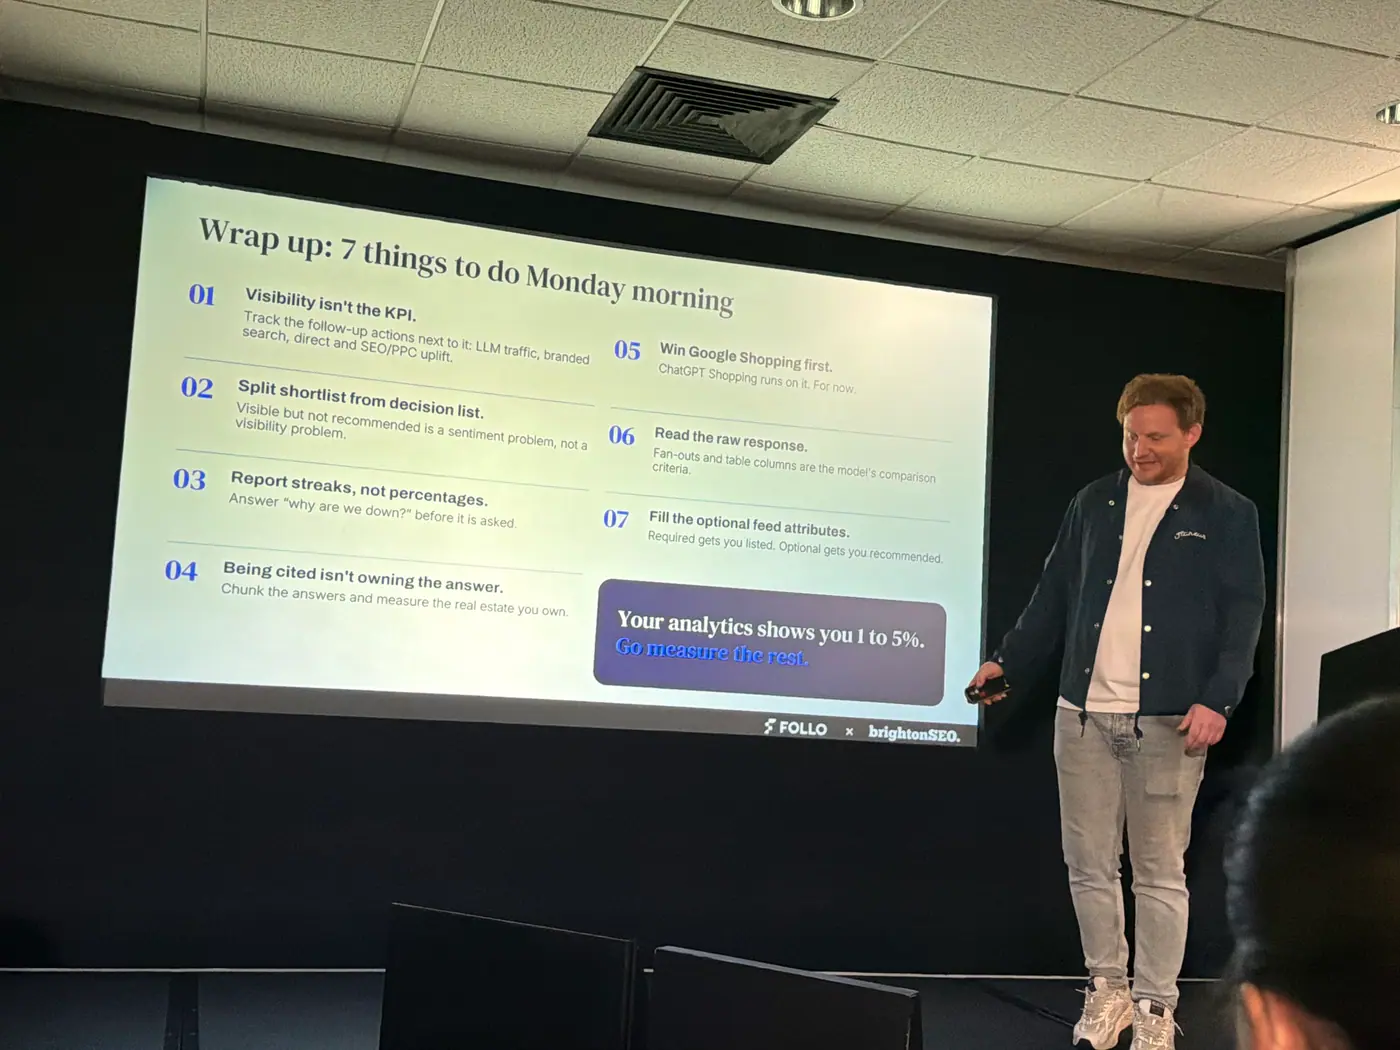
Pomiar powinien obejmować działania po przeczytaniu odpowiedzi, nie tylko kliknięcie w niej linku.
Bergmans pokazał, że użytkownik po rozmowie z LLM (Large Language Model / duży model językowy) może wyszukać markę, wejść bezpośrednio na stronę albo kliknąć reklamę. Wówczas analityka przypisuje wizytę innemu kanałowi.
Praktyczna rada: zestawiaj widoczność w odpowiedziach z ruchem, przychodem, wyszukiwaniami marki, wejściami na stronę główną i deklaracjami klientów. Żadnego z tych sygnałów nie traktuj osobno jako pełnego obrazu wpływu.Wzmianka i rekomendacja wymagają osobnego pomiaru.
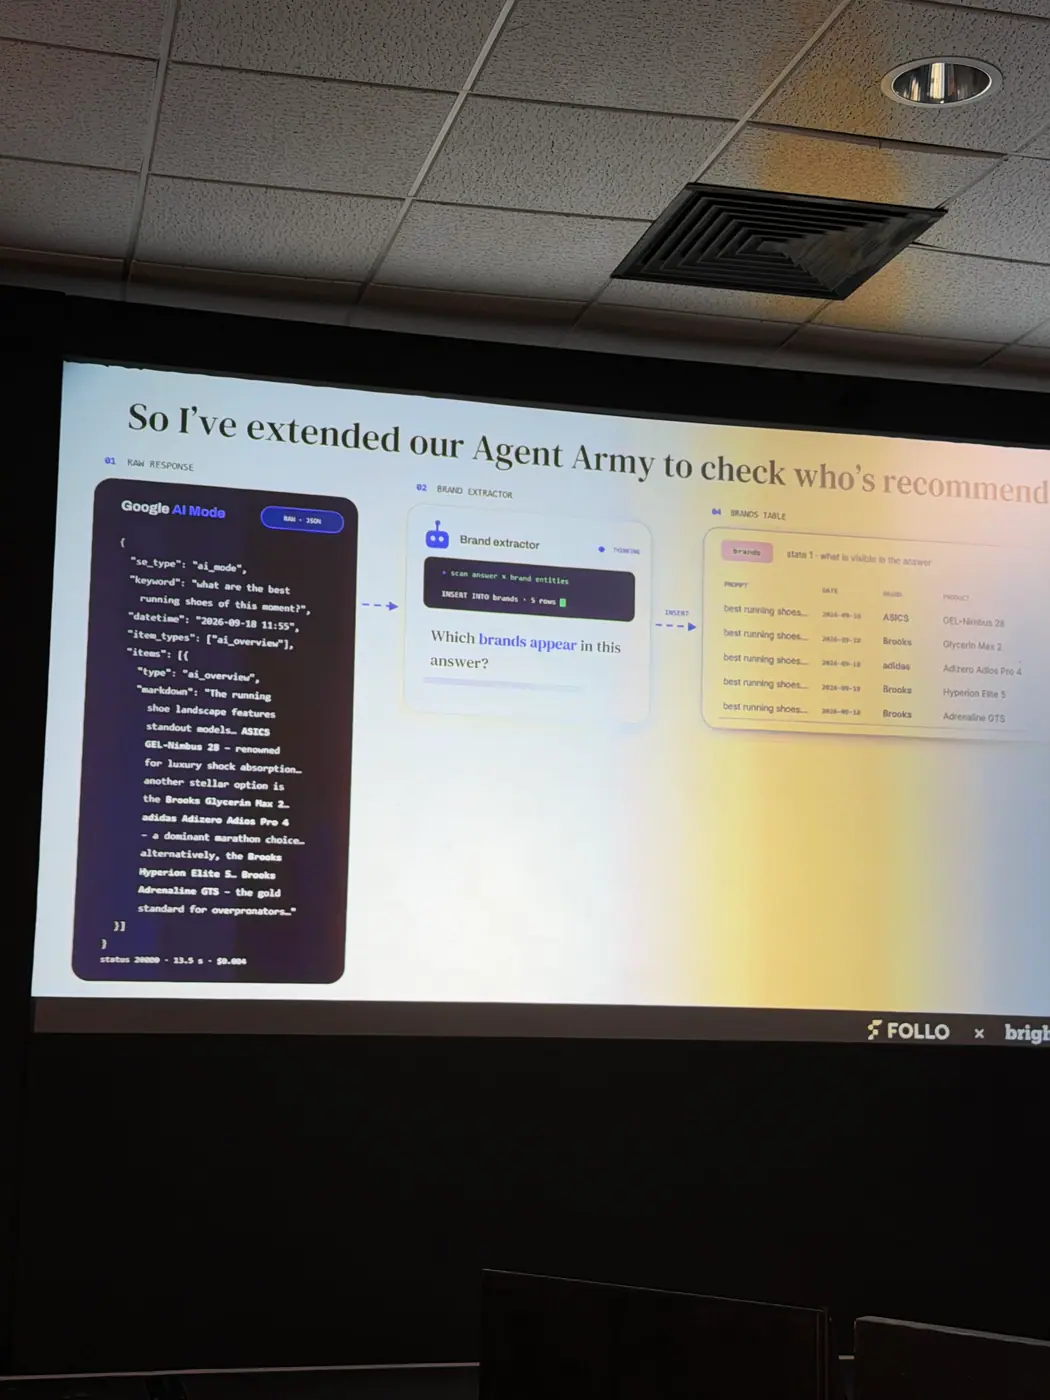
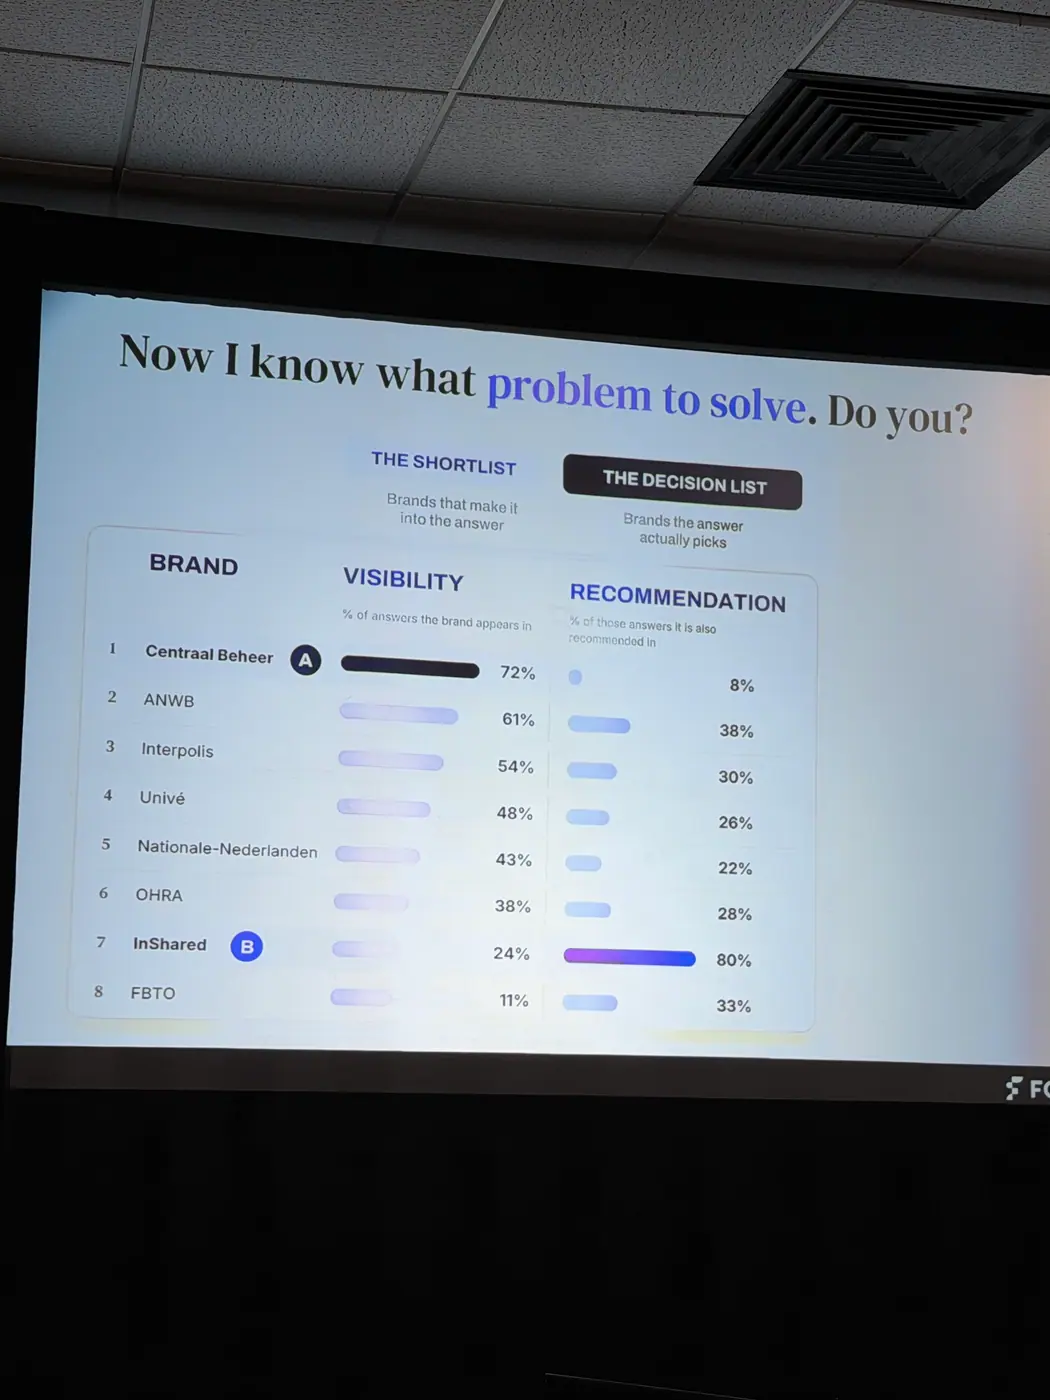
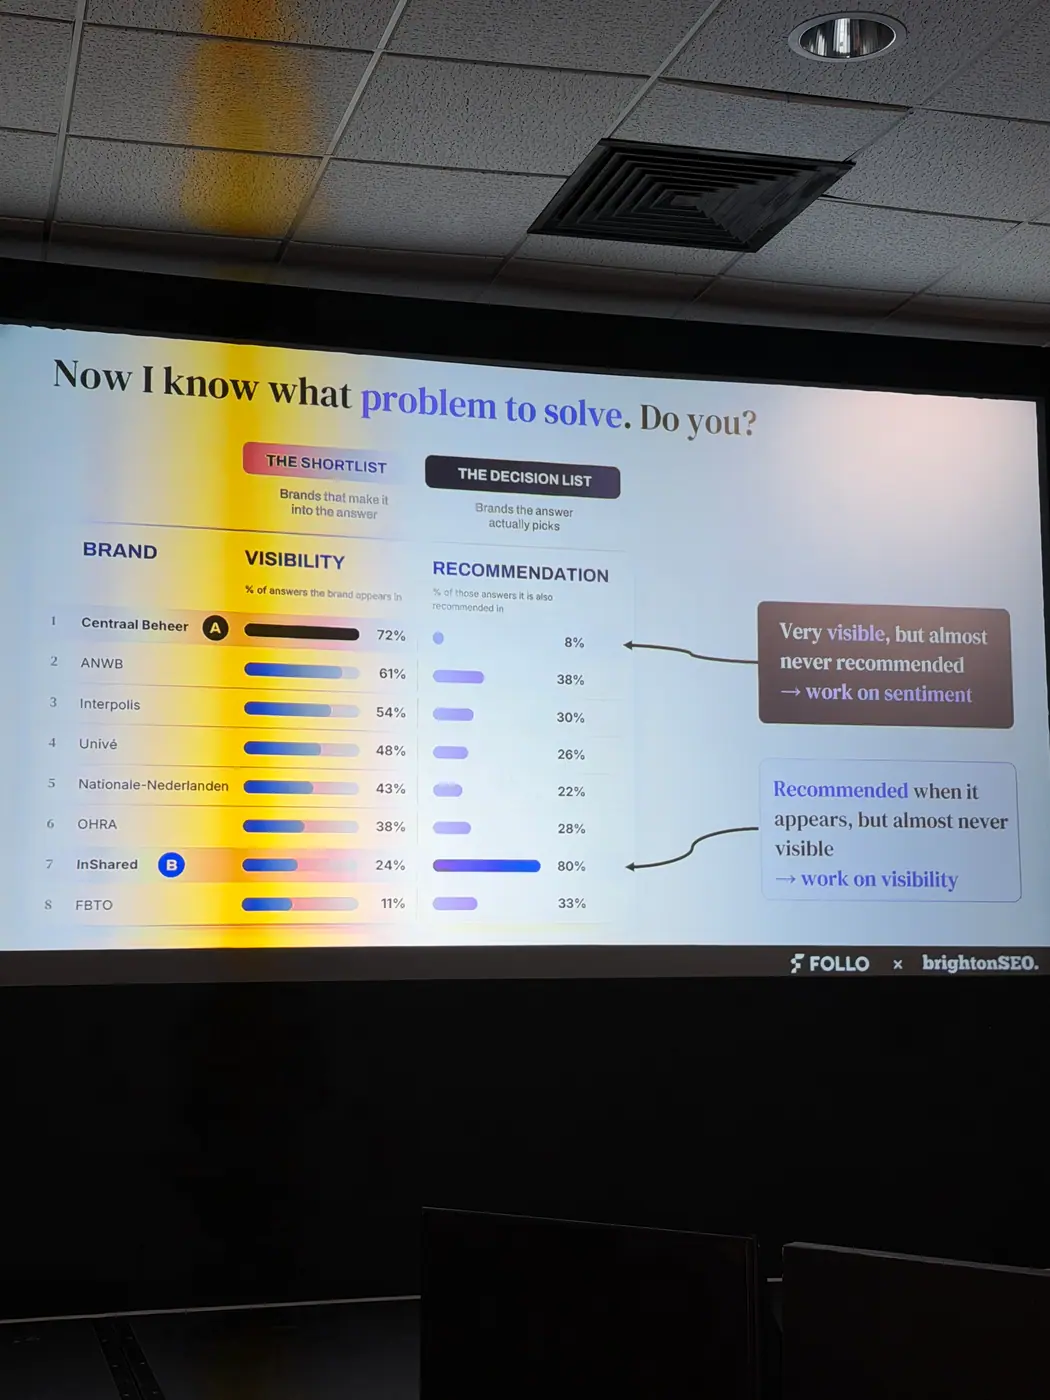
Prelegent rozdzielił wykrywanie nazw marek od rozpoznawania, którą z nich model wskazał jako preferowany wybór. Marka może pojawiać się w zestawieniu, ale przegrywać z konkurentem rekomendowanym wprost.
Praktyczna rada: obok obecności marki raportuj, czy została polecona, czy jedynie wymieniona.Stabilny procent widoczności może ukrywać istotne zmiany.
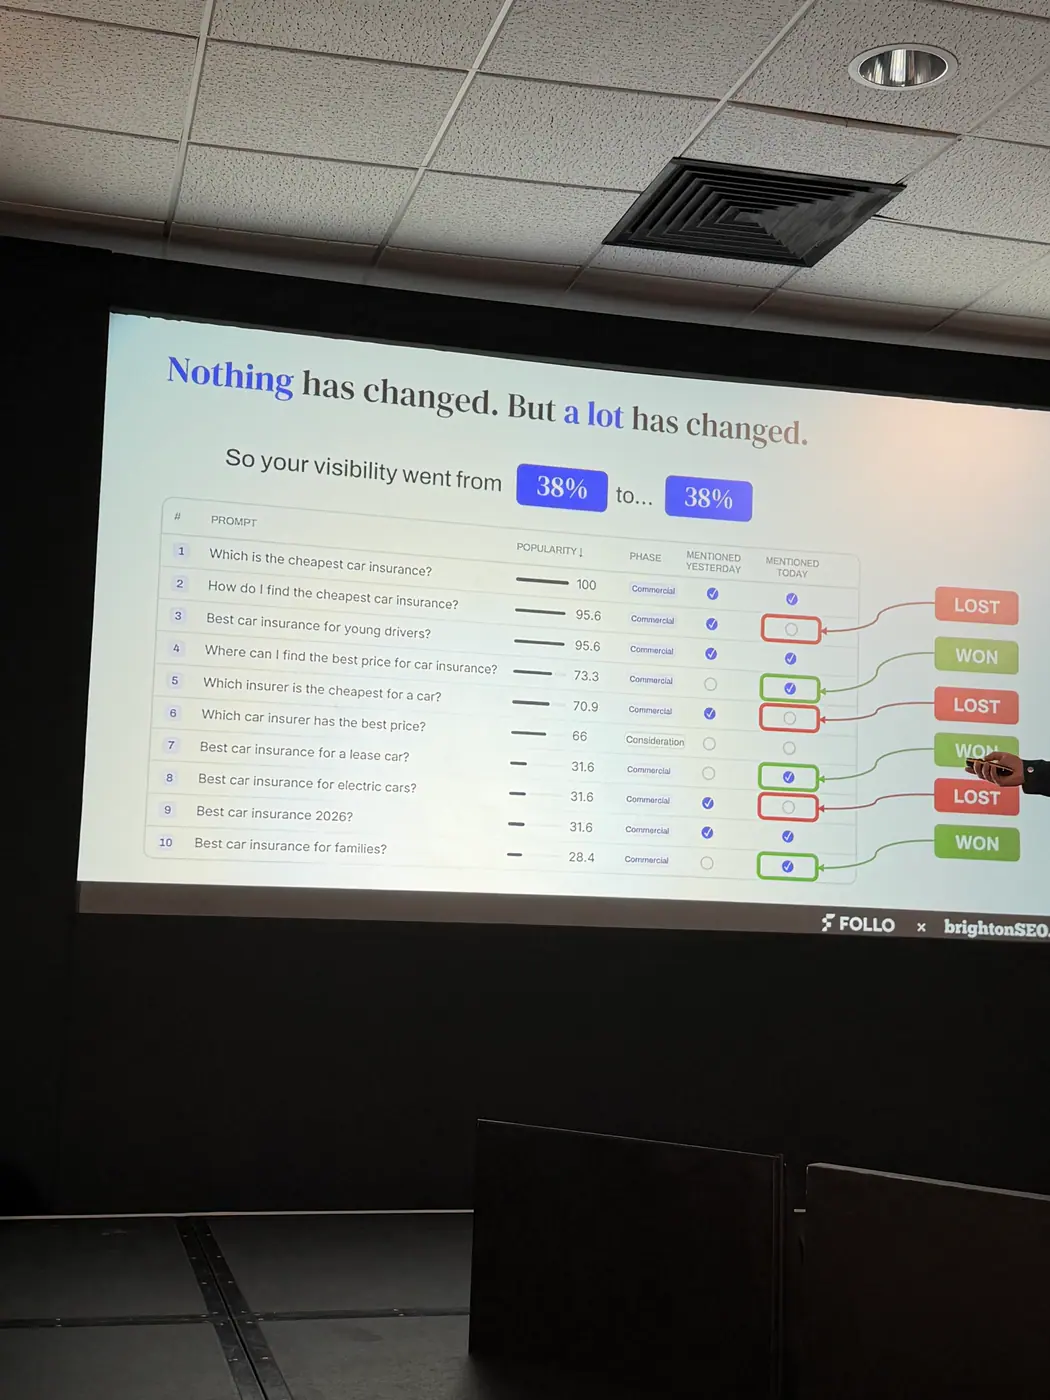
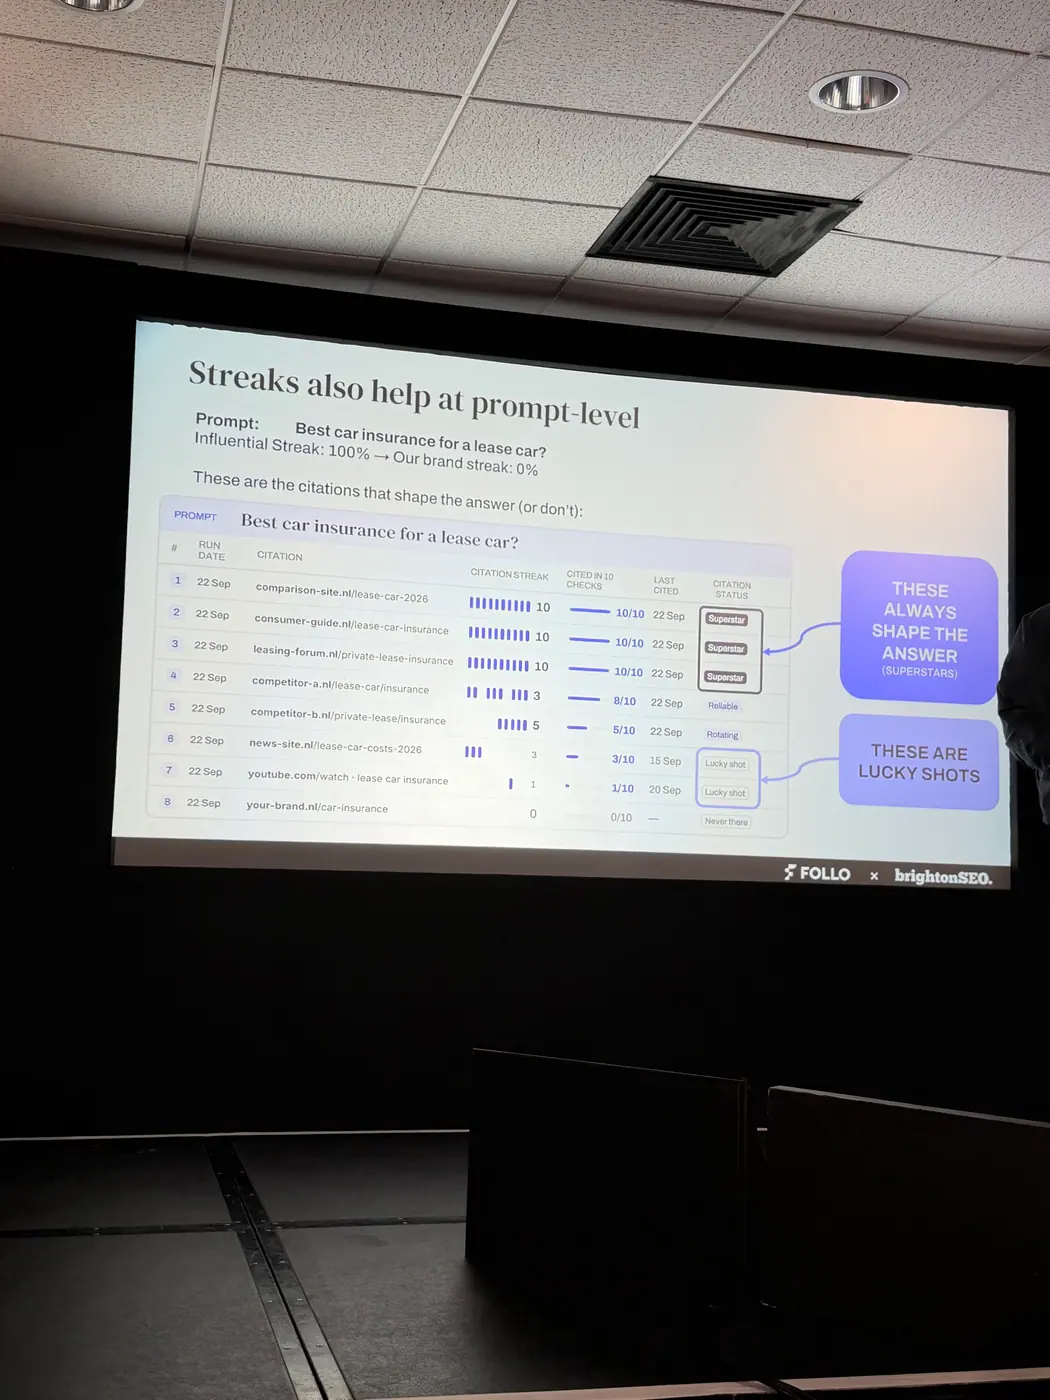
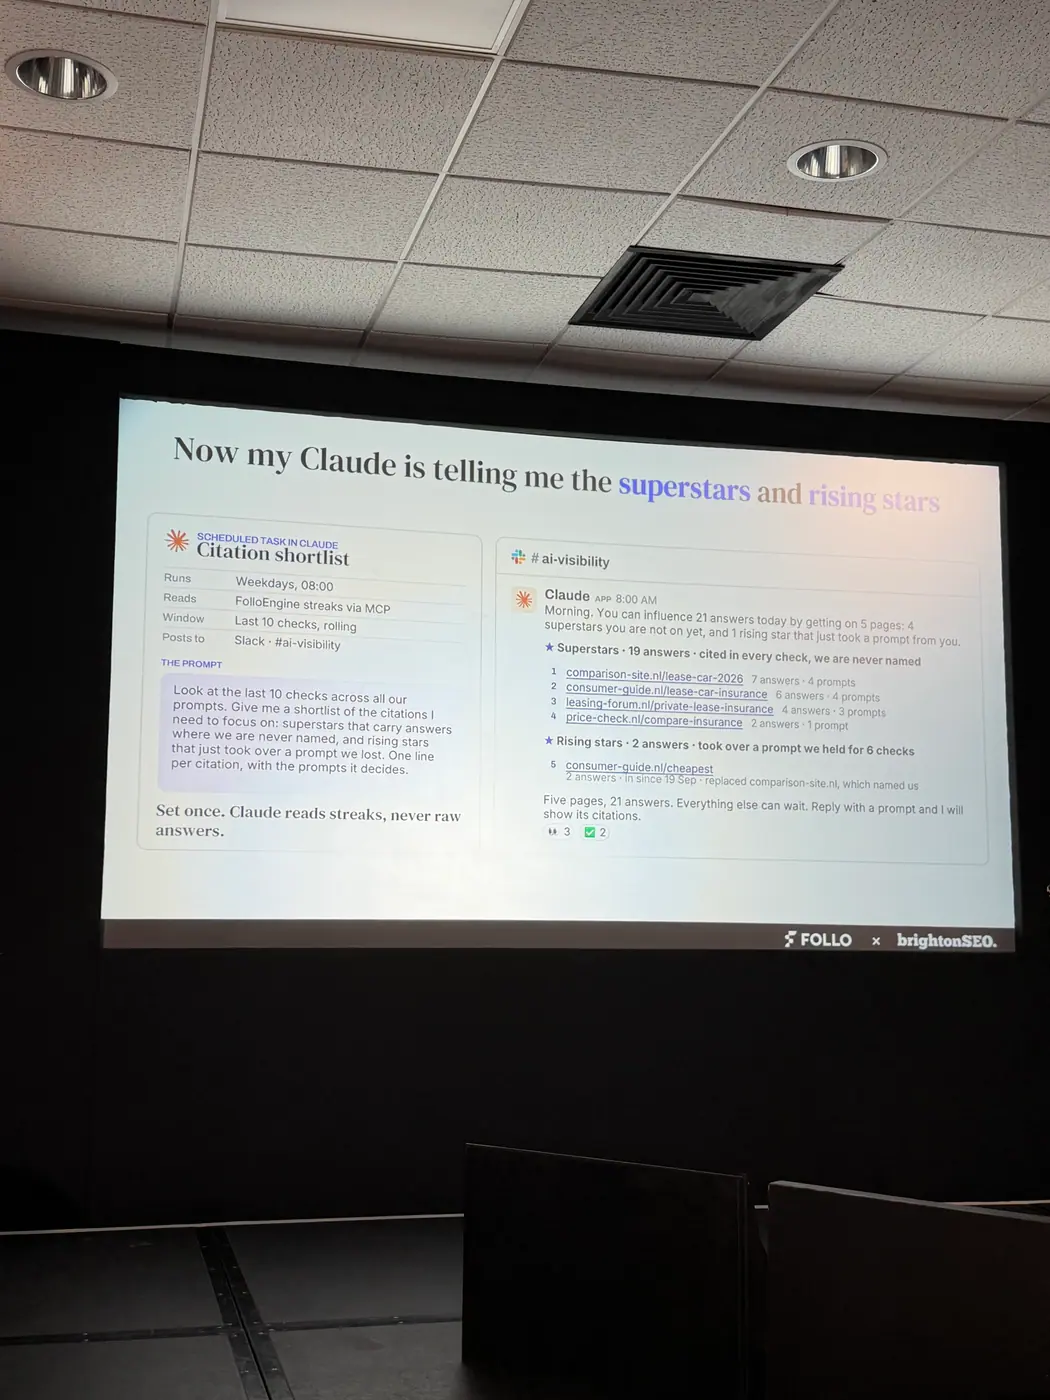
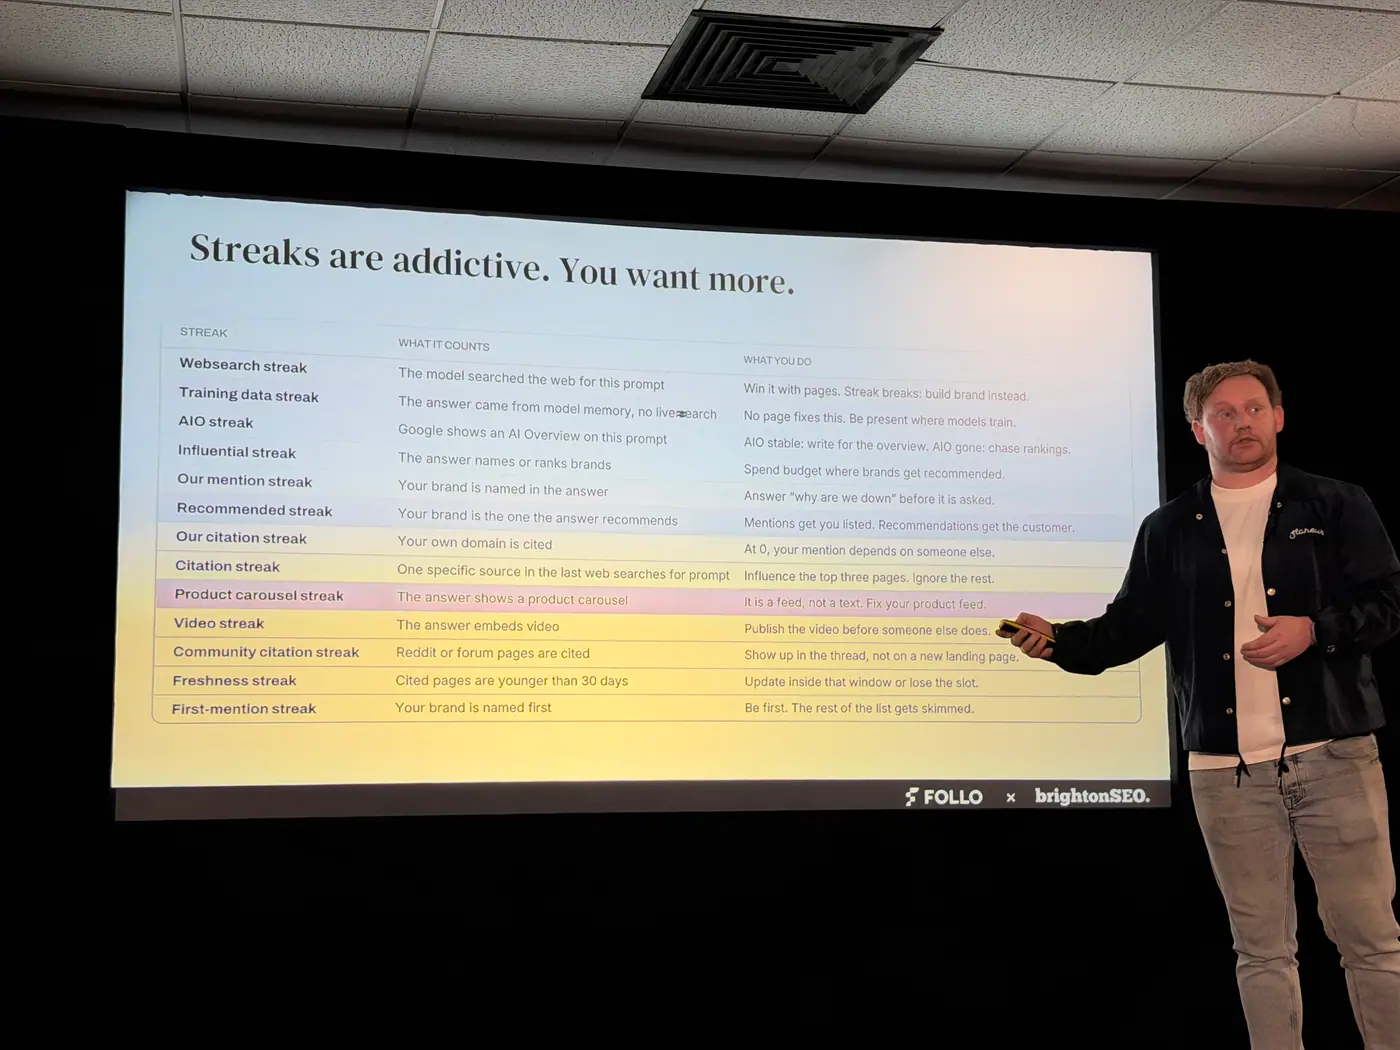
Bergmans analizował streaks, czyli serie kolejnych obserwacji tych samych zapytań, marek i źródeł. Odróżniał źródła stale obecne od pojawiających się sporadycznie oraz zyskujących lub tracących znaczenie.
Praktyczna rada: monitoruj utracone i zdobyte odpowiedzi oraz zmiany cytowanych stron, zamiast ograniczać raport do jednej średniej.Liczy się także wielkość fragmentu odpowiedzi przypisanego do źródła.
Prelegent analizował chunks, czyli fragmenty odpowiedzi powiązane z cytowaniami. Pokazał różnicę między częstym cytowaniem niewielkich fragmentów a dostarczaniem treści stanowiących dużą część odpowiedzi.
Praktyczna rada: porównuj tematy i zakres cytowanych fragmentów z własnymi treściami. Rozdzielaj źródła własne od zewnętrznych. Ustalaj, co trzeba stworzyć, co poprawić, a co już skutecznie trafia do odpowiedzi.Tabele porównawcze ujawniają kryteria wyboru produktów.
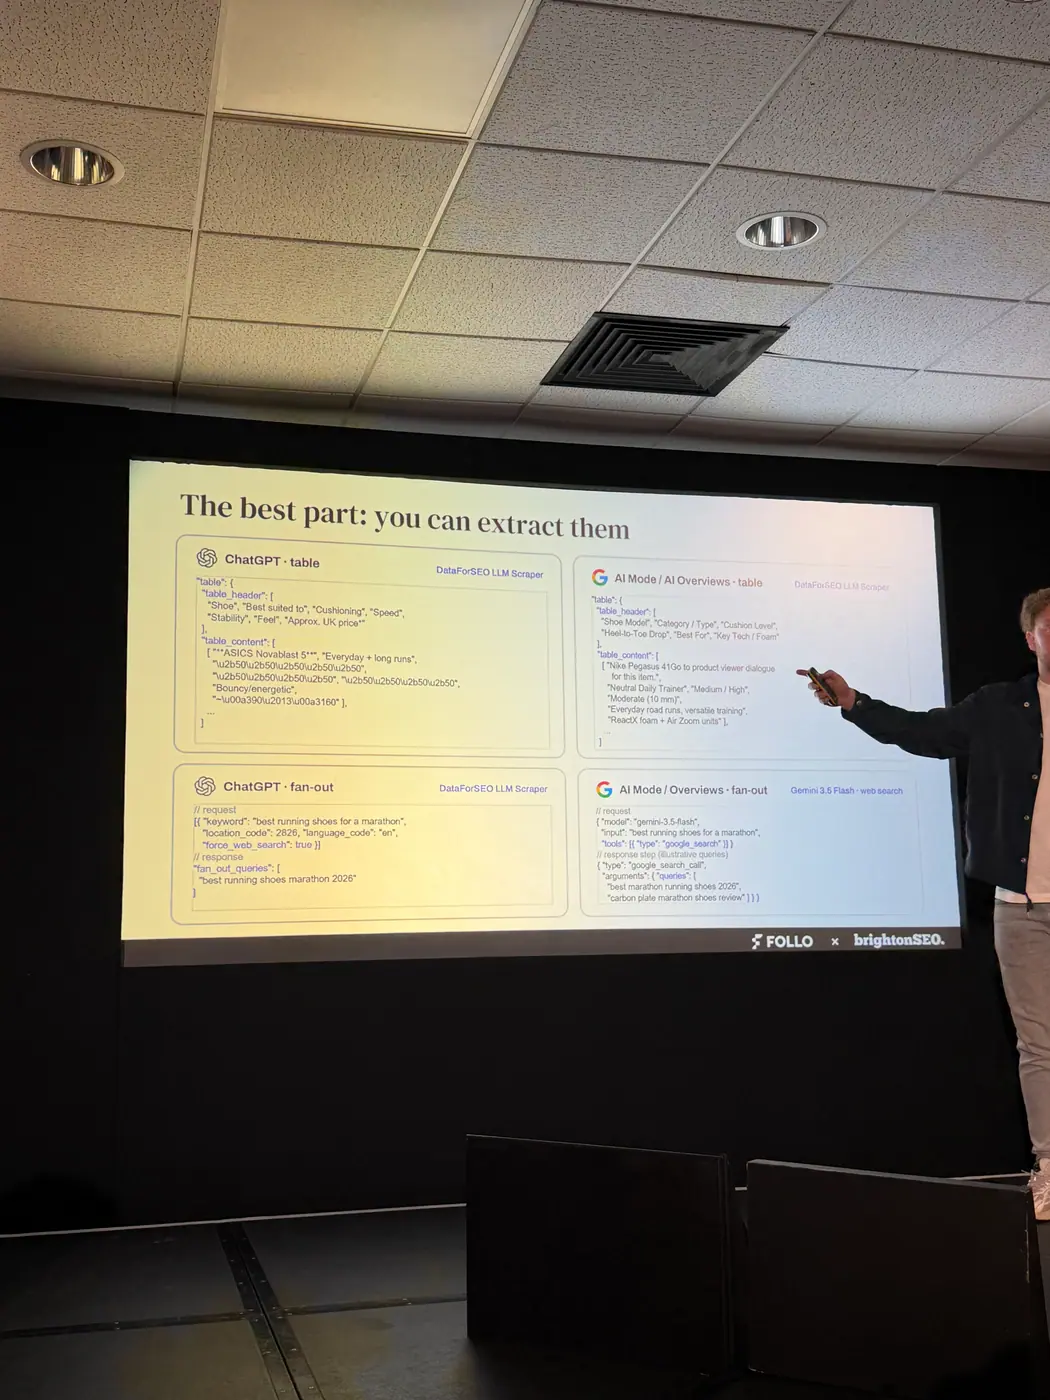
W przykładzie dotyczącym butów do biegania modele porównywały m.in. podeszwę, przeznaczenie terenowe, wodoodporność i głębokość bieżnika.
Praktyczna rada: sprawdzaj, czy cechy regularnie wykorzystywane w porównaniach są jasno opisane na kartach produktów i w feedach, czyli zbiorach danych produktowych.Zapytanie użytkownika nie wyczerpuje informacji poszukiwanych przez agenta.
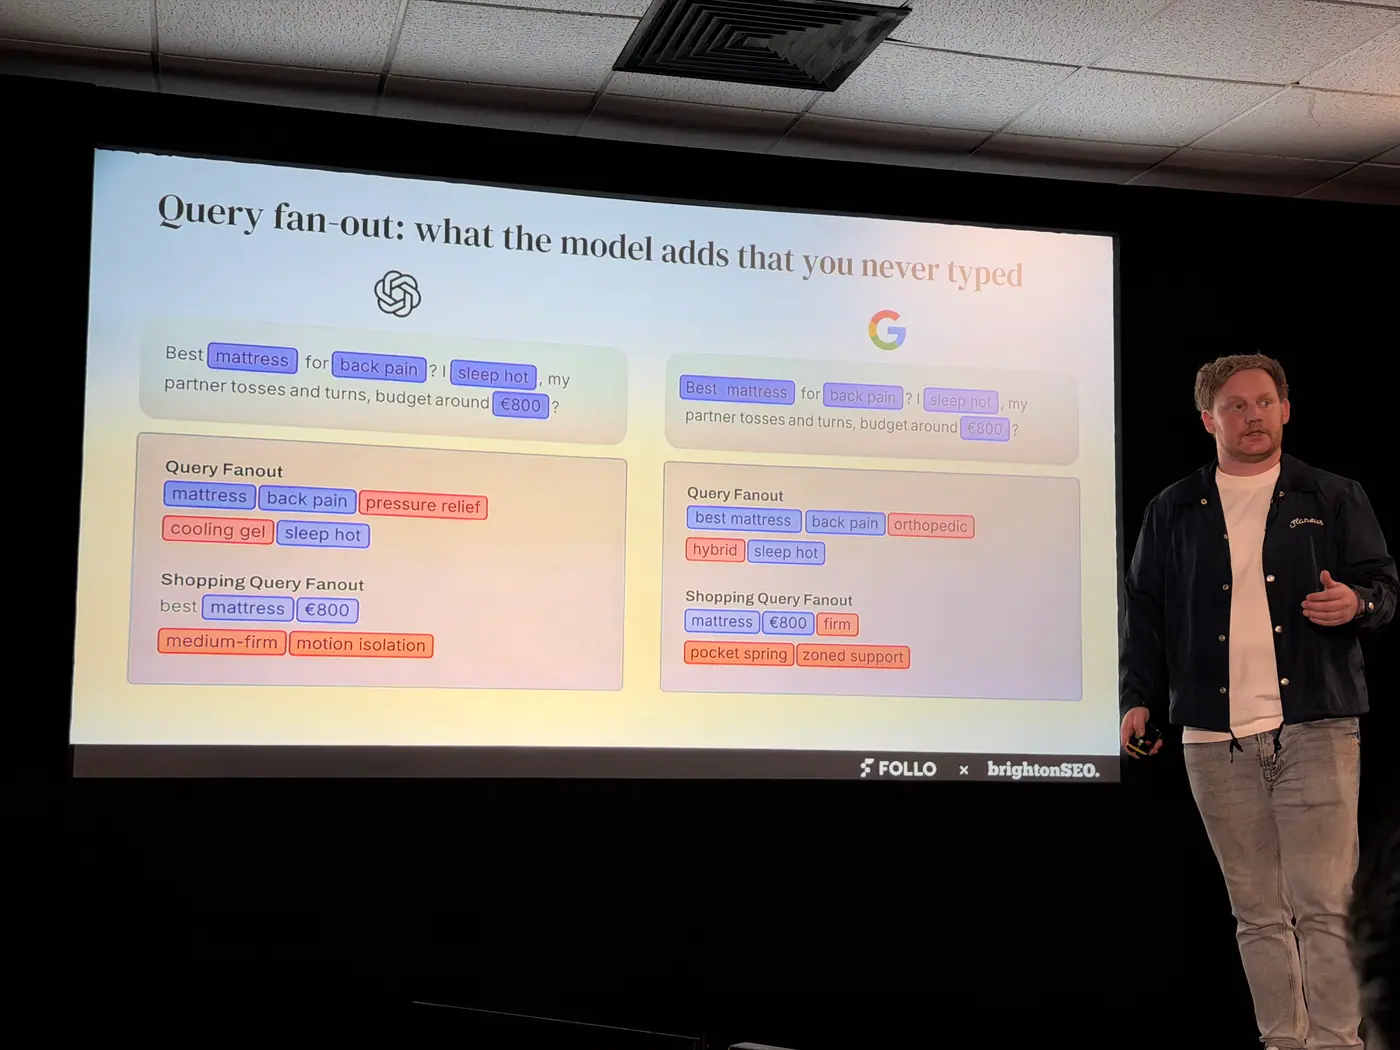
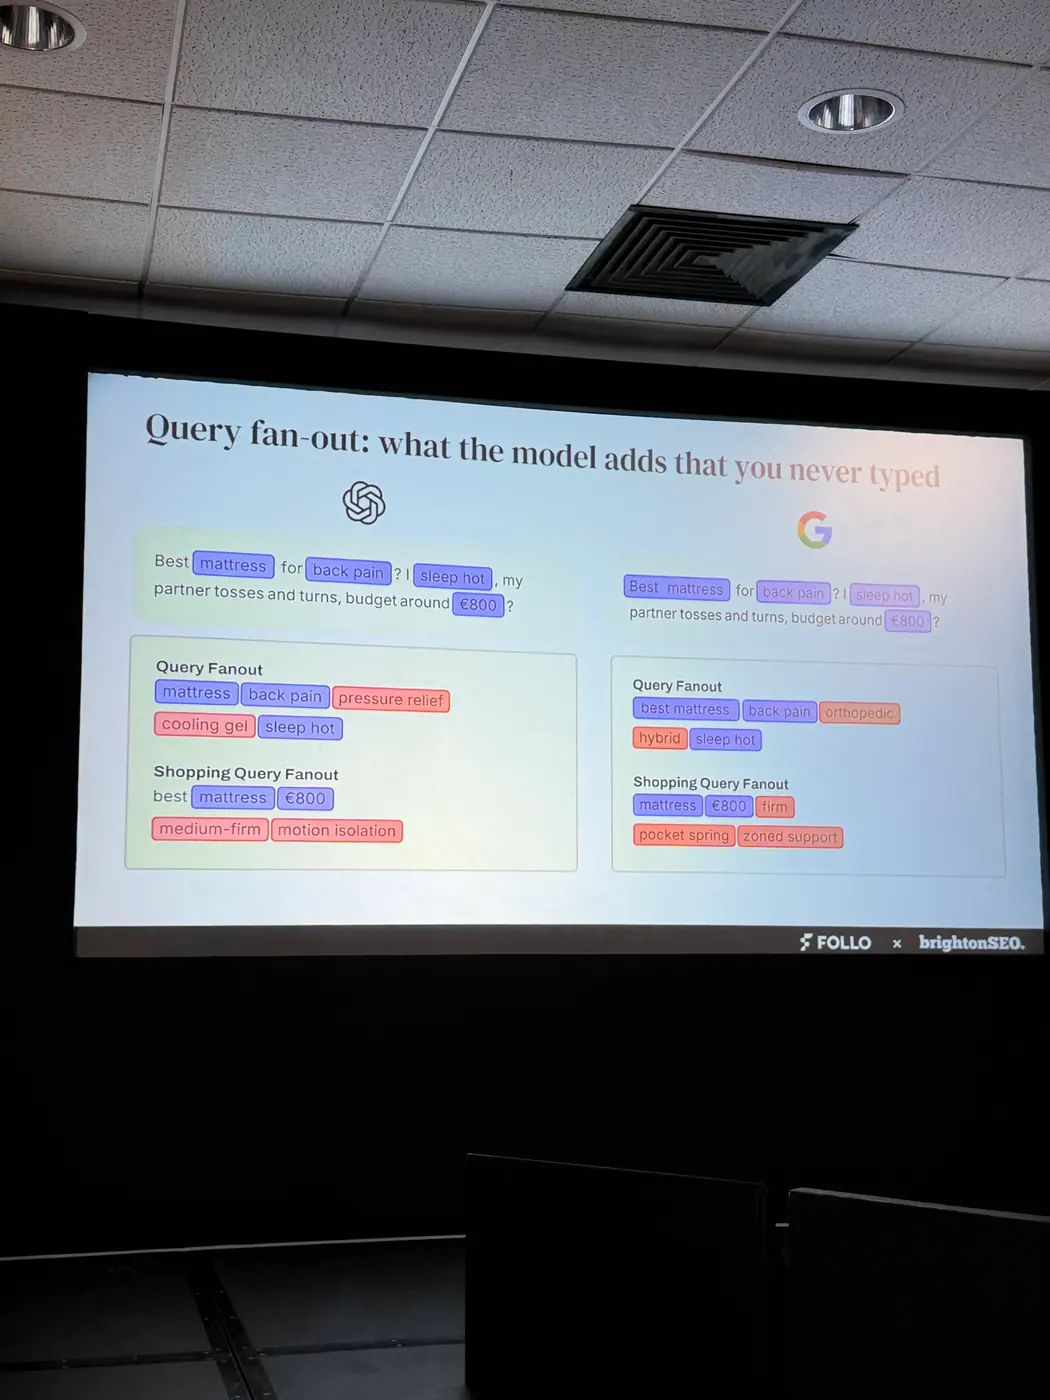
Bergmans analizował query fan-outs, czyli dodatkowe zapytania rozwijające pierwotne pytanie użytkownika. Zawierały one cechy i wymagania niewymienione wprost w pytaniu.
Praktyczna rada: wykorzystuj dostępne zapytania rozwijające do identyfikacji brakujących informacji produktowych. Prelegent traktował ich uzupełnianie jako sposób na zwiększenie szans na obecność i rekomendację, nie jako gwarancję wyniku.Wymagane pola feedu to nie to samo co pełny kontekst produktu.
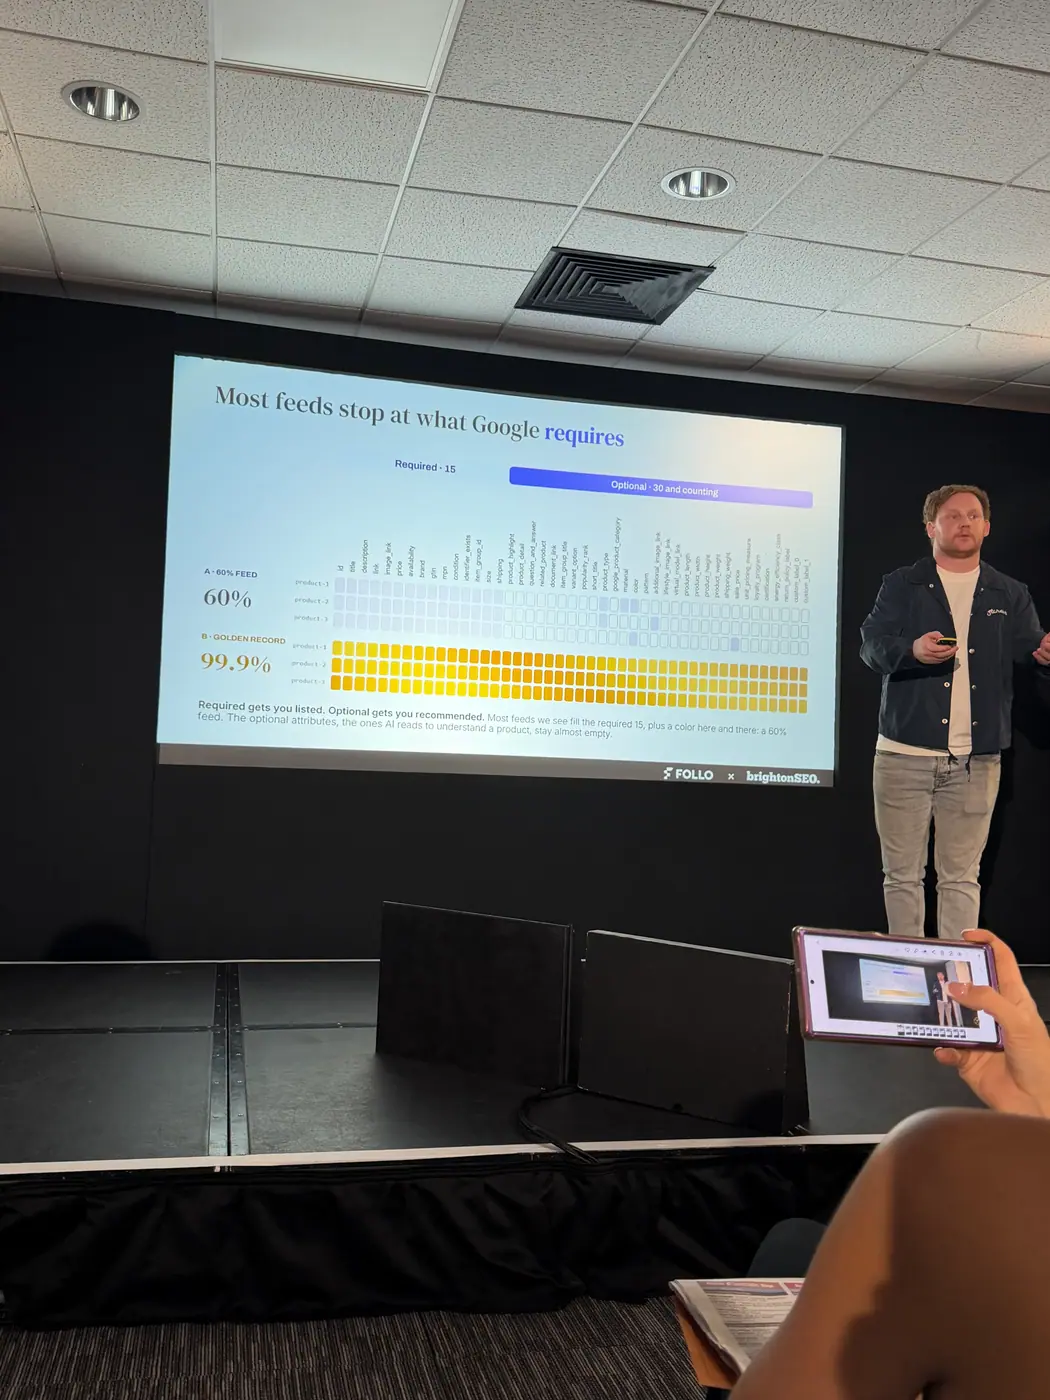
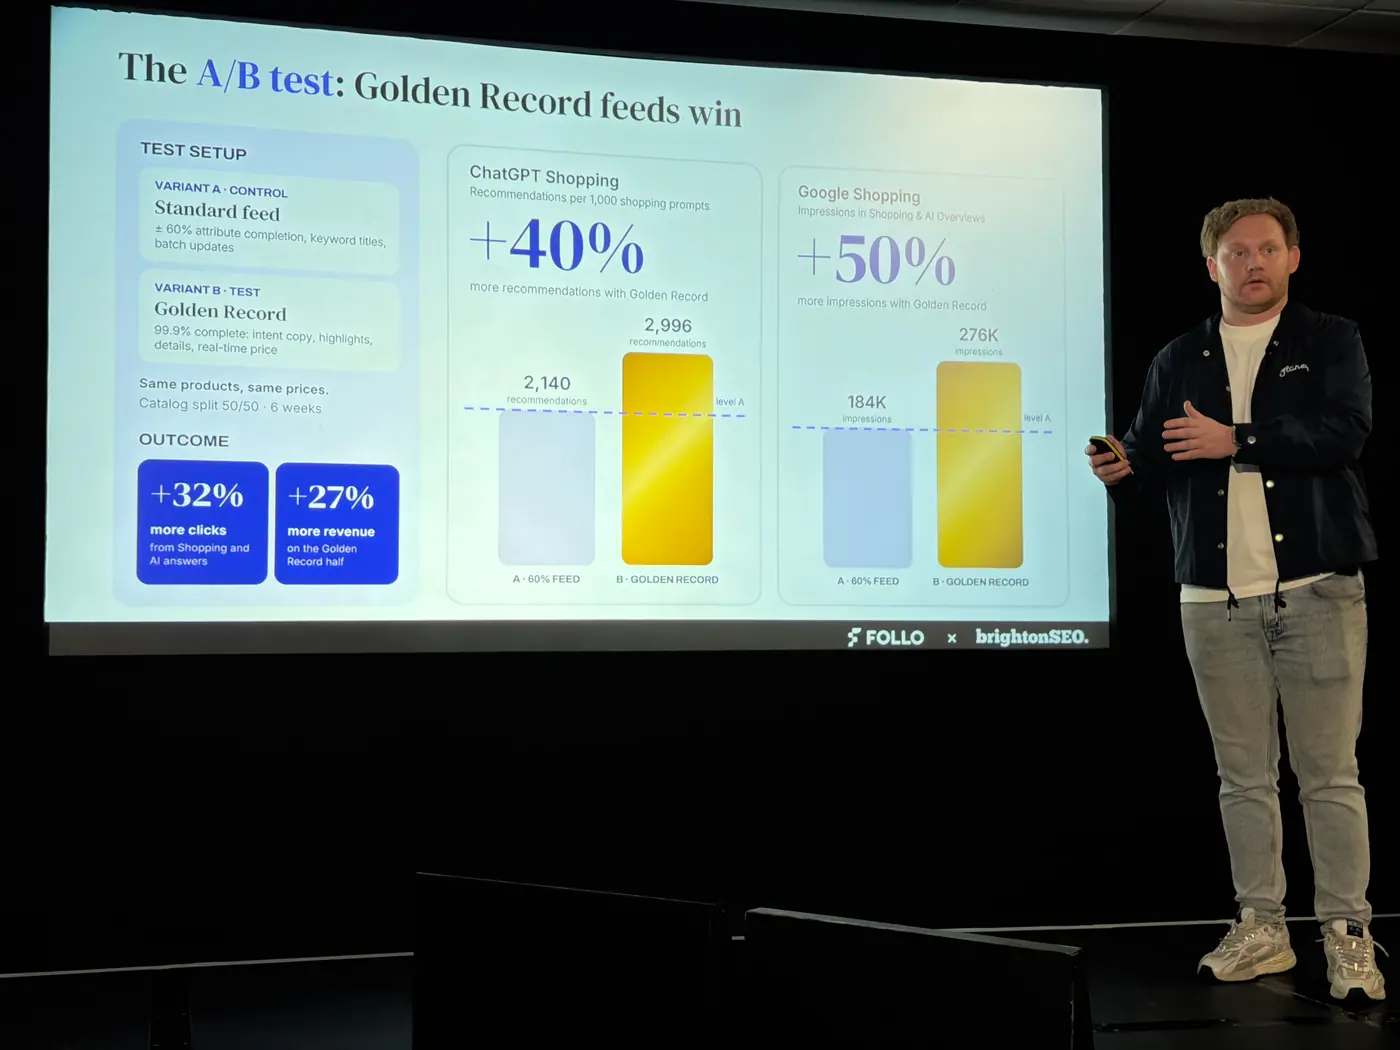
Prelegent promował golden record feed, czyli możliwie kompletny, wzorcowy zestaw danych produktowych. Uwzględniał w nim opisy, cechy, szczegóły oraz pytania i odpowiedzi. Według jego relacji pełniejsze feedy wygrywały w testach porównawczych pod względem widoczności; raportował też wzrost kliknięć i przychodu.
Praktyczna rada: audytuj nie tylko poprawność wymaganych pól, lecz także informacje potrzebne do porównania i wyboru produktu. W opisywanym przez niego przypadku europejskim dane Google Shopping były wykorzystywane również przez ChatGPT Shopping.
Dane liczbowe i przykłady
| Dane | Co wynikało z prezentacji | Charakter informacji |
|---|---|---|
| 0–1% | Taki udział ruchu i konwersji z modeli prelegent widział w swojej analityce. | Własna obserwacja |
| Niemal połowa klientów | W rozmowach wskazywała kontakt z modelem jako sposób znalezienia agencji. | Deklaracje klientów, nie udział w przychodzie |
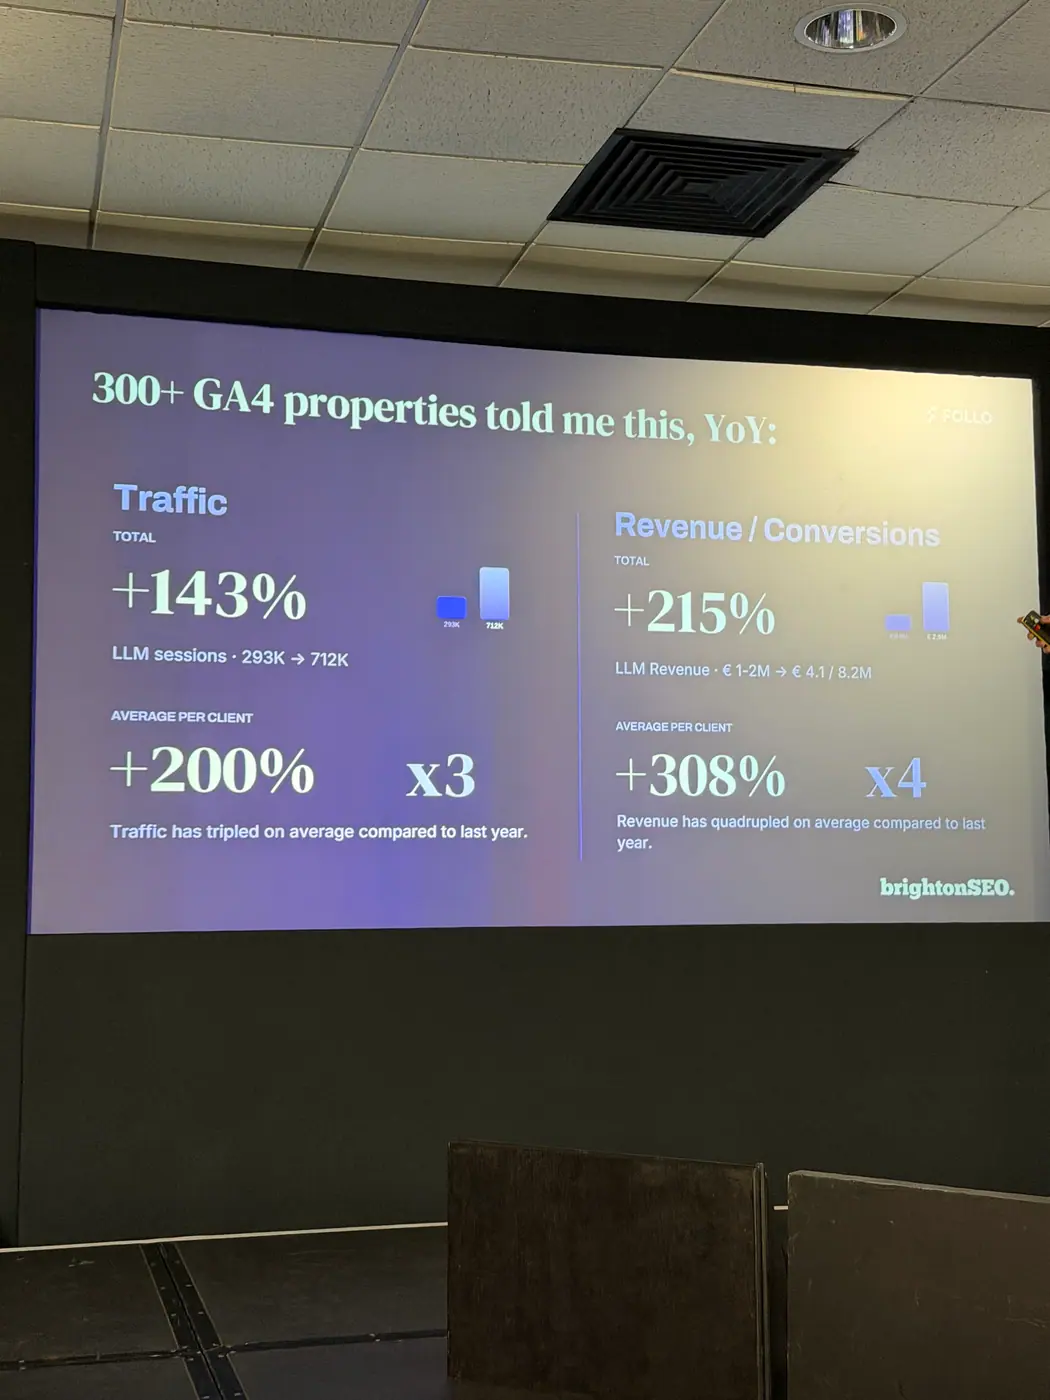
| 3× więcej ruchu, 4× więcej konwersji | Taką zmianę rok do roku Bergmans raportował dla ruchu z modeli. Chodziło o liczbę konwersji, nie współczynnik konwersji. | Dane z analizowanych właściwości analitycznych |
| 80% analizowanych właściwości: poniżej 1% | W większości analizowanych właściwości analitycznych udział ruchu i konwersji przypisanych modelom pozostawał poniżej 1%. | Wynik z bazy klientów prelegenta |
| 5% | Tyle wynosił udział ruchu i konwersji z modeli w najlepiej wypadającej właściwości w jego bazie. | Najlepszy zaobserwowany przypadek |
| Co najmniej 50× | Tak prelegent szacował możliwą skalę niedoszacowania wpływu modeli przez analitykę. | Szacunek prelegenta, nie uniwersalny mnożnik |
| Ponad 30 agentów | Tylu agentów analizowało dane klientów w jego własnym systemie. | Opis rozwiązania |
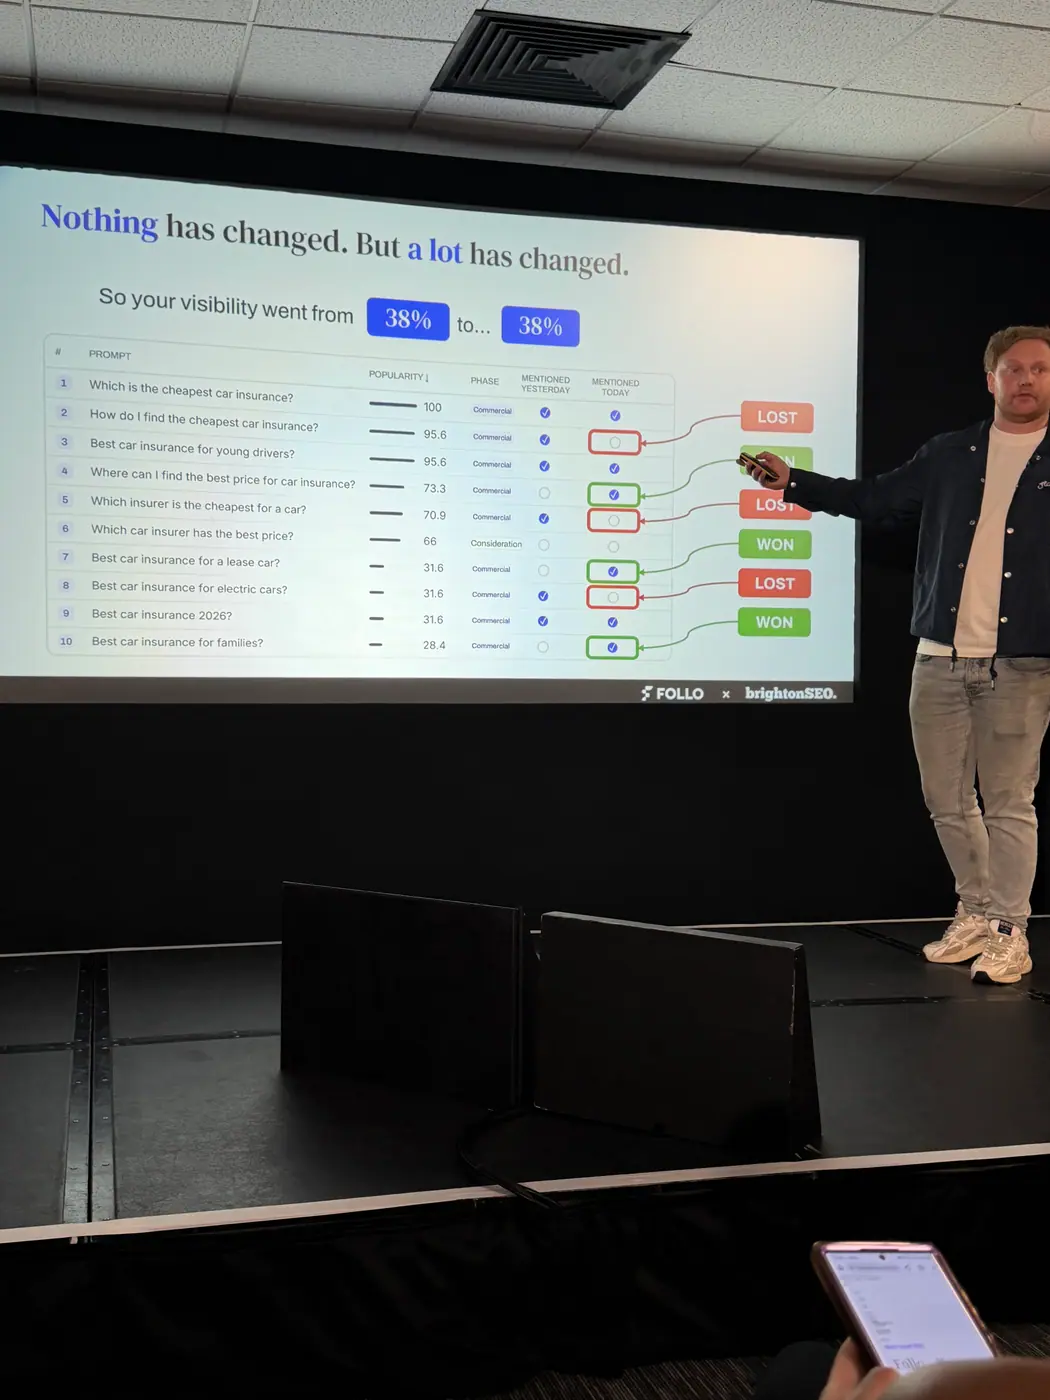
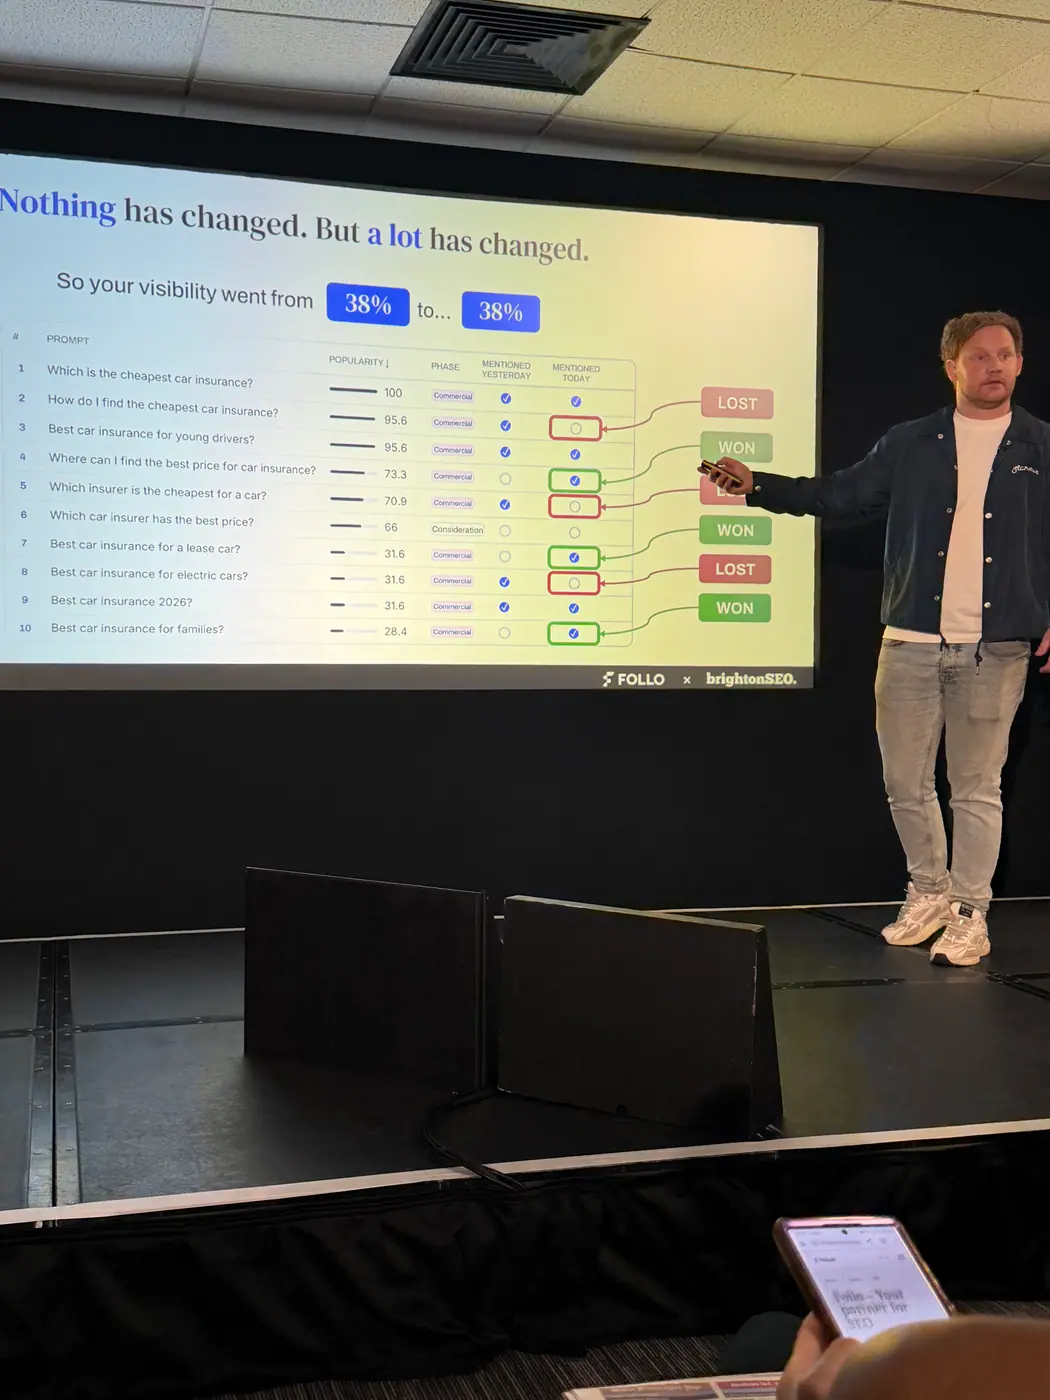
| 38% → 38% | Przykład niezmienionej widoczności mimo utraty części odpowiedzi i zdobycia innych. | Ilustracja ograniczeń wskaźnika zbiorczego |
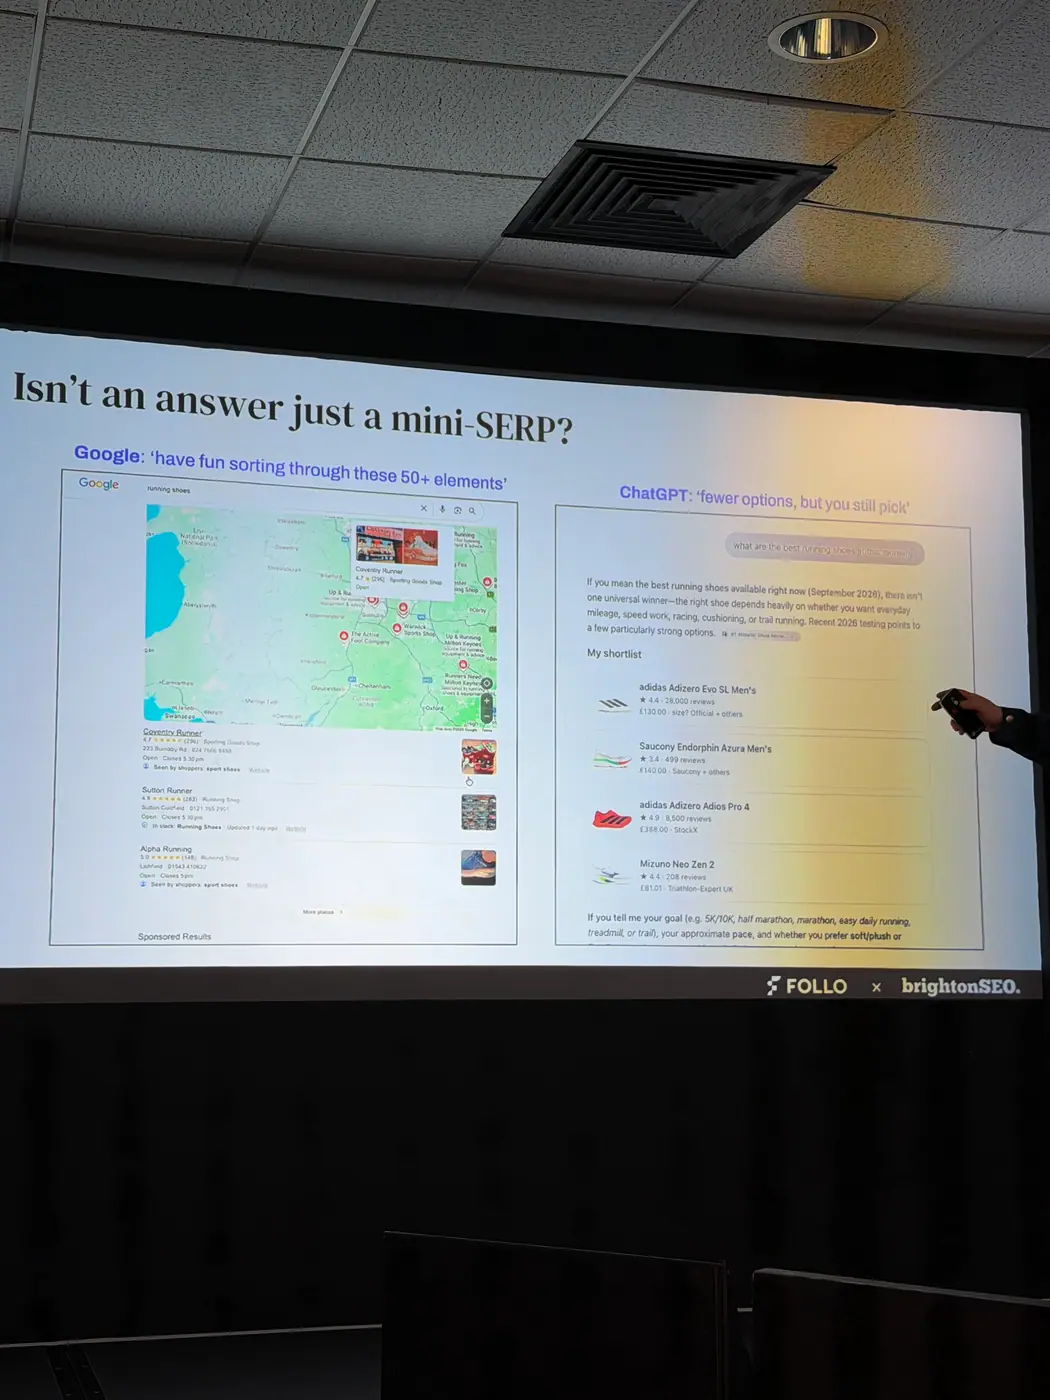
| Ponad 50 elementów vs 3–5, czasem 7 propozycji | Tak Bergmans zilustrował różnicę między tradycyjnymi wynikami a krótszą listą propozycji w odpowiedzi modelu. | Przykład porównania interfejsów |
| Około 60% vs 99+% | Tak opisywał niepełne feedy i docelowy golden record feed. | Ilustracja kompletności danych, nie wynik wzrostu sprzedaży |
Knowledge bombs
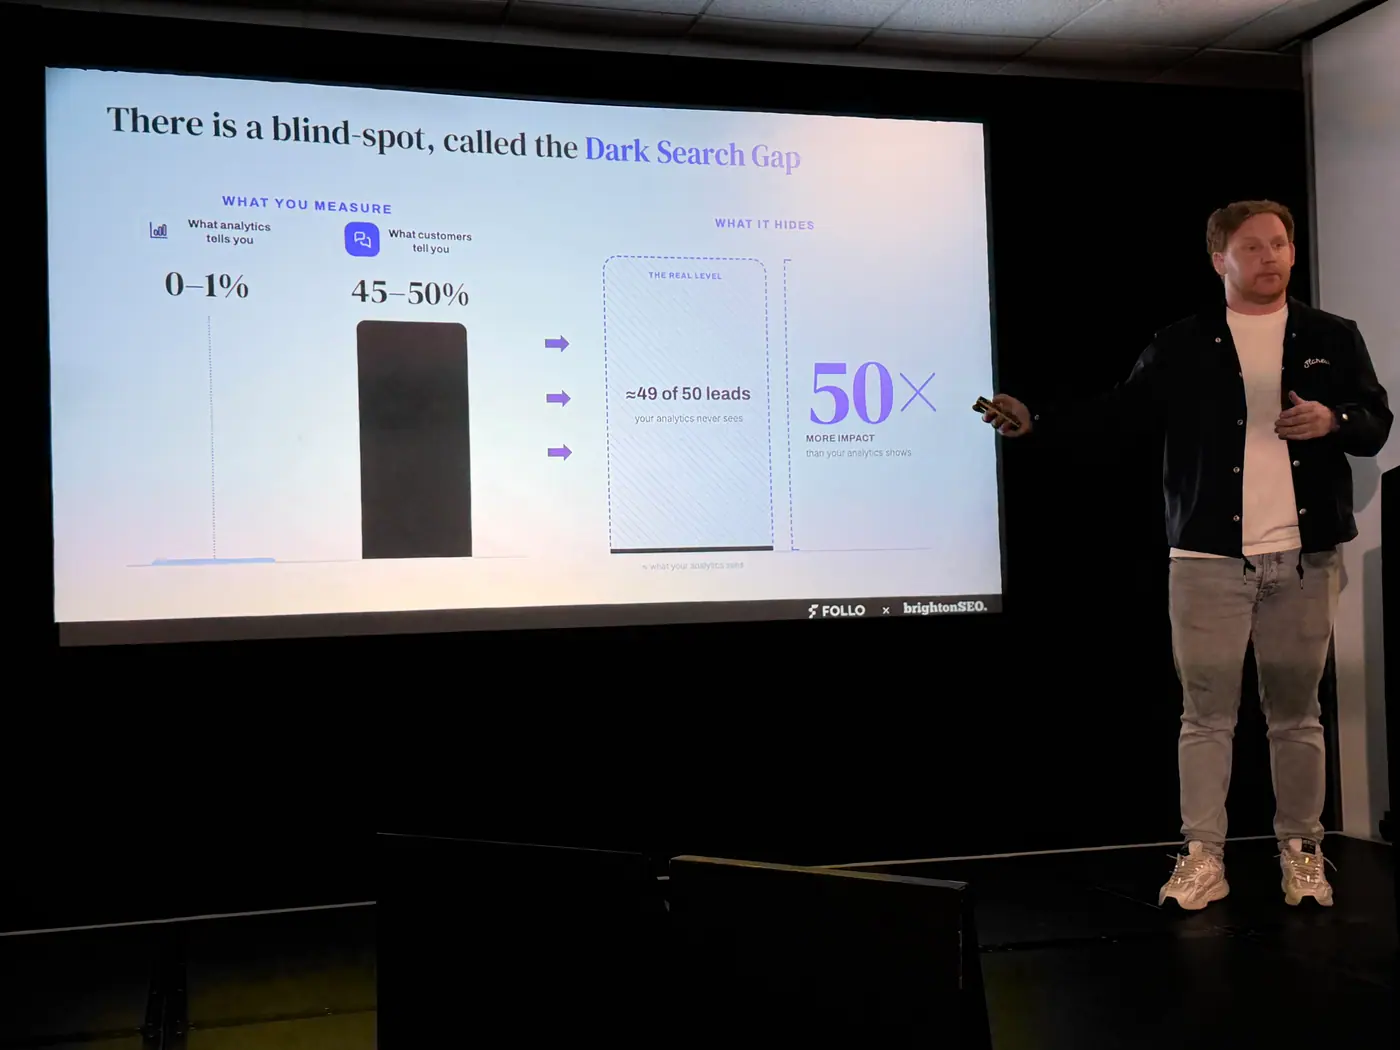
1. Analityka pokazuje 0–1% ruchu z LLM-ów, a połowa klientów mówi, że znalazła firmę w rozmowie z chatbotem.
Bergmans nazywa to „dark search gap”: wpływ odpowiedzi AI na decyzje jest kilkadziesiąt razy większy niż to, co raportuje Google Analytics, bo większość ścieżek z odpowiedzi nie kończy się kliknięciem w link. Budżety idą tam, gdzie widać konwersję po kliknięciu, czyli do płatnych mediów, a GEO (Generative Engine Optimization, optymalizacja pod odpowiedzi generowane przez AI) i organic social zostają bez kredytu.
„I only see zero to 1% in my analytics, traffic from LLMs, conversion from LLMs. But when I talk to my clients, almost half of them are saying, okay, we found you in a conversation with an LLM.”
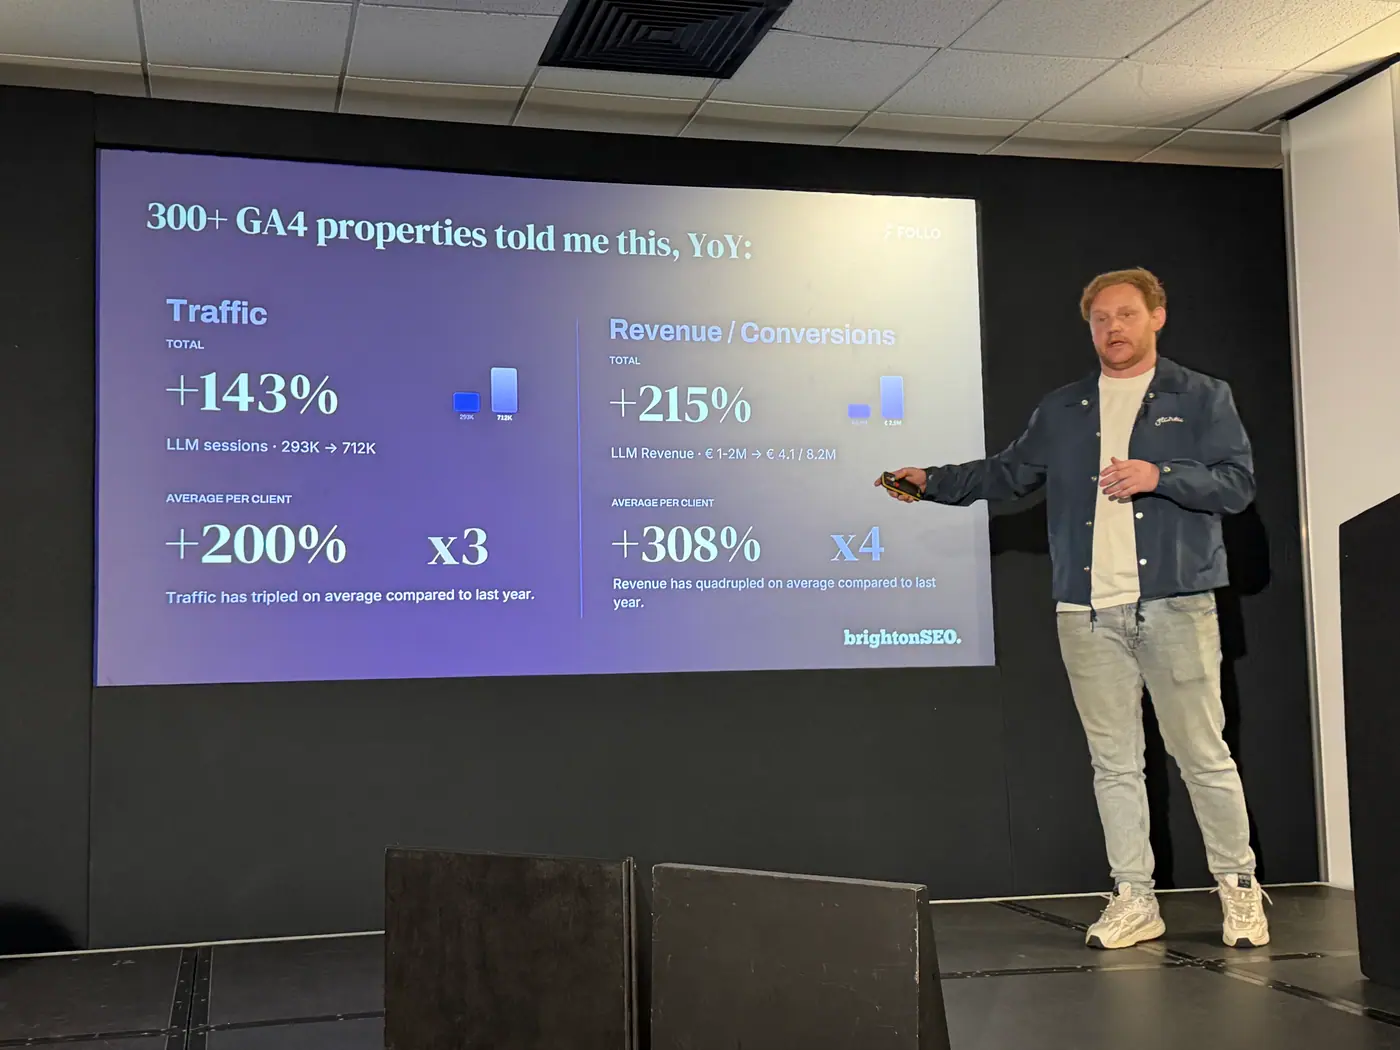
2. Ruch z LLM-ów rośnie 3x rok do roku, konwersje 4x, ale w 80% serwisów to nadal mniej niż 1% całości.
Dane z całego portfela klientów agencji: dynamika jest wysoka, ale udział mały; rekordowy serwis ma 5% ruchu i konwersji z LLM-ów. Wniosek dla właściciela firmy: samo mierzenie „ruchu z ChatGPT” w analityce nie pokaże skali zjawiska, bo mierzy tylko ostatni etap ścieżki.
„So three times the traffic compared to last year, and in conversions, even four times.”
3. AI visibility nie jest nowym świętym Graalem – mierz działania, które następują po odpowiedzi.
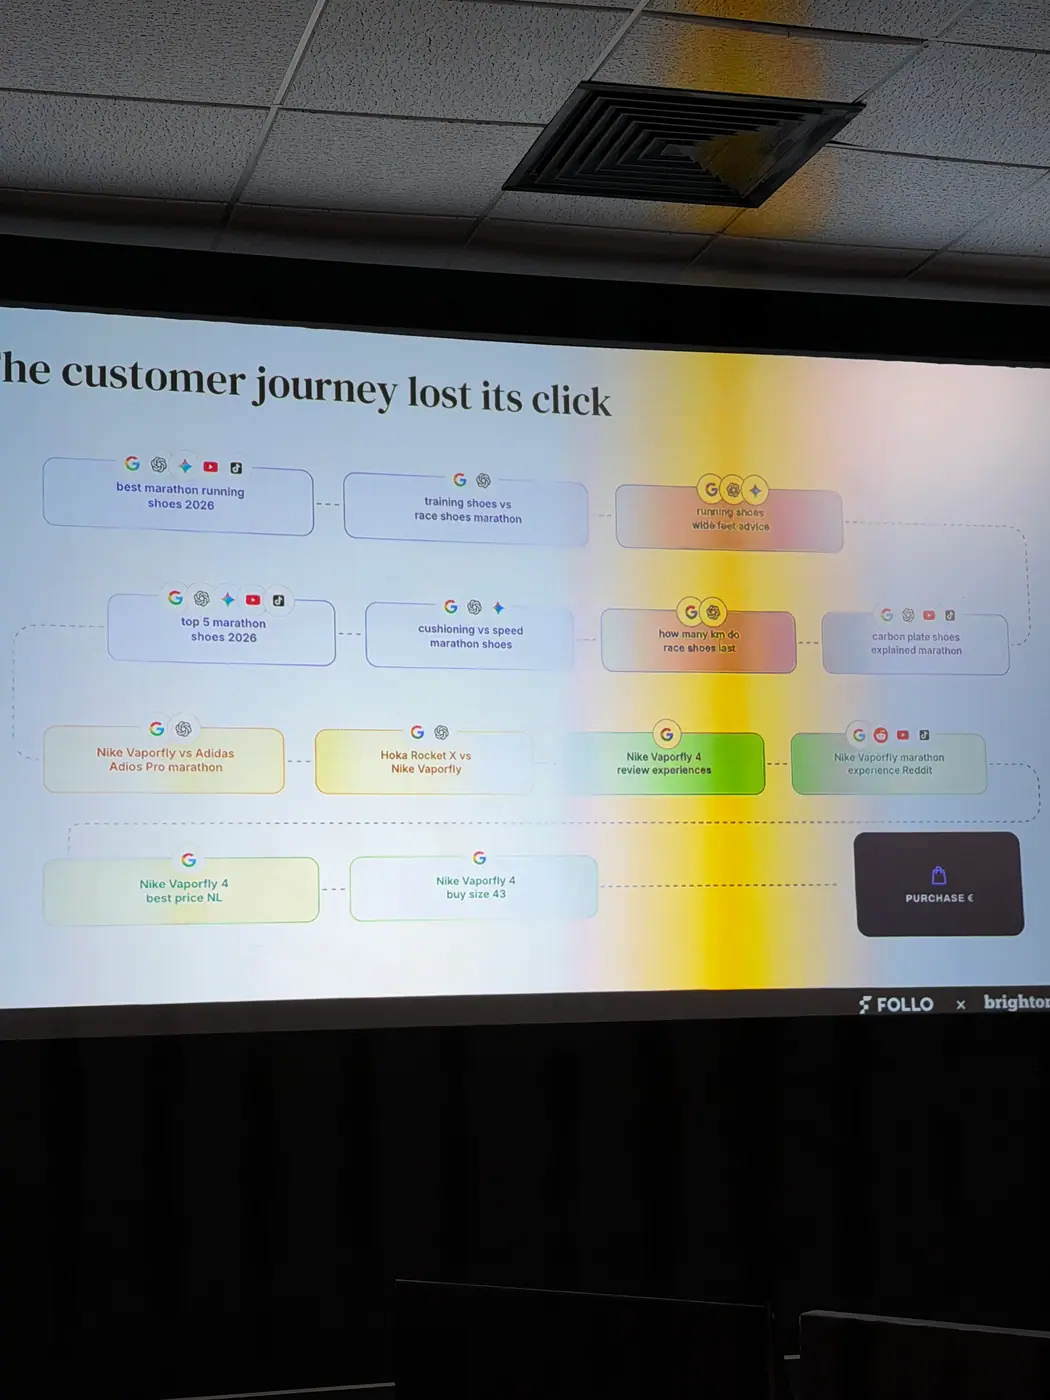
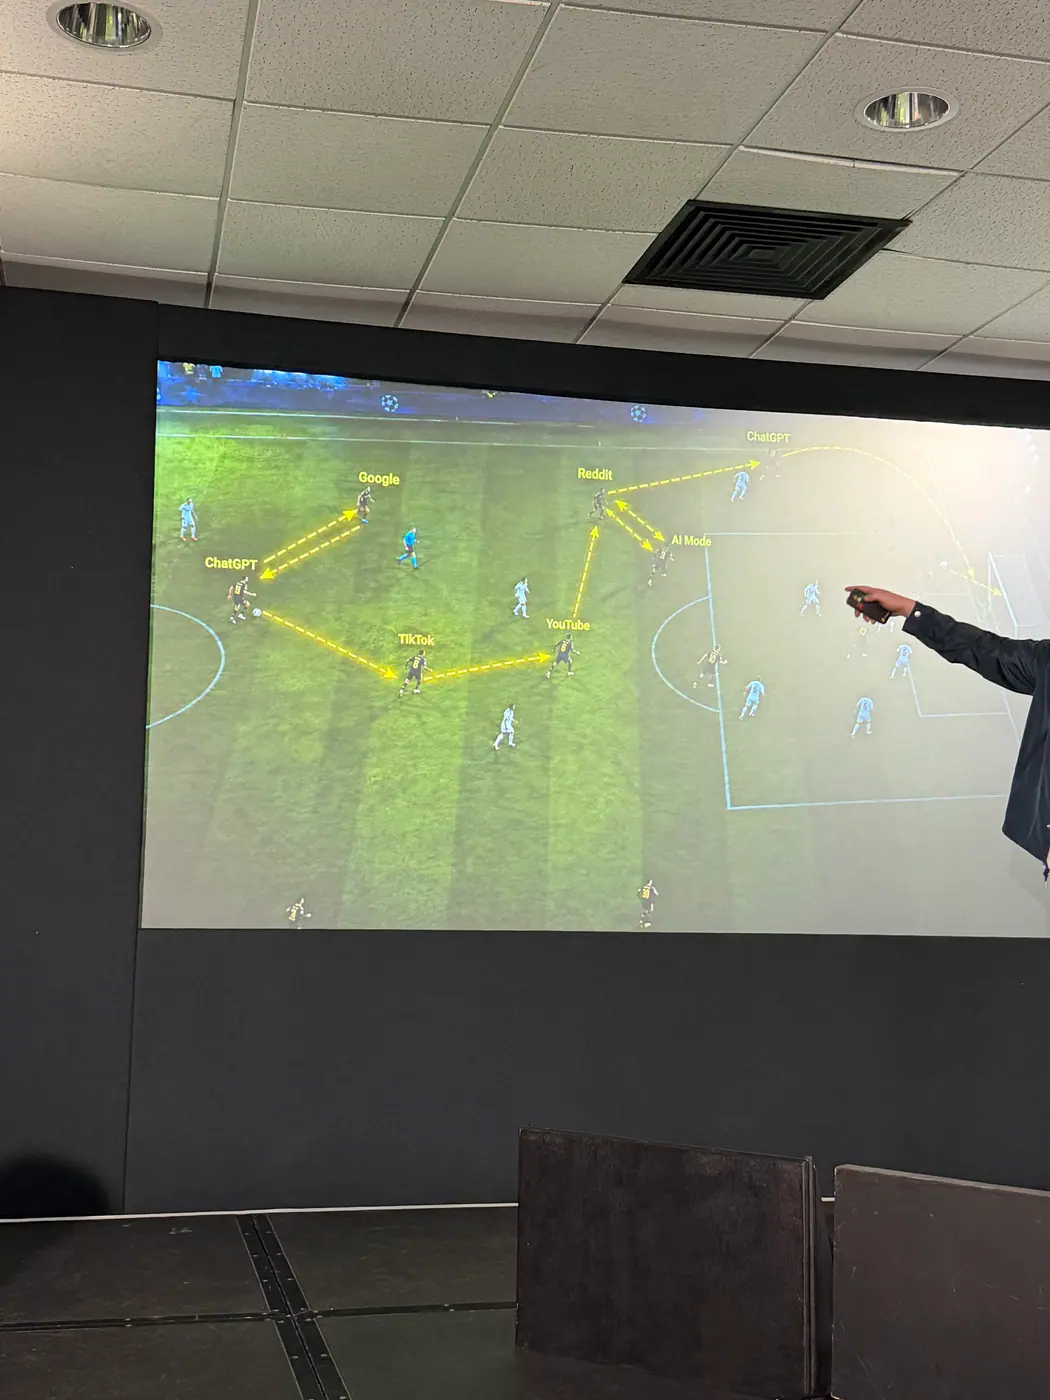
Po odpowiedzi użytkownik zwykle nie klika: wpisuje markę w Google, wchodzi bezpośrednio, dopytuje LLM albo odkłada decyzję na wieczór. Dlatego obok widoczności w odpowiedziach Bergmans zestawia w jednym modelu wolumen zapytań brandowych, wejścia na stronę główną, wzrosty w PPC (reklamie płatnej) i SEO oraz pole „skąd o nas wiesz” w formularzu kontaktowym, i na tej podstawie liczy wpływ LLM-ów na przychód.
„So if I show up more in an answer, are people going to start and search my brand name in Google more often? Maybe they visit my homepage more. I see an increase in PPC. I see an increase in SEO because people are moving from an answer into traditional search.”
4. Bycie widocznym w odpowiedzi to nie to samo co bycie rekomendowanym.
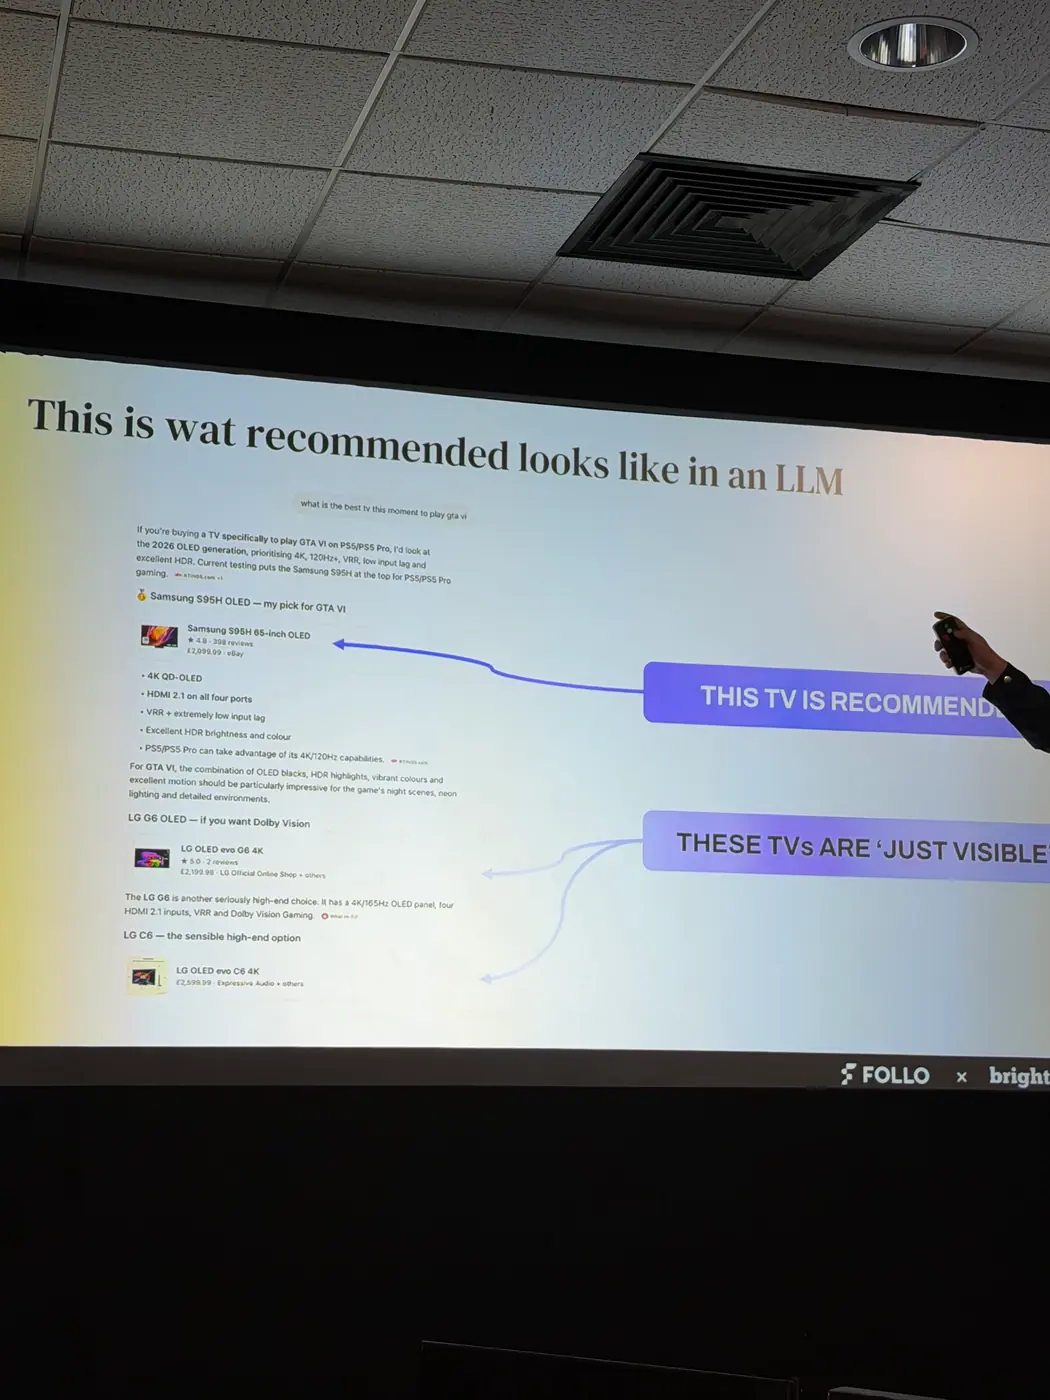
Odpowiedź wymienia 3–7 marek, ale rekomenduje zwykle jedną i to w nią klika użytkownik. Bergmans prowadzi dwa osobne agenty: ekstraktor marek (czy marka jest w odpowiedzi) i agent rekomendacji (czy jest tą wskazaną). W dashboardzie okazuje się, że jedna marka jest niemal zawsze widoczna i prawie nigdy rekomendowana, a inna odwrotnie – to dwa różne problemy wymagające różnych działań.
„And one of the things that I’ve learned is that being visible is not meaning that you’re being recommended.”
5. Procent widoczności ukrywa rotację: 38% wczoraj i 38% dziś może oznaczać, że zmieniło się wszystko.
Zamiast procentu Bergmans śledzi „streaks”, czyli serie: dla których promptów marka pojawia się stale, w których wypadła, a w których weszła. Z tego wynikają trzy kategorie cytowań – „superstars” (zawsze obecne i odpowiedzialne za wzmiankę), „rising stars” i „falling stars” (strona, która przejęła miejsce po twojej). Tę samą logikę stosuje do rekomendacji, karuzel produktowych i odpowiedzi z danych treningowych, które trudniej zmienić.
„So my visibility went from 38 to 38. Nothing happened, if you look at the percentage. But backstage a lot happened, everything changed.”
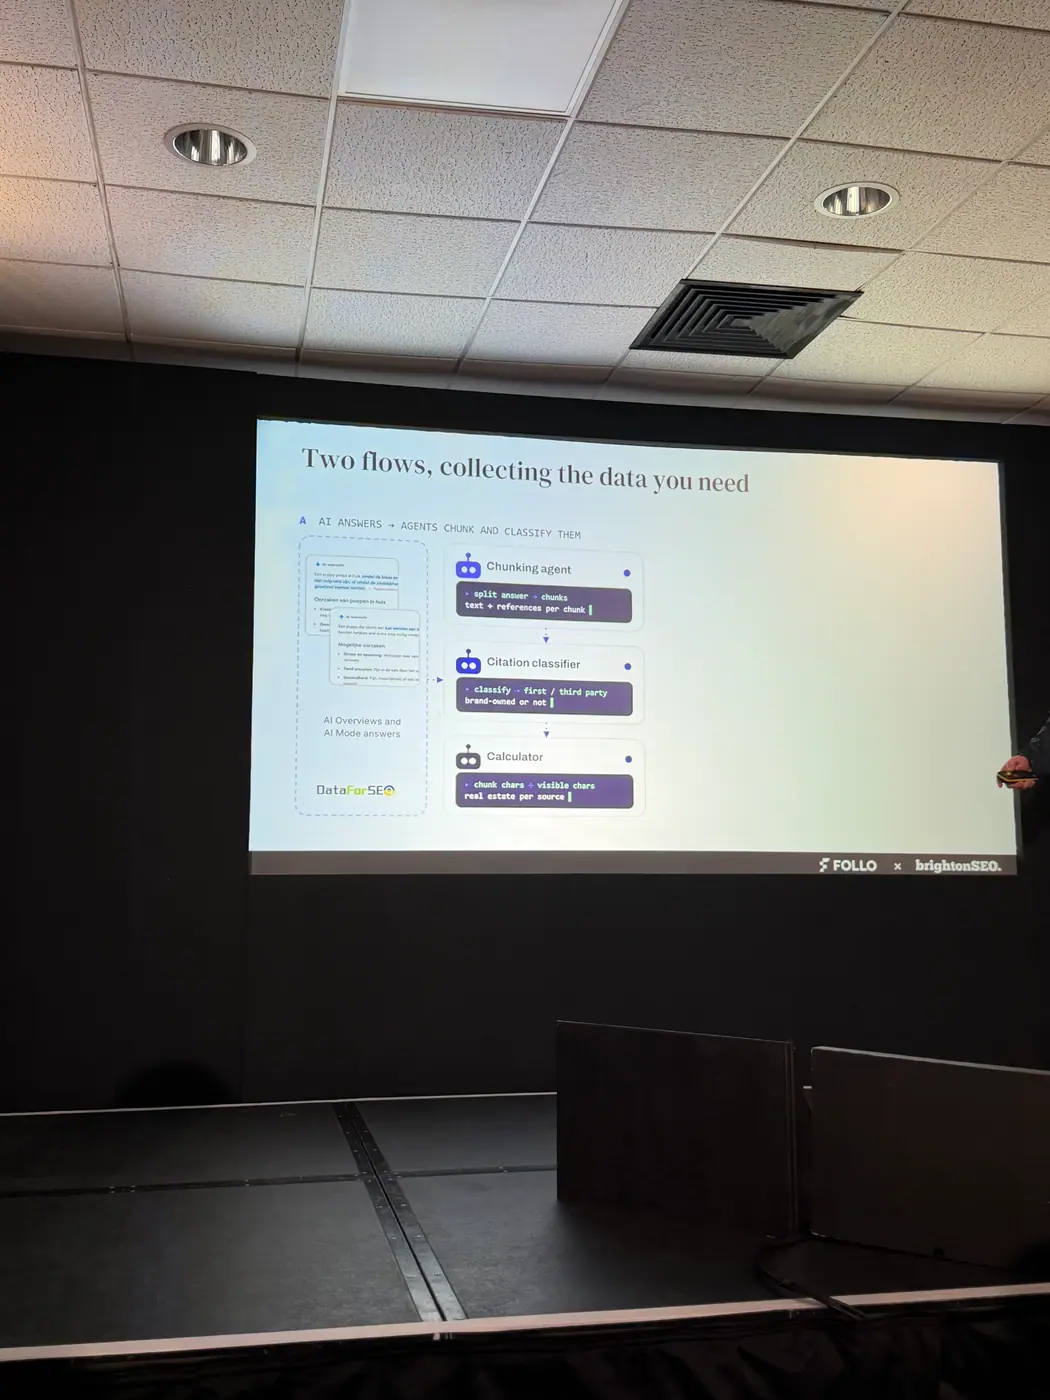
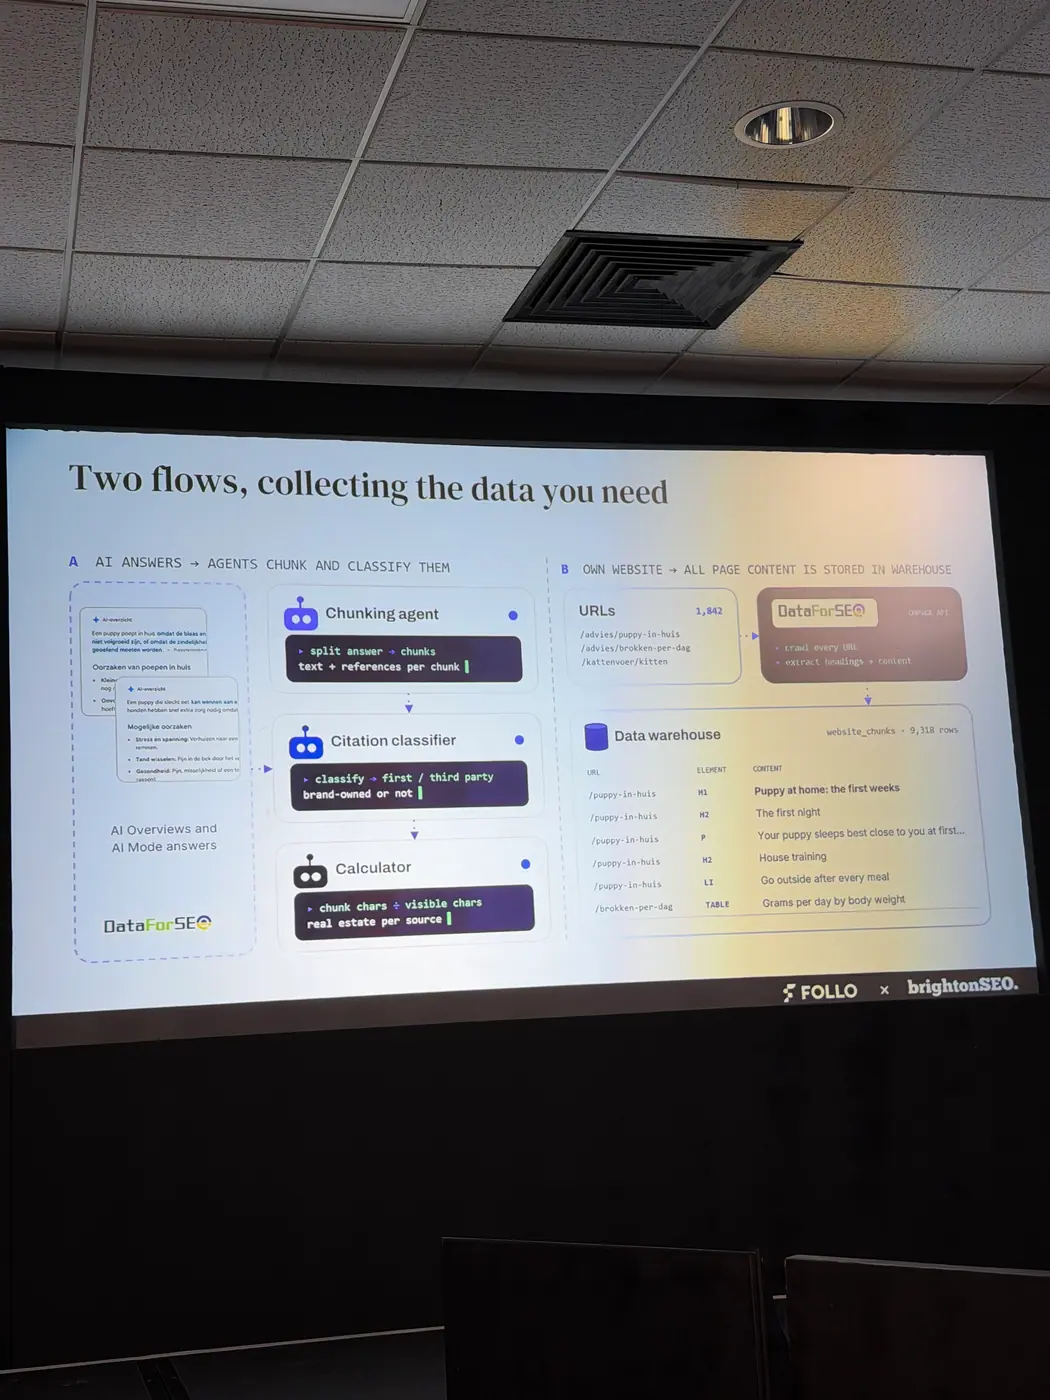
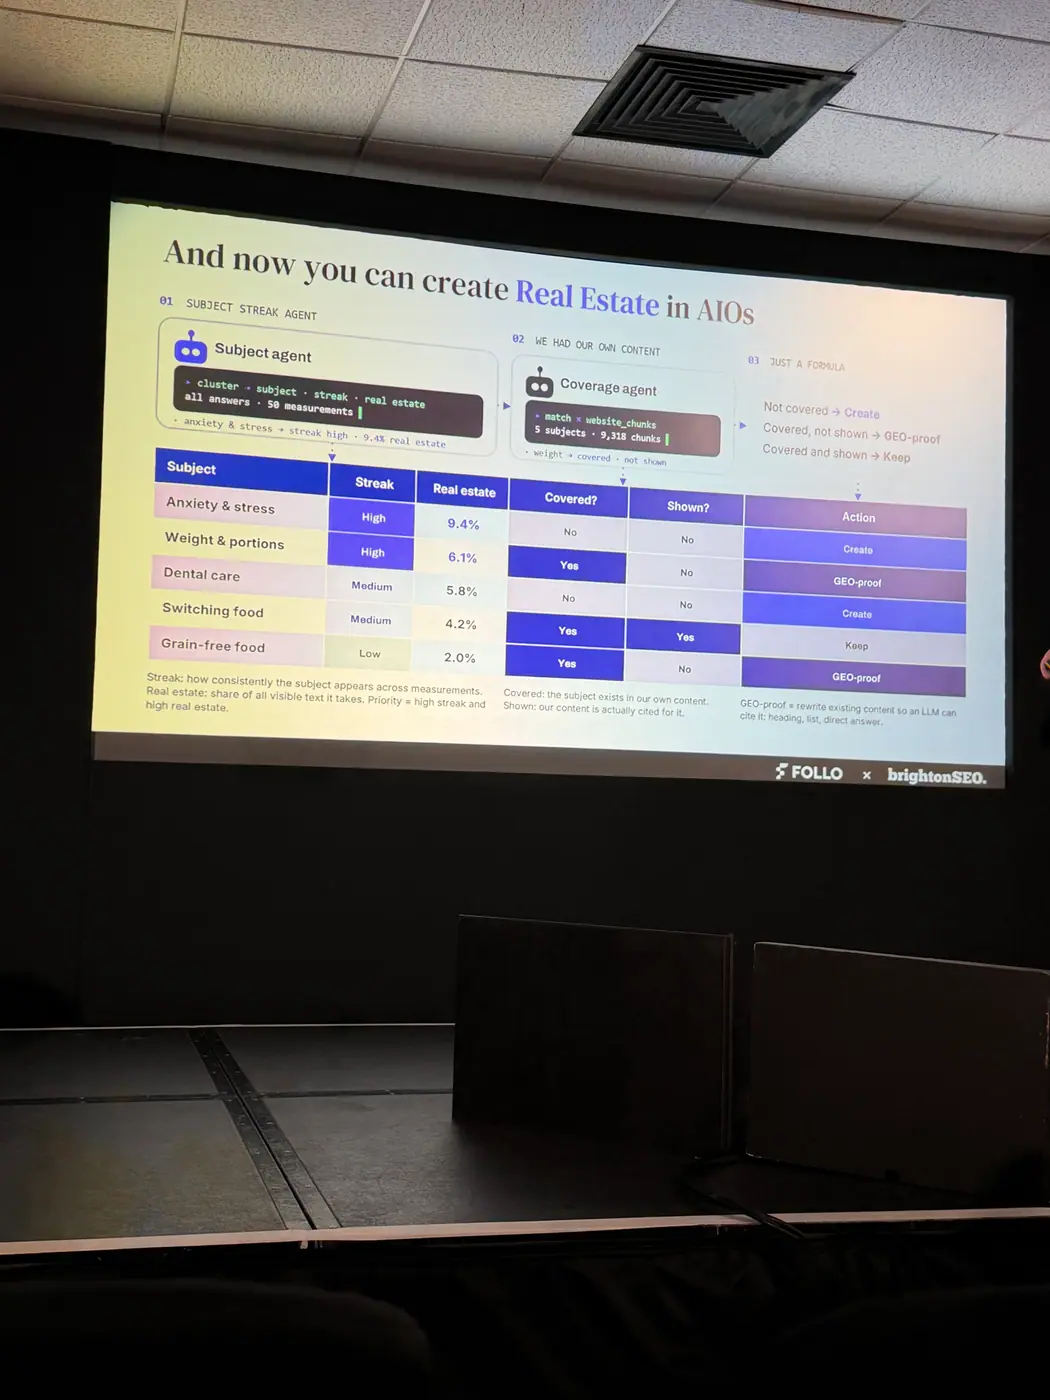
6. Cytowanie to za mało – licz, jaką część odpowiedzi zajmuje twoja treść („chunks”).
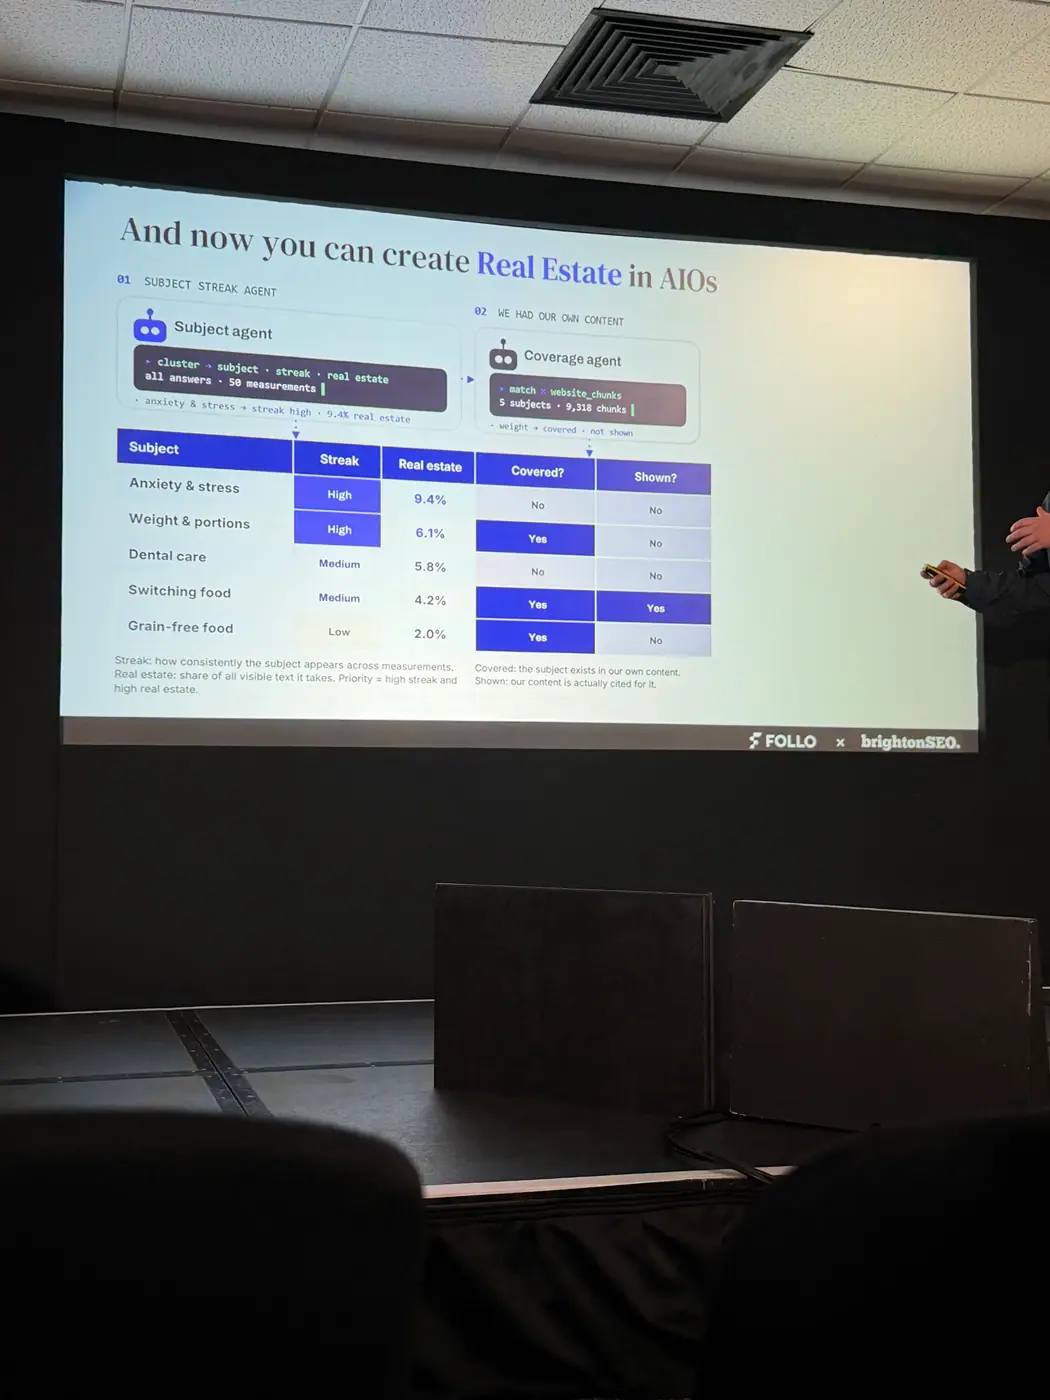
Można być w prawie każdej odpowiedzi małym fragmentem, podczas gdy konkurent zajmuje większość tekstu. Bergmans klasyfikuje każdy fragment odpowiedzi jako pierwszo- lub trzeciostronny i liczy udział, a po zestawieniu z własnymi treściami w hurtowni danych (np. przez DataForSEO) dostaje trzy decyzje per temat: stworzyć treść, przerobić istniejącą pod AI albo nic nie robić, bo temat jest już „nasz”.
„But I got a problem because I’m in almost all the answers, but it’s always with little chunks. And my competitor is taking up the real estate from the answer.”
7. Tabele porównawcze i zapytania fan-out zdradzają specyfikacje, po których model porównuje produkty – te słowa trzeba mieć na stronie produktu i w feedzie.
Na pytanie „najlepsze buty do biegania” ChatGPT i AI Mode budują tabelę z atrybutami (podeszwa, teren, wodoodporność, głębokość bieżnika), a w tle wysyłają zapytania pomocnicze z terminami, których użytkownik nie wpisał. Oba zestawy da się wyciągnąć z surowych odpowiedzi lub przez API Gemini i zamienić w listę terminów do dodania na PDP (stronach produktu) i do feedów.
„But this is the real magic. They’re additionally searching for other terms and other specifications that I as a human being are searching for in my prompt. So when using these words on my product page or maybe in my feeds, I probably have a higher chance to show up in the answers and being recommended.”
8. Większość feedów produktowych jest wypełniona w 60%; „golden record feed” z 99% atrybutów wygrywa każdy test A/B.
Sklepy wypełniają tylko pola wymagane przez Google lub OpenAI i pomijają atrybuty konwersacyjne, np. pytania i odpowiedzi, wyróżniki produktu czy szczegóły. Feed z pełnym kontekstem, w którym opisy, Q&A i highlighty zawierają terminy z tabel porównawczych i fan-outów, w testach daje więcej kliknięć i przychodu; w Europie poprawia jednocześnie Google Shopping i ChatGPT Shopping, bo ten drugi korzysta z danych pierwszego.
„My clients and a lot of feeds that I’m auditing are just 60% feed. They only give in what’s required by Google or maybe required by GDG. […] And we see when we test it, every time we test it, a B test that the golden record feed is winning from the feeds that don’t give too much context to the platform.”
Zdjęcia: Stijn Bergmans
60 kadrów · Fot. Robert Nowaczyk
Greta Koivikko: PDPs Over PLPs
10:10
Streszczenie
Greta Koivikko przekonywała, że w strategii SEO (Search Engine Optimization / optymalizacja dla wyszukiwarek) sklepów internetowych trzeba poświęcić więcej uwagi PDP (Product Detail Page / strona produktu). Nie oznaczało to rezygnacji z PLP (Product Listing Page / strona listingu produktów).
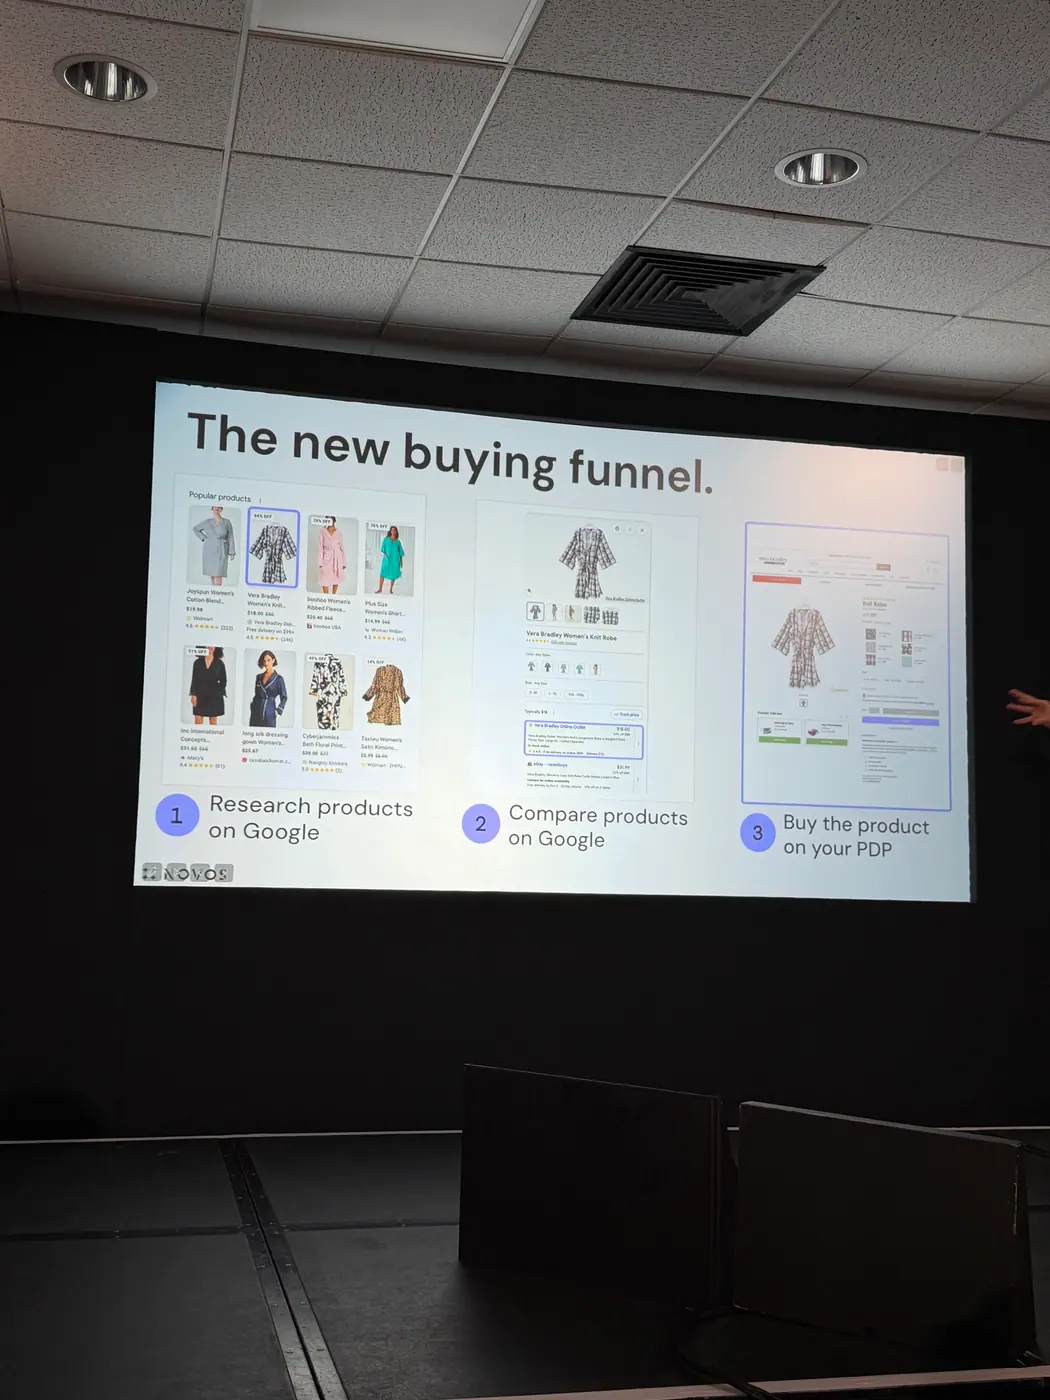
Jej główna teza: karta produktu może być pierwszą i jedyną stroną sklepu, którą zobaczy kupujący, ponieważ wyszukiwanie, selekcja produktów i porównywanie sprzedawców coraz częściej odbywają się poza sklepem. Dlatego karta powinna jednocześnie pomagać w zakupie, przedstawiać markę i dostarczać informacji wyszukiwarkom oraz AI (Artificial Intelligence / sztuczna inteligencja).
Najważniejsze wnioski
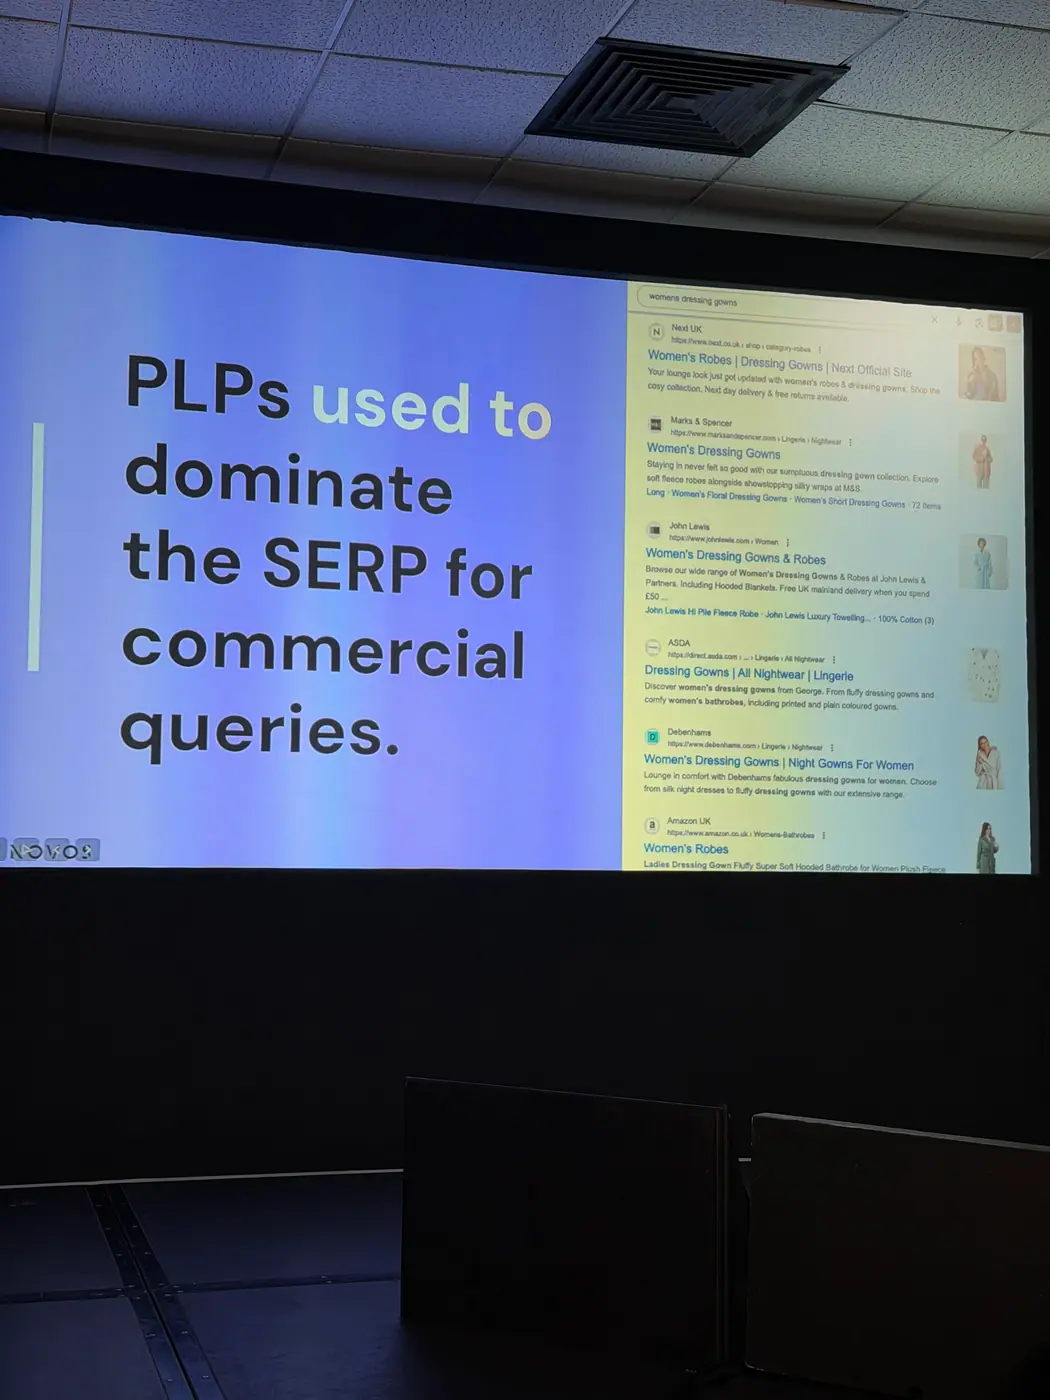
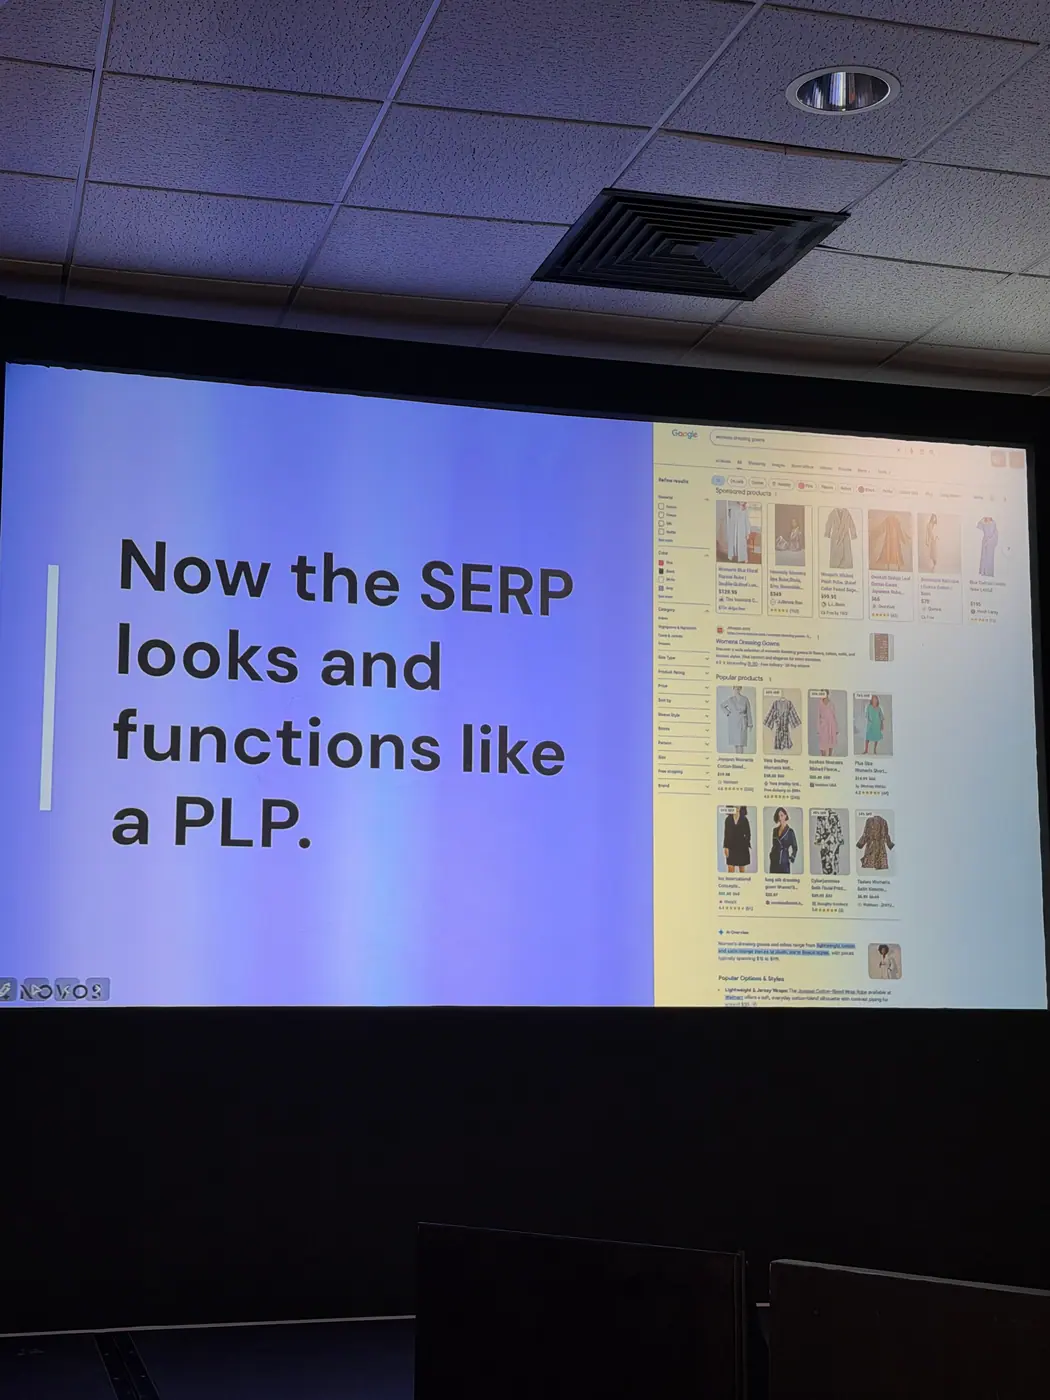
Obserwacja z prezentacji: wyniki wyszukiwania przejmują funkcje kategorii.
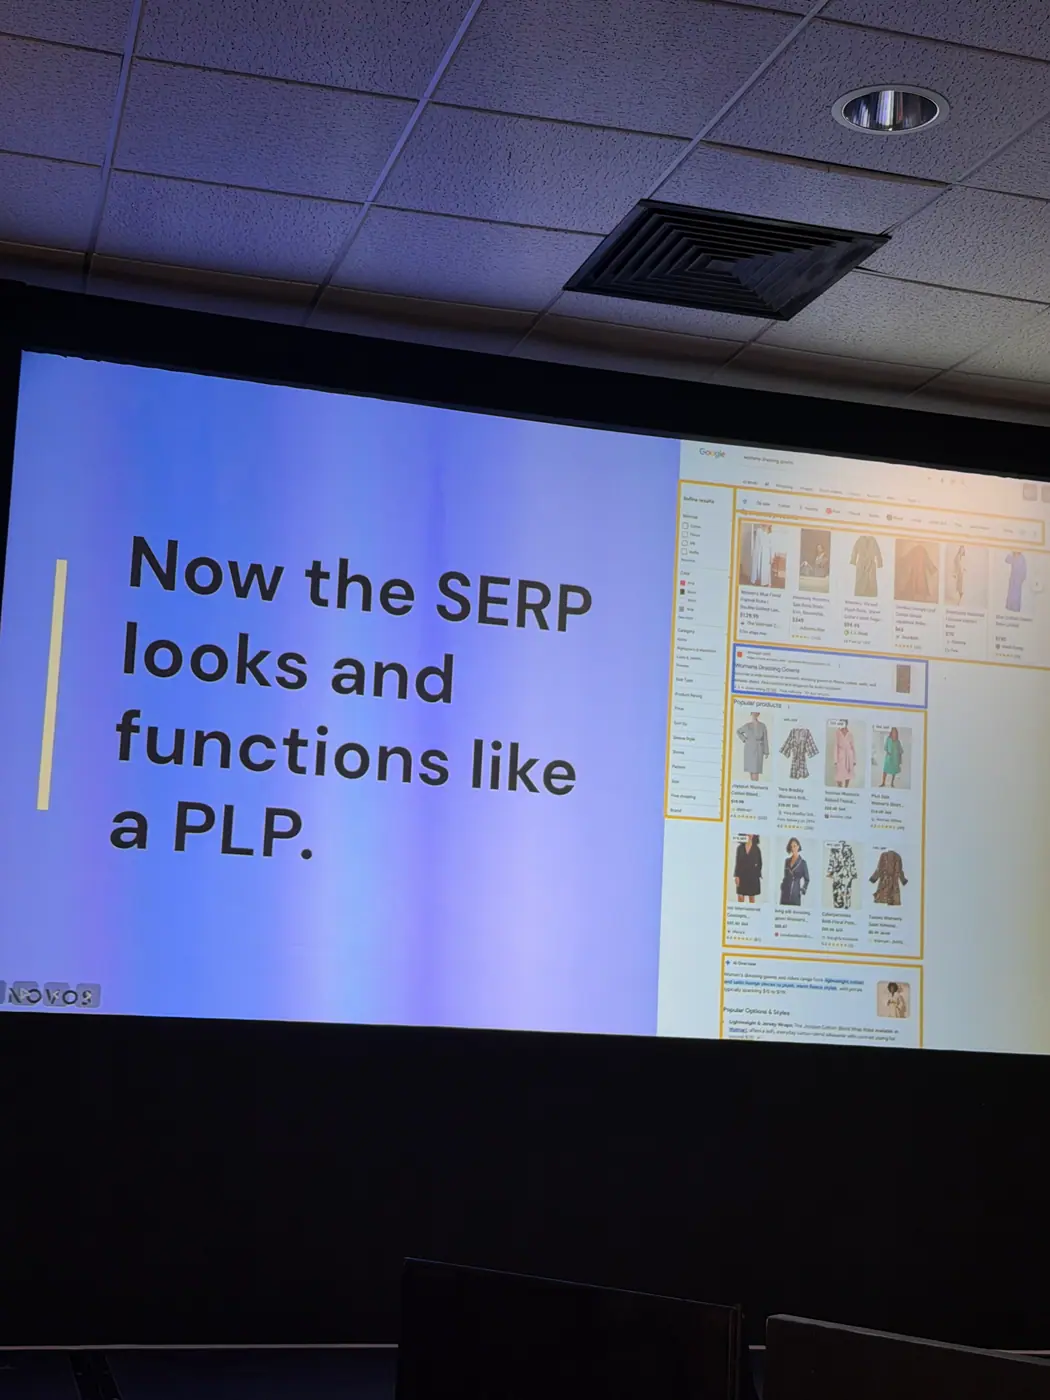
W pokazanym przykładzie z USA użytkownik miał do dyspozycji filtry, siatkę produktów i możliwość porównywania sprzedawców. Do sklepu mógł przejść dopiero po wybraniu konkretnego produktu.Wniosek prelegentki: karta produktu musi przejąć część zadań innych stron.
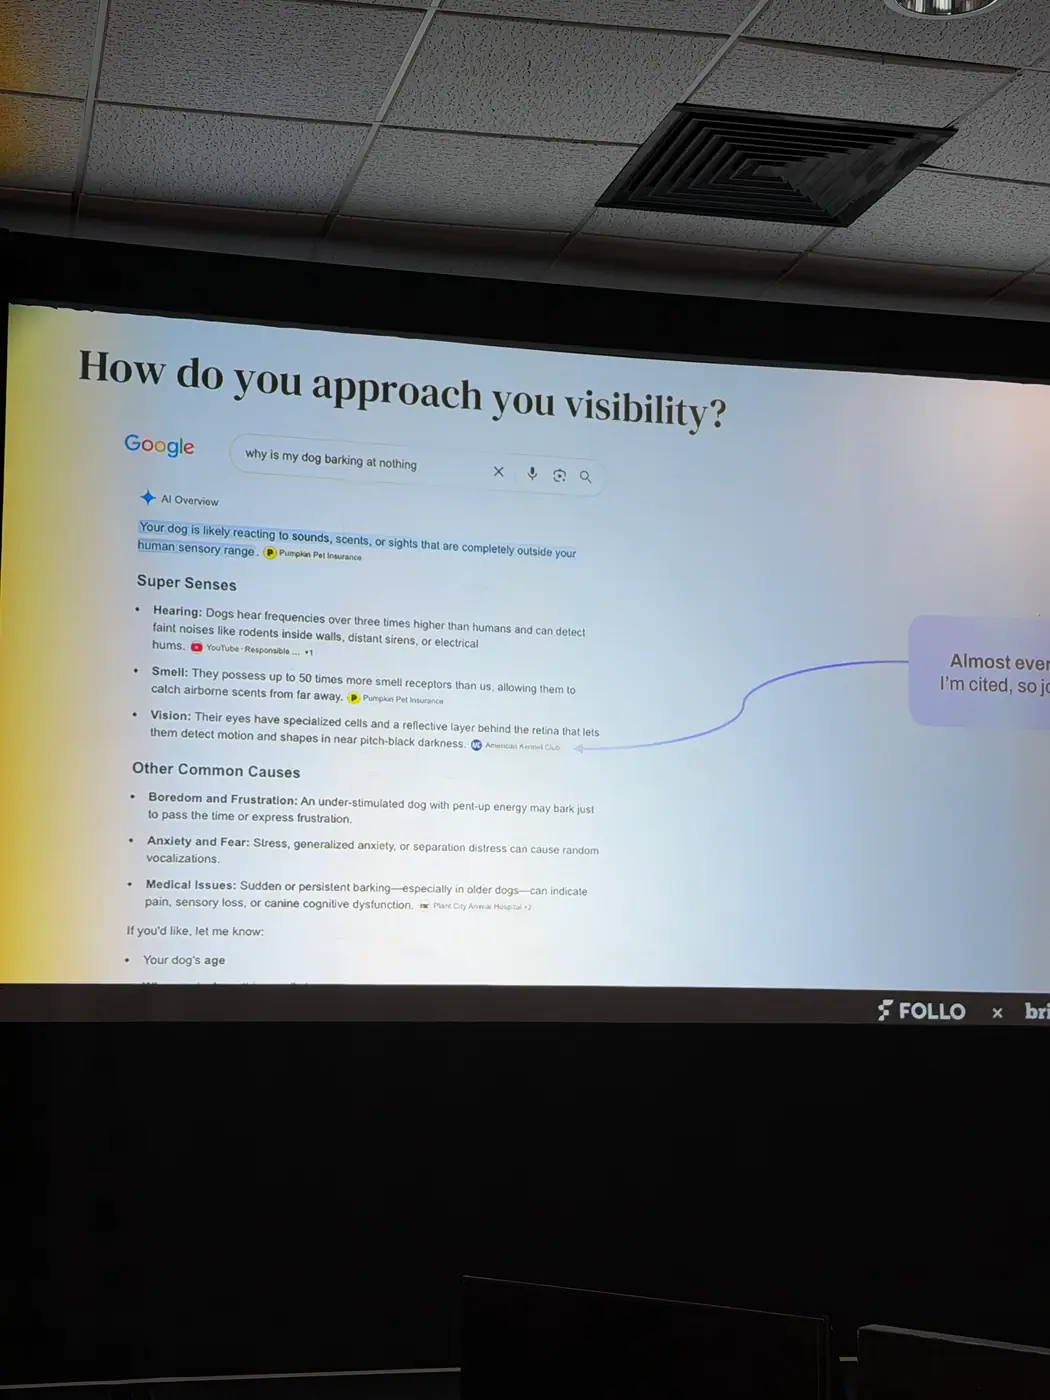
Sam opis parametrów nie wystarcza. PDP powinna również wyjaśniać, czym wyróżnia się marka i dlaczego warto kupić właśnie od niej.Przywołane ustalenie techniczne: wartościowa treść może pozostawać niewidoczna dla botów.
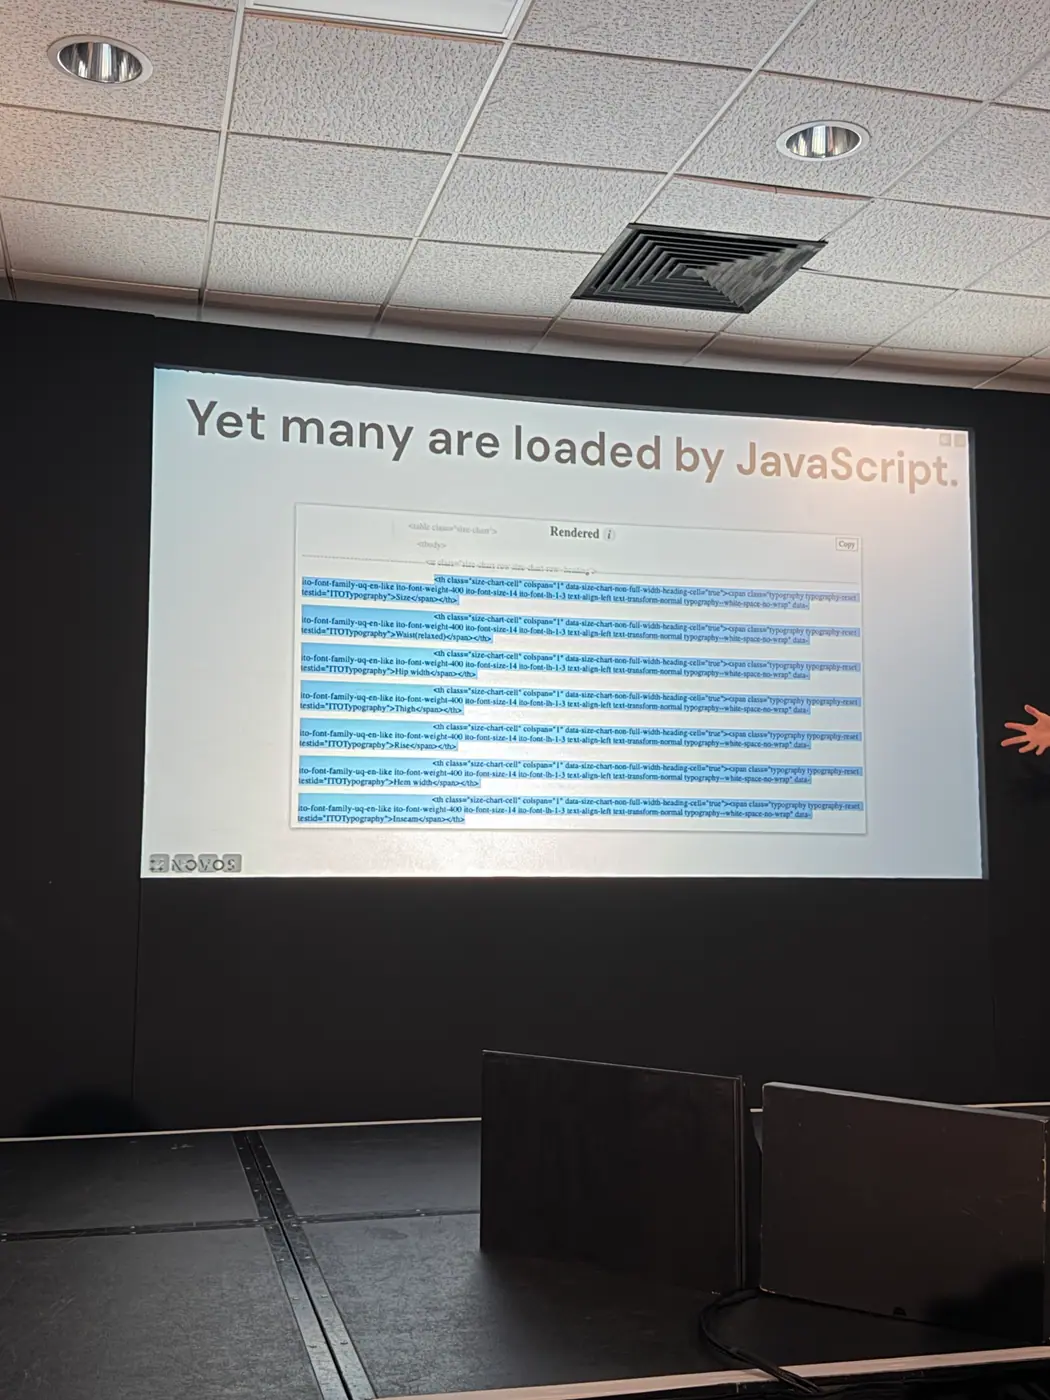
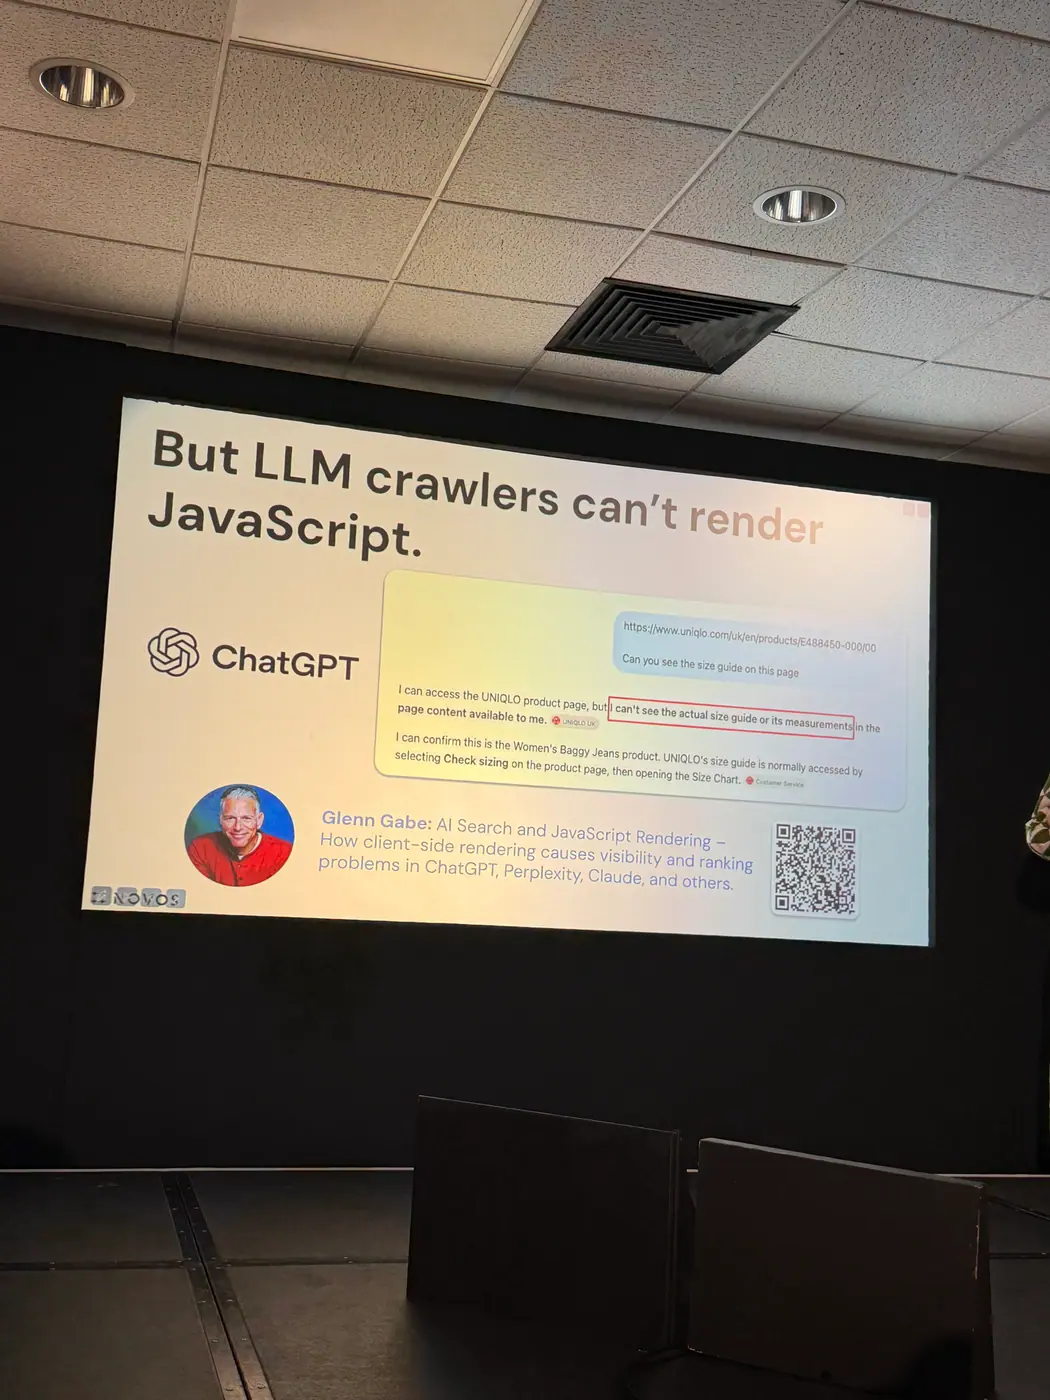
Koivikko odwołała się do badania, według którego większość crawlerów LLM (Large Language Model / duży model językowy) nie renderowała JavaScript. Pokazała poradnik rozmiarów dostępny dla użytkownika, ale niedostępny dla asystenta, który zamiast tego korzystał z opinii i zewnętrznych źródeł.Rekomendacja: wspólna optymalizacja treści i danych według modelu SEED (Situational Relevance / dopasowanie do sytuacji klienta; Example-led Content / treści oparte na przykładach; Enriched Product Data / wzbogacone dane produktowe; Distinct Brand Voice / wyrazisty głos marki).
Model łączył potrzeby kupujących, wyszukiwarek i AI, zamiast traktować je jako trzy osobne strategie.Istotne rozróżnienie: cytowanie źródła i wzmianka o marce to różne rodzaje widoczności.
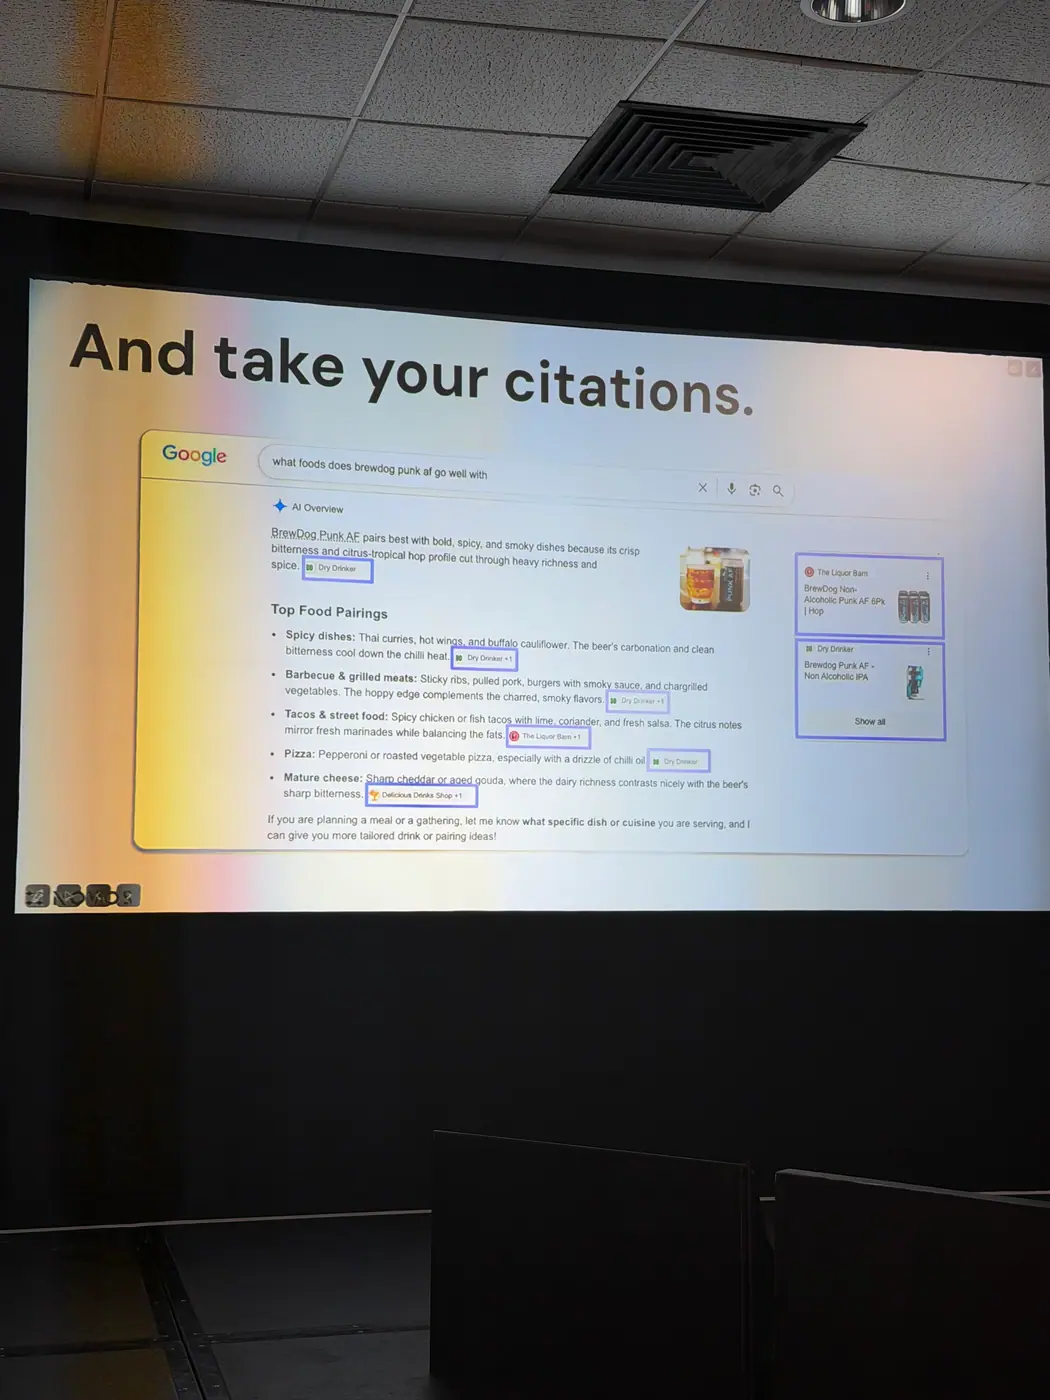
Odpowiedź AI może wymieniać produkt, ale opierać się na stronie sprzedawcy, nie producenta. Koivikko pokazała taki przypadek na przykładzie informacji o sposobach podawania piwa bezalkoholowego i łączenia go z jedzeniem.Prognoza prelegentki: amerykańskie wyniki mogą zapowiadać kierunek rozwoju innych rynków.
Greta potraktowała przykład z USA jako sygnał możliwych zmian, a nie opis jednakowego doświadczenia zakupowego we wszystkich krajach.
Dane liczbowe i przykłady
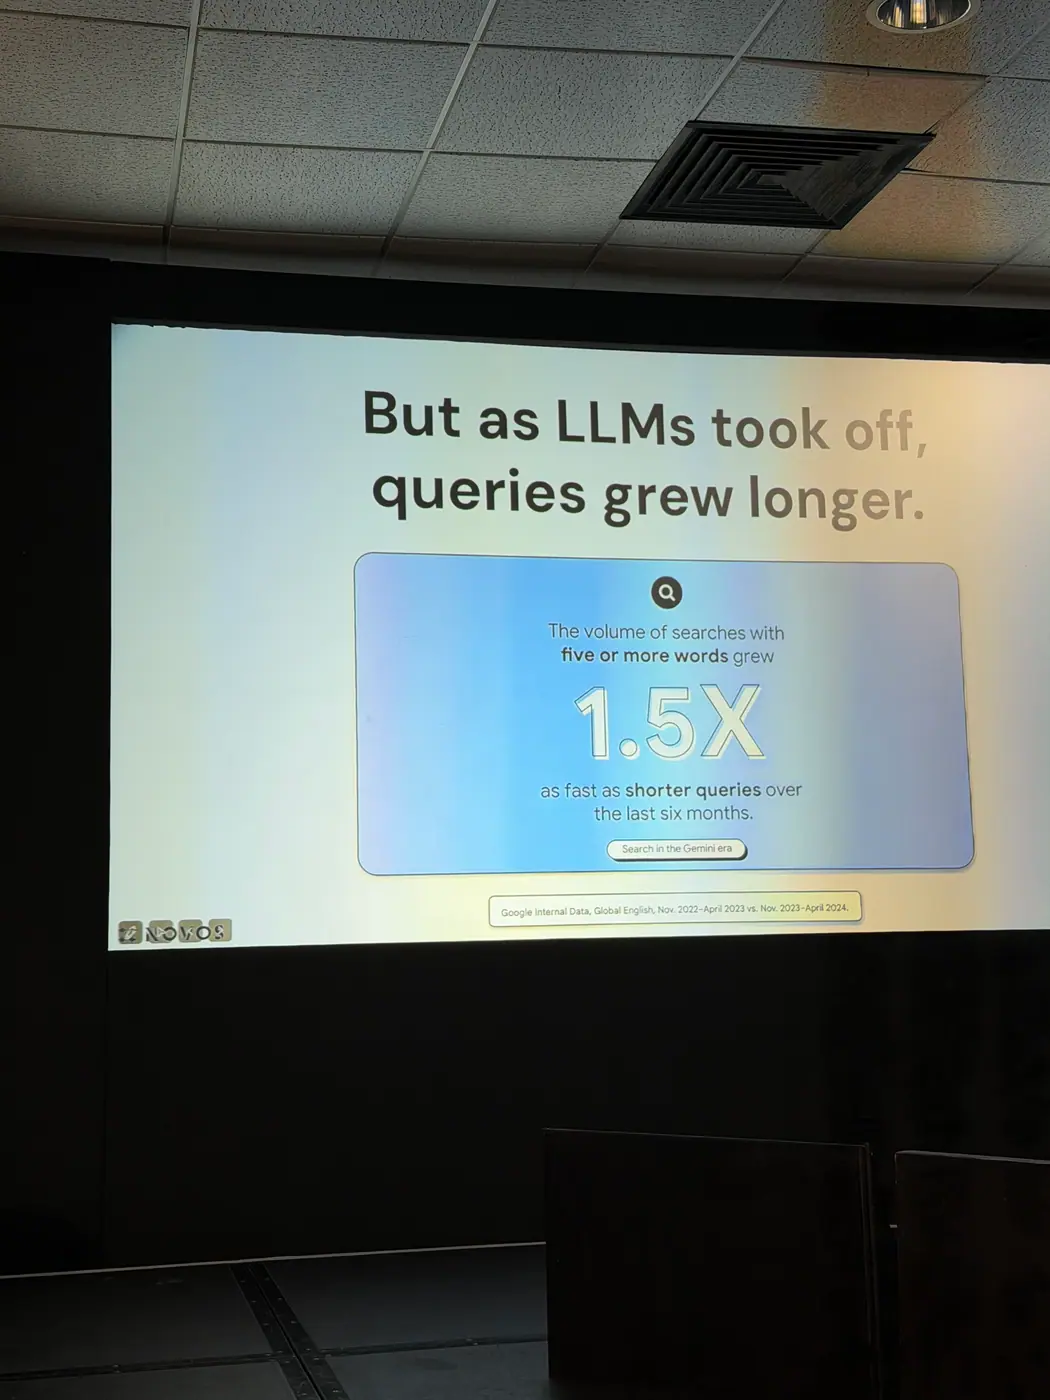
- Zapytania zawierające co najmniej 5 słów rosły 1,5 raza szybciej niż krótsze. Prelegentka przytoczyła dane Google z okresu 2023–2024, dotyczące sześciomiesięcznego okresu. Było to porównanie tempa wzrostu.
- 1 tradycyjny niebieski link pozostał w pokazanym przykładzie amerykańskich wyników zdominowanych przez elementy zakupowe.
- 1–3 dodatkowe dni między myciami włosów przedstawiono jako korzyść w treści karty omawianego kosmetyku. Był to przykład komunikowania konkretnego zastosowania produktu, nie wynik badania skuteczności optymalizacji.
Praktyczne rady
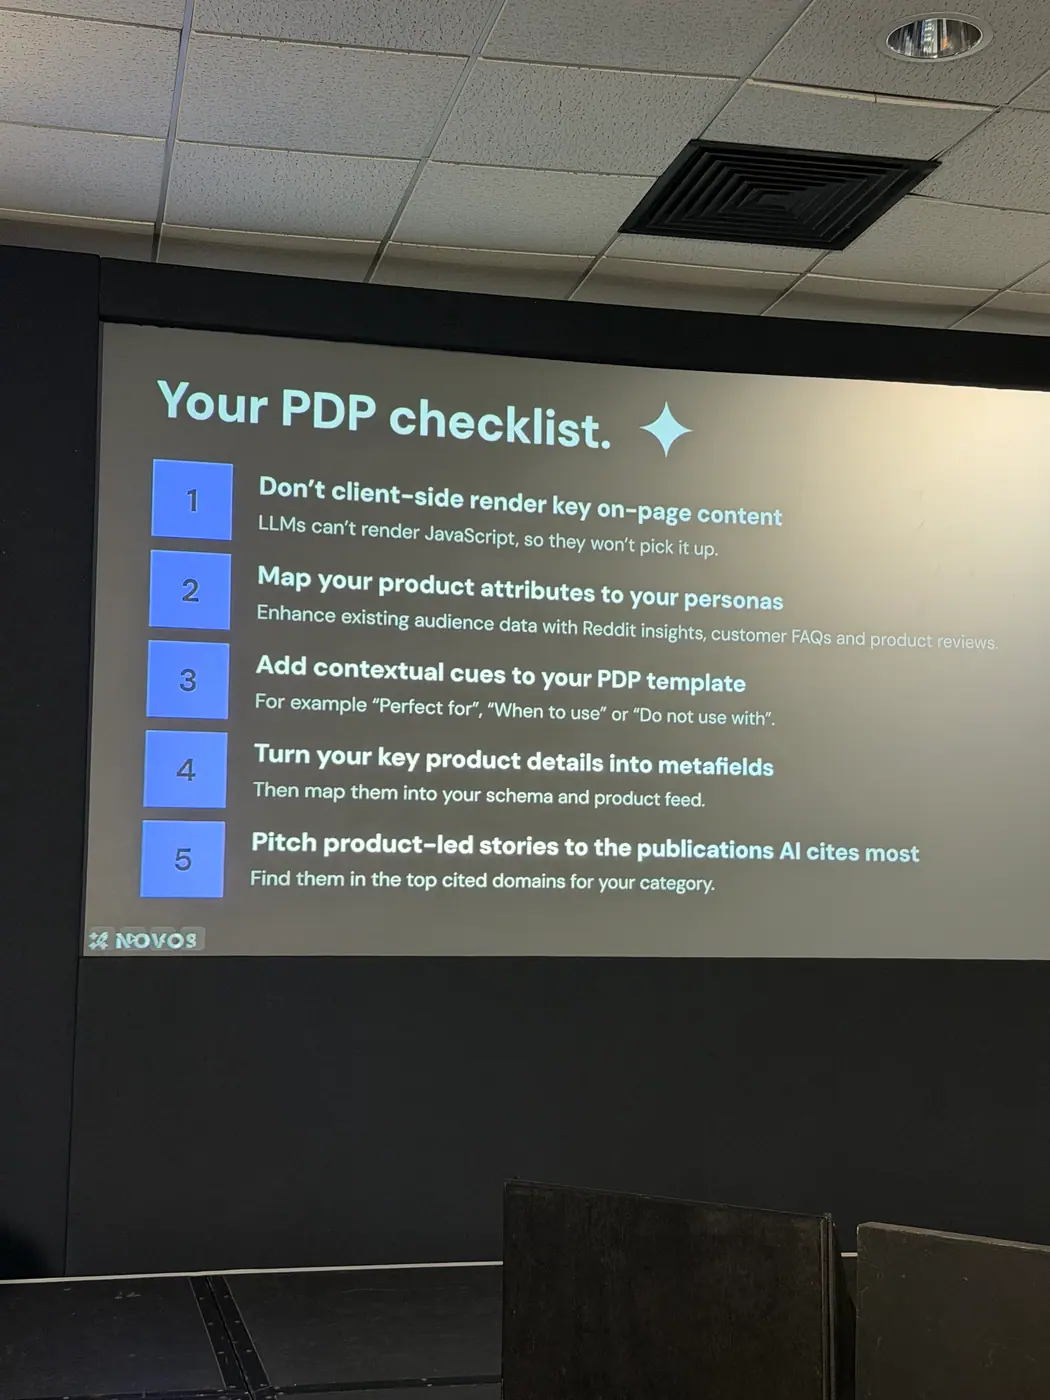
- Zacznij od dostępności treści. Sprawdź, czy kluczowe informacje, np. rozmiarówka, nie pojawiają się dopiero po wykonaniu JavaScript. Koivikko rekomendowała renderowanie po stronie serwera lub inne rozwiązanie zapewniające dostęp botom.
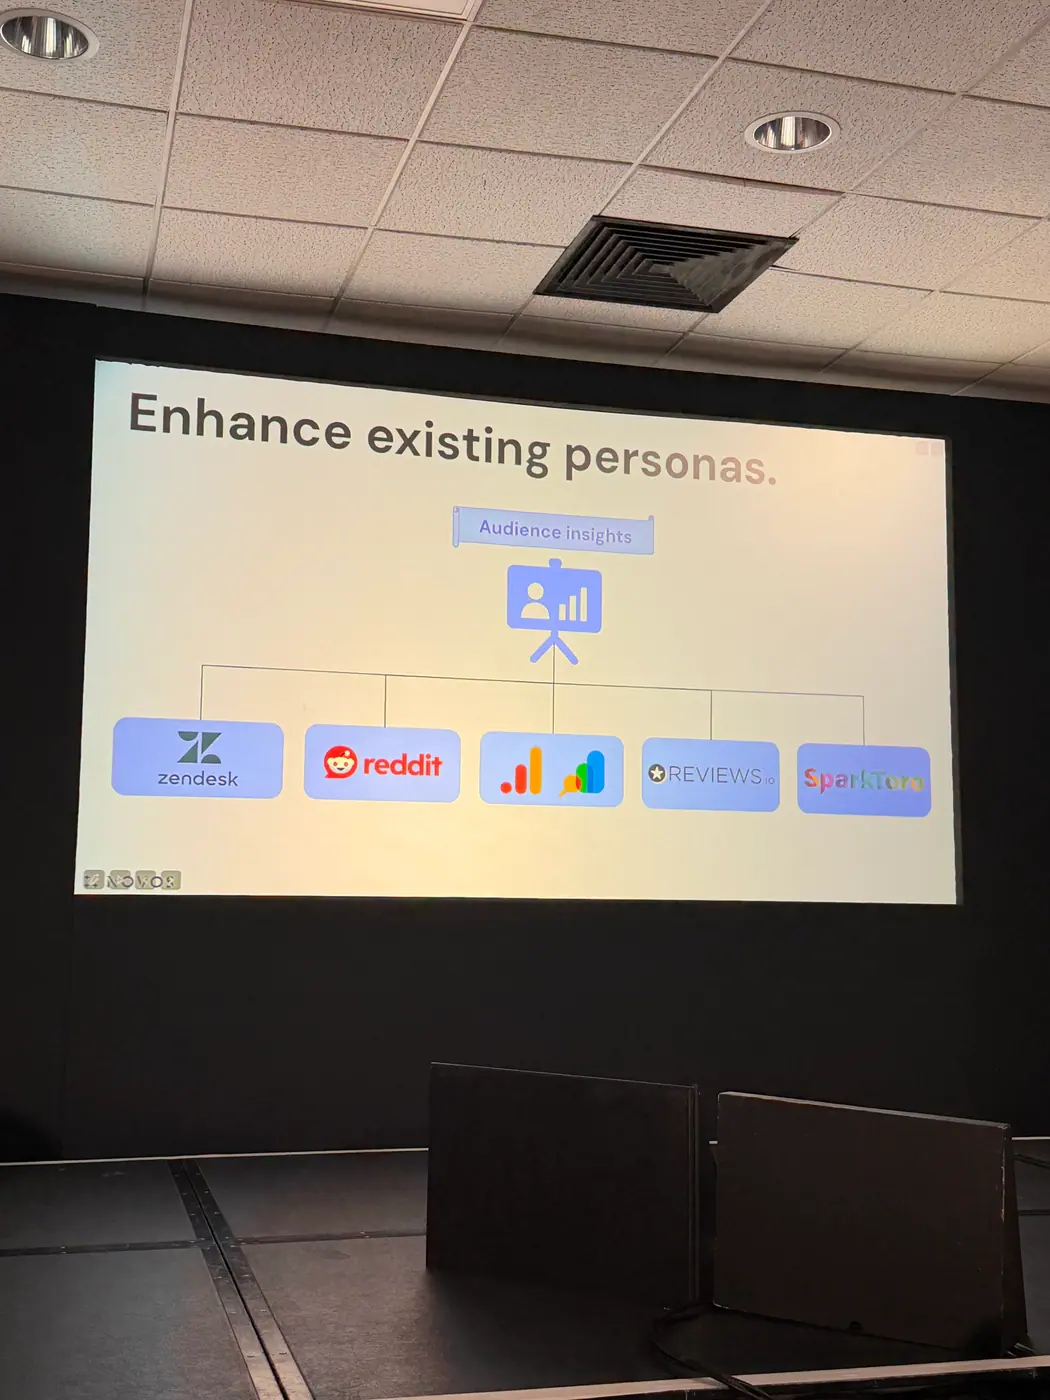
- Buduj persony na rzeczywistych pytaniach klientów. Wykorzystaj opinie produktowe, kontakt z obsługą, dyskusje na forach i własne dane o odwiedzających oraz kupujących.
- Przełóż potrzeby na pola produktowe i kontekst użycia. Koszt karmienia czy cechy opakowania można zapisać w powtarzalnych polach, zamiast tworzyć każdy opis od początku. Dodaj zastosowania i ograniczenia produktu.
- Uzgodnij informacje na stronie, w pliku produktowym i danych strukturalnych. Szczególnie pilnuj zgodności ceny. Traktuj PDP również jako źródło informacji dla systemów reklamowych.
- Oddzielaj obecność marki od cytowania własnej strony. Sprawdzaj nie tylko, czy produkt pojawia się w odpowiedzi AI, ale również, z czyich informacji ta odpowiedź korzysta.
Knowledge bombs
1. W pierwszym roku po premierze ChatGPT zapytania o pięciu i więcej słowach rosły półtora raza szybciej niż krótsze.
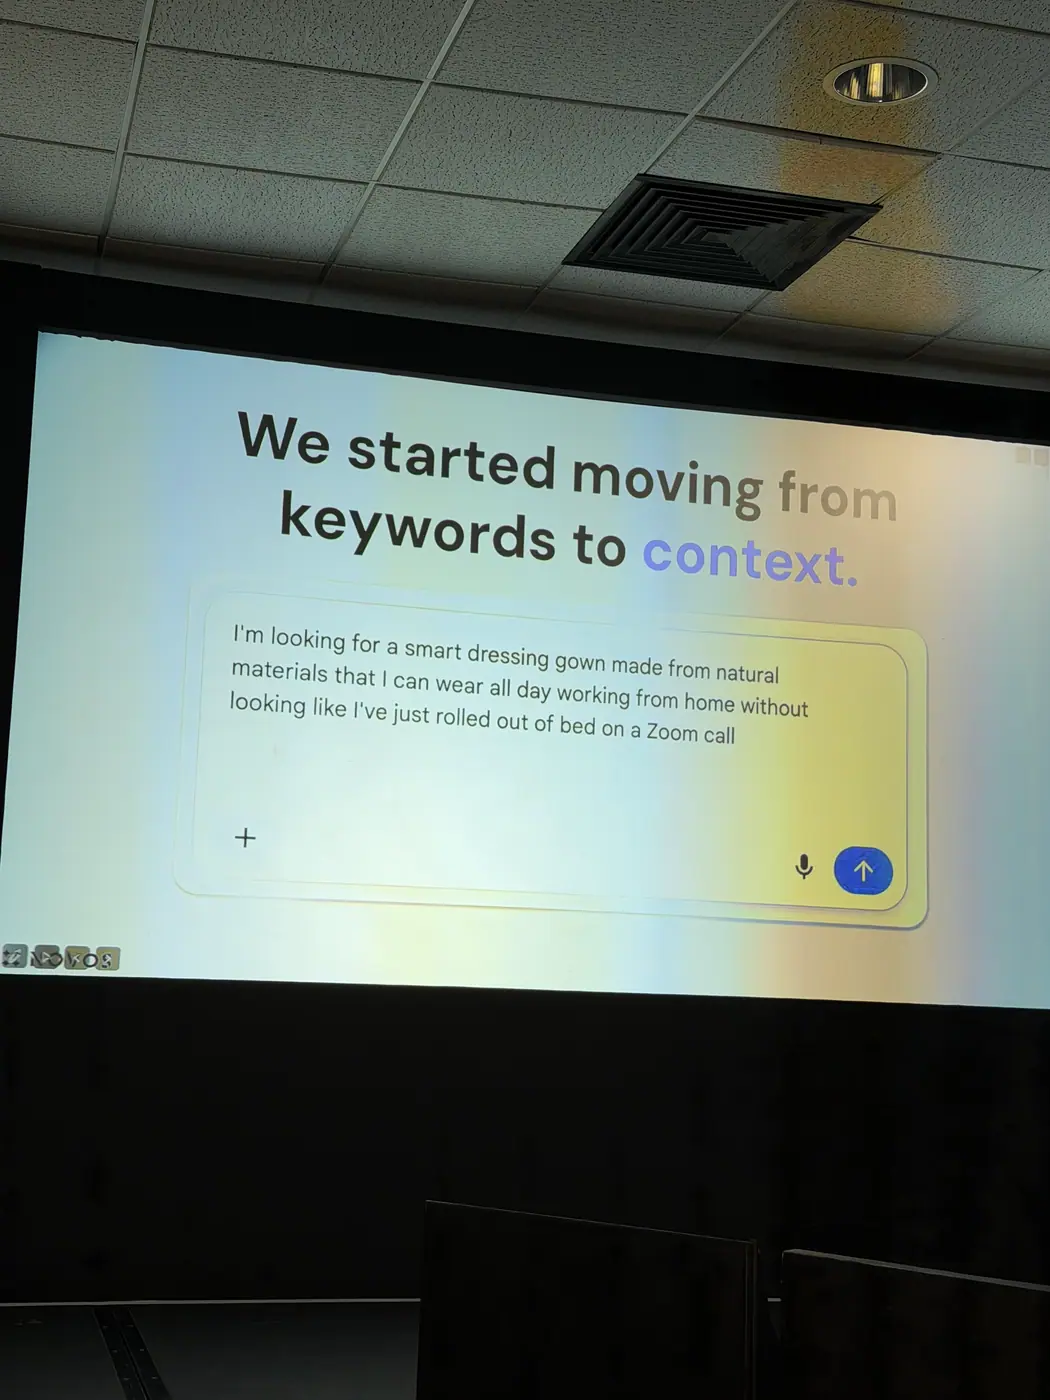
Koivikko powołuje się na dane Google z lat 2023–2024: zaraz po upowszechnieniu modeli językowych ludzie zaczęli wpisywać dłuższe, bardziej sytuacyjne zapytania, a ta zmiana wciąż trwa. Jej wniosek: optymalizacja e-commerce przesuwa się „od słów kluczowych do kontekstu”, czyli od ogólnych fraz kategorii do konkretnych sytuacji i atrybutów, które najlepiej opisuje strona produktu (PDP, product detail page), a nie strona kategorii (PLP, product listing page).
„we could see that searches that had five or more words grew one and a half times as fast as shorter queries over the last six months.”
2. Wynik wyszukiwania Google wygląda już jak strona kategorii, więc kupujący ląduje od razu na stronie produktu.
Na amerykańskim SERP-ie (stronie wyników wyszukiwania) są filtry, siatka produktów, opis kategorii w formie AI Overview i tylko jeden niebieski link. Google chce zatrzymać kupującego u siebie na etapie researchu i porównywania sprzedawców, więc pierwsza, często jedyna wizyta na sklepie zaczyna się od PDP. Strona produktu musi więc przejąć rolę strony głównej i „o nas”: przekazać wartości marki i unikalne przewagi.
„But the page you land on, it’s no longer your category page. It’s your product page. […] They essentially have to do the job of your homepage, your about us page”
3. Większość crawlerów modeli językowych nie renderuje JavaScriptu, więc treść ładowana po stronie przeglądarki dla nich nie istnieje.
Przykład Uniqlo: tabela rozmiarów wstrzykiwana JavaScriptem jest niewidoczna w kodzie źródłowym. Googlebot sobie z tym poradzi (choć nie zawsze sprawnie), ale asystent AI pytany o rozmiar jeansów nie widzi własnego przewodnika sklepu i bierze dane z opinii, serwisów recenzenckich i Reddita. Każda treść, którą mają zobaczyć ChatGPT czy Claude, musi być renderowana po stronie serwera; to pierwszy punkt checklisty, bez którego reszta optymalizacji nie ma sensu.
„So most LLM crawlers actually can’t render JavaScript at all […] So what this means is that someone else who’s not you is educating your customers about your products.”
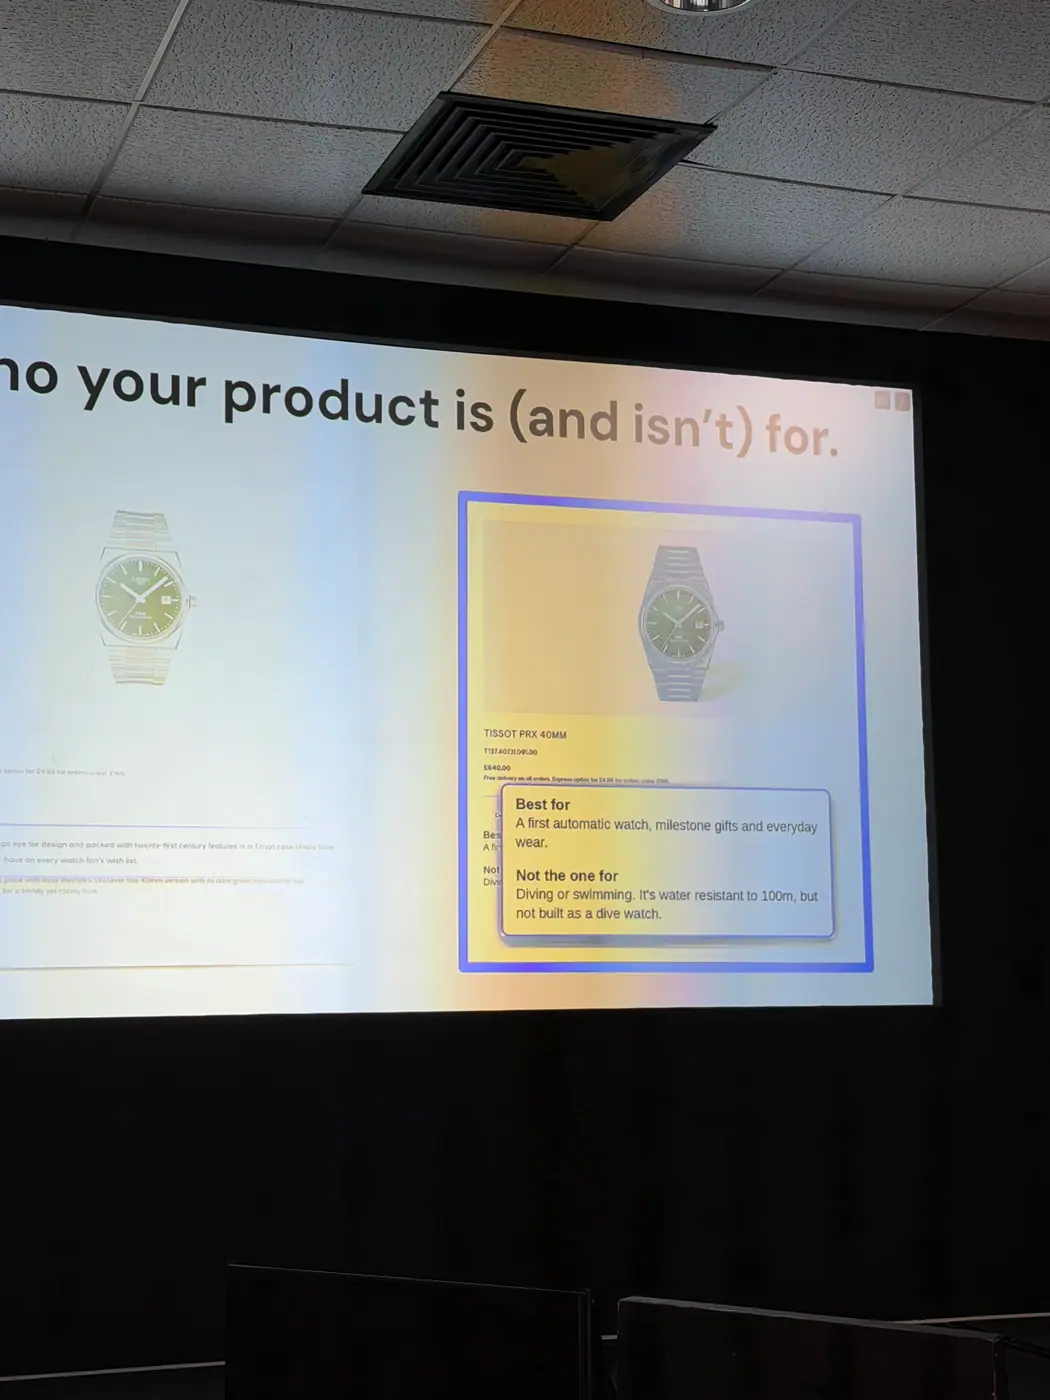
4. Napisz na stronie produktu, dla kogo produkt nie jest.
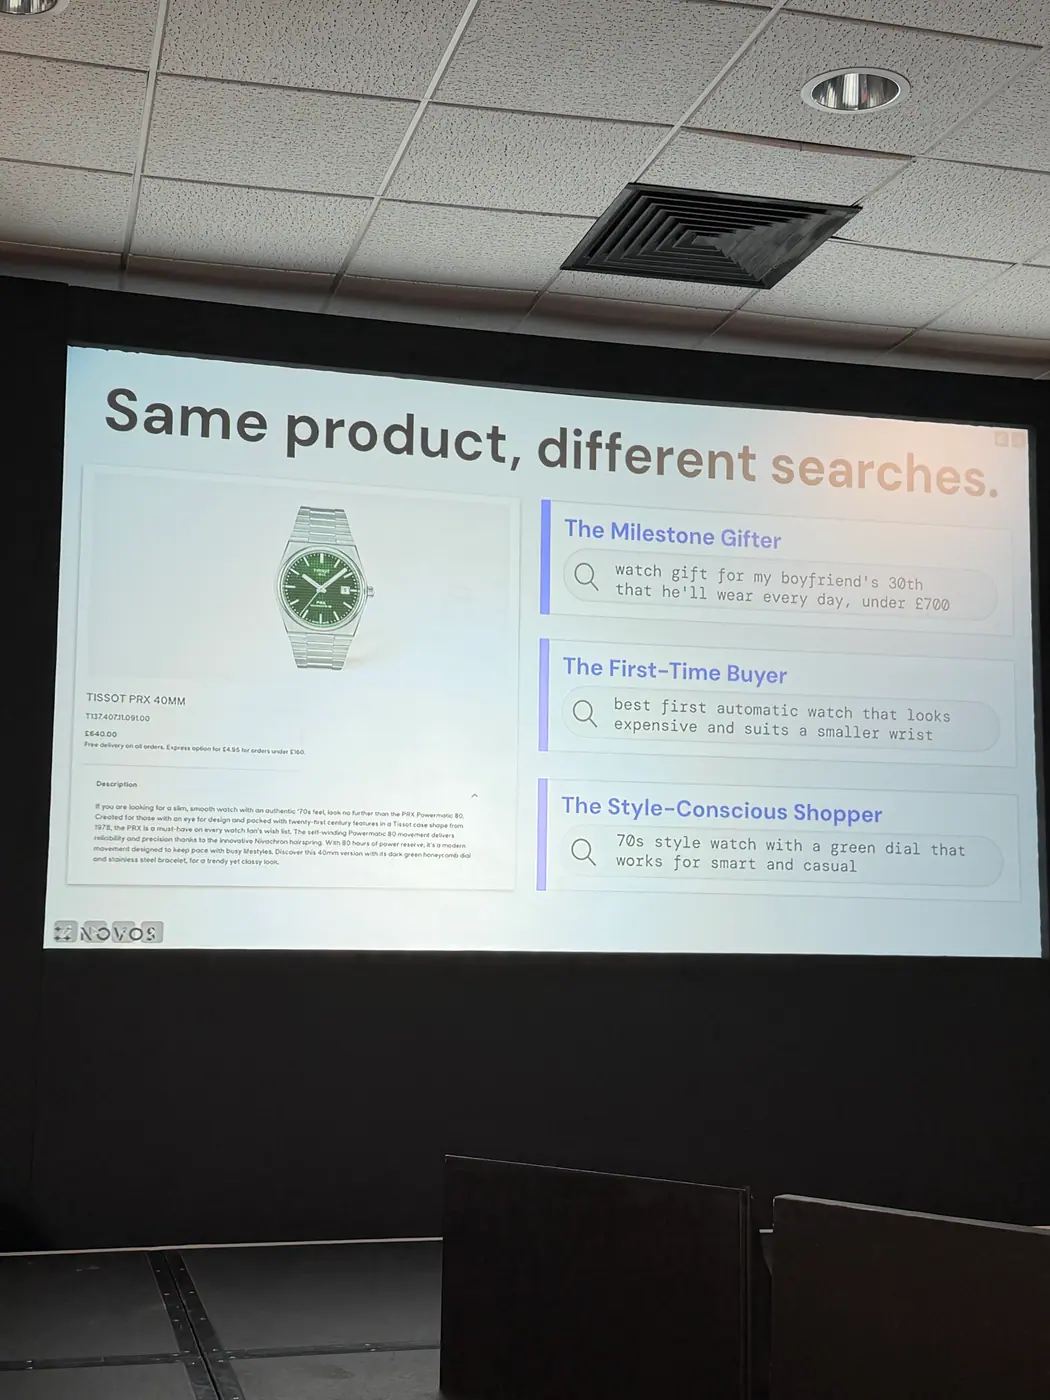
Ten sam zegarek Tissot PRX kupują trzy różne osoby: szukająca prezentu, kupująca pierwszy zegarek i znawca stylu, a opis mówi tylko do tej trzeciej. Koivikko dodałaby wskazówki sytuacyjne (dobry pierwszy automatyk, dobry prezent) i jasno zaznaczyła, że mimo wodoszczelności to nie jest zegarek nurkowy. Tradycyjnie sklepy przedstawiają produkt jako najlepszy w każdej sytuacji; jej zdaniem wykluczanie niewłaściwych klientów daje mniej zwrotów i bardziej zadowolonych kupujących.
„But if you clearly say who your product is not for, that can lead to much happier customers over the long run.”
5. Priorytety person zapisane jako pola produktu (metafields) skalują treść bez pisania każdej strony od zera.
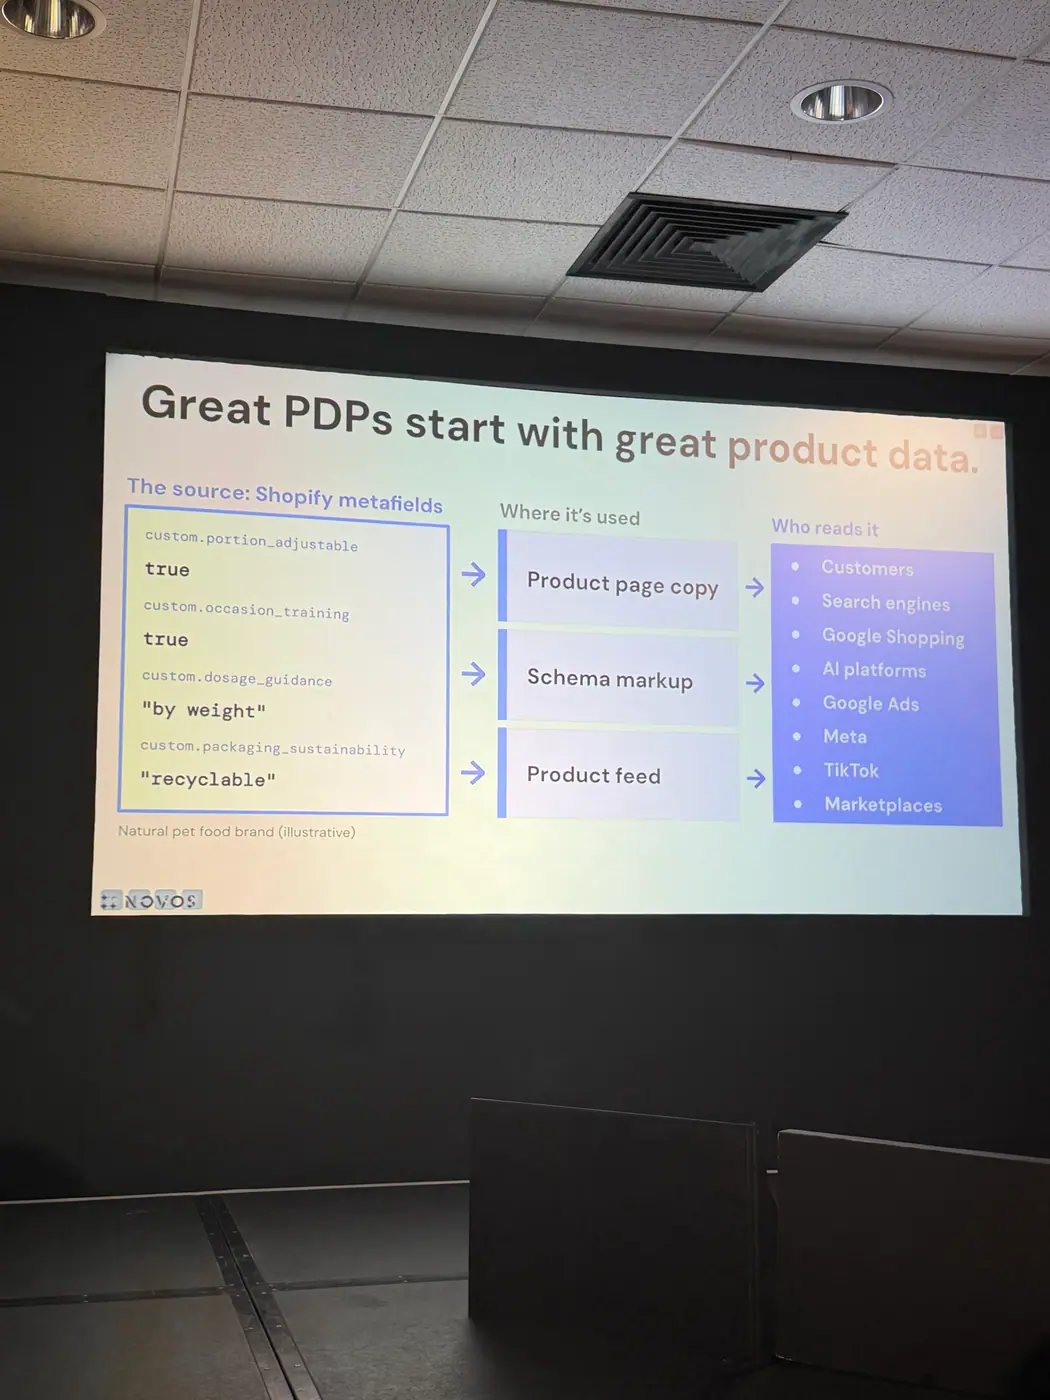
Dla marki naturalnej karmy dla zwierząt zespół ustalił, co liczy się dla każdej persony (np. koszt jednego posiłku, ekologiczność opakowania), i zapisał te atrybuty jako metafields w Shopify, czyli bezpośrednio w danych produktu. Te same pola wyświetlają się na stronach produktów, trafiają do feedu i są czytane przez Google Shopping, platformy AI i reklamy. Treść dopasowana do person powstaje więc raz, na poziomie danych, a nie osobno dla każdego PDP.
„and then we build those as Shopify metafields, so take them straight to the product data. And the good thing about doing this is that you don’t have to do copy from scratch for every single product page because these can be applied to different pages on scale.”
6. Nowy produkt bez wolumenu wyszukiwań pozycjonuj przez sytuacje, w których ludzie faktycznie szukają.
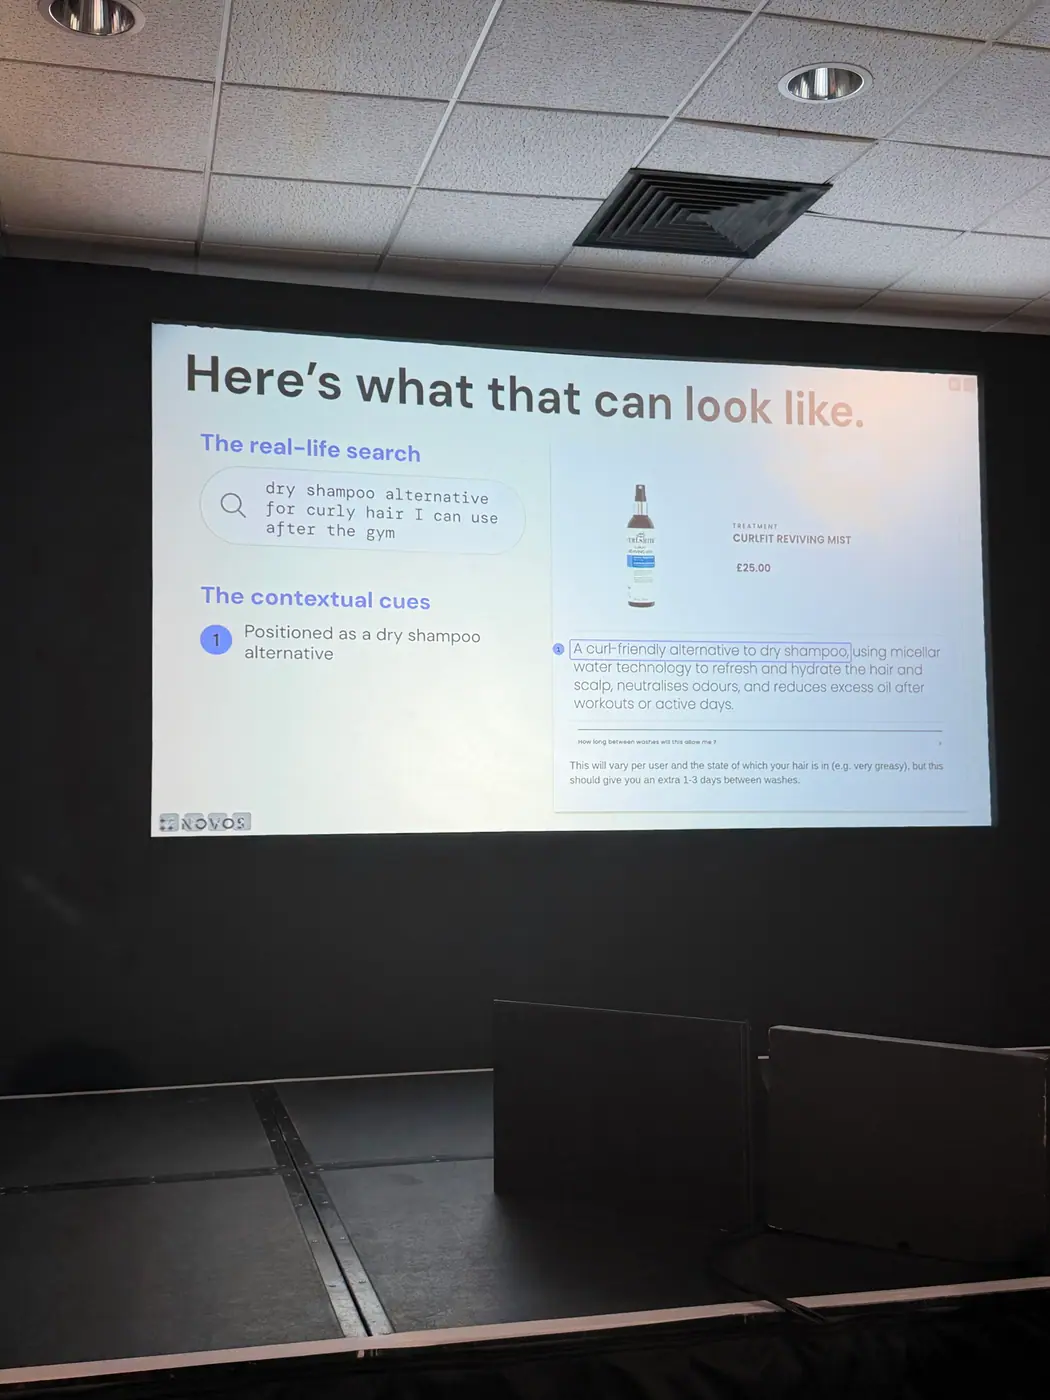
Curlsmith wypuścił sprej z wodą micelarną do włosów, czego prawie nikt nie wpisuje w wyszukiwarkę. Na PDP produkt opisano jako alternatywę dla suchego szamponu (tego ludzie szukają), umieszczono w realnej sytuacji (po treningu, w aktywne dni) i w sekcji FAQ (najczęściej zadawanych pytań) podano konkretny efekt: jeden do trzech dni więcej między myciami. Takie wskazówki sytuacyjne pozwalają wyszukiwarkom i modelom AI przypisać produkt do zapytań, a klientowi wyobrazić go sobie w swoim życiu. Podobnie działają Lick (do jakich pomieszczeń pasuje farba, w zależności od nasłonecznienia) i The Ordinary (sekcja „nie łącz z”).
„So we’re positioning it as a dry shampoo alternative because this is something people actually search for. We’ve placed it in a real situation. This is great after workouts or on active days.”
7. Rozbieżność ceny między feedem a stroną produktu to dla algorytmów sygnał braku wiarygodności.
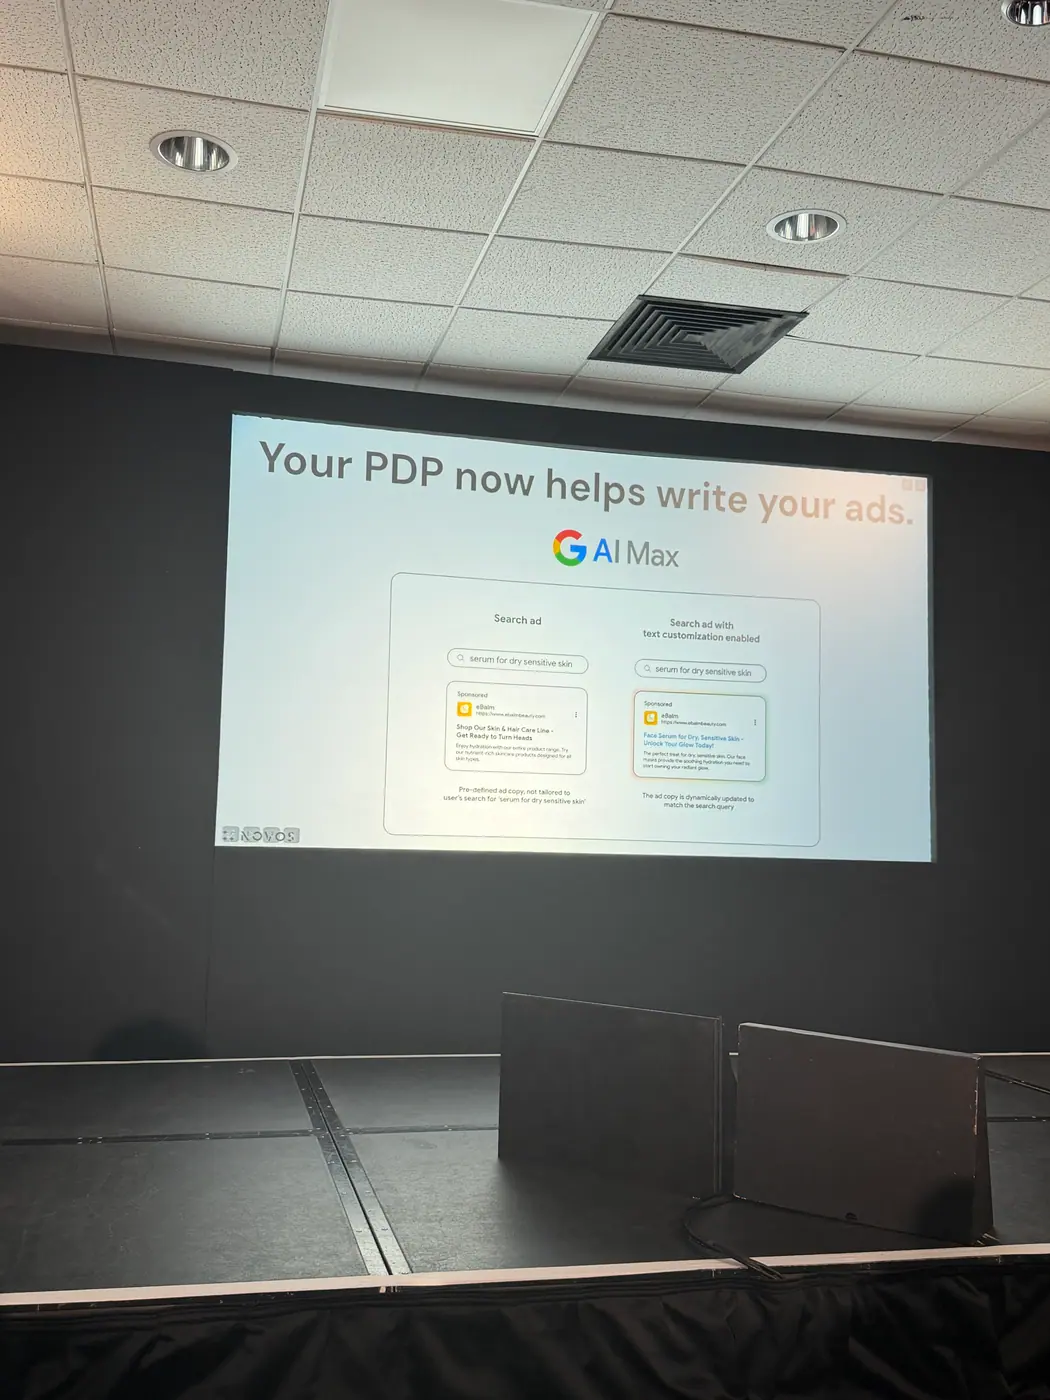
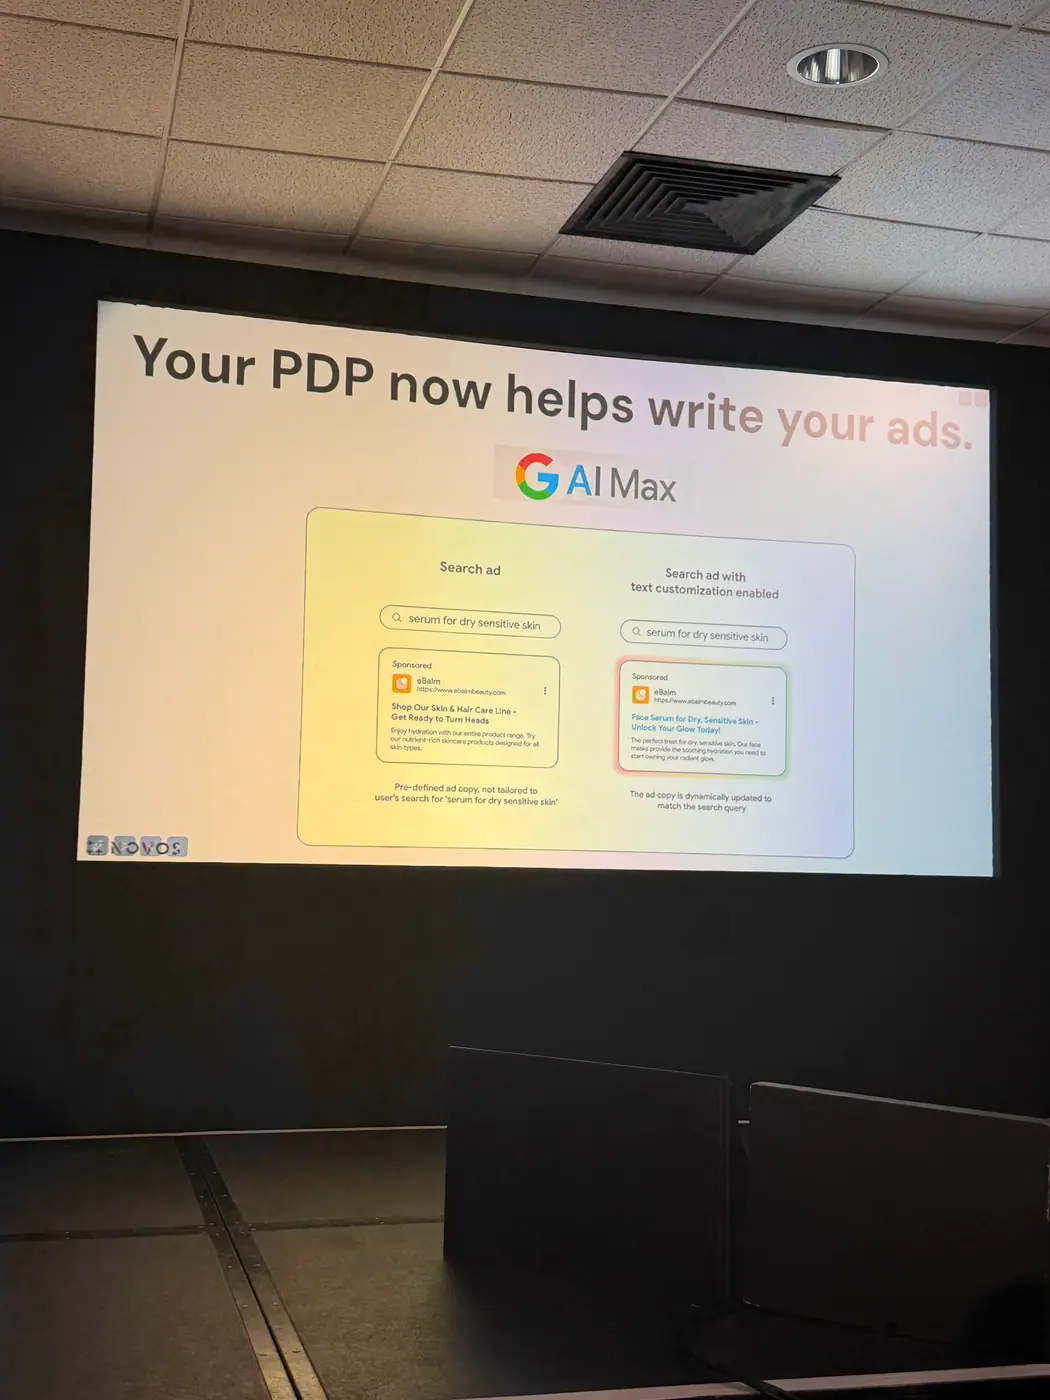
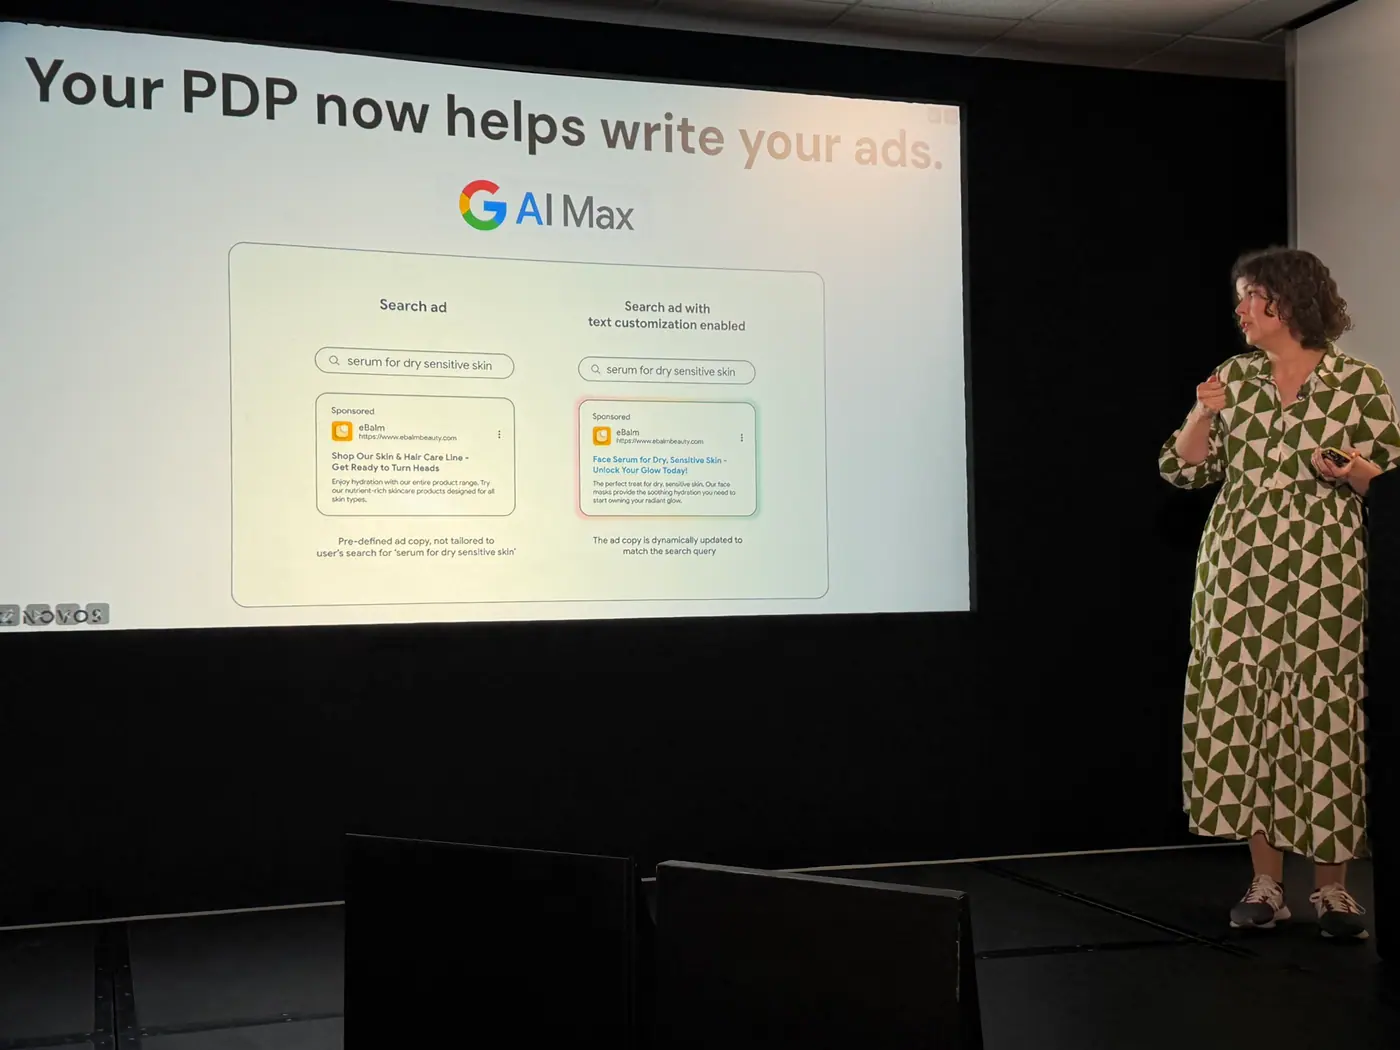
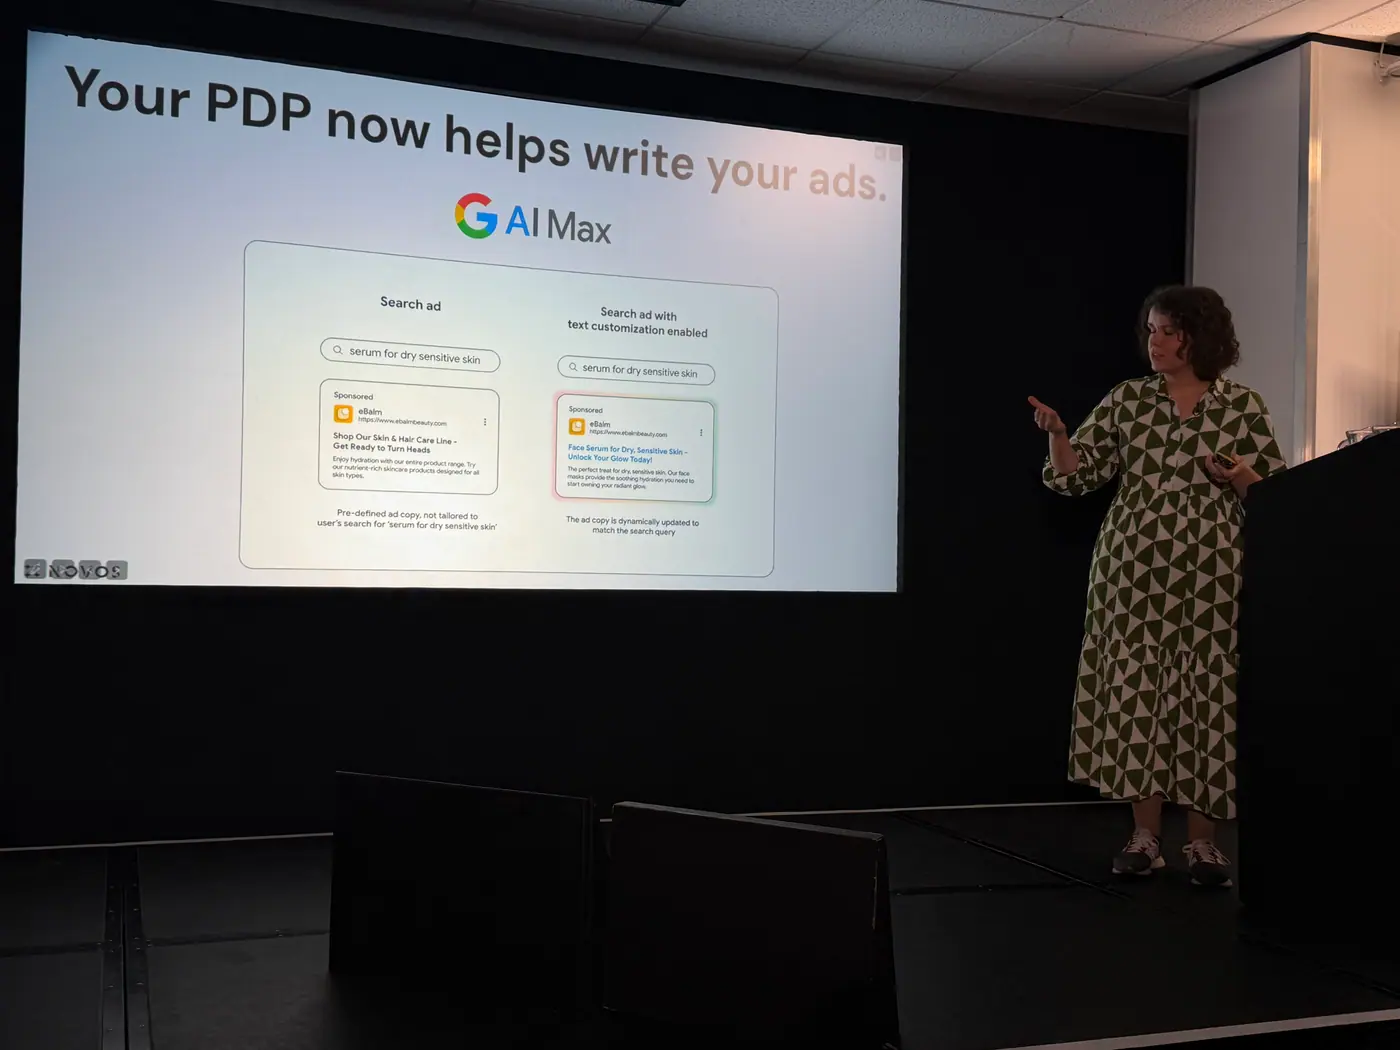
Google Shopping i platformy AI krzyżowo sprawdzają dane produktu z feedu, danych strukturalnych i strony. Niezgodność, np. inna cena w feedzie niż na PDP, oznacza, że produkt nie zostanie polecony. Dochodzi do tego AI Max w reklamach Google, który czyta stronę produktu i na jej podstawie przepisuje treść reklamy pod zapytanie, więc jakość PDP wprost przekłada się na jakość kampanii płatnych. Koivikko mówi o „sprzedawaniu algorytmom”, które decydują, czy w ogóle trafimy do rekomendacji.
„So if they see, for example, that your feed gives a different price than your PDP, that’s an immediate signal of you’re not trustworthy. So you shouldn’t be recommended.”
8. Jeśli producent nie opisuje własnego produktu, cytowania w odpowiedziach AI zgarnia detalista.
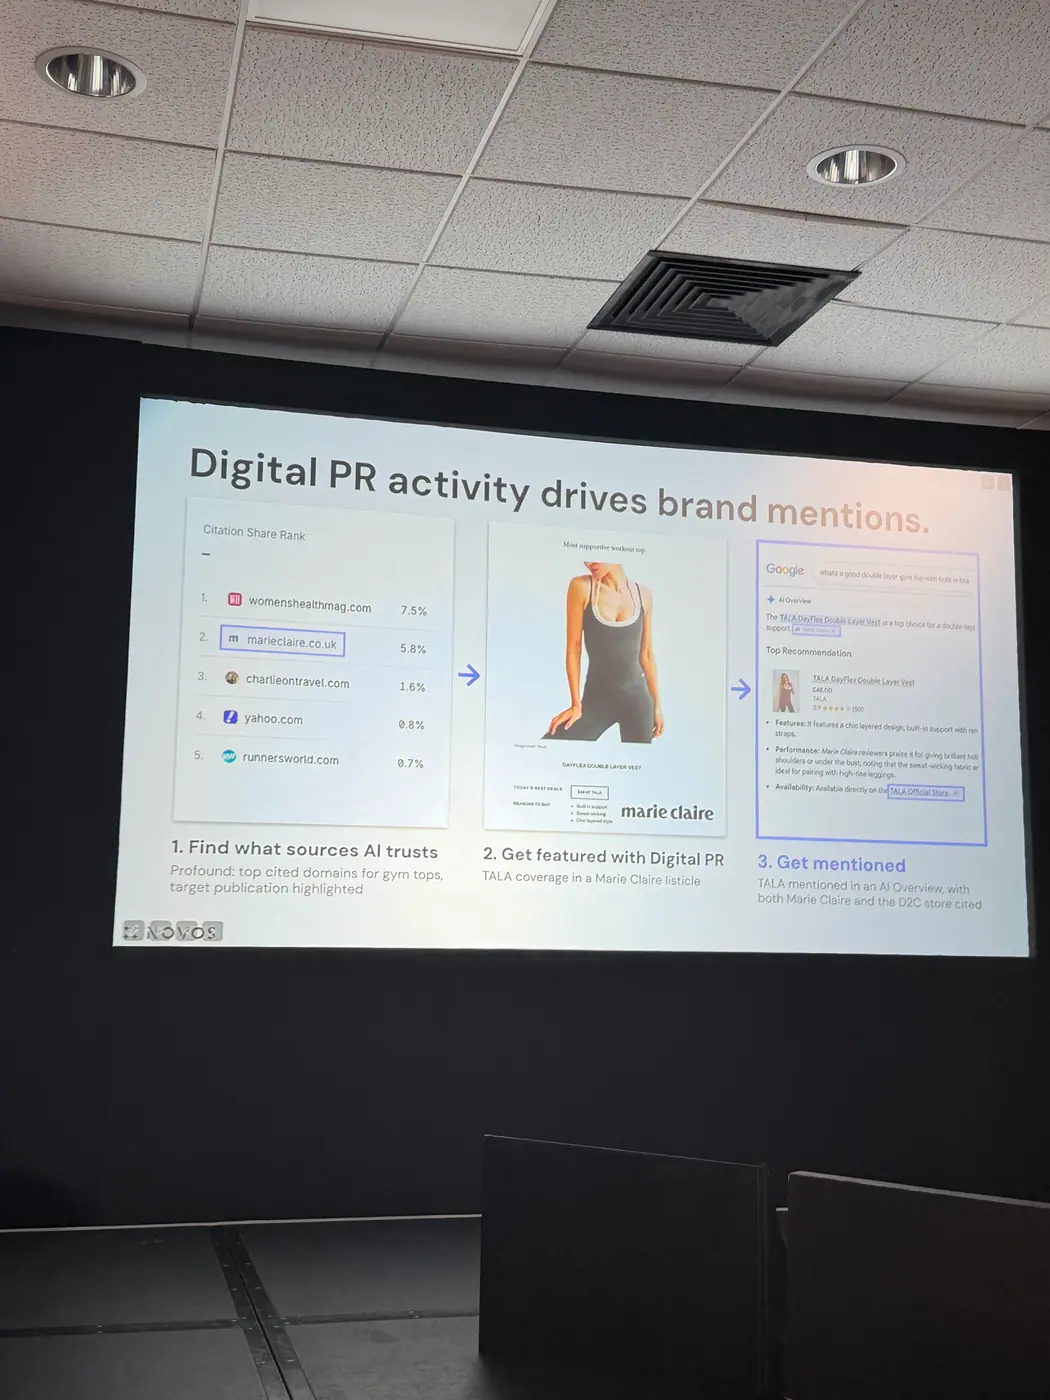
Sklep Dry Drinker dopisał do strony piwa BrewDog Punk AF propozycje podania i dopasowania do potraw, których nie ma na stronie producenta. W AI Overview na pytanie, z czym to piwo się komponuje, wszystkie cytowania idą do Dry Drinker, a strony BrewDog nie dostają żadnego linku. Odzyskanie kontroli nad historią produktu to z jednej strony PDP wart cytowania (Curlsmith jest cytowany z własnej strony produktu), z drugiej product-led digital PR: ustalenie, którym źródłom (np. Marie Claire) ufa AI, i doprowadzenie do obecności w ich listach zakupowych.
„A lot of this serving suggestions and food pairings, BrewDog doesn’t write any of that on their own page. […] it’s Dry Drinker that gets all those citations. BrewDog pages don’t get any links at all.”
Zdjęcia: Greta Koivikko
36 kadrów · Fot. Robert Nowaczyk
Adam Preston: The Biggest Factors in AI Visibility for Retailers
10:30
Streszczenie
Adam Preston przedstawił analizę 250 witryn sprzedawców detalicznych, zestawiając ich przygotowanie techniczne i treściowe z widocznością w odpowiedziach AI (Artificial Intelligence / sztuczna inteligencja).
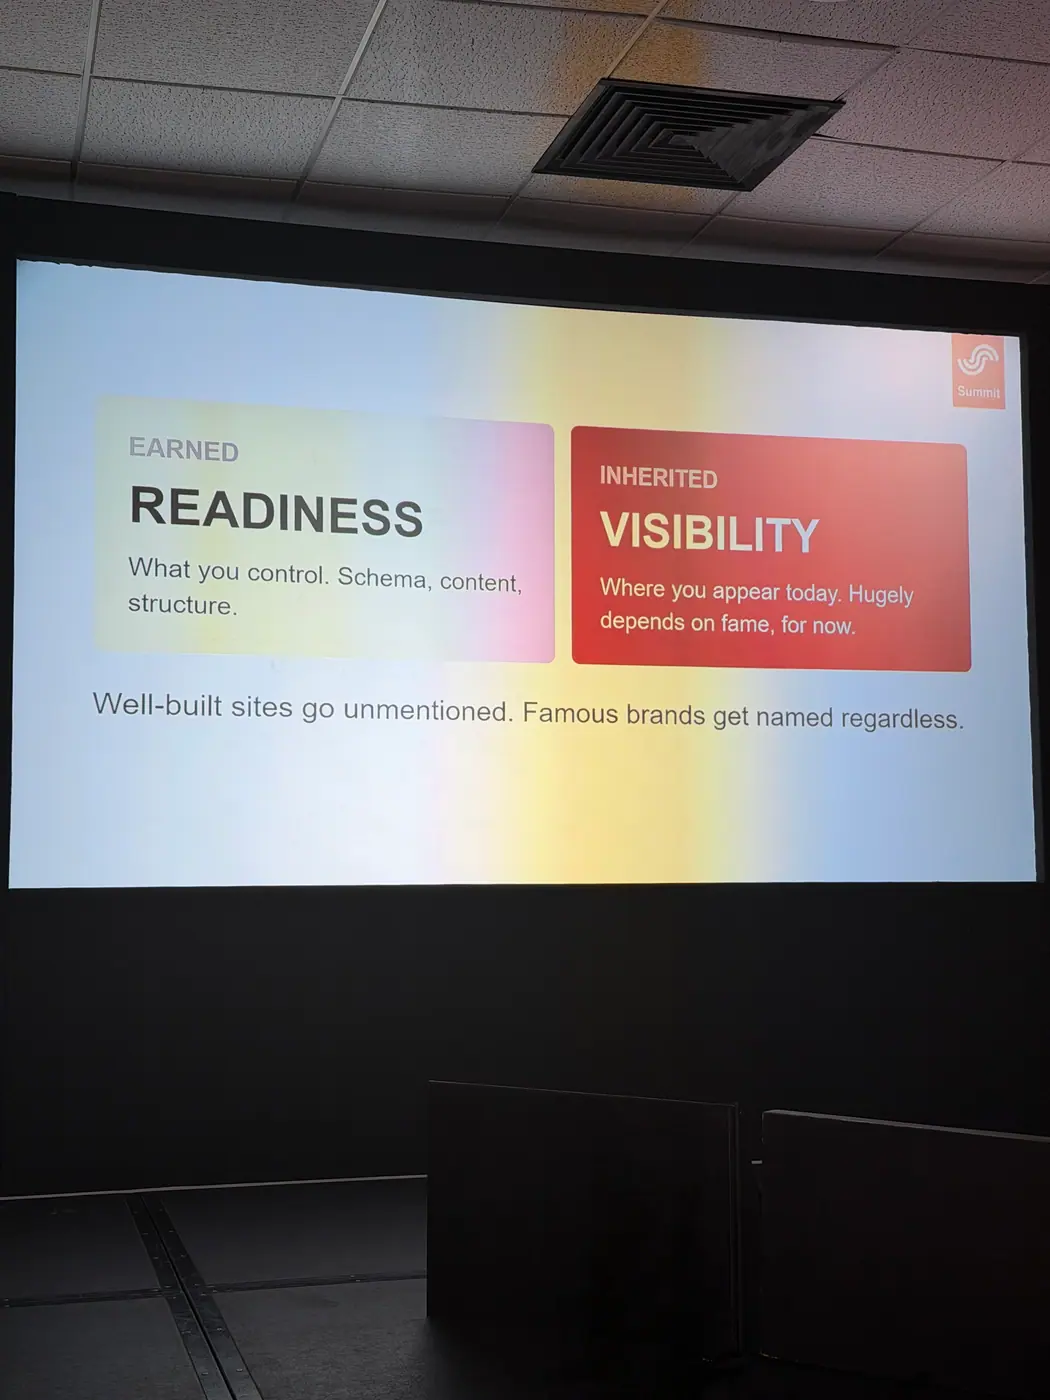
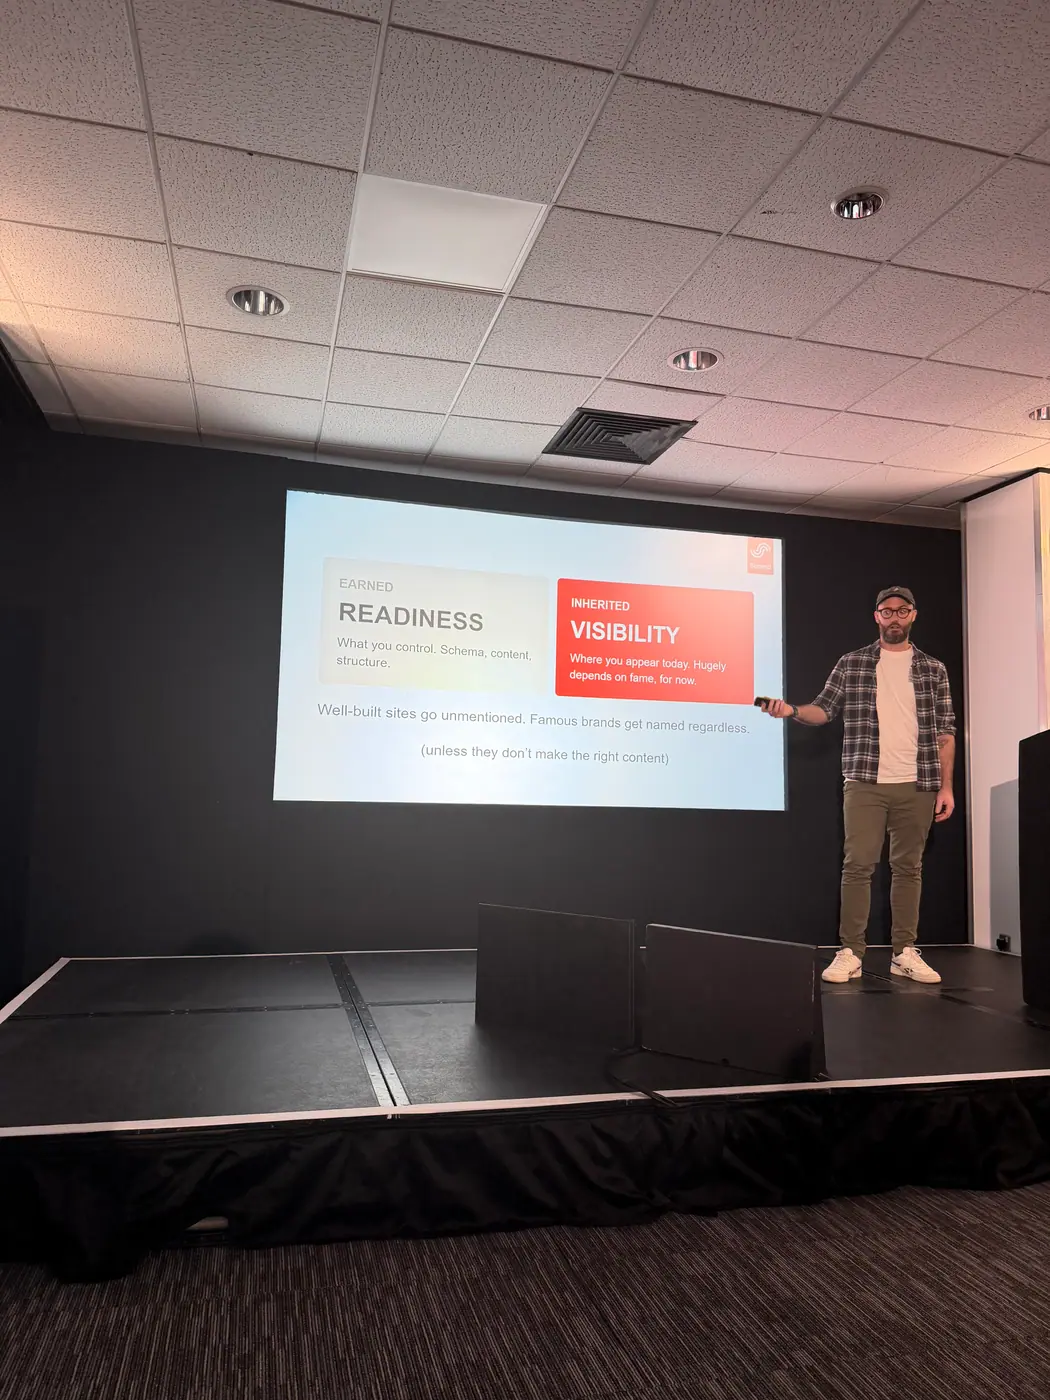
Główny wniosek: ani wysoka ocena SEO (Search Engine Optimization / optymalizacja pod wyszukiwarki), ani rozpoznawalność marki nie gwarantowały obecności w badanych odpowiedziach. Prelegent wskazał na połączenie trzech obszarów: dopasowania własnych stron do konkretnych potrzeb, obecności w zewnętrznych źródłach oraz spójnych informacji o marce i produktach.
Najważniejsze wnioski
1. Dobra ocena witryny nie była równoznaczna z widocznością w AI.
- Analiza objęła 250 witryn, po 50 na branżę, oraz około 11 sygnałów dotyczących m.in. treści, danych uporządkowanych, metadanych i dostępności dla robotów.
- Widoczność sprawdzono na podstawie 50 promptów na markę, dopasowanych do jej kategorii i produktów.
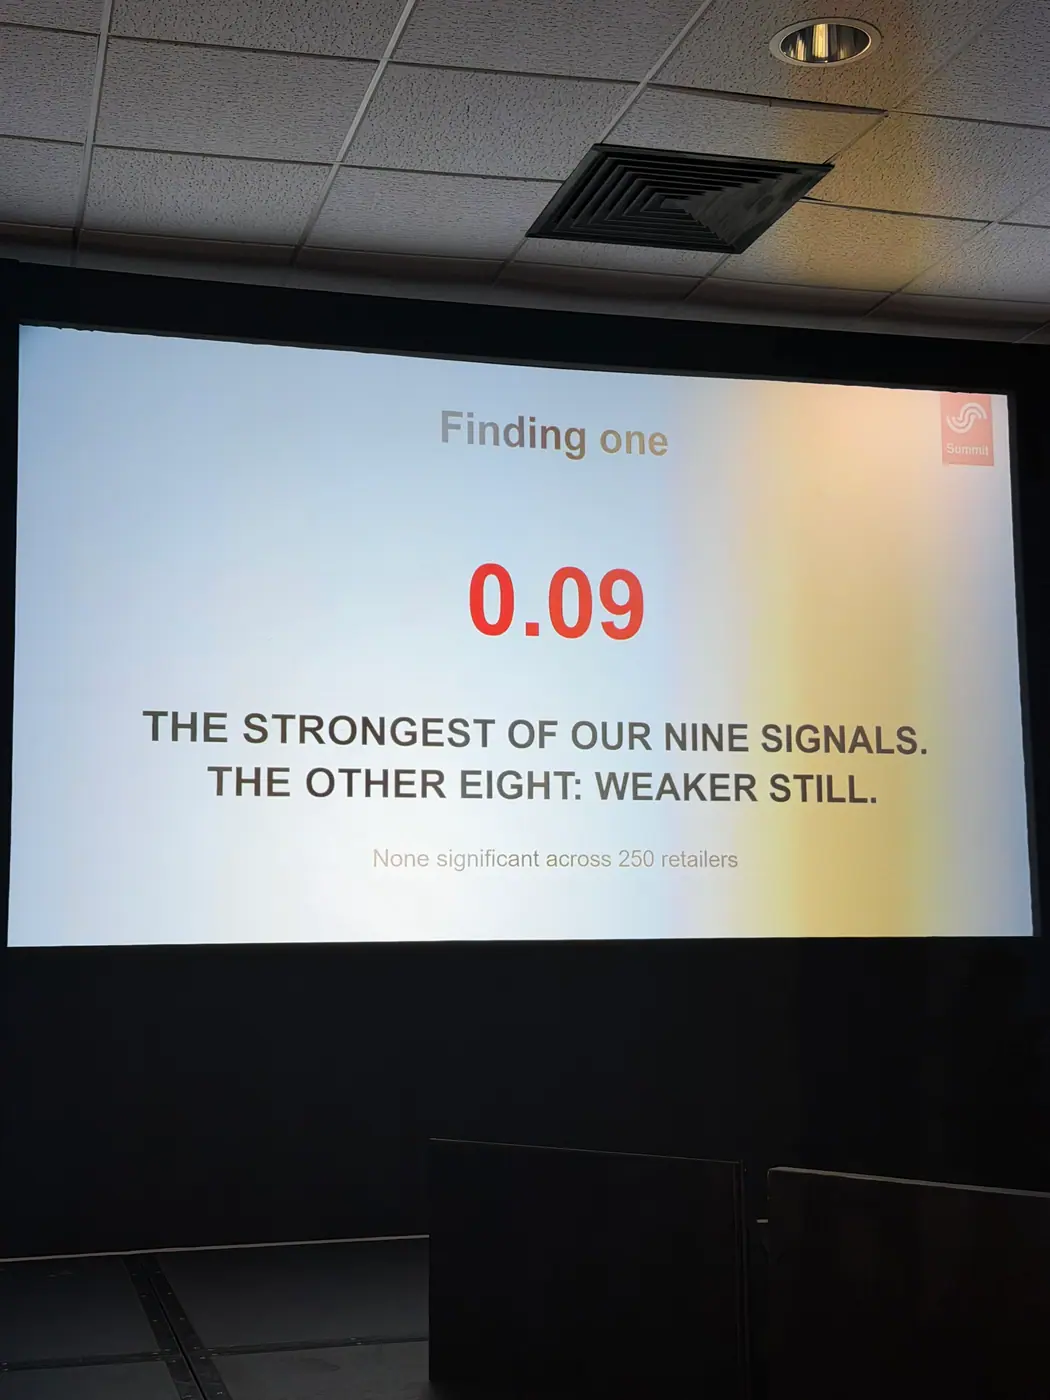
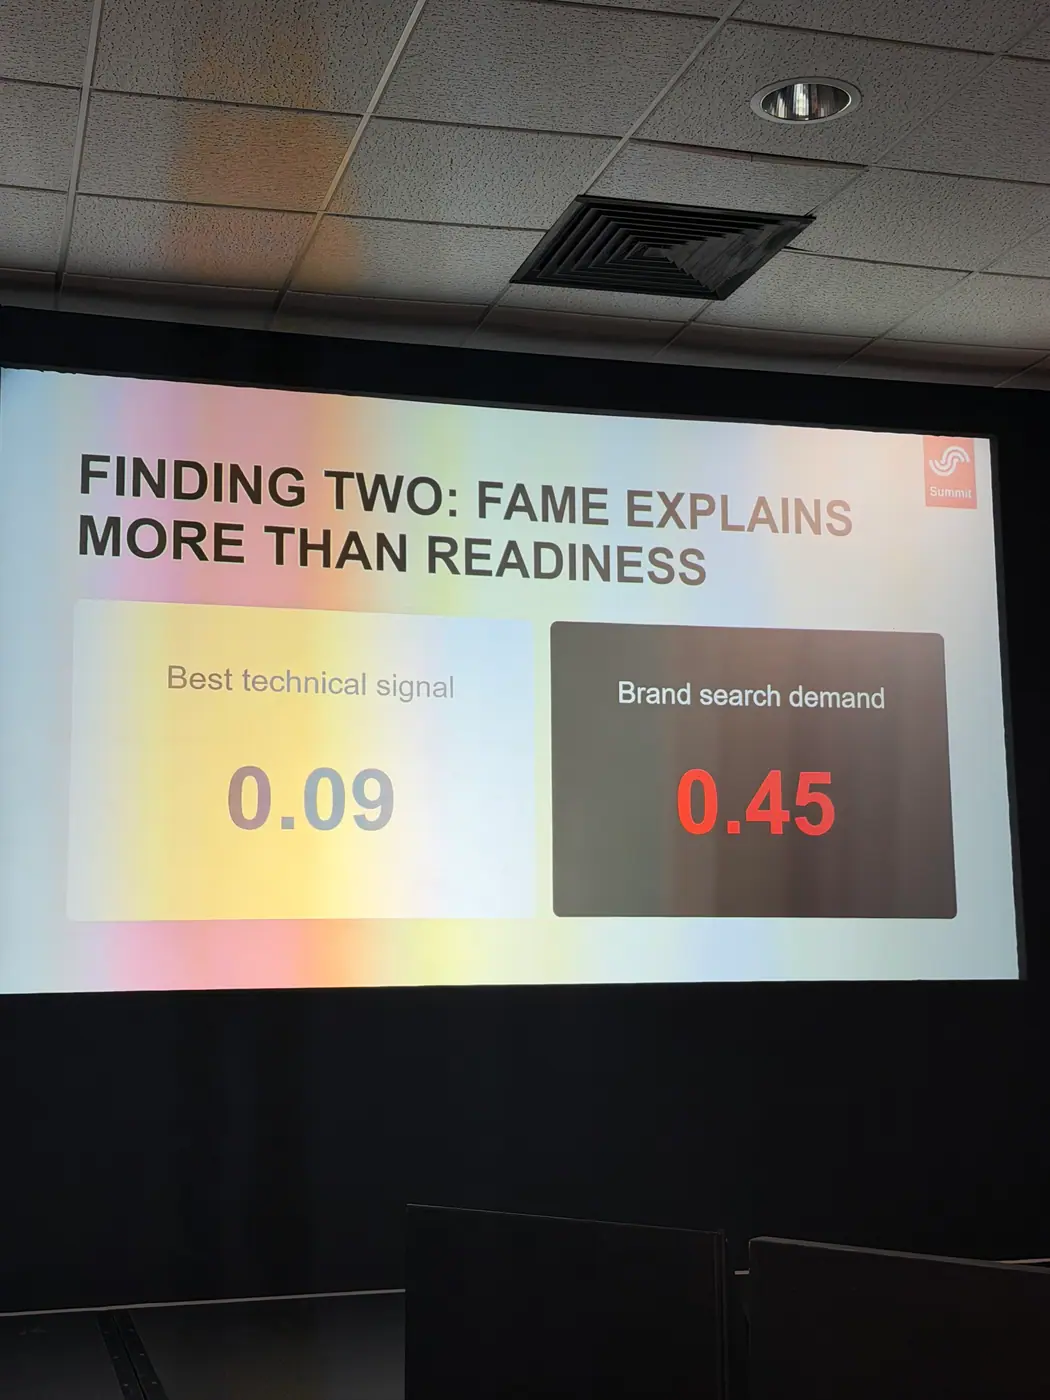
- Korelacje między ocenianymi sygnałami na stronie a widocznością były niewielkie. Dla jednego z sygnałów prelegent podał współczynnik 0,09.
- Preston częściowo tłumaczył ten wynik podobnym poziomem podstawowych wdrożeń w wielu witrynach. Nie przedstawiał go jako dowodu, że optymalizacja strony była zbędna.
2. Zewnętrzne źródła miały duże znaczenie, szczególnie przy pytaniach bez nazwy marki.
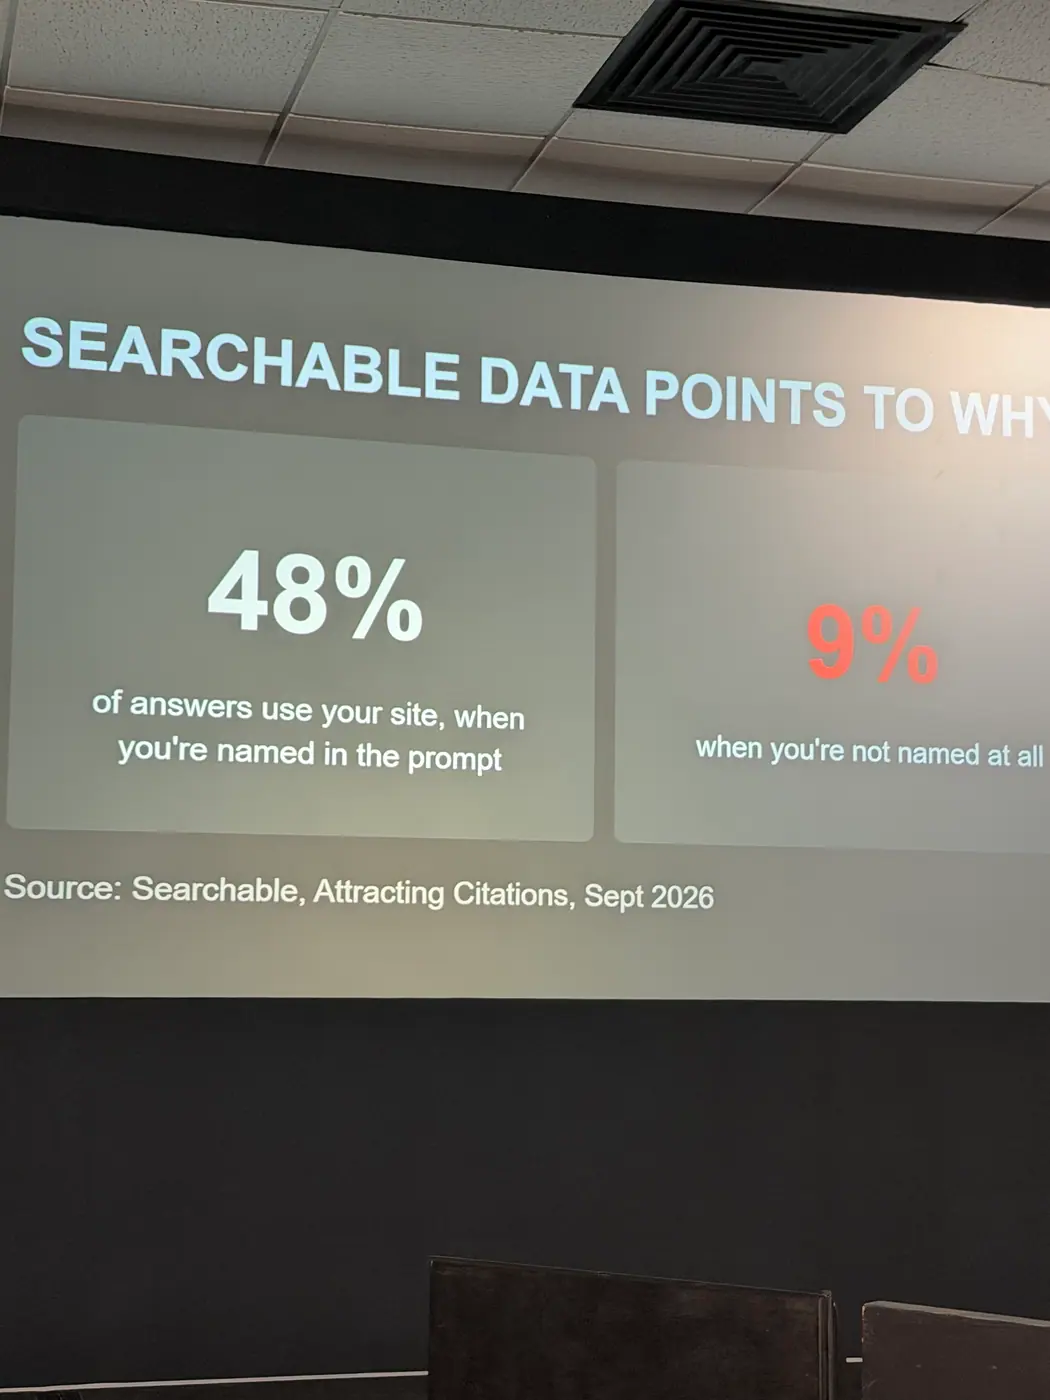
Prelegent przywołał osobne badanie Searchable obejmujące około 60 tys. promptów:
- Gdy marka występowała w pytaniu, jej własna witryna była wykorzystywana jako źródło w około 48% przypadków.
- Gdy pytanie nie zawierało nazwy marki, ale marka pojawiała się w odpowiedzi, w 91% przypadków źródłem była inna witryna.
Preston wiązał przewagę rozpoznawalnych marek z większą liczbą wzmianek, linków, publikacji i obecnością w zestawieniach. Popyt na wyszukiwania marki traktował jako oznakę jej rozpoznawalności, a nie dowód bezpośredniego wykorzystania wolumenu wyszukiwań przez modele.
3. Własna witryna nadal miała znaczenie jako źródło odpowiedzi.
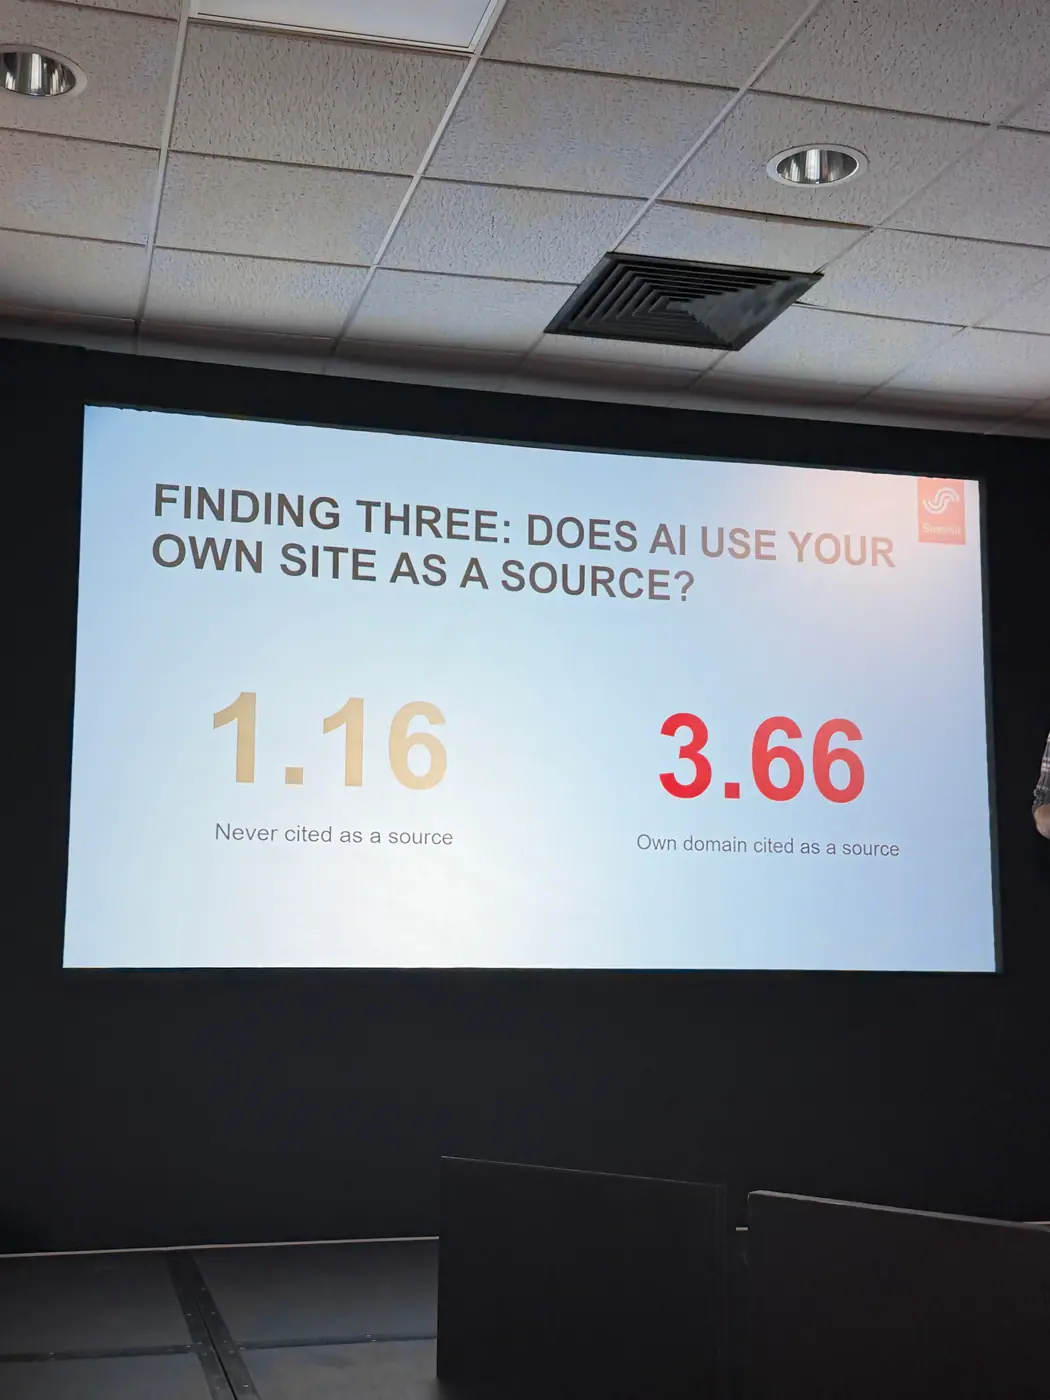
- W pokazanym porównaniu wynik widoczności wynosił 1,16/10 dla witryn niecytowanych oraz 3,66/10 dla witryn cytowanych. Było to porównanie grup, nie wynik konkretnego wdrożenia.
- Prelegent zalecał sprawdzanie, dlaczego informacje o marce były pobierane z cudzych stron, zamiast z jej własnego serwisu.
- Pokazał też przypadek sklepu zajmującego pierwsze miejsce w Google, który nie znalazł się wśród dziewięciu marek rekomendowanych w analizowanej odpowiedzi modelu.
4. Precyzyjne dopasowanie strony było ważniejsze niż sama obecność szerokiej kategorii.
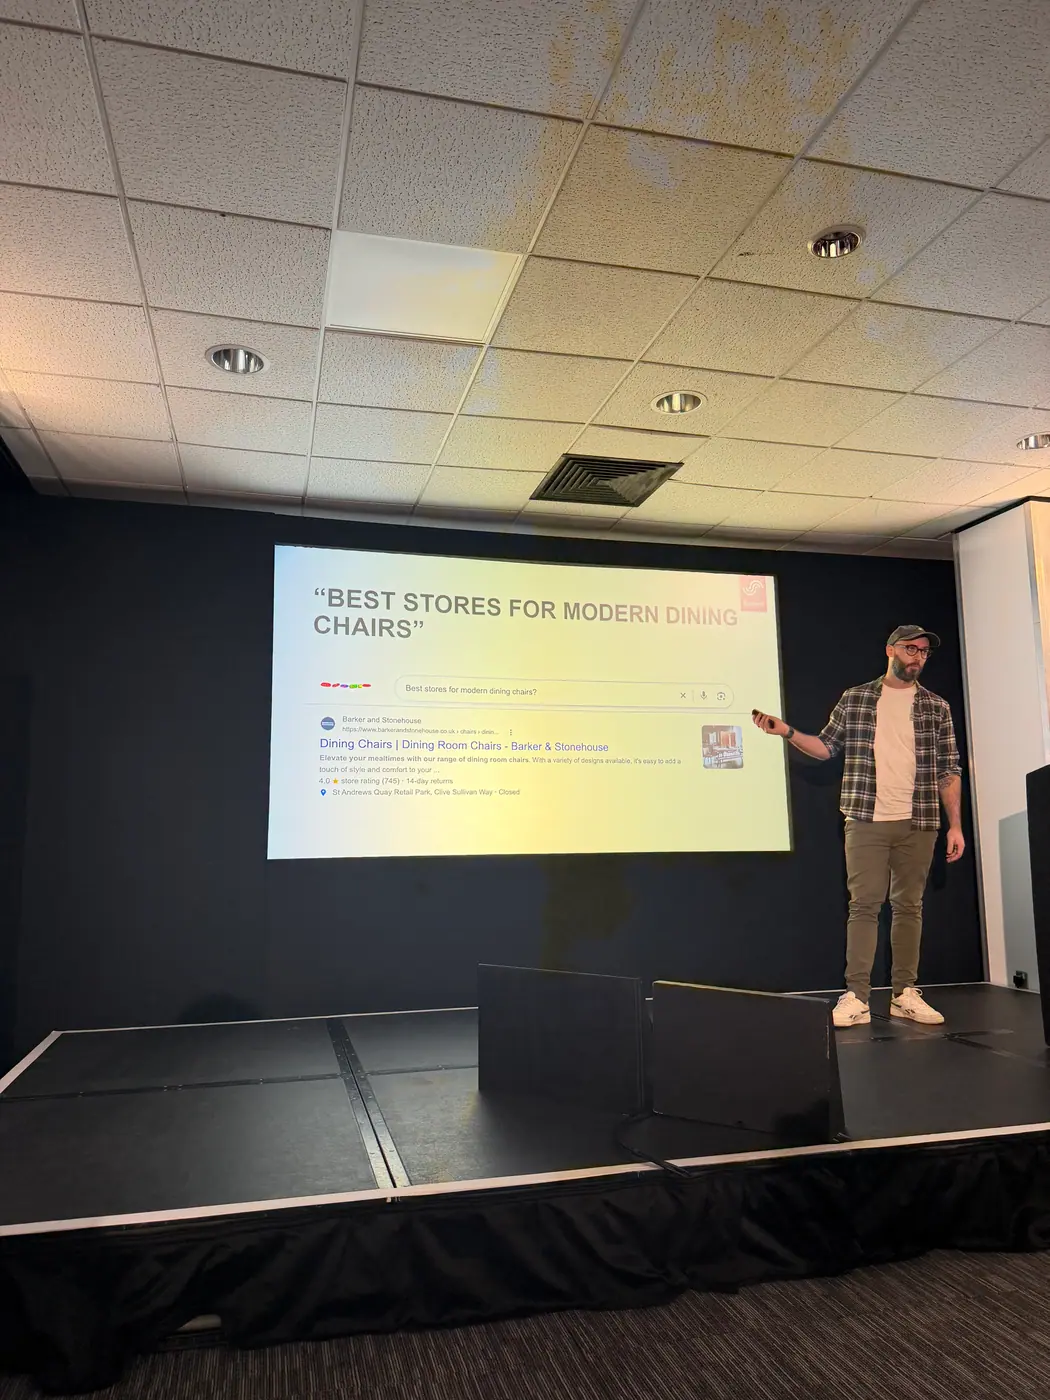
W przykładzie dotyczącym nowoczesnych krzeseł do jadalni jeden sklep miał ogólną kategorię i filtr „modern”, ale brakowało dostępnej strony odpowiadającej dokładnie tej potrzebie.
Konkurent dysponował taką stroną. Zawierała przede wszystkim tytuł i produkty, a mimo niewielkiej ilości tekstu została wykorzystana jako źródło odpowiedzi.
Preston pokazał również PDP (Product Detail Page / stronę szczegółów produktu) sprzedawcy, na podstawie której model rekomendował markę producenta. Wiązał to z opisem stylu i korzyści odpowiadających pytaniu użytkownika.
5. Zapytania pomocnicze ujawniały dodatkowy kontekst potrzebny do przygotowania treści.
W dodatkowej analizie 1000 promptów na branżę sprawdzono query fan-out, czyli rozwijanie pytania użytkownika w zestaw dodatkowych zapytań.
Według przedstawionych wyników model dodawał:
- wskazanie rynku brytyjskiego w około 30% przypadków,
- rok, np. 2026, w około 20% przypadków,
- słowo „best”, czyli „najlepsze”, w około 10% przypadków.
Prelegent rekomendował analizowanie tych rozwinięć, aby lepiej rozumieć, jakich stron i informacji model szukał podczas przygotowywania odpowiedzi.
6. Część działań wykraczała poza marketing i publikowanie treści.
Preston opisał analizowanie opinii o marce i konkurentach, a następnie przekazywanie wniosków zespołom produktowym, obsłudze klienta i logistyce. Przykładem były powtarzające się skargi na wolne dostawy.
Jego przewidywanie: poprawa rzeczywistej jakości obsługi powinna z czasem sprzyjać lepszym opiniom i rekomendacjom. To argument za traktowaniem GEO (Generative Engine Optimization / optymalizacja widoczności w wyszukiwarkach generatywnych) jako pracy międzyzespołowej, a nie wyłącznie zadania dla SEO.
Praktyczne rady
- Mierz osobno przygotowanie witryny i rzeczywistą widoczność. Sprawdzaj zarówno obecność marki w odpowiedziach, jak i cytowanie jej domeny.
- Analizuj źródła odpowiedzi. Ustal, które publikacje i zestawienia wspierają rekomendacje konkurentów oraz jakich informacji o własnej marce brakuje w serwisie.
- Sprawdzaj strony odpowiadające na szczegółowe potrzeby. Dotyczy to także stron wynikających z filtrowania. Wykorzystuj zapytania pomocnicze do oceny ich dopasowania.
- Łącz opisy korzyści z konkretnymi produktami. Uzgadniaj tę samą argumentację z zespołami afiliacji, komunikacji z mediami i mediów społecznościowych.
- Przekazuj problemy z opinii do zespołów, które mogą je rozwiązać. Negatywnych doświadczeń zakupowych nie naprawi sam opis produktu.
Knowledge bombs
1. W badaniu 250 sklepów korelacja sygnałów on-site z widocznością w AI wyszła znikoma: dla pełnej treści 0,09.
Summit ocenił 250 witryn detalicznych (po 50 w pięciu branżach) pod kątem 11 sygnałów: dane strukturalne, metadane, teksty alternatywne, treść, jej nastawienie na korzyści i dostępność dla botów, a potem zestawił to z widocznością w AI mierzoną przez Searchable na 50 promptach na markę. Wszystkie sygnały on-site miały korelację dodatnią, ale bardzo małą. Jednym z powodów jest brak zróżnicowania: większość sklepów ma standardowe dane produktowe i wynik około 6–7 na 10, więc nie ma czym się wyróżnić.
„So this is full text was 0.09. It’s about 9%, I guess, in terms of correlation. There’s things like structured data and contents of all positive, but all very small.”
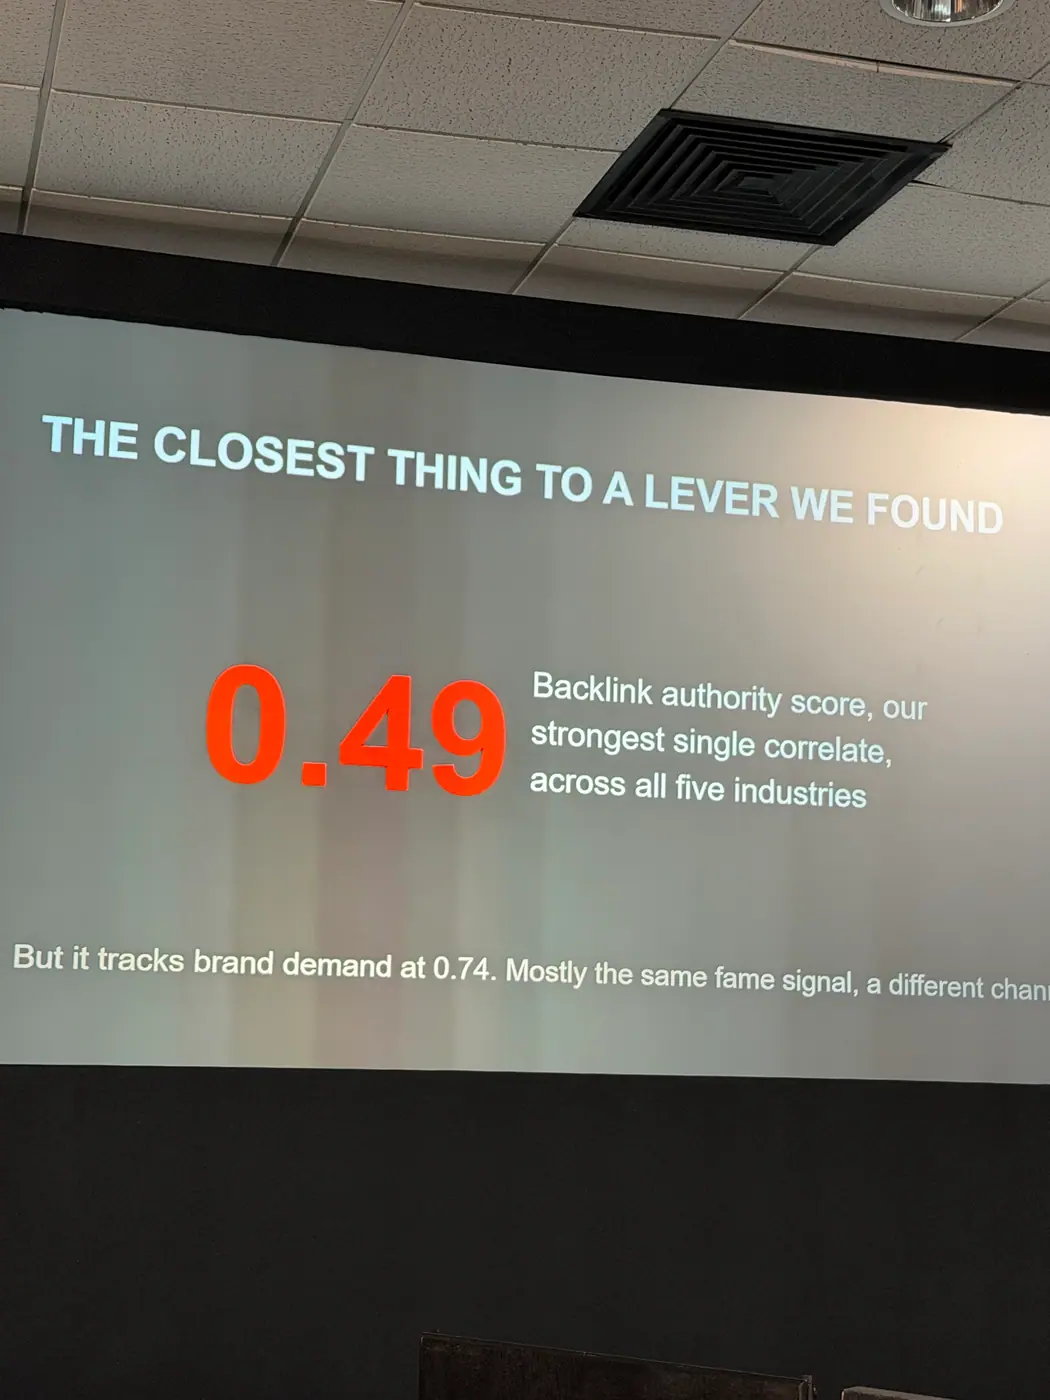
2. Największym czynnikiem widoczności w AI okazała się rozpoznawalność marki, nie jakość strony.
Popyt na markę (liczba wyszukiwań brandowych) i wynikająca z niego siła profilu linków korelowały z widocznością w AI wyraźnie mocniej niż cokolwiek na samej stronie. Mechanizm jest prosty: większa marka ma więcej linków, wzmianek, obecności w mediach społecznościowych i w listach zakupowych, a to właśnie z takich źródeł modele składają rekomendacje. Dla praktyka SEO oznacza to, że czynniki off-site trzeba traktować jako główną dźwignię, a nie dodatek do optymalizacji technicznej.
„But also, when we started looking, okay, what else could be an impact then? Brand fame was the impact.”
3. Gdy marka pojawia się w odpowiedzi AI bez wymienienia jej w pytaniu, w 91 proc. przypadków źródłem jest cudza strona.
Z osobnego badania Searchable na około 60 000 promptów: jeśli użytkownik wymienia markę w pytaniu, model opiera odpowiedź na jej stronie w 48 proc. przypadków; jeśli marka pojawia się jako rekomendacja bez wymieniania jej w pytaniu, aż w 91 proc. przypadków źródłem jest inna witryna. Ponad połowa wzmianek o marce pochodzi spoza jej strony. Zadaniem jest znaleźć, jakich informacji o marce i produktach AI szuka gdzie indziej, i uzupełnić je u siebie, tak żeby ten 48-procentowy udział rósł do 60–70 proc.
„When your brand’s answered, when your brand’s mentioned in the prompt, about 48% of the time, it’s using your website. But actually, when you’re not mentioned in the prompt, but you are an answer […] 91% of the time, it’s a different website.”
4. Marki nigdy niecytowane jako źródło miały widoczność w AI 1,16 na 10, a cytowane 3,66.
To ważna korekta do punktu o sile marki: nie wystarczy być duży i liczyć na cudze wzmianki. Marki, które same bywają cytowane jako źródło odpowiedzi, mają ponad trzykrotnie wyższy wynik widoczności niż te, których nikt nie cytuje. Trzeba więc wiedzieć, jakie prompty padają w danej kategorii, i celowo budować strony, które mogą być na nie odpowiedzią.
„this is 1.16 and 3.66, so if you’re never cited as a source, you get a much smaller AI Visibility Score, whereas if you are cited, so you can’t just rely on your brand”
5. Barker and Stonehouse jest numerem jeden w Google na „modern dining chairs” i nie istnieje w ChatGPT.
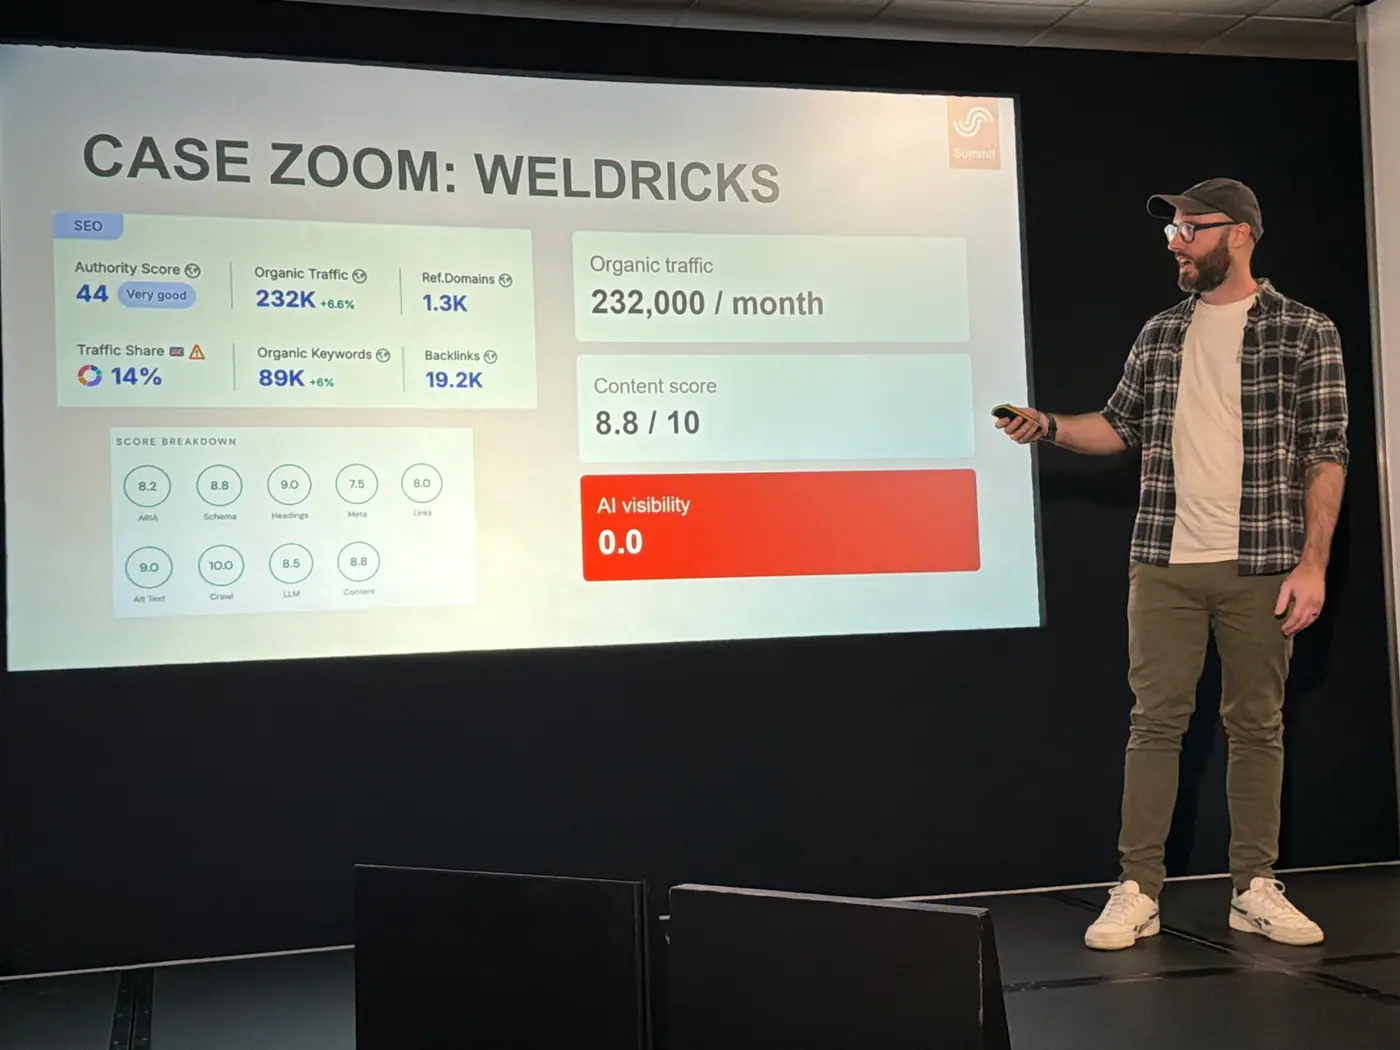
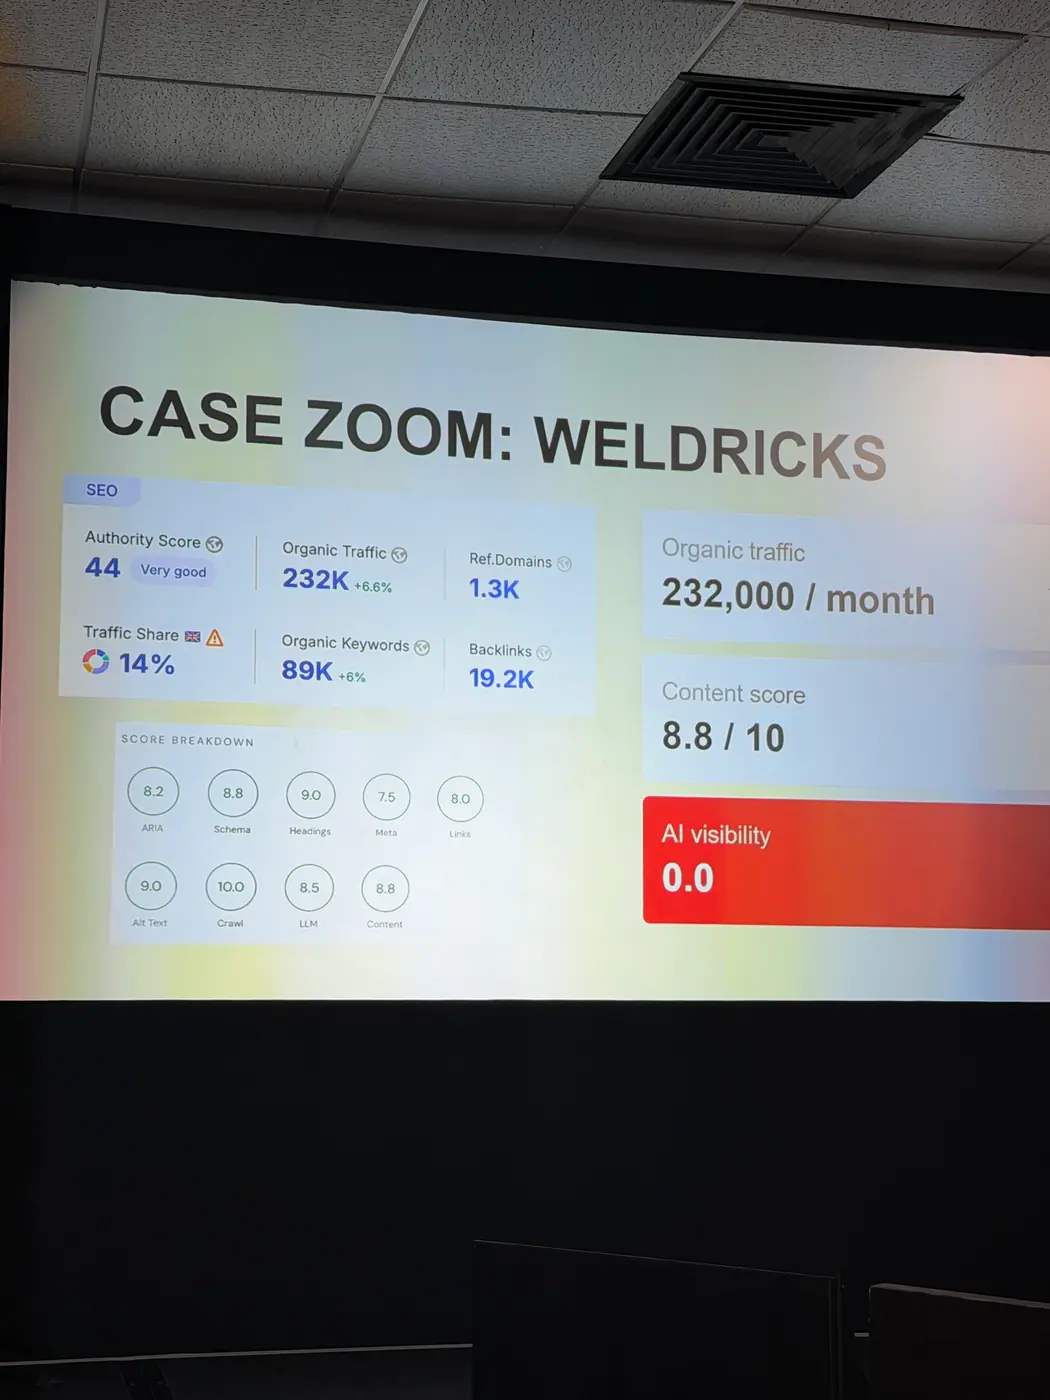
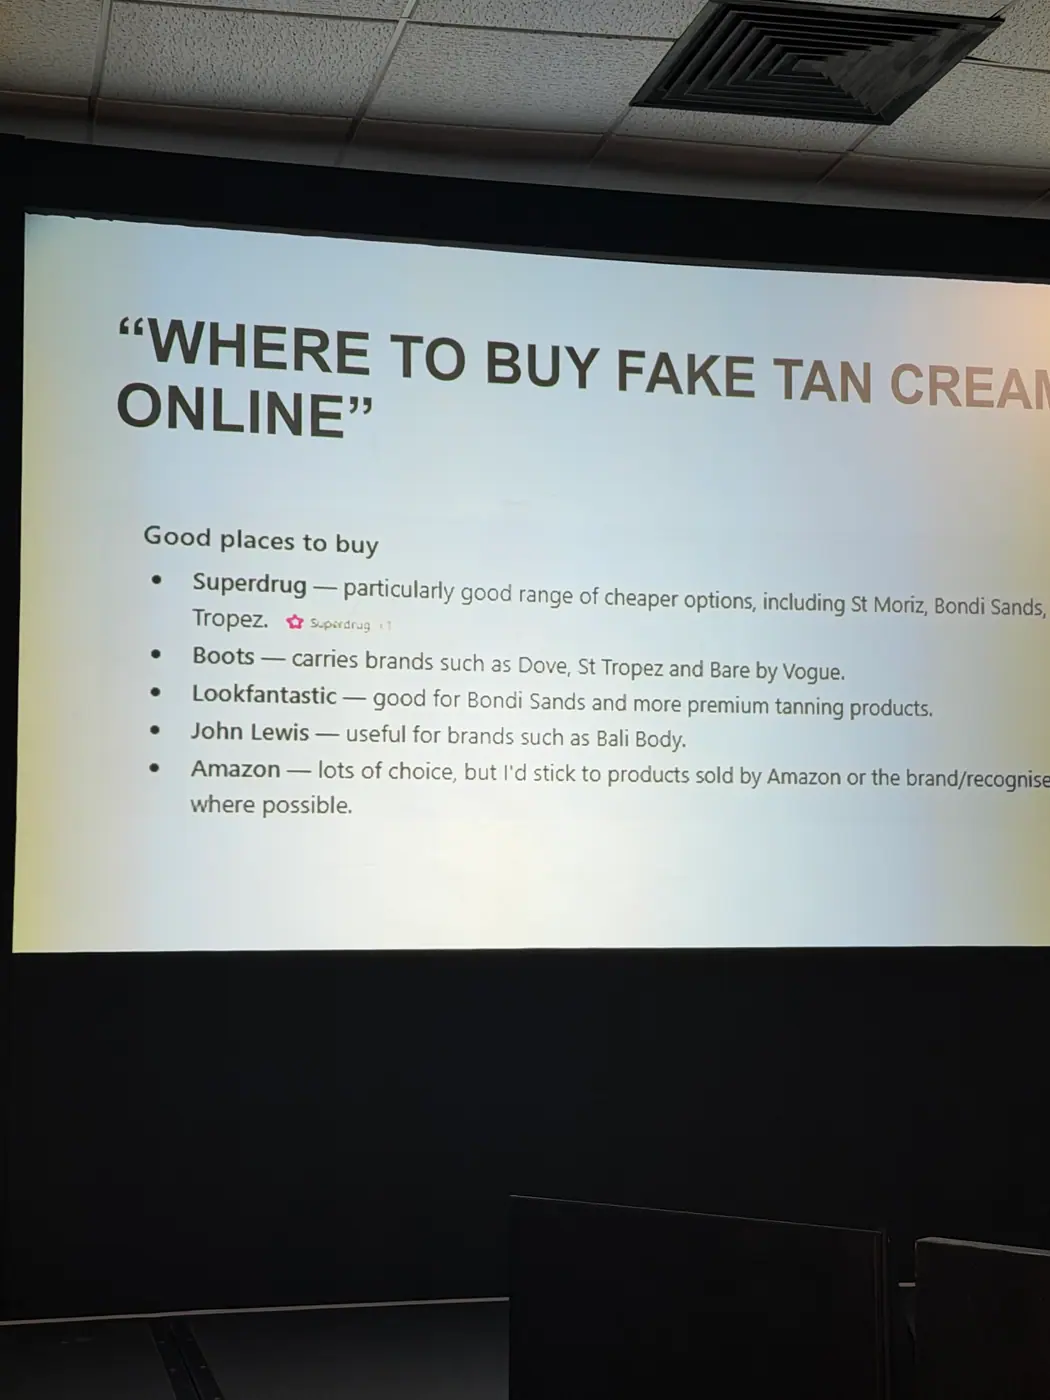
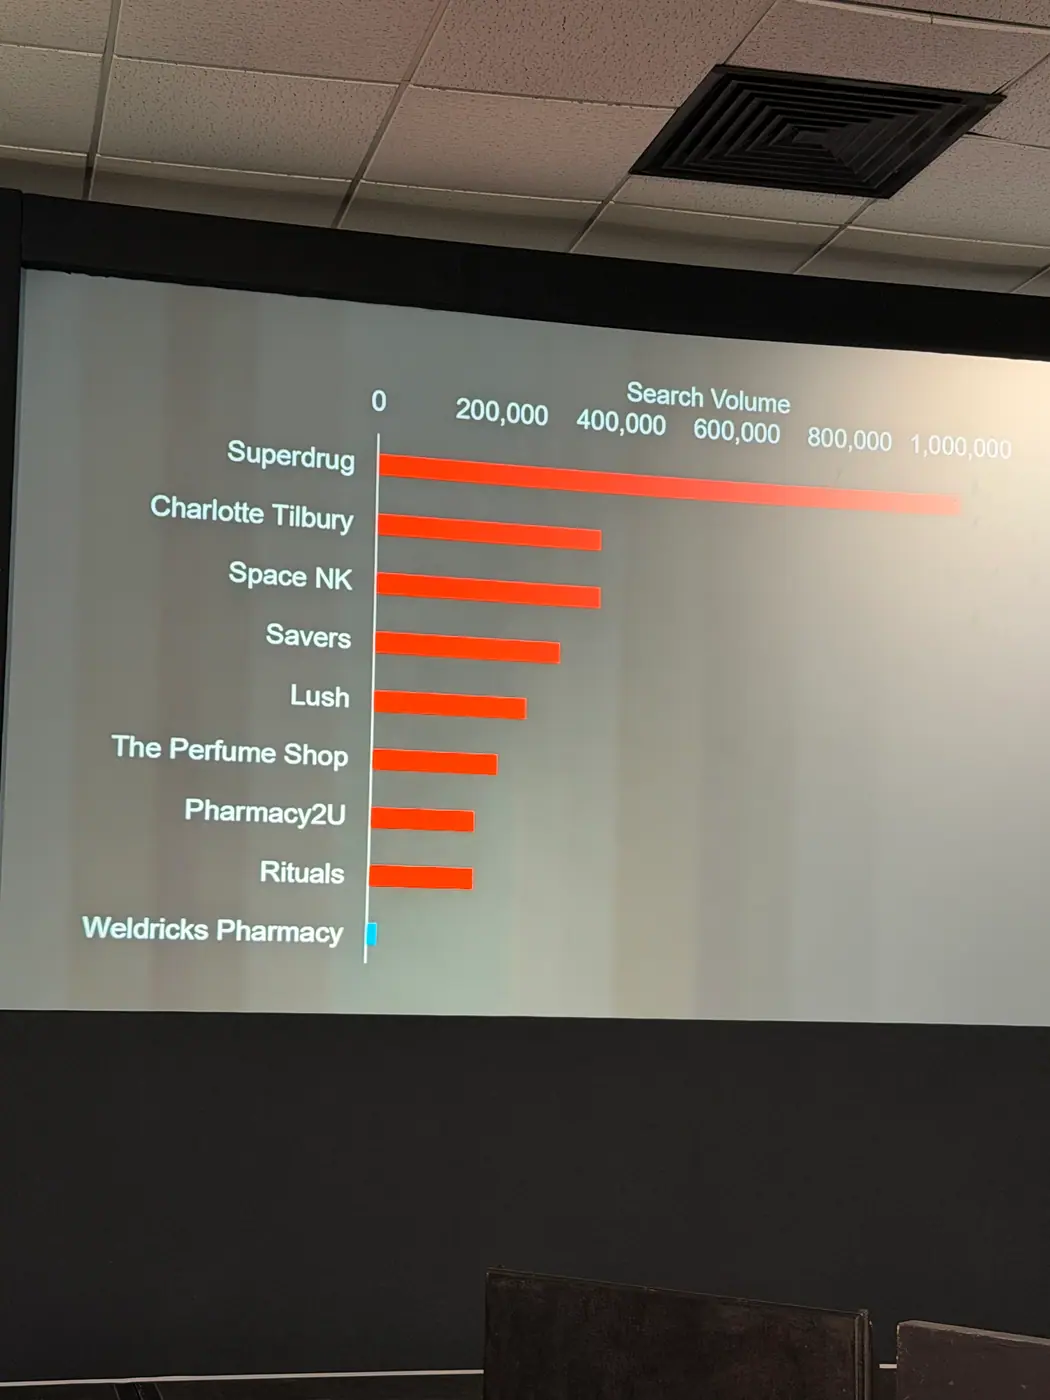
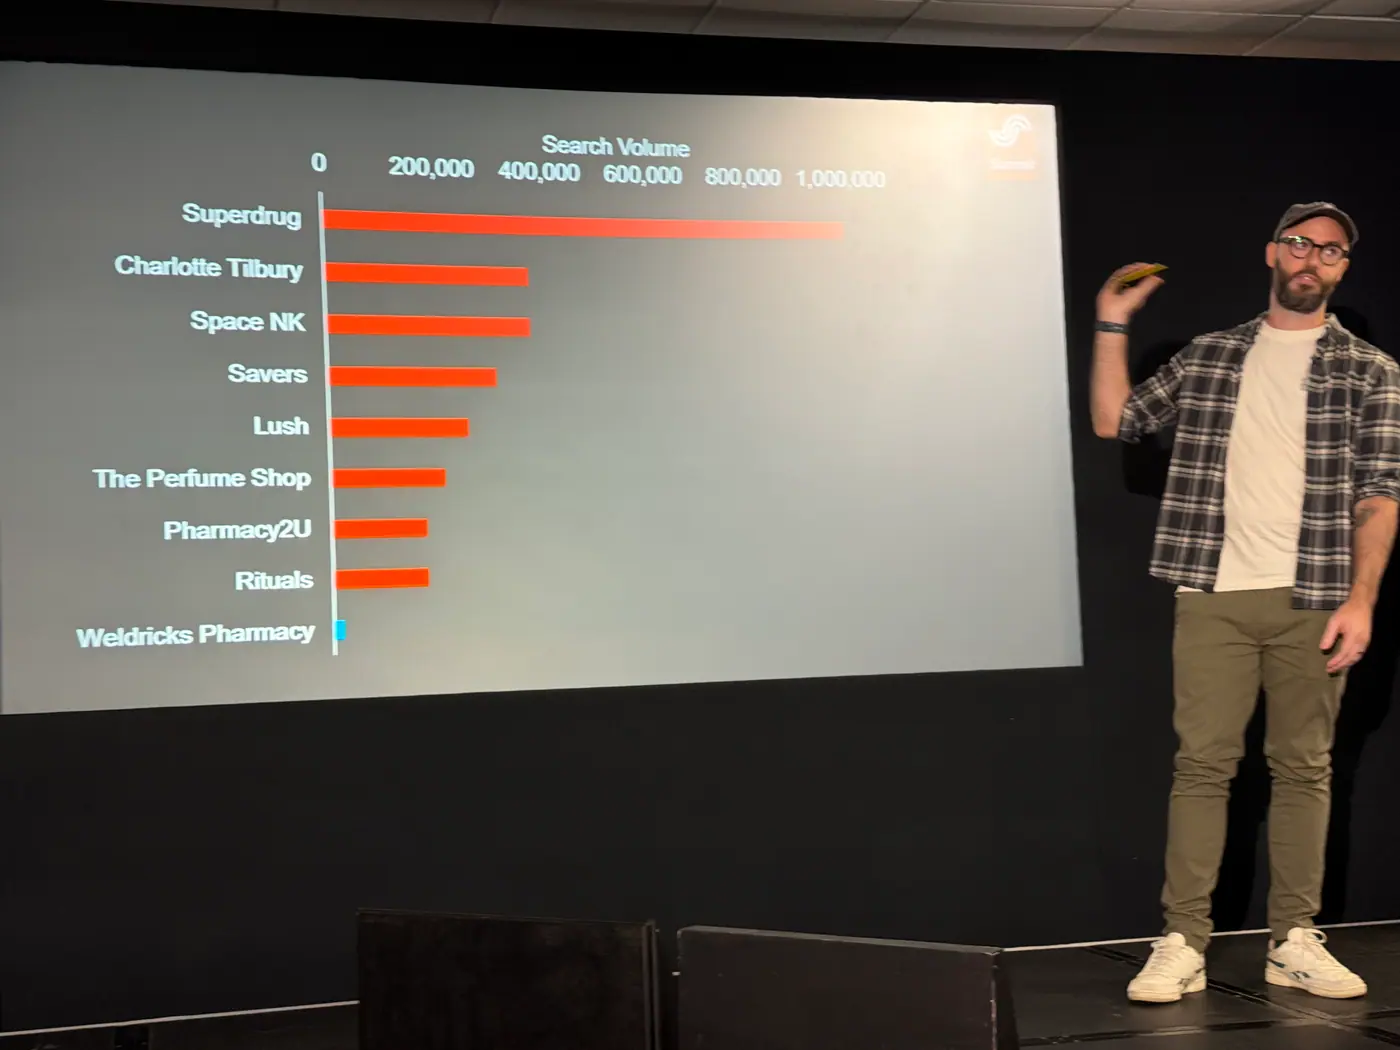
Duża marka meblowa z około 300 000 szacowanych wizyt organicznych miesięcznie zajmuje pierwszą pozycję w Google na frazę o nowoczesnych krzesłach do jadalni, a w ChatGPT wśród dziewięciu polecanych marek jej nie ma. Powody: na stronie nie ma żadnej treści o „nowoczesności” (jest tylko nieindeksowalny filtr) i marka nie figuruje w listach zakupowych typu The Independent czy Ideal Home. Ranking w Google i rekomendacja w AI to dwa różne procesy; nawet jeśli fan-out modelu (rozbicie pytania na pod-zapytania) sięgnął po podobne wyniki Google, model odrzucił markę na podstawie innych informacji. To samo dotyczy Weldricks Pharmacy, Superdrug i Ted Baker: w ocenie SEO wysoko, w promptach o własnych produktach praktycznie nieobecne.
„So despite them having a really good SEO presence in that term, there’s nowhere to be seen.”
6. Pusta, indeksowalna strona filtra John Lewis nie rankuje w Google, a w AI jest pierwszym wynikiem.
Strona „modern dining chairs” w John Lewis to sam tytuł i produkty, bez żadnej treści, i w Google nie rankuje nawet na zapytanie z nazwą sklepu. Mimo to ChatGPT cytuje ją jako pierwszą, bo John Lewis ma każdy filtr indeksowalny i dostępny dla crawlerów, a nazwa strony pokrywa się z treścią promptu. Konkurenci mają te same filtry, ale zablokowane, więc nie mogą zostać zwrócone jako odpowiedź. Wniosek dla sklepów: fasety i filtry muszą być indeksowalne i crawlowalne, a jeśli dostaną własną treść, tym lepiej.
„Because this page, if you actually search it in Google, doesn’t rank whatsoever. […] So from an SEO point of view, it’s really, really poor. But from an AI point of view, it’s ranked number one.”
7. Fan-out dopisuje do promptu „UK” w 30 proc., rok w 20 proc., „best” w 10 proc. przypadków, a strony z tymi słowami w tytule i H1 wracają w około jednej czwartej odpowiedzi.
Dodatkowe 1000 promptów na branżę pokazało, jak model sam doprecyzowuje pytanie użytkownika: dodaje kraj, rok (2026) i słowo „best”, jeśli użytkownik ich nie wpisał. Strony, które miały te doprecyzowania w meta title i H1, były zwracane w około 25 proc. przypadków. Dane o fan-oucie z narzędzi do monitoringu AI to konkretna wskazówka, co dopisać do tytułów i nagłówków stron kategorii.
„About 30% of the time, it adds UK to that prompt. About 20% of the time, it will add year, so 2026. And about 10% of the time, it adds best, if you’re not adding it yourself.”
8. Jedna strona produktu u detalisty może wciągnąć do rekomendacji całą markę producenta.
ChatGPT poleca markę krzeseł Swift, ale cytuje nie jej stronę, tylko PDP (stronę produktu) w John Lewis, bo tam opis mówi językiem korzyści o stylu „contemporary” i „modern”. Preston robi z tego metodę: dla klienta z branży materacy wybiera jeden produkt-bohatera i jedną korzyść (chłodzenie), a potem ten sam komunikat idzie przez afiliantów z listami najlepszych materacy chłodzących, digital PR i social media, tak żeby wiele źródeł mówiło to samo. GEO (generative engine optimization, optymalizacja pod wyszukiwarki generatywne) wymaga wyjścia z kanału SEO; do tego dochodzi analiza sentymentu z Reddita i social mediów, przekazywana zespołom produktu i obsługi klienta, bo wolne dostawy obniżają rekomendacje tak samo jak braki na stronie.
„And even though it’s just one PDP and one product, they’re recommending that whole brand just based on John Lewis’s PDP because they’re really focused in that.”
Zdjęcia: Adam Preston
21 kadrów · Fot. Robert Nowaczyk
Chris Willow: Building an Agency Like a SaaS
11:20
Streszczenie
Podczas brightonSEO Chris Willow przekonywał, że właściciel agencji nie musi budować własnego SaaS (Software as a Service / oprogramowanie jako usługa), żeby przejąć część ekonomiki tego modelu: powtarzalne przychody, wysokie marże i niski koszt obsługi kolejnego klienta.
Podstawą miały być jasno zdefiniowane usługi za stałą cenę, systematycznie usprawniane procesy oraz dłuższa współpraca z klientami. AI (Artificial Intelligence / sztuczna inteligencja) miała wspierać ten model, ale nie zastępować uporządkowanej organizacji pracy.
Najważniejsza myśl: każdy projekt powinien przynosić nie tylko pieniądze, lecz także poprawiać system realizacji usług i tworzyć warunki do dalszego wzrostu.
Najważniejsze wnioski
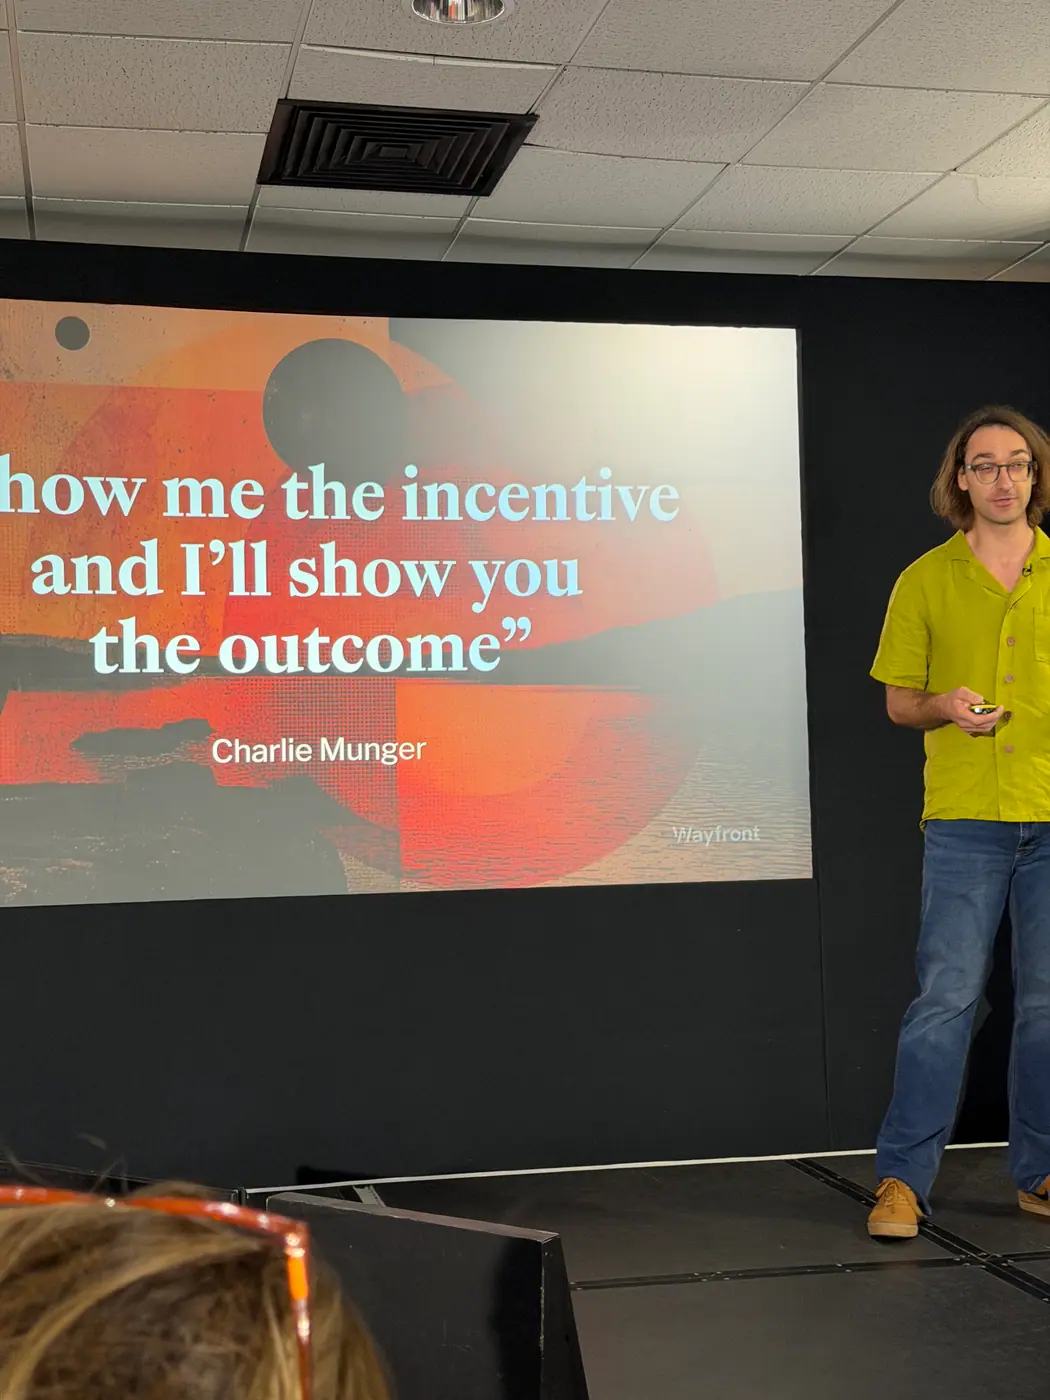
Opinia prelegenta: rozliczenie godzinowe osłabia motywację do zwiększania efektywności.
Gdy technologia skraca czas pracy, mniej godzin może oznaczać niższy przychód. Willow rekomendował rozliczanie za rezultat biznesowy, a gdy nie pozostawał on pod kontrolą agencji, za konkretny zakres prac i materiały do przekazania.Rekomendacja: standaryzować usługę, a następnie ulepszać sposób jej realizacji.
Przy stałej cenie sprawniejszy proces może poprawiać marżę. Prelegent wskazał testowanie własnego onboardingu, czyli wdrożenia klienta do współpracy, ograniczanie formularzy, wspólne zasady obsługi oraz proste automatyzacje.Wniosek z przedstawionego modelu: sama sprzedaż nie wystarcza do utrzymania wzrostu.
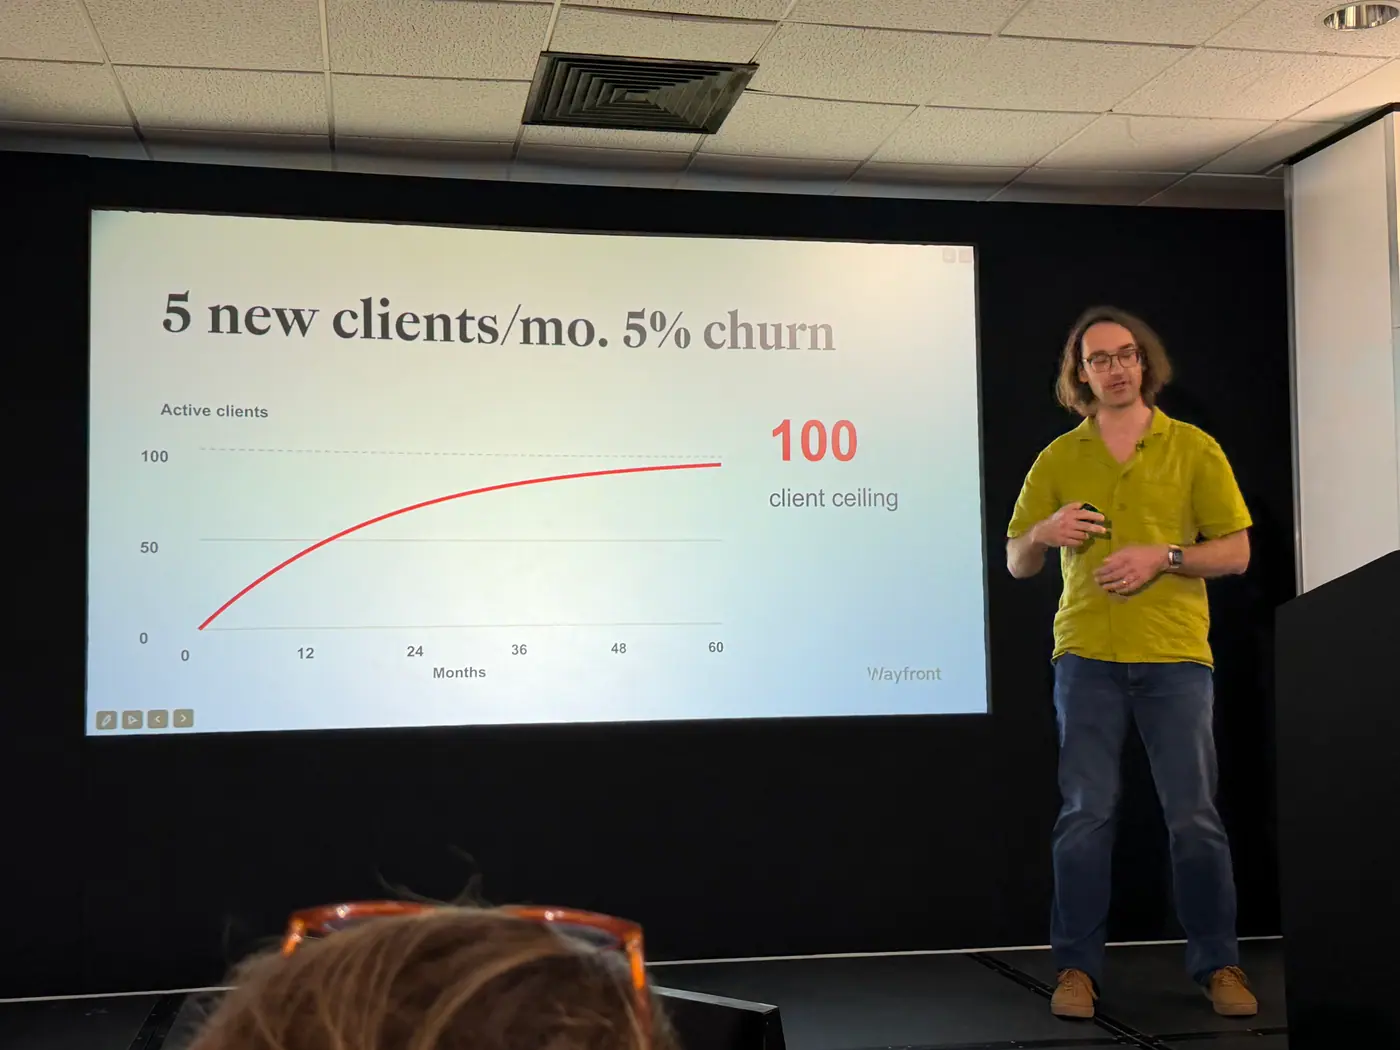
Liczba nowych klientów może z czasem jedynie równoważyć odejścia. Willow wyróżnił trzy dźwignie: pozyskiwanie klientów, ich utrzymanie oraz zwiększanie LTV (Lifetime Value / wartość klienta w całym okresie współpracy).Rekomendacja: przenosić do agencji mechanizmy abonamentowe, nie tylko sam abonament.
Wśród przykładów znalazły się automatyczne płatności, plany roczne, pakiety kredytów do wykorzystania na usługi, płatne okresy próbne i samodzielne rozszerzanie pakietu. Miały wspierać MRR (Monthly Recurring Revenue / miesięczny przychód powtarzalny).Rekomendacja: część korzyści z efektywności przekazywać klientom.
Nie musiało to oznaczać obniżki cen. Prelegent wymienił szybszą realizację, mniej formalności, wyższą jakość i większy zakres w tej samej cenie. Wzrost miały wspierać również polecenia z korzyścią dla obu stron oraz realizacja usług pod marką innych agencji.Prognoza prelegenta: po usprawnieniu realizacji ograniczeniem może stać się popyt, a nie zdolność wykonania pracy.
Zbliżenie kosztu obsługi kolejnego klienta do zera było docelową wizją tego modelu. Willow nie traktował jednak produktowania usług jako rozwiązania dla każdego rodzaju współpracy, szczególnie z największymi klientami.
Dane liczbowe i przykłady
| Liczba | Znaczenie | Charakter informacji |
|---|---|---|
| 5 nowych klientów miesięcznie, 5% miesięcznego odpływu, 100 klientów | Przy 100 klientach miesięcznie odchodzi 5, więc pozyskiwanie kolejnych 5 tylko uzupełnia straty. | Przykład obliczeniowy pokazujący pułap wzrostu przy stałych założeniach. |
| 95% klientów przeszło na abonament | Jedna z opisanych agencji sprzedawała pierwszy miesiąc jako usługę jednorazową, zamiast wymagać od razu subskrypcji. | Wynik pojedynczego przypadku przywołany przez prelegenta. |
| Ponad 500 mln dolarów wartości sprzedanych usług | Według Willow agencje sprzedały usługi o takiej wartości z pomocą jego platformy. | Deklaracja prelegenta dotycząca skali transakcji, nie przychodu jego firmy. |
Praktyczne rady
- Zdefiniuj jedną powtarzalną usługę: zakres, cenę, wymagane materiały, termin i zasady poprawek. W agencji SEO (Search Engine Optimization / optymalizacja pod kątem wyszukiwarek) przykładem mogłaby być mapa tematyczna.
- Przejdź własny onboarding jako klient. Sprawdź, gdzie formularze przytłaczają, pytania się powtarzają i brakuje jasnej informacji o kolejnym kroku.
- Ustal zasady przed rozpoczęciem projektu. Opóźnienie materiałów od klienta powinno mieć z góry określony wpływ na termin realizacji.
- Automatyzuj najpierw znane czynności: przypomnienia, tworzenie zadań, aktualizacje statusu i raporty. Oprzyj je na uporządkowanym, wspólnym źródle danych.
- Ułatw klientowi ocenę współpracy. Udostępniaj w jednym miejscu wykonane prace, uzasadnienia, status projektu i możliwości rozszerzenia usługi.
Knowledge bombs
1. Rozliczanie godzinowe przestało działać, bo klient wie, że agencja używa AI.
Willow (założyciel Wavefront, platformy do sprzedaży usług agencyjnych) twierdzi, że zawyżanie godzin lub stawki jest dziś czytelne dla klientów i psuje wiarygodność, a dodatkowo rozliczanie czasem nie motywuje agencji do efektywności. Zamiast tego proponuje opłatę za wynik (wzrost pozycji, leadów, konwersji), a gdy wynik nie jest w pełni kontrolowalny, stałą cenę za zdefiniowany deliverable, np. budowę strony czy mapę tematyczną. Tak powstaje usługa produktowa, której marża rośnie z każdym powtórzeniem, bo doskonali się system dostarczania.
„And especially if you do hourly billing, that just doesn’t work anymore, because clients are smart. They know you have AI.”
2. Agencje nie są już ograniczone mocą przerobową, lecz popytem, a sufit wyznacza churn.
Przy pięciu nowych klientach miesięcznie i 5-procentowym churnie agencja rośnie do ok. 100 klientów i staje, bo od tego momentu nowe umowy tylko zastępują odchodzących. Willow widział ten moment u wielu agencji, które „drukują pieniądze”, ale nie potrafią przebić pułapu. Wyjście to równoległa praca nad trzema dźwigniami: pozyskaniem, utrzymaniem i wzrostem LTV (wartości klienta w całym okresie współpracy), wbudowana w sam sposób dostarczania usługi.
„So if that’s true, then agencies are no longer delivery-constrained. They are demand-constrained. They need to get more clients and keep them for longer.”
3. Ręczna faktura to comiesięczna decyzja klienta, czy chce ci dalej płacić.
Prelegent wskazuje, że wysyłając fakturę ręcznie, agencja sama stawia klienta przed pytaniem o sens dalszej współpracy. Automatyczne obciążanie karty, nawet droższe w obsłudze, usuwa ten moment decyzji i jest podstawą MRR (miesięcznego powtarzalnego przychodu) w stylu SaaS (oprogramowania w modelu subskrypcyjnym). Zaleca też pobieranie opłaty z góry; argument, że nie zadziała to przy dużych klientach, zbywa stwierdzeniem, że dużym klientom nie sprzedaje się usług produktowych.
„if you’re sending manual invoices, then clients have to make a decision whether they want to pay you that month. But if we’re on automatic billing, even if it’s more expensive, then we eliminate the decision”
4. Pierwszy miesiąc sprzedany jako usługa jednorazowa przekonwertował 95 proc. klientów na subskrypcję.
Przykład agencji obsługującej profile Google Business: klienci nie chcieli od razu wiązać się abonamentem, więc agencja sprzedała im pierwszy miesiąc jako zamknięty projekt, a potem zaproponowała kontynuację. Willow zachęca, by w ten sam sposób zapożyczać z SaaS inne mechanizmy: plany roczne, modele kredytowe (klienci chętniej wydają kredyty niż pieniądze), opłaty wdrożeniowe, a nawet darmowy okres próbny traktowany jako koszt pozyskania klienta.
„So they sold their first month as a one-time service and ended up converting 95% of their clients into a subscription.”
5. Najpierw płatność, potem brief, bo opłacony klient odpowiada staranniej.
Wysłanie 20-stronicowego briefu przed podpisaniem umowy przytłacza klienta i skłania do ponownego przemyślenia decyzji. Po wpłacie klient jest zaangażowany w wynik i daje lepsze odpowiedzi. Willow dodaje dwie zasady: pytać tylko o to, co potrzebne teraz, oraz nie pytać o rzeczy, które AI wyciągnie samo (logo, dane marki) w pół minuty.
„If you’re charging up front, charge them first, then send them the brief, so that they’re bought into your vision, and they will give you higher quality answers.”
6. Automatyzuj tylko to, co umiesz zrobić ręcznie; prawdziwe automatyzacje biznesowe to zwykle proste if-else.
Najczęstszy błąd to próba zautomatyzowania procesu, którego agencja nie ma opanowanego manualnie. Willow radzi zacząć od przypomnień, zakładania zadań i wysyłki raportów, a dopiero potem rozszerzać. Efektowne scenariusze z LinkedIn traktuje z dystansem: przywołuje artykuł Stripe o autonomicznych agentach kodujących, pod którym pracownik firmy skomentował, że to raczej chwyt PR-owy niż działające rozwiązanie.
„The way I see most people go wrong with automation is they try to automate things that they cannot do manually either.”
7. Klient wrzuci twój raport do Claude’a i zapyta, czy jest dobry, więc wpisz uzasadnienie do raportu.
W raportach powinny znaleźć się dane źródłowe i tok rozumowania, choćby w formie przypisów nieprzeznaczonych dla ludzkiego czytelnika. Model, który ma skłonność do potakiwania, oceni wtedy raport przychylniej. Willow łączy to z obserwacją, że klient przed rezygnacją przegląda dawne deliverables, by uzasadnić decyzję, więc muszą być łatwo dostępne w dashboardzie, a nie w skrzynce Gmail.
„clients will take your reports. They’re going to feed them into Cloud, and they’re going to ask, is this any good? And if you have your background information, your reasoning inside your reporting, it could be a footnote even.”
8. Agencja z 10-krotnie wyższym przychodem nie ma 10-krotnie lepszych deliverables, tylko lepsze systemy.
Różnicę robi otoczka: obsługa klienta, oferta, samoobsługowe upgrade’y planu wyświetlane wtedy, gdy klient ogląda rosnące wyniki, oraz programy poleceń nagradzane kredytami lub dodatkowym deliverable zamiast prowizją, bo klienci agencji rzadko mają własną publiczność pasującą do ICP (profilu idealnego klienta). Celem jest ujemny churn przychodowy, czyli sytuacja, w której zeszłoroczna kohorta klientów płaci w tym roku więcej mimo odejść. Zysk z efektywności AI ma wracać do klienta nie przez niższą cenę, lecz przez więcej wartości za tę samą kwotę.
„if you look at these two agencies, one is doing 10 times more revenue. Are the deliverables 10 times better? Probably not. But everything around it is like their systems, how they handle the client, what they offer.”
Zdjęcia: Chris Willow
13 kadrów · Fot. Robert Nowaczyk
Tanya Kant: AI Literacy: What It Is and Why Your Workforce Needs It
11:40
Streszczenie
Tanya Kant przedstawiła AI literacy, czyli kompetencje potrzebne do świadomego korzystania z AI (Artificial Intelligence / sztucznej inteligencji), jako coś znacznie szerszego niż obsługa narzędzia.
Skupiła się na odpowiedzialności, ocenie wyników i rozpoznawaniu ryzyka. Zakwestionowała wystarczalność krótkich szkoleń od dostawców, wiarygodność detektorów oraz przedstawianie agentów jako pracowników. Pokazała też, jak generowane obrazy mogą powielać stereotypy i zastępować pomysł wizualny dosłownością. Unijne regulacje stanowiły kontekst dla rozmowy o kompetencjach i nadzorze człowieka.
Najważniejsze wnioski
Sprawna obsługa narzędzia nie oznacza rozumienia jego ograniczeń.
Stanowisko prelegentki: kompetencje obejmują również ocenę ryzyka, korzyści, konsekwencji etycznych i sytuacji, w których narzędzia nie należy używać. Samo wdrożenie nie dowodzi gotowości zespołu.Oszczędność na generowaniu treści nie przesądza o oszczędności całego procesu.
Ocena Kant: do kosztów trzeba doliczać weryfikację faktów, sensowności i ryzyka reputacyjnego oraz poprawianie wyników. Prelegentka podważyła automatyczne utożsamianie wykorzystania AI z oszczędnością czasu.Ani detektor, ani intuicja człowieka nie zapewniają bezstronnej oceny autorstwa.
Przywołane badania: Kant wskazała ograniczenia detektorów w rzeczywistych zastosowaniach oraz przykłady uprzedzeń rasowych i płciowych u osób oceniających, czy ktoś korzystał z AI.Stereotypy dotyczą nie tylko ilustracji, ale także założeń o odbiorcach.
Badania i interpretacja prelegentki: generowane obrazy i historie mogą utrwalać schematy dotyczące płci, wieku czy pochodzenia. Kant ostrzegła, że podobne ryzyko należy uwzględniać przy tworzeniu person i segmentacji odbiorców.Agent pozostaje narzędziem, nawet jeśli jest sprzedawany jako pracownik.
Argument prelegentki: nie ponosi odpowiedzialności prawnej i etycznej tak jak człowiek. Kant zwróciła też uwagę na zależność od dostawców. Możliwe podwyżki abonamentów i znikanie narzędzi przedstawiła jako ryzyka, nie pewne zdarzenia.Konsekwencje profilowania mogą ujawniać się z opóźnieniem.
Prognoza: nawiązując do wcześniejszych problemów z targetowaniem reklam dotyczących płodności i ciąży, Kant przewidywała możliwość wystąpienia podobnych szkód przy reklamach i profilowaniu w systemach konwersacyjnych.
Dane liczbowe i przykłady
- 20 minut: przykład krótkiego instruktażu od dostawcy, który Kant uznała za niewystarczający zamiennik przygotowania do odpowiedzialnej pracy z narzędziem.
- Cztery role marketingowe: w demonstracji generowanych ilustracji powracały podobne postacie, odwrócone notatniki i przedmioty opisane nazwą specjalizacji. Był to przykład pokazany na scenie, nie pomiar całej kategorii narzędzi.
- 2024 rok: Kant przywołała badanie Gillespiego dotyczące stereotypów w generowanych historiach. Jako przykład podała dominację par heteroseksualnych i cispłciowych w odpowiedziach na prośbę o napisanie historii miłosnej.
- 2017 i 2025 rok: zestawiła swoją wcześniejszą prelekcję o targetowaniu reklam z przywołanymi przez nią pozwami z 2025 roku dotyczącymi krzywdzących doświadczeń związanych z takim profilowaniem.
Praktyczne rady
Poniższe działania są wnioskami wdrożeniowymi z argumentów prelegentki:
- Doprecyzuj politykę korzystania z narzędzi: do jakich zadań służą, jakich danych nie wolno przekazywać, kto sprawdza wynik i kiedy należy zrezygnować z użycia.
- Rozliczaj cały proces: uwzględniaj czas generowania, poprawek, weryfikacji i zatwierdzania, a nie tylko przygotowania pierwszej wersji.
- Kontroluj założenia w personach: sprawdzaj, czy opis odbiorcy nie opiera się na stereotypach. Wygenerowana persona nie zastępuje wiedzy o klientach.
- Nie opieraj oceny autora wyłącznie na detektorze: oddziel pytanie o sposób powstania treści od oceny jej rzetelności i przydatności.
- Oceniaj grafikę szerzej niż przez brak błędów: sprawdzaj pomysł, czytelność przekazu, sposób przedstawienia ludzi i zasadność użycia fotorealizmu.
Knowledge bombs
1. Reklamy w ChatGPT powtórzą problem targetowania sprzed dekady, tylko z opóźnieniem.
Kant (Associate Professor na University of Sussex, etyczka technologii) przypomina kampanie testów ciążowych Clearblue kierowane do kobiet na YouTube około 2017 r. Dopiero po około 10 latach uznano to za szkodę psychologiczną, a w 2025 r. poszkodowane kobiety pozwały Meta. Jej zdaniem profilowanie i reklamy w ChatGPT uruchomią ten sam cykl: najpierw entuzjazm, potem długo odroczony rachunek etyczny i prawny.
„And I think in some ways we’re going to see some of the same issues with the rise of advertising in chat GPT and profiling.”
2. Od sierpnia 2026 r. AI Act wymaga od firm rozwijania AI literacy w zespołach, a efekt brukselski rozciąga to poza UE.
Prelegentka wskazuje, że kluczowe punkty egzekucji unijnego AI Act już obowiązują, w tym obowiązek wspierania kompetencji AI u pracowników. Argument „to UE, nas w Wielkiej Brytanii nie dotyczy” odrzuca: regulacje unijne historycznie kształtują praktykę globalną i są traktowane jako złoty standard. Dla agencji i działów marketingu oznacza to, że szkolenie z AI staje się wymogiem zgodności, nie dodatkiem.
„So since August 2026, the EU AI Act stipulates that providers and developers of AI systems should take measures to support the development of AI literacy in their workforces.”
3. Polityka „używaj jednego narzędzia odpowiedzialnie” i 20-minutowy film od dostawcy to nie jest AI literacy.
Typowa firmowa polityka wskazuje jedno zatwierdzone narzędzie i każe używać go odpowiedzialnie, nie definiując, co to znaczy. Szkolenie to zwykle materiał producenta, który nigdy nie powie, kiedy narzędzia nie używać. Według AI Act kompetencja AI obejmuje rozumienie, czym AI jest i jak działa, świadomość ryzyk, korzyści i kwestii etycznych oraz zdolność do nadzoru człowieka. Kant podkreśla, że biegłość techniczna nie oznacza rozumienia: adopcja nie równa się zrozumieniu.
„These kind of tools, training aids that are developed by the developer are never going to tell you not to use these tools in a broader sense.”
4. Kupując narzędzie „z AI”, pytaj sprzedawcę: które AI.
Termin obejmuje bardzo różne technologie: systemy adaptacyjne, samouczące i generatywne. Wiele rozwiązań sprzedawanych dziś jako AI to uczenie maszynowe znane z epoki big data sprzed 10 lat. Konkretne nazwanie technologii poprawia przejrzystość i pozwala ocenić, co narzędzie naprawdę robi.
„If somebody is selling you an AI tool, I really want you to ask them, which AI?”
5. Detektory AI nie działają w praktyce, a ludzkie „na oko” jest obciążone uprzedzeniami.
Detektory z ostatnich dwóch lat opierają się na wnioskowaniu probabilistycznym, tak jak same modele językowe, i w realnych warunkach zawodzą. Ocena ludzka nie jest lepsza: badanie w USA wykazało, że nauczyciele częściej oskarżają czarnoskórych uczniów o użycie AI, a w innym badaniu ten sam kod oceniony jako napisany przez kobietę częściej uznawano za wygenerowany. Kant zapowiada znaki wodne wprowadzane na mocy art. 50 AI Act jako formę wykrywania nieopartą na prawdopodobieństwie.
„I would put AI detectors in because the ones that we’ve seen in the last two years have tended to work on probabilistic inference. […] However, research is showing that when used in real-world contexts, they don’t work very well.”
6. Obrazy z AI zdradza nie halucynacja, lecz „kapitan oczywistość” w projekcie.
Kant wygenerowała w Copilocie (narzędziu zatwierdzonym przez jej uczelnię) portrety specjalisty GEO (Generative Engine Optimization, optymalizacji pod odpowiedzi generatywne), SEO, marketera i analityka social media: te same twarze, kubki z napisem o ulubionej dziedzinie, notatki pisane do góry nogami. Błędów ortograficznych już prawie nie ma; rozpoznawalny jest nadmiar dosłownych sygnałów tam, gdzie projektant użyłby abstrakcji i konotacji. Zaleca styl ilustracyjny zamiast fotorealizmu, także dlatego, że AI Act nakaże oznaczać hiperrealistyczne wizerunki jako deepfake.
„But I would say that one of the telltale signs that an AI has generated in an image is that they are the captain obvious of design. They have to fill the page with signifiers about the thing that the user has prompted them to do.”
7. Stereotypy z danych treningowych trafiają do person i segmentacji odbiorców, nie tylko do obrazków.
Badania (m.in. Gillespie, 2024) pokazują, że AI powiela normy płci, rasy i wieku w obrazach i narracjach; poproszona o historię miłosną, prawie zawsze opisze parę heteroseksualną. Kant odrzuca odpowiedź „dopisz do promptu różnorodność”: od Hollywood i wydawców oczekujemy więcej, więc od systemów AI też, a użytkownik bez kompetencji medialnych nie wie, że powinien o to prosić. Dla marketera wniosek jest praktyczny: persony i segmenty budowane z AI wymagają sprawdzenia pod kątem wbudowanych uprzedzeń.
„This happens not just in storytelling and image telling. It is a problem for persona building and audience segmentation as well. You’re going to see stereotypes built into some of the training data that are used to create those things as well.”
8. Agenci AI to narzędzia, nie pracownicy, a oszczędność na produkcji treści przenosi koszt na weryfikację.
Nawet stażysta po studiach odpowiada prawnie za swoje działania, agent AI nie, więc mówienie o „pracownikach AI” nie ma sensu prawnego. Agenci powstają w niestabilnych łańcuchach dostaw i mogą zniknąć w pół roku, a subskrypcje drożeją nieprzewidywalnie. Taniej wytworzona treść wymaga więcej budżetu na sprawdzanie faktów, sensu i reputacji oraz na przekonywanie narzędzia, by zrobiło to, o co proszono. Kant nie jest przekonana, że AI oszczędza czas: z całej konferencji słyszy raczej o śledzeniu wielu źródeł i platform, czyli o rosnącym obciążeniu pracą. Dodaje apel do szefów o zatrudnianie absolwentów, bo stanowiska juniorskie to pipeline eksperckiej wiedzy.
„I would kind of consistently remind your boss, especially, that they are tools and not workers. Why? They are not ethically and legally accountable for their actions in a way that a human is.”
Zdjęcia: Tanya Kant
9 kadrów · Fot. Robert Nowaczyk
Vishal Mahida: Selling GEO: What Clients Actually Want and How to Close the Deal
12:00
Streszczenie
Podczas „Selling GEO” na brightonSEO Vishal Mahida przedstawił model sprzedaży GEO (Generative Engine Optimization / optymalizacja widoczności w wyszukiwarkach generatywnych) oparty na trzech krokach: Gap, Evidence, Offer, czyli luka, dowody i oferta.
Przekonywał, że klienta nie interesuje nazwa usługi. Interesuje go, dlaczego AI (Artificial Intelligence / sztuczna inteligencja) pomija jego firmę, błędnie ją opisuje lub rekomenduje konkurencję. Zadaniem agencji SEO (Search Engine Optimization / optymalizacja pod kątem wyszukiwarek) jest rozpoznać ten problem, pokazać konkretne przykłady i zaproponować dopasowany zakres prac.
Najważniejsze wnioski
Sprzedaż powinna zaczynać się od problemu biznesowego.
Mahida przeciwstawił ogólną obietnicę poprawy widoczności sytuacji, w której agencja pokazuje, jak brak rekomendacji może wpływać na wybór dostawców przez klientów. Była to główna teza sprzedażowa wystąpienia.Audyt powinien odwzorowywać pytania kupujących, a nie maksymalizować liczbę promptów.
Prelegent zalecił uwzględnienie etapu lejka, intencji, potrzeb klienta, lokalizacji oraz kontekstu marki i konkurencji. Celem miało być rozpoznanie popytu, nie samo zbieranie odpowiedzi.Pod nazwą GEO kryją się różne problemy wymagające różnych usług.
W przedstawionym modelu były to: odnalezienie firmy, wykorzystanie jej treści, poprawne przedstawienie informacji i rekomendacja na tle konkurencji. Mahida proponował dopasowywanie oferty do zdiagnozowanego problemu zamiast automatycznej sprzedaży pakietu.Dobór źródeł powinien zależeć od rodzaju biznesu.
Dla usług lokalnych prelegent wskazał stronę, profile lokalne, opinie i lokalne publikacje. Dla firm sprzedających innym firmom: publikacje branżowe, treści eksperckie i wzmianki w zewnętrznych źródłach. Dla marek konsumenckich zwrócił uwagę na stronę i informacje produktowe.Raport powinien łączyć widoczność z ruchem i efektami biznesowymi.
Mahida zaproponował trzy pytania: czy firma staje się bardziej widoczna, czy AI kieruje do niej użytkowników i czy biznes na tym korzysta. W komunikacji z klientem wskazał m.in. telefony i wysłane formularze.Stała obsługa wymaga uzasadnienia, a rekomendacji nie można zagwarantować.
Prelegent uzasadniał cykliczną współpracę działaniami konkurencji, zmianami modeli i potrzebą ponownej oceny widoczności. Podkreślił możliwość zwiększania prawdopodobieństwa rekomendacji, nie pewność jej uzyskania.
Dane liczbowe i przykłady
| Liczba | Kontekst |
|---|---|
| 400 agencji | Skala współpracy zadeklarowana przez prelegenta. |
| Ponad 300 agencji | Liczba uczestników ankiety podana przez Mahidę. |
| 6 z 10 promptów komercyjnych | Ilustracyjny przykład komunikatu sprzedażowego: konkurencja pojawia się w odpowiedziach, a analizowana firma jest nieobecna. Nie był to przedstawiony wynik badania. |
| 1 klient i 3 prompty komercyjne | Proponowany punkt wyjścia do szybkiego audytu sprzedażowego. |
| 90 dni | Format programu, który według obserwacji prelegenta sprawdzał się w sprzedaży agencyjnej. |
| 30 dni i 50 potencjalnych klientów | Horyzont planu uruchomienia sprzedaży oraz wielkość listy firm do kontaktu w drugim tygodniu. |
| Co miesiąc | Zalecana ponowna ocena widoczności w ramach stałej obsługi. |
Praktyczne rady
- Najpierw ustal, o co pytają kupujący. Dopasuj pytania do kategorii, potrzeb, lokalizacji i etapu wyboru dostawcy.
- Zapisuj konkretny problem: brak wzmianki, błędny opis albo rekomendowanie konkurencji.
- Przekładaj diagnozę na zakres prac. Nie zaczynaj od liczby godzin ani identycznych pakietów dla wszystkich.
- Dobieraj źródła do rynku klienta. Firma lokalna i dostawca usług dla przedsiębiorstw nie potrzebują takiej samej argumentacji ani identycznego planu.
- Ustal stan wyjściowy przed rozpoczęciem działań. Późniejsze raportowanie oprzyj na zmianach widoczności, ruchu i kontaktach biznesowych, nie wyłącznie na liczbie wykonanych zadań.
Knowledge bombs
1. Nikt nie chce kupić GEO; klient chce wiedzieć, dlaczego ChatGPT poleca konkurencję.
Mahida, który sprzedaje usługi GEO (Generative Engine Optimization, optymalizacja pod odpowiedzi AI) przez sieć ok. 400 agencji, twierdzi, że sam skrót GEO nic klientowi nie mówi. Pytania, które naprawdę padają, brzmią: jak wejść do ChatGPT, dlaczego AI rekomenduje konkurenta, jak poprawić to, co AI mówi o nas błędnie. Agencja, która mówi technicznym żargonem, sprzedaje mgliste oczekiwania, dlatego cały jego framework sprzedażowy (Gap, Evidence, Offer) zaczyna się od języka klienta, nie od taktyk.
„GEO, like nobody wants GEO, like I know you guys are like agency owners and you want to try selling GEO, but believe me, nobody wants GEO.”
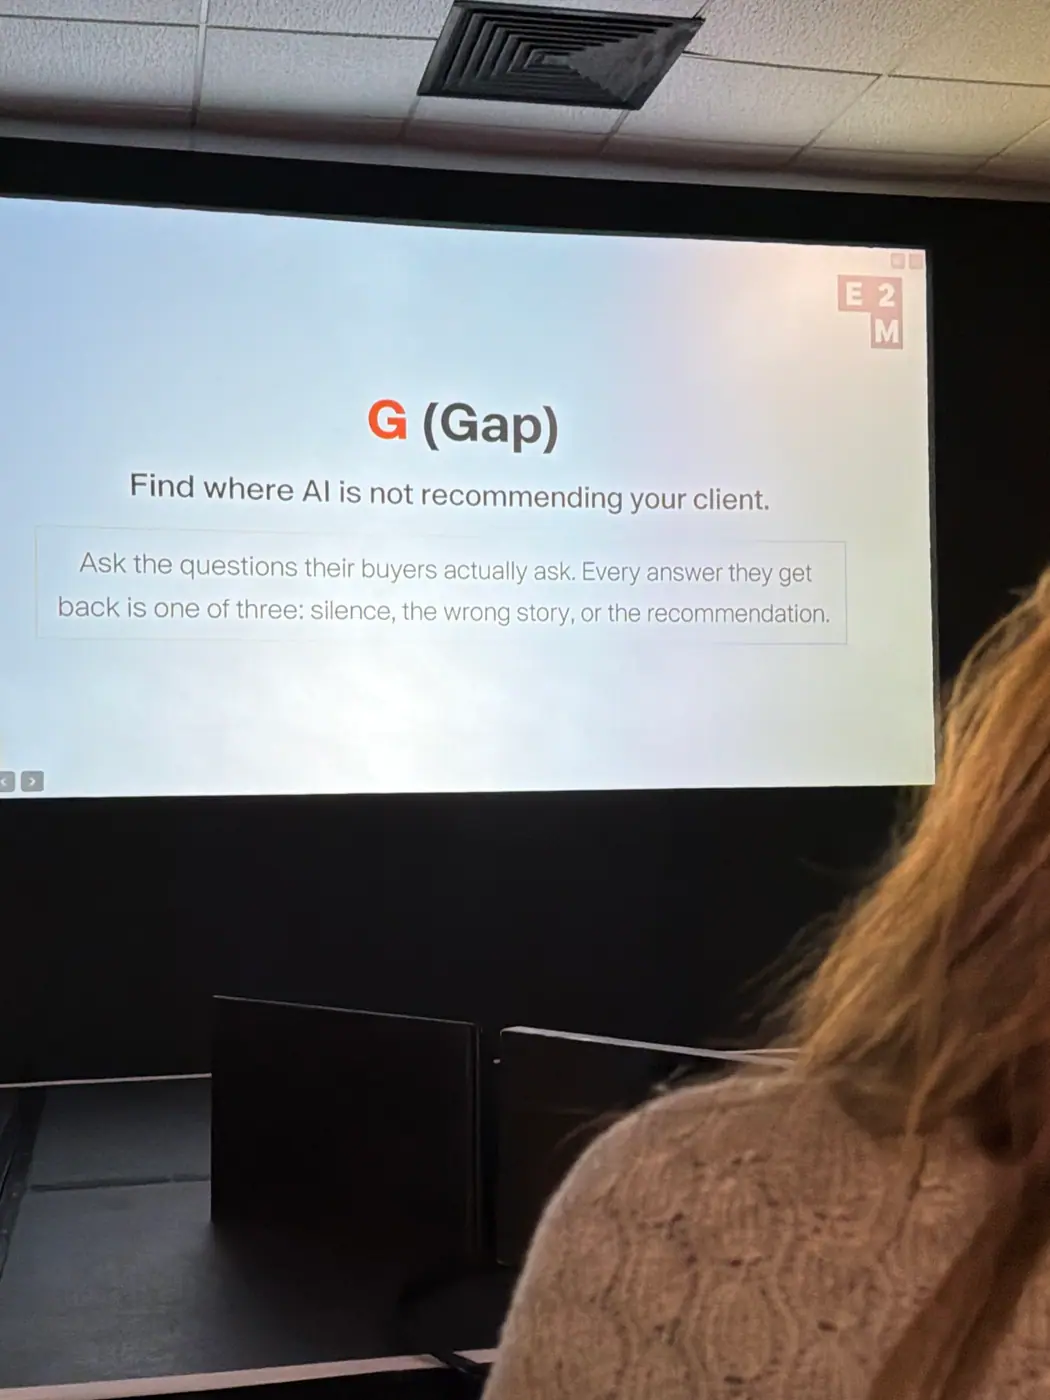
2. Analiza luki kończy się zawsze jedną z trzech diagnoz: cisza, zła historia albo rekomendacja konkurenta.
Zamiast wpisać w ChatGPT „najlepsza restauracja” i zrobić zrzut ekranu, Mahida każe zbudować listę promptów według etapu lejka, intencji, potrzeb klienta, lokalizacji i kontekstu konkurencyjnego. Każdy prompt daje jedną z trzech odpowiedzi: marki nie ma w ogóle, marka jest, ale AI mówi o niej nieprawdę, albo AI wskazuje kogoś innego jako pierwszy wybór. Ta trójka jest pierwszym argumentem sprzedażowym, bo celem nie jest śledzenie większej liczby promptów, tylko pokazanie, gdzie ucieka popyt.
„Every gap will give you three answers, right? One is going to be silence, not mentioned at all. The wrong story, they are mentioned, but it’s completely wrong. And the recommendation, like who AI named as a top choice.”
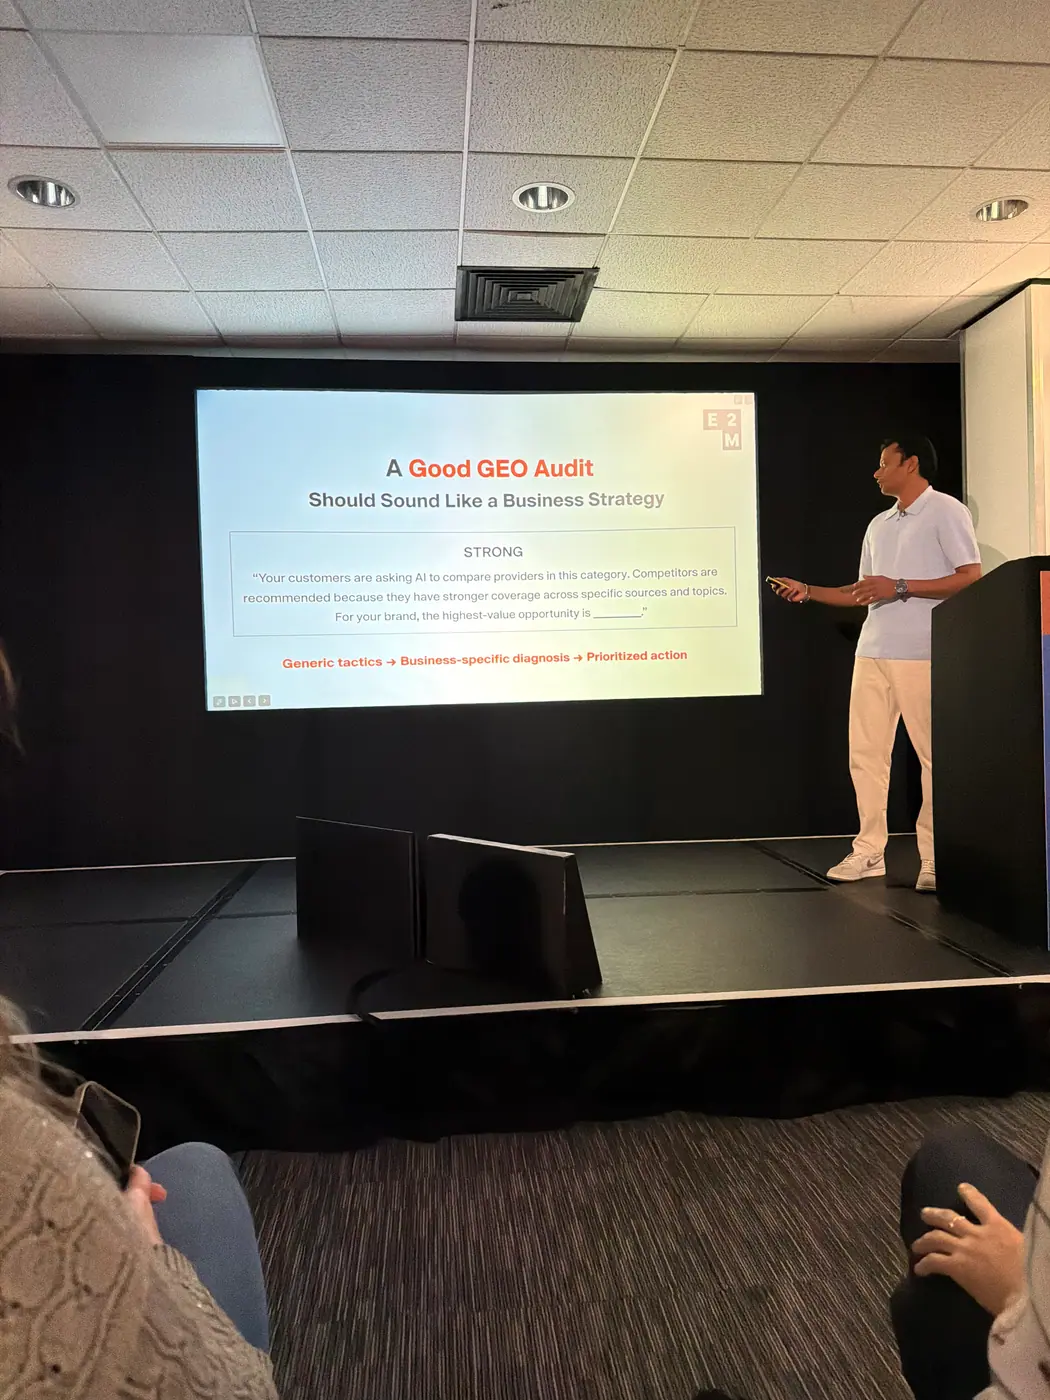
3. Ten sam wynik audytu da się powiedzieć na trzy sposoby i tylko wersja biznesowa sprzedaje.
Mahida rozróżnia komunikat techniczny („oferujemy usługi GEO poprawiające widoczność w AI”), oparty na dowodach („konkurenci pojawiają się w 6 z 10 promptów zakupowych, w których was nie ma”) i biznesowy („znaleźliśmy lukę, która wpływa na to, jak klienci tworzą krótką listę dostawców”). Dobry audyt GEO brzmi jak strategia biznesowa; słaby brzmi jak „potrzebujecie więcej wzmianek na Reddicie i więcej cytowań”.
„Evidence led is like your competitors appear six out of 10 commercial prompts where you are absent and the business led is we found visibility gap that could affect how customer shortlist providers.”
4. GEO to nie jedna usługa, tylko cztery różne problemy z czterema różnymi produktami.
Discovery (AI nie potrafi znaleźć firmy) sprzedaje się jako audyt odkrywalności; retrieval (AI nie korzysta z treści klienta) jako optymalizację treści i encji; synthesis (AI mówi o firmie nieprawdę) jako budowę autorytetu faktograficznego; presentation (AI poleca konkurenta) jako pełny program widoczności. Zamiast pakietów „basic, pro, enterprise” Mahida radzi najpierw zdiagnozować, który z czterech problemów ma klient, i sprzedać rozwiązanie właśnie jego.
„So geo, it’s not one service, it’s like four problems. The first is discovery, AI cannot find them, right? And what you sell is a discovery audit, retrieval, AI doesn’t use our content, like content and entity optimization, synthesis, when AI gets us wrong, entity and factual authority and presentation is like AI recommended competitive […]”
5. Źródła, które trzeba poprawić, zależą od typu klienta, więc jeden uniwersalny pitch nie działa.
Dla usług lokalnych liczą się strona, profile lokalne, opinie i lokalne media; dla B2B (sprzedaż firmom) publikacje branżowe, treści eksperckie i odniesienia u stron trzecich; dla marek konsumenckich dane produktowe na stronie. Mahida nakazuje najpierw ustalić, z kim się rozmawia, a dopiero potem budować ofertę, bo zestaw źródeł, które AI bierze pod uwagę, jest inny w każdej z tych grup.
„For example, let’s say if you are talking to a local services, then you need to think about the website, local profiles, relevant reviews, local publication. If you are talking to a B2B company, you need to think about like industry publication, expert content, third party references […]”
6. Klient nie płaci za GEO, tylko za zamknięcie konkretnej luki, a odnawia umowę, bo konkurenci się ruszają.
Z ankiety wśród ponad 300 z 400 agencji, z którymi pracuje Mahida, wynika, że najlepiej sprzedają się: audyt widoczności w AI, 90-dniowy program i stały program wzrostu, często jako dodatek do SEO albo usługa sproduktyzowana. Argument retencyjny jest prosty: raz zdobytą obecność w odpowiedziach AI trzeba bronić i co miesiąc mierzyć od nowa, bo konkurencja robi to samo. Raport dla klienta ma odpowiadać na trzy pytania: czy jesteśmy bardziej widoczni, czy AI przysyła ludzi (telefony, formularze), czy biznes na tym zarabia.
„Now, why it renews? Because the competitors keep moving, right? The coverage has to be defended.”
7. Nikt nie może zagwarantować rekomendacji w AI, a różnica wobec SEO polega na tym, że to retrieval, nie ranking.
Na pytanie „czy gwarantujecie, że AI nas poleci” Mahida odpowiada uczciwie: nikt nie może, ale da się podnieść prawdopodobieństwo. Na „a jeśli model zmieni się w przyszłym miesiącu” odpowiada, że właśnie dlatego to abonament, nie jednorazowa usługa. Na „czy to nie jest po prostu SEO” odpowiada, że AI pobiera i składa informacje ze źródeł zewnętrznych, więc praca toczy się na innych poziomach i w innych miejscach niż walka o pozycję w Google.
„No, because it’s a retrieval and third-party consignment, not ranking. So it’s a different levels and different work.”
8. Plan na 30 dni: w drugim tygodniu 50 potencjalnych klientów dostaje spersonalizowany mini-audyt.
Mahida podaje konkretny harmonogram wdrożenia GEO w agencji: tydzień pierwszy to przykładowy audyt, audyt wewnętrzny i jedna strona z cennikiem; tydzień drugi to lista 50 prospektów, mini-audyt dla każdego i wysyłka spersonalizowanych e-maili; dalej wewnętrzne SOP (standardowe procedury) i budowa pipeline’u. Szybki audyt sprzedażowy to jeden klient, trzy prompty zakupowe, zapis luki i diagnoza, co faktycznie trzeba sprzedać.
„The second week you are like listing 50 prospect, running the mini audit for them, like sending these mini audits, personalized emails.”
Zdjęcia: Vishal Mahida
5 kadrów · Fot. Robert Nowaczyk
Eilish Hughes: We Didn’t Build a GEO Team
12:20
Streszczenie
Eilish Hughes przedstawiła, jak w uSwitch rozwijano GEO (Generative Engine Optimization / optymalizację widoczności w wyszukiwarkach generatywnych) bez zatrudniania osobnego zespołu, konsultanta ani agencji zajmującej się tym obszarem.
Zamiast tworzyć nową strukturę, firma połączyła działania SEO (Search Engine Optimization / optymalizacji pod wyszukiwarki), treści, PR (Public Relations / relacji z otoczeniem), marki, mediów społecznościowych i wideo. Podstawą współpracy były wspólne cele, dane z różnych kanałów oraz ważne dla biznesu momenty.
Sednem wystąpienia nie była recepta na cytowania w odpowiedziach generatywnych, lecz sposób organizacji pracy, który pozwalał wspólnie eksperymentować i mierzyć efekty.
Najważniejsze wnioski
Teza prelegentki: GEO było przede wszystkim wyzwaniem organizacyjnym.
Zespół SEO nie kontrolował wszystkich zasobów i budżetów potrzebnych do budowania widoczności poza własną stroną. Przypisanie mu odpowiedzialności za wynik nie rozwiązywało tego problemu.Obserwacja z wdrożenia: gotowy plan SEO nie wystarczył do zaangażowania innych zespołów.
Hughes przygotowała słowa kluczowe, plan treści i wybrane możliwości obecności w odpowiedziach generatywnych. Pozostałe działy nie widziały jednak powodu, by realizować cudze cele. Punktem zwrotnym było uzgodnienie wspólnego celu oraz uruchomienie comiesięcznych spotkań liderów kanałów.Stanowisko prelegentki: treść na stronie nadal miała znaczenie, ale nie wyczerpywała tematu.
Hughes wskazywała również na wzmianki na YouTube, wzmianki o marce w internecie i wyszukiwania brandowe. W jej ocenie backlinki stanowiły tylko część sygnałów powiązanych z obecnością w odpowiedziach AI (Artificial Intelligence / sztucznej inteligencji).Hipoteza zespołu: szeroka obecność marki mogła wspierać cytowania.
Prelegentka wiązała wysoki poziom cytowań, obserwowany w wewnętrznym monitoringu, z siłą marki i skoordynowanymi działaniami wielu kanałów. Przedstawiła to jako interpretację zespołu, a nie potwierdzony związek przyczynowy.Prognoza i rekomendacja: pomiar GEO miał nadal ewoluować.
Hughes przekonywała, że nie należało zastępować dotychczasowych wskaźników jednym wynikiem widoczności generatywnej. Pozycje, ruch organiczny i przychód pozostawały ważne, a dodatkowe wskaźniki miały pokazywać postęp poszczególnych zespołów.
Dane liczbowe i przykłady
58% spadku CTR (Click-Through Rate / współczynnika klikalności) pierwszej pozycji w związku z obecnością AI Overviews, czyli automatycznych podsumowań w wyszukiwarce. Hughes przywołała tę liczbę z badania Ahrefs jako przykład danych wywołujących presję na zmianę działań marketingowych.
Pierwsza pozycja w dniu ogłoszenia limitu cen energii. Według prelegentki zespół osiągnął taki wynik przy tym wydarzeniu po raz pierwszy. Hughes poinformowała również o obecności w AI Overviews.
470 cytowań eksperta zajmującego się internetem szerokopasmowym, monitorowanych w Meltwater. Prelegentka podała tę liczbę w kontekście medialnej obecności eksperta i zainteresowania dziennikarzy, nie jako wynik cytowań w odpowiedziach AI.
Praktyczne rady
Wybierz wspólny moment biznesowy.
Oceń go przez trzy kryteria: znaczenie dla odbiorców, dopasowanie do marki i potencjał komercyjny. Uzgodnij zasoby, uwzględniając już zatwierdzone zobowiązania innych zespołów.Zbuduj bazę pytań z danych całego marketingu.
Połącz dane SEO z badaniami odbiorców, pytaniami dziennikarzy, komentarzami w mediach społecznościowych i wiedzą o skojarzeniach z marką. Do rozpoczęcia pracy wystarczy wspólny arkusz.Grupuj pytania, a następnie dobieraj formaty.
AI może pomóc usuwać duplikaty i porządkować tematy. Weryfikację trafności oraz wybór formatu i kanału pozostaw specjalistom, uwzględniającym także to, co pojawia się w wynikach wyszukiwania.Połącz plany kanałów w jeden plan dystrybucji.
Powinno być jasne, co powstaje, kto odpowiada za materiał, gdzie i kiedy zostanie opublikowany oraz na jaką potrzebę odbiorcy odpowiada. Wykorzystaj wiedzę redaktorów i ekspertów, których firma już zatrudnia.Dodawaj nowe wskaźniki do istniejącego pomiaru.
Zachowaj dotychczasowe KPI (Key Performance Indicators / kluczowe wskaźniki efektywności), a obok nich obserwuj cytowania i bieżące efekty działań poszczególnych kanałów. Regularnie omawiaj, co warto powtórzyć, zmienić lub ograniczyć.
Knowledge bombs
1. uSwitch nie zatrudnił zespołu GEO, bo GEO to problem struktury organizacji, nie kolejnej specjalizacji.
Hughes, content lead w uSwitch (brytyjska porównywarka energii, internetu i finansów), nie zatrudniła ani zespołu, ani konsultanta, ani agencji od GEO (Generative Engine Optimization, optymalizacji pod odpowiedzi AI). Zamiast tego zmieniła sposób, w jaki istniejące zespoły marketingu pracują ze sobą. Jej teza: podział na SEO, PR, brand, social i wideo był sensowny, dopóki każdy zespół odpowiadał za własny kanał; AI nagradza sygnały rozproszone po wszystkich tych kanałach naraz.
„When I’m talking about structure, I mean business structure, like team structure, marketing org-level structure.”
2. Najsilniejsze sygnały GEO leżą poza budżetem i mandatem zespołu SEO.
Z obserwacji uSwitch wynika, że obok treści najmocniej na obecność w odpowiedziach AI wpływają sygnały off-site: wzmianki na YouTube, brandowe wzmianki w sieci i wolumen wyszukiwań brandowych. Linki zwrotne korelują z wzmiankami AI, ale są znacznie mniejszym kawałkiem tortu. Wniosek organizacyjny: nie da się dać zespołowi SEO celu „widoczność w AI”, jeśli zasoby wideo, PR i brandu kontroluje ktoś inny.
„But these off-site signals are becoming so important, like YouTube mentions, branded web mentions, branded search volume. Backlinks do correlate with AI mentions, but they’re a much smaller part of the pie.”
3. Gotowy plan contentowy przyniesiony do innych zespołów przepadł; zadziałało dopiero przyznanie się do niepewności.
Hughes zrobiła research, plan treści, listę fraz i AI Overviews (podsumowań AI w Google) do zdobycia, po czym usłyszała od innych liderów: dlaczego mój zespół ma pracować na twoje cele SEO. Zmieniła podejście na odgórne: wspólne spotkanie „Organic Visibility Monthly” dla liderów SEO, contentu, PR, brandu, social i digital PR, na którym razem z liderem SEO przedstawiła szansę i zagrożenie GEO i otwarcie powiedziała, że nie wie, czy to zadziała. Ta otwartość sprawiła, że pozostali też przyznali, że nie wiedzą, co robić, i stąd wzięła się zgoda na wspólny eksperyment.
„importantly we said we’re not sure this is actually going to work but we need to have a go because with all of this external data we’re still not going to know the truth for our brand until we do ourselves.”
4. Testuj GEO na jednym „momencie” wybranym według trzech kryteriów: audytorium, marka, pieniądze.
Zamiast ciągłego planu contentowego uSwitch wybrał jeden punkt kulminacyjny, w którym wszystkie kanały miały zagrać naraz. Festiwale odpadły, bo są dobre dla social i PR, ale nie dla SEO i nie dają szybkiego zwrotu. Wybór padł na sierpniowy limit cen energii (price cap): ogromny wolumen wyszukiwań, temat w pełni na marce i kluczowy moment zmiany dostawcy, z której firma zarabia. Warunkiem był też realizm: czas brandu i PR nie mógł być zabrany z już zatwierdzonej kampanii telewizyjnej za milion funtów.
„So we filtered moments on these values, audience, brand and commercial. So something we wouldn’t have done this sandbox in is festivals. So festivals are like a good moment for social and PR but not so much for SEO.”
5. Zamiast keyword researchu buduj bazę pytań z danych wszystkich zespołów: ankiet PR, zapytań dziennikarzy i komentarzy z Facebooka.
Fundamentem jest wspólna baza (u Hughes Notion, ale może być arkusz, Asana czy Trello), do której wpadają dane z Search Console, Ahrefs i SEOmonitor, pytania People Also Ask, fan-out (podpytania generowane przez AI), social listening, dane z ankiet PR, e-maile od dziennikarzy i komentarze użytkowników. AI grupuje to w klastry zapytań (np. „jak zmienić dostawcę”, „jak oszczędzić”), z których powstają zasoby, a na końcu lista promptów i fraz do śledzenia. Efekt uboczny: każdy zespół widzi w planie własne dane, więc czuje się współautorem.
„Social and video. Actual people commenting on Facebook. Like Facebook comments. Absolute gold.”
6. Wszystkie kanały naraz dały pierwszą pozycję w dniu ogłoszenia price cap, czego wcześniej nigdy nie było.
Podczas price cap redaktor ds. energii występował w BBC Breakfast, PR rozesłał temat do gazet, SEO prowadził strategię newsową, do tego aktualizowany poradnik i social. Skutek: bardzo wysokie pokrycie brandowe, pierwsza pozycja w Google w dniu ogłoszenia i AI Overview z cytowaniem. Hughes przypisuje tej skoordynowanej sile marki wysoki wskaźnik cytowań w ich wewnętrznym śledzeniu, ale podkreśla, że każdy element planu musi mieć własne mikro-KPI, bo zespoły potrzebują dowodu, że coś działa, zanim GEO da się zmierzyć wprost.
„And we’re in P1 on announcement day that had never happened before.”
7. Nie potrzebujesz zespołu GEO, bo redaktorzy i producenci już niosą sygnały zaufania, których szuka AI.
Hughes wskazuje, że eksperci w firmie są gotowym nośnikiem wiarygodności: redaktor ds. internetu Max ma według Meltwater 470 cytowań i jest najczęściej cytowanym ekspertem od szerokopasmowego internetu, o którego proszą dziennikarze. Zamiast kupować zewnętrzną usługę, uSwitch systematycznie wystawia własnych ludzi w telewizji, prasie i wideo, włącznie z szefem i samą prelegentką.
„your team already know absolutely everything. They are the experts. If you’ve got editors, if you’ve got writers, if you’ve got producers, they already carry all those trust signals.”
8. Nie goń jednej liczby GEO; dokładaj warstwy do istniejących KPI, bo pomiar AI będzie się zmieniał.
uSwitch nadal śledzi pozycje w Search Console, ruch organiczny i przychód jako miary nadrzędne i dopiero na to nakłada śledzenie cytowań. Blueprint Hughes: fundament (ludzie i priorytety), pytania zamiast samych fraz, mapowanie z pomocą AI, ale z decyzją ludzi o kanale i przekazie, iteracja na podstawie feedbacku i pomiar oparty na czymś stabilniejszym niż zmienne metryki GEO. Pytania na poniedziałek: kto jest właścicielem kalendarza momentów, czy zespoły dzielą się danymi i czy plany treści powstają z pytań, a nie tylko z eksportu z SEMrush.
„Don’t just chase a GEO number, like make sure that every team knows what they’re doing is going to matter in the short term.”
Zdjęcia: Eilish Hughes
5 kadrów · Fot. Robert Nowaczyk
Michael Holloway: Stop Teaching Juniors to Audit Like Robots
14:00
Streszczenie
Michael Holloway przedstawił audyt SEO (Search Engine Optimization / optymalizacja pod wyszukiwarki) jako narzędzie diagnozowania problemów klienta i rozwijania kompetencji juniorów, a nie generowania list błędów.
Zaproponował model oparty na trzech pytaniach: gdzie jest problem, dlaczego występuje i co należy zrobić dalej. Na przykładach pokazał, że priorytet nadany przez narzędzie może rozmijać się ze znaczeniem problemu. Automatyzacja i AI (Artificial Intelligence / sztuczna inteligencja) miały w jego podejściu odciążać zespół od pracy z arkuszami, pozostawiając więcej czasu na analizę i naukę.
Najważniejsze wnioski
- Główna teza prelegenta: sposób uczenia audytowania kształtuje sposób myślenia juniorów o całym SEO. Eksportowanie błędów nie rozwija tych samych kompetencji co diagnozowanie ich przyczyn.
- Wniosek z przedstawionych przypadków: komunikat narzędzia jest punktem wyjścia do analizy. Może wskazywać nieistniejący problem albo pozornie drobną usterkę będącą objawem większego błędu.
- Rekomendacja dotycząca priorytetów: znaczenie problemu należy oceniać w kontekście pytania klienta. Spadek ruchu wymaga innego podejścia niż ogólny przegląd kondycji serwisu.
- Rekomendacja dotycząca formy audytu: zarząd potrzebuje statusu i obrazu sytuacji, zespół zarządzający serwisem konkretnych zadań, a programiści szczegółów technicznych.
- Opinia dotycząca rozwoju zespołu: automatyzacja nie powinna zastępować szkolenia juniorów. Holloway podkreślił znaczenie cierpliwości, dostępu do bardziej doświadczonych osób i wspólnego szukania przyczyn.
Dane liczbowe i przykłady
- 99,93% stron w jednym z opisanych serwisów miało zgłoszony brak nagłówków drugiego poziomu. Analiza ujawniła, że treść od nagłówka głównego w dół była renderowana po stronie przeglądarki.
- 90% zawartości eksportu było niezrozumiałe dla klienta według relacji przytoczonej przez prelegenta. Klient nie otrzymał priorytetów ani planu działania i nie wdrożył zaleceń.
- Około pięciu lat doświadczenia i setki audytów stanowiły deklarowane przez Hollowaya zaplecze przedstawionych obserwacji.
- Dwa–trzy lata to horyzont, w którym, według wizji prelegenta, dzisiejsi juniorzy mogli przechodzić do ról zarządczych. Był to argument za rozwijaniem przyszłej kadry, a nie pomiar tempa awansów.
Praktyczne rady
- Przekazuj juniorowi problem klienta i oczekiwany rezultat, nie tylko zadanie wykonania audytu.
- Weryfikuj istnienie problemu, jego zasięg i przyczynę przed przygotowaniem rekomendacji.
- Przy złożonych problemach technicznych analizuj przyczynę wspólnie z programistą, zamiast przekazywać ogólne zalecenia z narzędzia.
- Automatyzuj uzupełnianie pól, przygotowywanie arkuszy i eksportów. Zaoszczędzony czas przeznaczaj na diagnozę i szkolenie.
- Dołączaj kolejność działań oraz instrukcje dopasowane do odbiorców. Etykiety „wysoki”, „średni” i „niski” nie zastępują planu wdrożenia.
Knowledge bombs
1. Jeśli audyt może zrobić robot, klient kupi licencję Screaming Frog i Claude i zwolni agencję.
Eksport listy błędów z crawlera, lista pass/fail albo checklista bez priorytetów to praca, którą klient może wykonać sam. Holloway pokazuje realny przykład: klient dostał od poprzedniej agencji goły eksport, nie zrozumiał 90 procent, nie miał roadmapy i nie zrobił z nim nic. Audyt, który nie zawiera diagnozy i planu działania, nie dodaje wartości i uczy juniora, że audyty są szybkie, łatwe i „niczyje".
„And if a robot can do it, then your client can just get a Screaming Frog license, a Claude license, and fire you.”
2. Zastępowanie juniorów sztuczną inteligencją to sposób, w jaki branża SEO może zabić samą siebie.
Prelegent nie krytykuje AI (jego zespół używa jej do automatycznego wypełniania arkuszy i eksportów), ale sprzeciwia się logice „nie szkolimy juniorów, bo zrobi to AI". Dzisiejsi juniorzy to za dwa–trzy lata senior managerowie i założyciele nowych agencji; jeśli ta warstwa zniknie, nie będzie kto miał przejąć pracy. Automatyzacja ma uwalniać czas na naukę i diagnozę, nie zastępować ją.
„But what I’d say to that is, the juniors that we have kind of today, they are the senior managers in two years’ time, in three years’ time. They are the founders of the new agencies. If we get rid of that layer and kind of that role, we’re kind of killing SEO ourselves, which is ironic.”
3. Narzędzia odpowiadają na pytanie „gdzie", nie „dlaczego".
Screaming Frog, SEMrush, Moz, ObservePoint czy narzędzia Google świetnie wskazują, gdzie szukać i czy problem dotyczy szablonu, pojedynczej strony, tylko PDP (product detail page, strona produktu) czy całego serwisu. Nie powiedzą jednak, że przyczyną spadku widoczności jest konflikt przekierowań www z canonicalami. Odpowiedź na „dlaczego" to praca człowieka i to ona odróżnia audyt od listy błędów.
„So they’re really useful for that, but they get misconstrued a bit, and people think tools are the answer to the why. They’re not. They’re the answer to the where.”
4. Jeśli nie potrafisz powiedzieć, dlaczego problem występuje, nie wysyłaj go klientowi.
Holloway stosuje prostą zasadę kontroli jakości: punkt audytu bez wyjaśnienia przyczyny nie wychodzi z agencji. Klient i tak zada pytanie „dlaczego", a bez odpowiedzi nie będzie w stanie samodzielnie wdrożyć poprawki. Dodatkowo bezrefleksyjne przyjmowanie wyników narzędzi zakłada, że one się nie mylą, a mylą się często.
„Quite simply, if we can’t answer why, it should not go to the client.”
5. Najwyższy priorytet z SEMrush okazał się fałszywym alarmem, a „niski priorytet" z 99,93 procent stron ukrywał serwis niewidoczny dla LLM-ów.
Na realnym serwisie ze spadkiem ruchu rok do roku SEMrush na pierwsze miejsce z ośmiu wystawił błędną stronę w sitemapie, która po sprawdzeniu w ogóle nie była błędem. W tym samym czasie Screaming Frog oznaczył brak H2 jako problem o niskim priorytecie, ale skala (99,93 procent stron) wskazywała na coś większego: cała treść poniżej H1 była renderowana po stronie klienta, więc serwis był niewidoczny dla modeli językowych. Skala występowania błędu mówi więcej niż etykieta priorytetu z narzędzia.
„But it’s on 99.93% of pages. That tells us there’s something probably more wrong than just low priority H2s missing. In this case, we investigated and all of their content from H1 and below was being client-side rendered, not server-side rendered.”
6. Przy złym INP przyczyną nie było „za dużo JavaScriptu", tylko platforma do testów A/B źle wstrzykująca obrazy i karuzele produktowe.
PageSpeed Insights i WebPageTest zalecają w takich sytuacjach redukcję i minifikację JavaScriptu, co jest radą, której dev nie potrafi zamienić w konkretne zadanie. Holloway, który sam nie jest programistą, usiadł z deweloperem i razem znaleźli dokładne źródło problemu z INP (Interaction to Next Paint, metryka Core Web Vitals mierząca reakcję strony na interakcję). Dzięki temu klient dostał poprawkę do wdrożenia, a nie ogólnik.
„We found the exact cause of the issue was a A-B testing platform injecting images badly or injecting product aerosols badly. And we had an actual fix for them that wasn’t just, have you tried minifying JavaScript?”
7. JavaScript usuwał końcowy ukośnik z URL-i i wstrzykiwał noindex na każdą stronę, a crawler tego nie wykrył.
Problem zauważono dopiero obserwując gołym okiem, jak adres zmienia się po załadowaniu strony. Wraz z przepisaniem URL-a skrypt dodawał tag noindex do każdej podstrony serwisu, co ma nieporównanie większy wpływ na widoczność niż uszkodzony link w sitemapie. Wniosek dla praktyka: oprócz crawla trzeba fizycznie przejść przez serwis i zestawić to, co widzi przeglądarka, z tym, co raportuje narzędzie.
„So, when we initially checked with Screaming Frog, this didn’t come up. We noticed it when we saw physically the URL change and dropped the trending slash. With that trending slash drop, it also injected a JavaScript, no index tag, into every page on site.”
8. Klient nie prosił o audyt, tylko o wyjaśnienie spadku ruchu, więc audyt nie bada „zdrowia serwisu", tylko to, co ruch odbuduje.
Junior ma zacząć od pytania, o co klient faktycznie prosił i do kogo trafi dokument. Holloway proponuje trzy warstwy w jednym audycie: checklistę statusów dla CEO lub CMO, listę konkretnych działań dla web managera i szczegółową analizę dla deweloperów, do tego roadmapę z priorytetami zamiast samych etykiet „wysoki, średni, niski". Audyt „dla wszystkich" nie trafia do nikogo.
„That then changes the framing of what we’re actually looking at. We’re not looking at site health. We’re looking at what’s going to benefit their traffic and answer that question for them.”
Zdjęcia: Michael Holloway
4 kadrów · Fot. Robert Nowaczyk
Chima Mmeje i Anu Ramani: Write With AI / Big Idea Content Strategy
14:20
Dwie następujące po sobie prelekcje (14:20 i 14:40) nagrane i opracowane jako jeden materiał.
Streszczenie
Chima Mmeje przedstawiła proces tworzenia treści z AI (Artificial Intelligence / sztuczna inteligencja), w którym autor dostarcza doświadczenie i wiedzę, a model pomaga wyszukiwać dowody, planować ilustracje oraz wdrażać linkowanie wewnętrzne.
Anu Ramani zajęła się wcześniejszym etapem: wyborem idei przewodniej kampanii. Pokazała, jak rozpoznanie klienta, konkurencji i kontekstu pomaga odróżnić temat interesujący od tematu, który skłania odbiorców do działania.
Najważniejsze wnioski
Opis procesu: doświadczenie autora było punktem wyjścia, nie dodatkiem do wygenerowanego tekstu.
Chima pokazała, że odbiorca powinien dowiedzieć się, z jakim problemem autor się mierzył, czego próbował, co zadziałało i jak zastosować te doświadczenia u siebie.Rekomendacja: AI warto wykorzystywać do konkretnych zadań redakcyjnych.
Prelegentka przedstawiła wyszukiwanie materiałów potwierdzających tezy, wskazywanie miejsc na ilustracje, przygotowywanie ich szkiców i dobieranie linków. Nie sprowadzała pracy z modelem do wygenerowania całego artykułu jednym poleceniem.Opinia: efektywność produkcji nie jest tym samym co skuteczność marketingu.
Anu przestrzegała przed oddawaniem modelom myślenia strategicznego pod presją czasu. Jej zdaniem koncentracja na liczbie materiałów i kosztach ich tworzenia sprzyjała upodabnianiu się komunikacji marek.Rekomendacja: analizę należy przeprowadzić przed burzą mózgów.
Anu zaproponowała model 3C (Customer, Competition, Context / klient, konkurencja i kontekst). Podkreślała różnicę między podstawowymi wymaganiami kategorii, takimi jak cena czy bezpieczeństwo, a rzeczywistymi motywacjami zakupowymi.Wniosek z przykładów: zainteresowanie tematem nie oznacza gotowości do zakupu.
Kampania mogła zdobyć ruch i publikacje medialne, ale nie wywołać działania, jeśli problem nie był pilny. Z kolei badanie odpowiadające na aktualną niepewność klientów mogło wspierać rozmowy sprzedażowe i przychody.
Dane liczbowe i przykłady
| Liczba lub wynik | Kontekst |
|---|---|
| 67 unikalnych propozycji linków | Tyle sugestii Chima otrzymała w pokazanym przykładzie po poproszeniu modelu o pełny zestaw rekomendacji. Nie była to liczba linków, które należało automatycznie wstawić. |
| 80% trafności | Tak Chima oceniła proces wspierający linkowanie wewnętrzne po wielokrotnym wykorzystaniu go w swojej pracy. |
| 13 procesów i umiejętności do wykorzystania | Taki zestaw materiałów Chima zapowiedziała jako rozwinięcie prezentacji. |
| 89% oraz 64% | Anu przywołała wskaźnik 89% dotyczący korzystania z AI do tworzenia treści. Podała również, że 64% klientów B2B (Business-to-Business / relacje między firmami) nie potrafiło odróżnić cyfrowych doświadczeń oferowanych przez poszczególne marki. |
| 20% kupujących i 90% tej grupy | W przykładzie dotyczącym wyposażenia domu Anu przywołała przejście 20% kupujących do zakupów online po pandemii oraz brak powrotu 90% tej grupy do zakupów stacjonarnych. |
| 170 tys. wizyt | Taki ruch, obok licznych publikacji medialnych, przyniosła opisana kampania dotycząca oszustw związanych z promocjami. Według Anu nie przełożyło się to na oczekiwane działania odbiorców. |
| Milionowe przychody | Tak Anu opisała rezultat kampanii dotyczącej przyszłości pracy, przygotowanej dla firmy oferującej nieruchomości biurowe w 2021 roku. |
| Skala 1–5 | Służyła do oceny pomysłów pod względem wartości dla klienta, odróżnienia od konkurencji, aktualności kontekstu i kreatywności. Następnie kryteria otrzymywały wagi zależne od celu kampanii. |
Praktyczne rady
- Przed pracą z modelem zbierz materiał od eksperta: problem, podjęte działania, rezultaty, nieudane próby i wskazówki wdrożeniowe.
- Szukaj zewnętrznych dowodów na dwóch etapach: podczas budowania konspektu i po napisaniu tekstu. Weryfikuj źródła przed ich wykorzystaniem.
- Zbuduj bibliotekę do linkowania: adresy stron, metadane i dane o wynikach. Oddziel generowanie rekomendacji od ich akceptacji.
- Przed spotkaniem kreatywnym porozmawiaj ze sprzedażą: ustal motywacje klientów, blokady zakupowe, alternatywy oraz powód, dla którego temat jest ważny właśnie teraz.
- Porównuj pomysły według jawnych kryteriów: zastosuj ocenę 1–5 i wagi odpowiadające celowi kampanii. Anu traktowała wynik jako wsparcie decyzji, pozostawiając zespołowi możliwość odrzucenia najwyżej ocenionego pomysłu.
Knowledge bombs
1. Mmeje: czytelnik treści eksperckiej szuka czterech rzeczy – czy miałeś ten problem, co próbowałeś, co zadziałało i jak to wdrożyć u siebie.
Chima Mmeje pisze konsekwentnie w pierwszej osobie, żeby od pierwszego akapitu było jasne, że to relacja z własnego doświadczenia, a nie kompilacja. Jej schemat PEEL to: pain (problem), evidence (dowód z własnej praktyki), external validation (potwierdzenie z zewnątrz) i linkowanie. AI (sztuczna inteligencja) nie zastępuje żadnego z tych elementów, tylko przyspiesza ich składanie.
„People are looking for certain things when they are reading contents. They want to know if you faced the problem. What did you try? What worked? What didn’t? But most importantly, how do I implement what you’re sharing in my own strategy?”
2. Mmeje: gotowy szkic wraca do Claude z jednym pytaniem – gdzie dołożyć zewnętrzne dowody, żeby podnieść wiarygodność i E-E-A-T.
Model nie pisze artykułu, tylko wskazuje konkretne akapity, w których warto podeprzeć tezę cudzym badaniem lub cytatem, i podpowiada, jak wpleść je bez psucia rytmu tekstu. Mmeje pokazała to na wywiadzie z Mikiem Kingiem: samą wypowiedź jednego eksperta uznała za zbyt słabą do publikacji, więc obudowała ją głosami innych osób. E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness) to w tym procesie etap redakcji, nie slogan.
„When I finish writing the content, I’m still going to take that draft and feed it back into CLUD. And then I’m going to ask CLUD, in what parts can we lay on external evidence to improve credibility and EET?”
3. Mmeje: bibliotekę linkowania wewnętrznego dla 20-letniego serwisu Moz da się zbudować w Claude z crawla, Search Console i arkusza.
Przepis: eksport adresów i metadanych ze Screaming Froga, dane o wydajności z GSC (Google Search Console) i GA4, złożenie wszystkiego w Google Sheets, projekt w Claude z włączoną pamięcią, zapis jako skill do współdzielenia z zespołem. Po wgraniu artykułu model wypisał 67 unikalnych propozycji linków, ale trzeba mu wprost zabronić skracania listy, bo domyślnie wykonuje minimum pracy.
„I need internal link suggestions for the article. Please surface all link suggestions, not just eight. For some weird reason, it likes to do the least amount of efforts.”
4. Mmeje: automatyczne wstawianie linków z anchorem, adresem docelowym, oceną pewności i uzasadnieniem działa z około 80-procentową trafnością.
Model generuje plan wdrożenia (anchor, strona docelowa, confidence score, powód, dokładne miejsce w tekście), a potem sam wprowadza linki do dokumentu. Mmeje zastrzega, że LLM (duży model językowy) nie ma własnego źródła danych, więc bez crawla i danych z Search Console taki workflow nie ma na czym pracować.
„I’ve tried this multiple times, and it has an 80% accuracy, which is pretty incredible.”
5. Ramani: 64 procent klientów B2B nie odróżnia cyfrowego doświadczenia jednej marki od drugiej – to skutek oddania myślenia maszynie.
Anu Ramani nazywa to „cognitive surrender”: gdy blog czy kampania leadowa jest siedemnastym punktem na liście zadań, zespół oddaje AI nie tylko pisanie, ale i pomysł. 89 procent marketerów używa AI do tworzenia treści, więc wszystko brzmi tak samo, a silniki odpowiedzi – jak przypominała – preferują treść oryginalną. Dużą ideę trzeba wymyślić samemu, AI jej nie wygeneruje.
„All content is sounding the same. 64 percent of B2B customers cannot tell the difference between one brand’s digital experience and another.”
6. Ramani: bezpieczeństwo, zgodność, cena i funkcje to czynniki higieny – spełnia je każdy konkurent, więc nie da się na nich zbudować przekazu.
Ramani odwołuje się do dwuczynnikowej teorii Herzberga: większość marketerów kończy research na czynnikach higieny, zamiast dokopać się do czynników motywujących. Praktyczna rada: gdy sprzedaż podaje listę takich cech, zapytać wprost, czym to nas odróżnia od konkurencji, i przyjąć, że rozmowa zrobi się trudniejsza. Przykład: badanie konsumentów pokazujące, że po pandemii 20 procent kupujących przeszło do internetu i 90 procent z nich nie wróciło do sklepów stacjonarnych, stało się otwarciem każdej rozmowy handlowej klienta i jest powtarzane co roku.
„[…] we are stopping at the hygiene factors. Security, compliance, pricing, features. So these are category motivators. You and every single one of your competitors can fulfill this.”
7. Ramani: „jesteśmy w kategorii jednego” to złudzenie, bo żaden dział zakupów nie zatwierdzi budżetu B2B bez dwóch lub trzech alternatyw.
Skoro klient zawsze porównuje, trzeba uczciwie rozdzielić parity (to, co mają wszyscy) od rarity (to, co mamy tylko my). Metoda Ramani: spisać wszystkie hasła konkurencji w stylu „developer-friendly”, „AI-powered”, „powerful” i traktować tę listę jako teren zakazany, a inspiracji szukać poza nią. Singapore Airlines, Virgin Atlantic i Ryanair sprzedają identyczną usługę na tych samych samolotach i z tych samych lotnisk, a różnią się wyłącznie pozycjonowaniem.
„There is not a single procurement lead or CFO who is going to sign off on a budget, a B2B budget, without you showing them at least two or three credible and viable options.”
8. Ramani: kontekst decyduje o wyniku kampanii – raport o przyszłości pracy z 2021 r. przyniósł miliony przychodu, a badanie o oszustwach promocyjnych 170 tys. wizyt i zero leadów.
Oba projekty miały ten sam mechanizm (własne badanie, raport, dystrybucja), ale pierwszy trafił w moment, gdy najemcy biur nie wiedzieli, co dalej, a drugi opisywał problem, którego nikt nie uznawał za pilny. Ramani zaleca wpisać kontekst do karty oceny pomysłów obok klienta, konkurencji i kreatywności, z wagami zależnymi od typu kampanii, i mimo to wybrać drugi pomysł, jeśli ten z wyższym wynikiem „nie siedzi”.
„Campaign two was interesting, right? The media covered it, people wanted to read about it, but nobody took action on the back of it because the context wasn’t right.”
Zdjęcia: Chima Mmeje i Anu Ramani
6 kadrów · Fot. Robert Nowaczyk
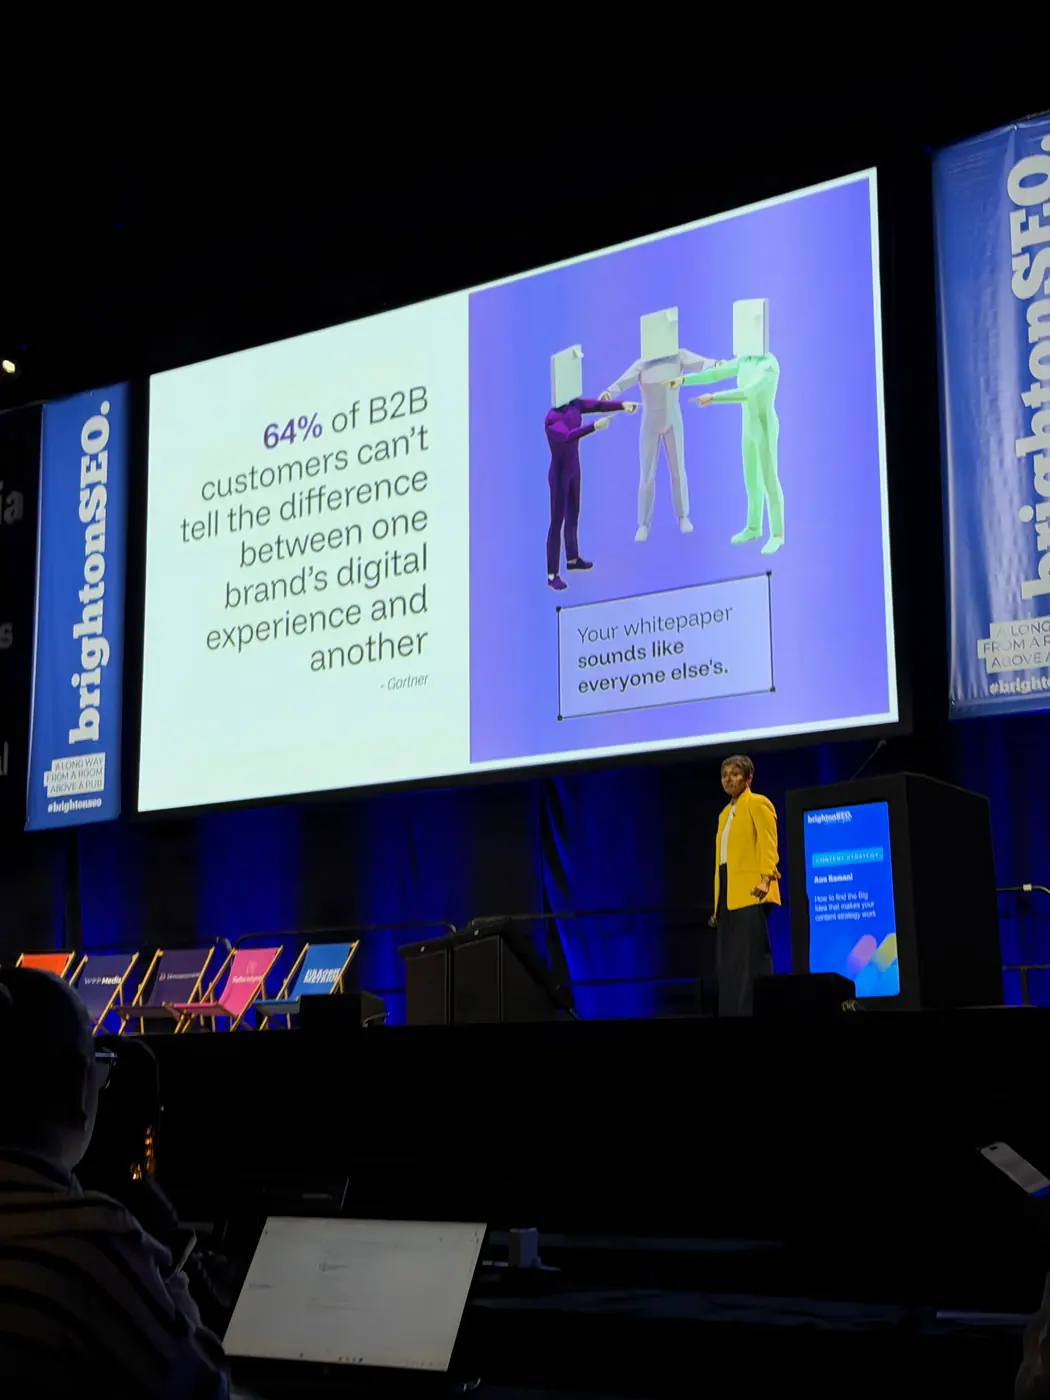
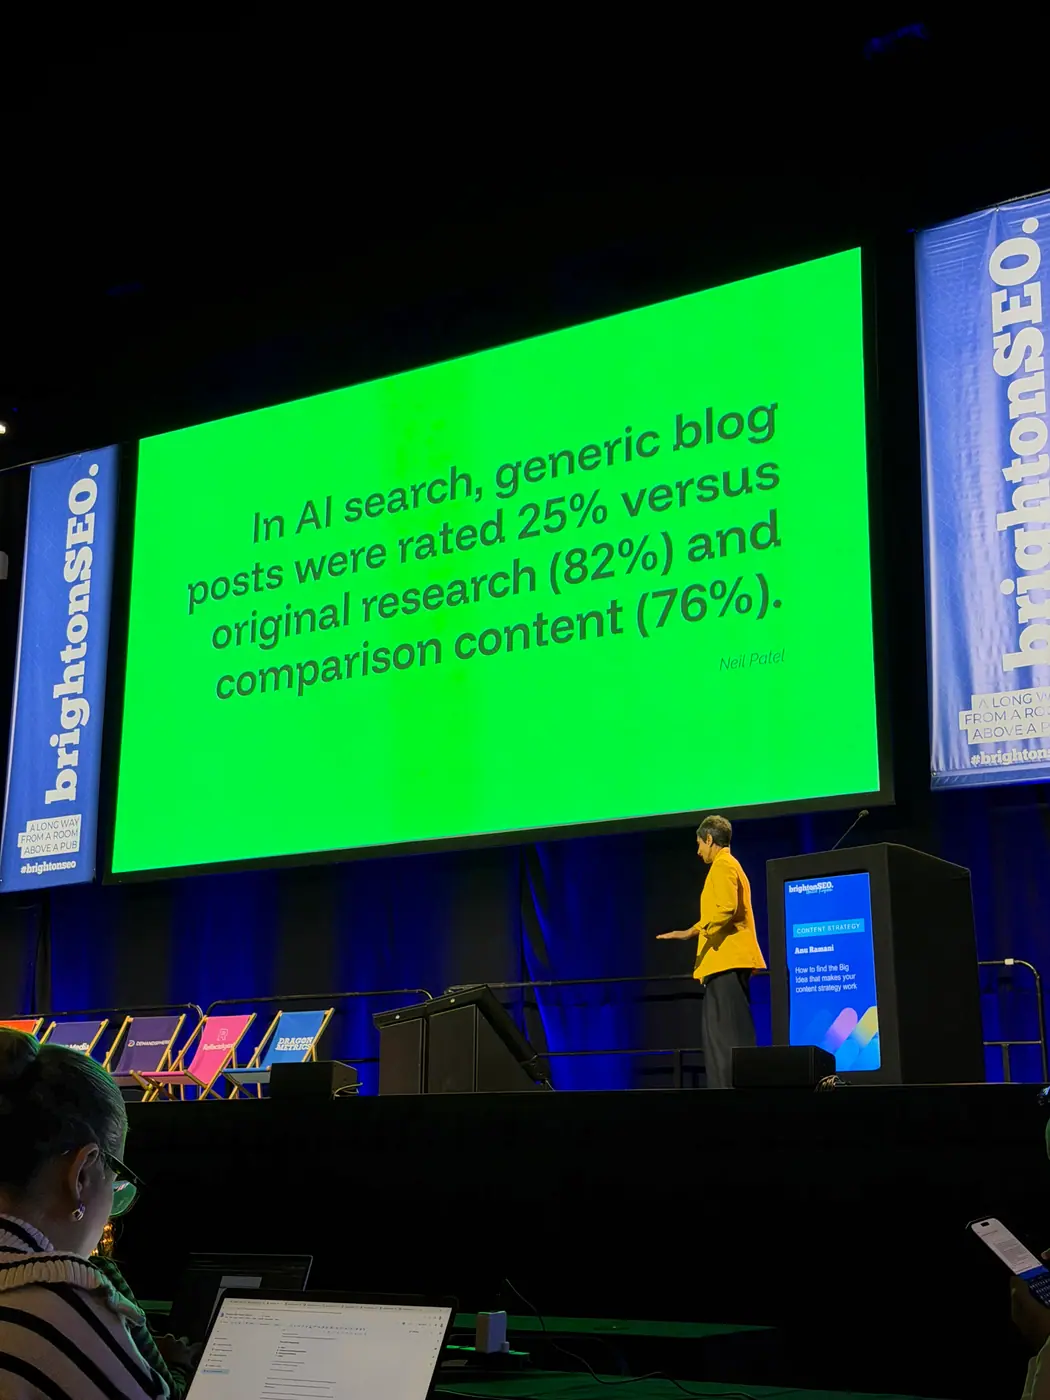
Vittoria Rinaldi: Ecommerce Tech SEO Audits 2026
14:20
Nagranie obejmuje tylko fragment prelekcji.
Streszczenie
Vittoria Rinaldi przedstawiła problemy techniczne e-commerce, których standardowy audyt SEO (Search Engine Optimization / optymalizacja dla wyszukiwarek internetowych) może nie wychwycić. Skupiła się na okresowych błędach renderowania, nieoczekiwanych adresach z parametrami oraz zmianach w statystykach crawlowania, czyli pobierania stron przez roboty.
Najpełniej omówiła przypadek błędów soft 404: strony zwracały status 200, ale czasami nie wyświetlały treści. Pokazała przyczynę, poprawkę i późniejszą stabilizację pozycji. Wątek nieoczekiwanych adresów z canonicalem zakończył się w dostarczonym fragmencie na rozpoznaniu sygnałów problemu.
Najważniejsze wnioski
Obserwacja: poprawny test na żywo nie wykluczał okresowej awarii.
Liczba błędów soft 404 w Google Search Console rosła, chociaż ponowne testy i ręczne sprawdzanie stron nie potwierdzały problemu.Przyczyną były niedostępne zasoby potrzebne do renderowania.
Między pobraniem strony a jej renderowaniem wdrożenie zmieniało nazwy plików. Wcześniejsze zasoby przestawały być dostępne, a część stron nie mogła wyświetlić treści. Rozwiązaniem było zachowywanie starszych zasobów.Brak nagłówka okazał się objawem większego problemu.
Crawler zgłaszał brak H1 (Heading 1 / nagłówek pierwszego poziomu). Po sprawdzeniu stron okazało się, że brakowało całej treści, a w logach pojawiał się błąd „chunk load failure”, czyli błąd ładowania fragmentu kodu.Poprawny canonical nie oznaczał, że przyrost adresów był zamierzony.
Canonical wskazuje preferowany adres do indeksowania, ale nie blokuje crawlowania pozostałych adresów. Prelegentka zwróciła uwagę na parametry, które w ogóle nie powinny były powstać.Rekomendacja prelegentki: interpretować raporty w kontekście zmian w serwisie.
Skoki odpowiedzi 200 i odkrywania nowych adresów wymagały sprawdzenia szczególnie wtedy, gdy nie towarzyszyło im uruchomienie nowych stron ani inne planowane zmiany.
Dane liczbowe i przykłady
- Pogłębiony crawl w Screaming Frog trwał około 10–12 godzin, obejmował wszystkie wersje językowe i wykorzystywał zwiększoną liczbę wątków.
- Pierwsze oznaki stabilizacji pozycji po poprawce pojawiły się po kilku tygodniach.
- Dalsza stabilizacja trwała jeszcze kilka miesięcy. Był to rezultat opisanego przypadku, nie uniwersalny termin odzyskiwania widoczności.
Praktyczne rady
- Nie odrzucaj rosnącej liczby soft 404 tylko dlatego, że pojedynczy test strony zakończył się poprawnie.
- Przy brakującym H1 sprawdź również pozostałą treść i logi błędów renderowania.
- Zweryfikuj z zespołem programistycznym dostępność starszych zasobów po wdrożeniach.
- Przy wzroście liczby stron z canonicalem sprawdź, jakie parametry się pojawiły i czy ich powstanie było planowane.
- Zestawiaj skoki w statystykach crawlowania z kalendarzem zmian w serwisie.
Knowledge bombs
1. Gdy crawl i standardowe raporty Search Console są czyste, problemy e-commerce chowają się w trzech miejscach.
Rinaldi opisuje sytuację, w której pozycje wahają się albo powoli spadają, audyt niczego nie wykazuje, a w Google Search Console nie ma błędów 500 ani problemów z hostingiem. Wtedy trzeba sprawdzić raport soft 404 (w tym strony, które po ponownym teście wyglądają poprawnie), raport „Alternate page with proper canonical tag" oraz statystyki indeksowania: strony nieosiągalne, timeouty i nagłe piki odpowiedzi 200 lub odkrywania nowych adresów.
„Issues that don’t look like issues. We need to start digging into those, because there is where the big problems might be hiding.”
2. „Ghost soft 404" to strony, które w ponownym teście wyglądają dobrze, a licznik soft 404 i tak rośnie.
Klasyczny soft 404 to pusta strona ze statusem 200, łatwa do znalezienia i naprawienia. Wariant „duch" jest trudniejszy: strona wygląda poprawnie na żywo, test w Search Console nie zgłasza błędu, a raport mimo to puchnie. W dużym sklepie zespół najpierw uznał to za usterkę Google; wzrost nie zatrzymał się, więc trzeba było szukać dalej.
„The other issue are the so-called ghost software report. These are pages that look totally fine. And when you retest it in Google Search Console, you don’t get any software report error.”
3. Flaga „brak H1" z wielogodzinnego crawla okazała się pustą stroną z błędem chunk load failure w konsoli Chrome.
Dopiero pełny crawl w Screaming Frog ze zwiększoną liczbą wątków, obejmujący wszystkie wersje językowe i trwający 10–12 godzin, zwrócił pakiet stron bez H1. Po bliższym sprawdzeniu brakowało na nich wszystkiego, nie tylko nagłówka, a w konsoli przeglądarki pojawiał się błąd ładowania fragmentu JavaScriptu. To był ten sam obraz, który widział Google.
„We got a bunch of pages that were flagged as missing H1, and digging into them, it was not just missing H1. It was missing everything from it. And these pages actually had a Chrome log error.”
4. Przyczyną były zmienione podczas wdrożenia nazwy zasobów JavaScript, a lekarstwem zachowanie starych plików po deploymencie.
Google crawlował stronę z odwołaniami do konkretnych plików, po czym deployment zmieniał ich nazwy, więc w momencie renderowania zasoby już nie istniały i strona wyświetlała się pusta. Po uzgodnieniu z deweloperem sklep (serwis na Next.js) zaczął przechowywać stare zasoby po każdym wdrożeniu. Wahania pozycji zaczęły się uspokajać po kilku tygodniach, a pełna stabilizacja zajęła kilka miesięcy.
„During deployment, those resources were changed. Their name was changed. So when the rendering happened, those resources were not available anymore.”
5. Canonical zatrzymuje indeksowanie, ale nie crawlowanie, więc nagły wzrost raportu „Alternate page with proper canonical tag" to sygnał, nie potwierdzenie poprawności.
W e-commerce kanonikalizowane parametry są normą i wielu specjalistów traktuje ten raport jako „wszystko w porządku". Problem zaczyna się, gdy pojawiają się parametry, które nigdy nie powinny istnieć: sklep, który miał niewiele canonicali, nagle dostał ich tysiące, a każda taka strona nadal pochłania budżet crawlowania i powiększa serwis z perspektywy Google.
„And this looked a bit scary because, as we all know, a canonical stops indexing, but it doesn’t stop crawling. So that really was increasing the size of the website.”
6. Pik odpowiedzi 200 lub odkrywania nowych adresów w statystykach indeksowania jest groźny tylko wtedy, gdy nic nie wdrażałeś.
Ten sam problem z niechcianymi parametrami zwykle widać w Crawl stats jako skok liczby odpowiedzi 200 i liczby nowo odkrytych adresów. Interpretacja zależy od kontekstu: po premierze kolekcji albo wdrożeniu taki pik jest naturalny, ale bez żadnego wdrożenia oznacza, że Google znajduje adresy, których nie zamierzałeś publikować.
„And this is scary only when you know that you haven’t released anything. There’s no peak. There’s no launch. There hasn’t been anything that justify a peak in 200 or in discovery.”
Jess Atkinson: SERP Psychology
15:30
Streszczenie
Jess Atkinson podczas brightonSEO przedstawiła optymalizację decyzji użytkownika jeszcze przed kliknięciem wyniku. Przekonywała, że w SEO (Search Engine Optimization / optymalizacja pod kątem wyszukiwarek) sama poprawa pozycji nie wystarcza do wyjaśnienia, dlaczego odbiorca wybiera konkretną markę.
Zaproponowała analizę SERP (Search Engine Results Page / strona wyników wyszukiwania) przez pięć pytań dotyczących uwagi, dopasowania, wiarygodności, wysiłku i ryzyka. Połączyła ten model z mechanizmami psychologicznymi, doborem formatów treści i budowaniem rozpoznawalności marki.
Najważniejsze wnioski
- Obserwacja prelegentki: widoczność nie oznacza wyboru. Atkinson opisała sytuacje, w których klienci obserwowali poprawę pozycji, ale nie widzieli odpowiadającego jej wzrostu kliknięć. Zwróciła uwagę na konkurencję między różnymi elementami wyników, nie tylko między linkami.
- Model ścieżki odbiorcy: search orbit. Etapy decyzji nie muszą następować po sobie liniowo. Odbiorcy przemieszczają się między nimi i korzystają z różnych platform.
- Interpretacja: intencja wyszukiwania nie wyjaśnia wszystkich motywacji. Prelegentka proponowała wykorzystywać ją do rozumienia tego, co wyszukiwarka uznaje za odpowiednie. Osobno analizować potrzeby, obawy i skróty myślowe człowieka.
- Model roboczy: decision stack, czyli pięć pytań poprzedzających wybór. Czy widzę ten wynik? Czy odpowiada mojej potrzebie? Czy mu wierzę? Ile wysiłku wymaga decyzja? Co się stanie, jeśli wybiorę źle?
- Opinia: rozpoznawalność i lojalność pełnią różne funkcje. Lojalność oznacza powtarzanie zakupów. Rozpoznawalność może ułatwiać wybór również wtedy, gdy odbiorca porównuje nowe marki.
- Prognoza jakościowa: Atkinson przewidywała największe korzyści dla marek, które lepiej zrozumieją wybór odbiorcy i ograniczą przeszkody przed kliknięciem. Nie proponowała porzucenia pozycji, lecz odejście od traktowania ich jako celu samego w sobie.
Dane liczbowe i przykłady
| Informacja z wystąpienia | Znaczenie i status |
|---|---|
| Spadek „rzeczywistej lojalności wobec marek” o 5% od 2024 r. | Wynik badania przywołanego przez prelegentkę. Według jej relacji był to największy spadek w pięciu latach. |
| Około 1000% wzrostu wolumenu wyszukiwań marki w około pięć lat | Liczba podana przy przykładzie Trip i jego spójnej identyfikacji wizualnej. To przykład towarzyszących sobie zjawisk, nie dowód, że sam wygląd spowodował wzrost. |
| 24 warianty dżemu w większym zestawie | W przywołanym badaniu osoby mające większy wybór rzadziej dokonywały zakupu niż osoby z mniejszym wyborem. Prelegentka wykorzystała przykład do omówienia przeciążenia decyzją. |
| 3 funty wobec 3000 funtów | Ilustracja różnicy w ryzyku finansowym, nie wynik badania. Atkinson podkreśliła również koszt czasu i emocjonalne konsekwencje złego wyboru. |
Praktyczne rady
- Wybierz jedno priorytetowe zapytanie. Może to być fraza z dobrą pozycją i niewielką liczbą kliknięć albo taka, dla której dopiero chcesz zbudować widoczność.
- Obejrzyj rzeczywisty układ wyników. Sprawdź, co przyciąga uwagę: zdjęcia, filmy, oceny, wydawcy czy klasyczne wyniki tekstowe. Własną obserwację potraktuj jako hipotezę do testowania.
- Dobierz materiał do widocznego formatu. Nie zakładaj automatycznie, że potrzebny jest kolejny artykuł. Czasem właściwym działaniem będzie przygotowanie zdjęć, filmu lub współpraca z wydawcą.
- Porównaj sygnały zaufania. Policz widoczne opinie, oceny i wyniki z forów. Sprawdź, jak na ich tle prezentuje się Twoja oferta.
- Oceń wysiłek i ryzyko wyboru. Poszukaj prawdziwych przewag, takich jak bezpłatny zwrot czy możliwość anulowania, które warto komunikować przed wejściem na stronę. Nie zastępuj ich sztuczną presją czasu.
Knowledge bombs
1. Wzorzec F już nie opisuje czytania wyników Google – funkcje SERP rozbijają uwagę, a lojalność wobec marek spadła o 5 procent od 2024 r.
Jess Atkinson nazywa to „pattern interrupt”: na stronie wyników (SERP, Search Engine Results Page) pełnej modułów oko skacze po ekranie niemal losowo, więc pierwsza pozycja przestała gwarantować kliknięcie. Do tego dochodzi badanie SAP o największym od pięciu lat spadku prawdziwej lojalności. Stąd rozjazd, który widzą klienci agencji: pozycje rosną, kliknięć nie przybywa.
„And this is also why ranking number one isn’t as important anymore. If you combine this with the fact brand loyalty is eroding. So there was a study by SAP, I believe, that said true brand loyalty had dropped 5% since 2024.”
2. „Optymalizacja pod ludzi” kończy się dziś zbyt późno – trzeba optymalizować decyzję podejmowaną przed kliknięciem.
Branża od lat ulepsza własne strony pod użytkownika, ale nie zajmuje się tym, co dzieje się zanim ten użytkownik wejdzie na stronę. Atkinson przesuwa cel: nie ranking, lecz usunięcie tarcia na etapie wyboru w wynikach, bo o zaufaniu do marki człowiek decyduje jeszcze w SERP-ie. Algorytm wybiera, kto trafi na stronę wyników; użytkownik wybiera, kto wygrywa.
„So we still need to optimize for humans, but we actually have to optimize before that click happens and we optimize for that decision.”
3. Intencja wyszukiwania opisuje, jak algorytm rozumie zapytanie, a nie co czuje człowiek – na to drugie nie ma narzędzia.
Kategorie „informacyjna”, „komercyjna” wymyślili marketerzy; nikt nie siada do telefonu z zamiarem zrobienia zapytania informacyjnego, tylko z potrzebą lub emocją. Atkinson proponuje zostawić intencję do analizy tego, co Google uznaje za trafne, a zachowanie odbiorcy badać osobno, ręcznie, przez pryzmat błędów poznawczych (kotwiczenie, autorytet, pilność, dowód społeczny, nadmiar wyboru).
„Your average Joe out on the street won’t get the phone out and go to Google and think, I’m going to make an informational search today.”
4. Efekt kotwiczenia: reklama i przegląd AI na górze ustawiają oczekiwania, a wynik niżej musi się z nimi kłócić.
Jeśli na szczycie strony reklamę ma Dell, a przegląd AI (AI Overview) wspomina Maca, użytkownik skanujący dalsze wyniki spodziewa się, że będą pasować do tego, co już przeczytał. Wynik organiczny z inną rekomendacją startuje więc z pozycji polemisty, nie odpowiedzi – i to trzeba uwzględnić w tym, co pokazuje się w tytule i opisie.
„So ultimately, if you are ranking a bit lower in these situations, you are arguing with kind of the summaries at the top.”
5. O zaufaniu w wynikach decydują sygnały, nie pozycja – użytkownik prędzej uwierzy MrsStyles22 z Reddita niż marce chwalącej własny produkt.
Gwiazdki, weryfikacja, oceny i wątki forum sprawiają, że wynik wygląda oficjalnie i sprawdzonie, niezależnie od tego, gdzie rankuje. Dowód społeczny działa w SERP-ie tak samo jak w mediach społecznościowych. Z kolei sztuczna pilność (ostatnie dwa miejsca) przyciąga uwagę, ale kosztuje zaufanie; bezpieczniej łączyć ją z sygnałem obniżającym ryzyko, np. darmową anulacją.
„And a lot of the time, people are less likely to trust a brand when it says my product is great, but they might trust someone with the username MrsStyles22 on Reddit with the same kind of opinion.”
6. „Decision stack”: pięć pytań, które użytkownik zadaje sobie podświadomie, a na Google trzeba odpowiedzieć na wszystkie naraz.
Uwaga (czy cię widzę), trafność (czy jesteś tym, czego szukam), pewność (czy ci wierzę), wysiłek (ile mnie to będzie kosztować) i ryzyko (co, jeśli się pomylę). Brak odpowiedzi na którekolwiek z nich obniża szansę wyboru. Na innych platformach proporcje się zmieniają: w LLM-ach (dużych modelach językowych) celem jest samo włączenie do odpowiedzi, bo trafność model rozstrzygnął za użytkownika, a w social search wszystko zaczyna się od uwagi.
„So again, with LLMs, inclusion is the goal, and LLMs have already kind of made the decision about that relevance for you, so it’s not something that’s needed to be considered as much.”
7. Rozpoznawalność marki to skrót przez cały decision stack, a każda platforma buduje ją z czego innego: Google z autorytetu, TikTok z zażyłości, LLM ze spójności.
Lojalność słabnie, więc rozpoznawalność znaczy więcej, nie mniej. Atkinson pokazuje trzy marki, które wybrały jedną rzecz i robiły ją konsekwentnie: Trip (spójna pastelowa estetyka, wzrost wyszukiwań brandowych o około 1000 procent w pięć lat, ChatGPT opisuje markę właśnie przez estetykę), Who Gives A Crap (jeden ton głosu w nudnej kategorii) i marka z TikToka powtarzająca ten sam format wideo. Jej zdaniem działa to przy każdym budżecie.
„And then LLMs, it’s about consistency. So you need to make sure that where you’re talking about your brand in different places, it is a consistent message. So LLMs can kind of recognize that and keep pushing with it.”
8. Audyt zaczyna się od zmrużenia oczu nad SERP-em: jeśli wzrok idzie do pakietu obrazów, potrzebujesz obrazu, nie kolejnego wpisu na blogu.
Procedura Atkinson dla jednego priorytetowego zapytania: spojrzeć, gdzie ucieka uwaga, i tworzyć ten format (obraz, wideo, a gdy SERP wypełniają wydawcy – iść do digital PR); policzyć sygnały zaufania u konkurentów i wyrównać braki, np. gwiazdki w danych strukturalnych; zmierzyć, ile zajmuje decyzja i ile opcji trzeba porównać; wycenić ryzyko przez koszt, odwracalność i to, jak źle poczuje się człowiek po pomyłce. Darmowe zwroty widoczne dopiero po wejściu na stronę nie pomagają, bo decyzja zapadła wcześniej.
„If the eye goes to the image pack, for example, this means you don’t need another blog post just because you want to rank higher. You need an image.”
Zdjęcia: Jess Atkinson
4 kadrów · Fot. Robert Nowaczyk
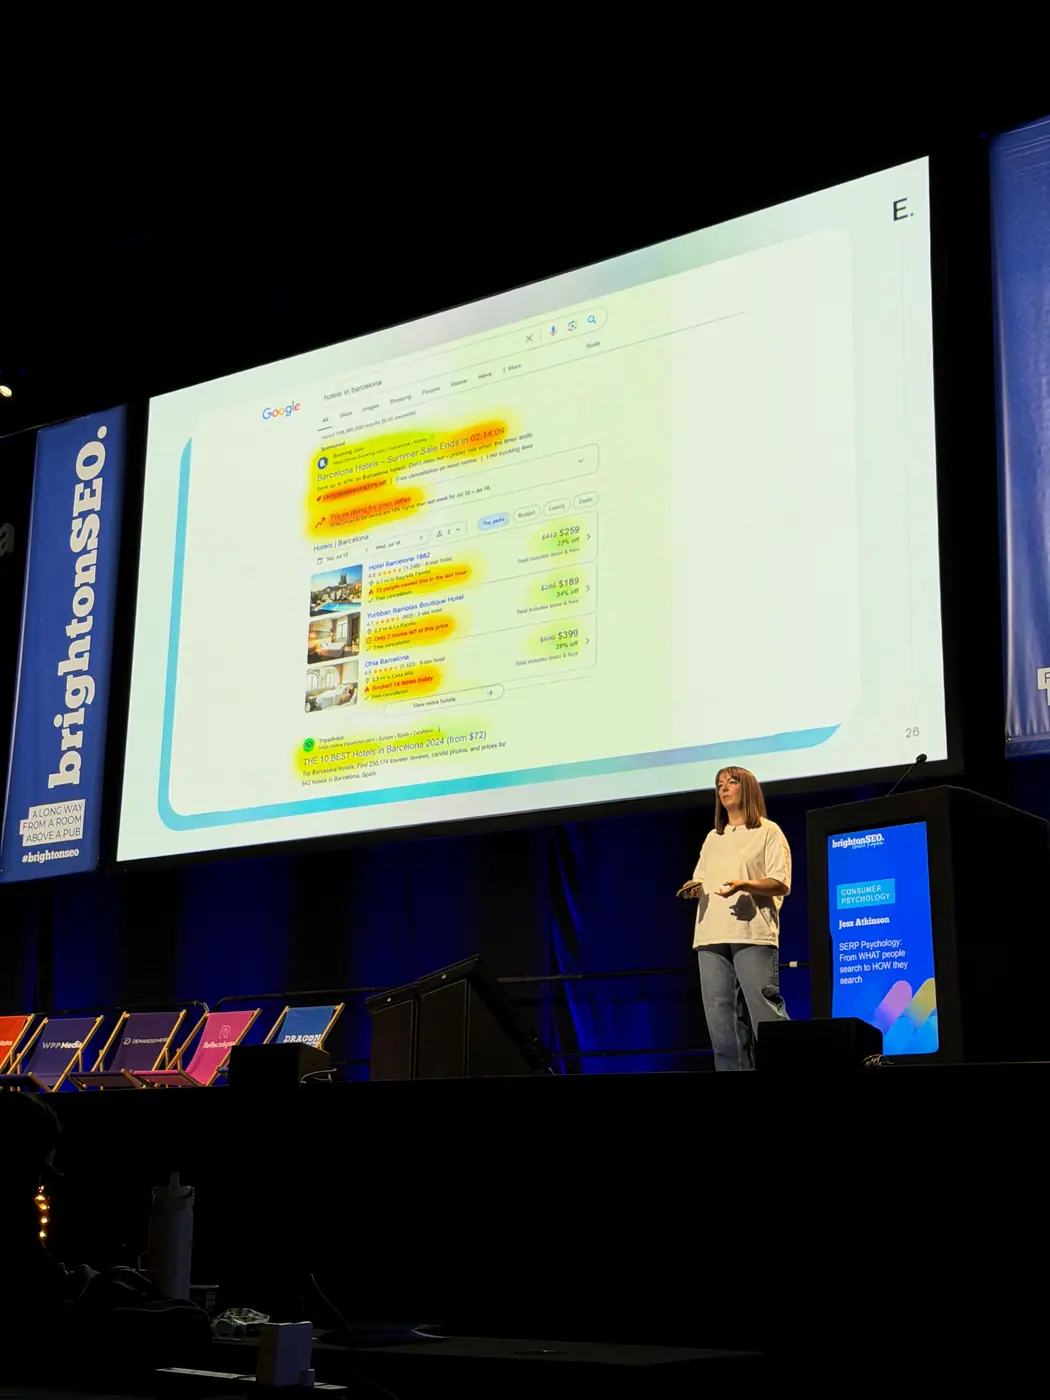
Chloe Blades: The Algorithm Got You Seen, Psychology Gets You Remembered
15:50
Streszczenie
Chloe Blades podczas brightonSEO 9 października 2026 r. rozdzieliła dwa zadania marketingu: zdobycie widoczności i zbudowanie pamięci marki. Przekonywała, że algorytm może pomóc w dystrybucji treści, ale sam zasięg nie dowodzi, że odbiorca zapamiętał nadawcę, zaufał mu lub zechce kupić jego produkt.
Przedstawiła podejście oparte na emocjach, aspiracjach odbiorcy, historiach i powtarzaniu istotnych komunikatów. Były to przede wszystkim autorskie tezy i przykłady, nie prezentacja wyników badań.
Najważniejsze wnioski
- Uwaga jest początkiem ścieżki klienta, nie jej końcem. Blades oddzieliła wyświetlenia od zapamiętania, zaufania, zakupu i dobrowolnego polecania marki.
- Zaangażowanie może dotyczyć tematu, a nie nadawcy. Opowiedziała o własnym viralowym materiale dotyczącym rozstania celebrytów. Dyskusja przyciągnęła osoby zainteresowane sporem, niekoniecznie jej działalnością.
- Treść nie musi być głośniejsza, żeby została zauważona. Prelegentka wskazała cztery mechanizmy zdobywania uwagi: kontrast, zaskoczenie, przerwanie schematu i ciekawość.
- Aspiracje odbiorcy mogą być ważniejsze niż same cechy produktu. Blades proponowała pytanie: kim klient chce się stać i jaką rolę ma w tym odegrać zakup?
- Informacja, emocja i powtórzenia powinny ze sobą współpracować. Historie miały nadawać informacji kontekst, a regularne wracanie do kluczowych komunikatów pomagać utrwalać skojarzenia.
- Dobrowolne rekomendacje uznała za szczególnie wartościowy efekt marketingu. Ilustrowała to przykładem polecenia restauracji znajomemu bez wynagrodzenia czy zachęty ze strony lokalu.
Liczby i przykłady z materiału
- 100 tys. i 1 mln wyświetleń posłużyły jako ilustracja dużego zasięgu, który nie musi oznaczać zapamiętania marki. Nie były wynikami analizowanej kampanii.
- 2020 rok i 200 funtów na koncie pojawiły się w przykładowym porównaniu suchej informacji o założeniu firmy z historią jej początku. Nie należy przedstawiać tej historii jako biografii prelegentki.
- Cztery mechanizmy uwagi: kontrast, zaskoczenie, przerwanie schematu, ciekawość.
- Cztery pytania do komunikacji: z czego marka chce być znana, co odbiorca ma poczuć, co zapamiętać i co zrobić następnie.
Praktyczne rady
- Zrób test rozpoznawalności bez oznaczeń. Usuń nazwę, logo i nazwę profilu. Sprawdź, czy treść nadal zawiera charakterystyczne elementy komunikacji marki.
- Uzupełnij opis odbiorcy o jego aspiracje. Obok potrzeb funkcjonalnych zapisz, kim chce być i do jakiej grupy chce należeć.
- Nadaj informacji konkretny kontekst. Przy historii firmy lub projektu pokaż sytuację wyjściową, motywację i znaczenie decyzji, zamiast ograniczać się do dat i deklaracji.
- Planuj powtórzenia kluczowych skojarzeń. Jednorazowe poruszenie tematu nie oznacza, że odbiorcy zdążyli powiązać go z marką.
- Przed publikacją odpowiedz na cztery pytania Blades. Pozwoli to połączyć temat treści z oczekiwanym skojarzeniem i kolejnym krokiem odbiorcy.
Knowledge bombs
1. Milion wyświetleń i zerowa rozpoznawalność marki to realny, częsty scenariusz.
Algorytm może wepchnąć treść przed oczy setek tysięcy osób, które jej nie wybrały i nic z niej nie zapamiętają. Blades opisuje własny viral na TikToku: zasięg trafił do ludzi, którzy chcieli się kłócić o rozstanie celebrytów, a nie do kogoś, kto chciałby ją śledzić. Zasięg mierzy ekspozycję, nie pamięć, zaufanie ani zakup.
„But the point is you can have 100,000 views or even a million views, whether that’s on Instagram, TikTok, the brand you work for, the marketing that you do or for you personally and people could still have zero brand recall with you.”
2. Nikt nie pamięta, ile polubień miała treść, po której kupił.
Test na sali: nikt nie potrafił powiedzieć, ile lajków miał post, który skłonił go do ostatniego zakupu. Wniosek dla marketera: polubienia i zaangażowanie karmią algorytm, ale o zakupie decyduje to, jak odbiorca się poczuł. Dlatego pytanie „jak zdobyć więcej wyświetleń” jest źle postawionym celem.
„When you saw a piece of content and then purchased off the bat, can anyone, and you can put your hands up if it’s a yes, can anyone remember how many likes that piece of content had?”
3. Uwaga to początek ścieżki klienta, nie jej koniec.
Celem nie są wyświetlenia, lecz to, żeby odbiorca zapamiętał markę, polecał ją i w końcu kupił. Algorytm wygrywa pierwszą bitwę o uwagę w hałaśliwym kanale, ale nie ma wpływu na to, czy ktoś zostanie i wróci. Metryki zasięgowe trzeba więc traktować jako wskaźnik wejścia, a nie wyniku.
„The goal that we want is we want people to remember you, advocate for you, about you and ultimately buy from you, right? […] Because attention is the beginning of the customer journey, not the end.”
4. Test marki: zabierz logo, nazwę i nazwę użytkownika i sprawdź, czy ktoś nadal cię rozpozna.
Blades przywołuje Adidas i Apple jako marki, które dałoby się rozpoznać po samej treści. Jeśli komunikacja bez identyfikacji wizualnej jest nieodróżnialna od konkurencji, algorytm może ją dystrybuować, ale nie zbuduje marki. Tę pracę wykonuje spójny charakter przekazu, nie zasięg.
„If I took away your name, logo, username, or whatever it is that you guys are using, whether you’re working in or with brands, would someone still know it was you?”
5. Uwagę zdobywa się przez kontrast, zaskoczenie, przerwanie wzorca i ciekawość, a nie przez głośność i częstotliwość.
Cztery źródła zatrzymania przewijania według Blades: kontrast (robić inaczej niż cała branża, np. poważnie tam, gdzie wszyscy są zabawni, albo kłótliwie tam, gdzie wszyscy są korporacyjni, jak Ryanair), zaskoczenie, przerwanie wzorca i ciekawość. Większa liczba chaotycznych postów nie przerywa nawyku przewijania.
„But attention isn’t just loud. Loud doesn’t just mean attention. So posting more and just being erratic with it doesn’t necessarily mean that you’re going to stop the scroll.”
6. Ludzie kupują to, co pasuje do tego, kim chcą być, więc przekaz, który ich obniża, nie sprzeda.
Zakup to „podniesienie tożsamości”: buty, które nosi biegacz, oznaczają „będę jak on”. Marki takie jak Apple, Chanel czy sieć klubów fitness David Lloyd sprzedają tożsamość (innowacyjny, mam gust, jestem zdyscyplinowany), nie produkt. Zadanie dla marketera: odpowiedzieć na pytanie „kim chce być mój klient” i odzwierciedlić to w komunikacji; przekaz, który degraduje odbiorcę, może dać zasięg, ale nie sprzedaż.
„People buy what matches what and who they believe they are or who they want to be.”
7. Ta sama informacja opowiedziana jako historia daje inny efekt emocjonalny, a więc inną pamięć.
Formuła Blades: informacja plus emocja równa się pamięć. „Założyłam firmę w 2020” i „siedziałam na podłodze sypialni z 200 funtami na koncie, kiedy wpadłam na ten pomysł” to ten sam fakt, ale tylko drugi wywołuje reakcję, buduje zaufanie i skłania do podzielenia się z innymi. Czysto informacyjna treść jest poprawna i zapominalna.
„So same information, different emotional experience. One story is going to make you just scroll and one is going to make you feel something.”
8. Jednorazowa publikacja nie buduje pamięci; Apple mówi o iPhonie niemal codziennie.
Najczęstsza obiekcja klientów i studentów brzmi „przecież już to raz zrobiłem”. Pamięć marki zakotwicza powtarzanie tego samego przekazu, emocji i misji przez długi czas, a nie pojedynczy viral. Formuła pamięci według Blades to emocja, trafność względem marki i powtarzanie.
„Repetition. We can’t expect, and I hear this from students and clients all the time, oh, but I did that once. Repetition is going to then anchor it in over and over again.”
Zdjęcia: Chloe Blades
2 kadrów · Fot. Robert Nowaczyk
Giulia Panozzo: Decision Distance
16:10
Streszczenie
Giulia Panozzo przedstawiła decision distance, czyli dystans decyzyjny: różnicę między tym, co skłania odbiorcę do wyboru, a tym, co marka komunikuje na poszczególnych etapach jego ścieżki.
Zaproponowała uzupełnienie raportowania SEO (Search Engine Optimization / optymalizacja dla wyszukiwarek) o analizę dopasowania komunikacji do motywacji klientów. Pokazała metodę porównywania języka odbiorców z językiem marki za pomocą sentence embeddings, czyli numerycznych reprezentacji znaczenia zdań, oraz podobieństwa semantycznego.
Główna teza wystąpienia: widoczność pomaga wejść do zbioru rozważanych opcji, ale nie zastępuje powodów, dla których klient miałby wybrać właśnie nas.
Najważniejsze wnioski
Obserwacja dotycząca pomiaru: kliknięcia, konwersje i wyjścia ze strony pokazują zachowanie, ale same nie wyjaśniają jego przyczyn. Widoczność również nie mówi, czy komunikacja odpowiedziała na obawy i oczekiwania odbiorcy.
Obserwacja dotycząca ścieżki zakupowej: systemy AI (Artificial Intelligence / sztuczna inteligencja) mogą porównywać i zawężać opcje przed wizytą użytkownika na stronie. Część oceny oferty odbywa się więc poza obszarem widocznym w analityce witryny.
Autorski model prelegentki: dystans decyzyjny rośnie, gdy marka podkreśla inne argumenty niż te, których potrzebuje odbiorca. Przykładem była komunikacja funkcji oprogramowania wobec zapytań wskazujących na potrzebę bezpieczeństwa i zaufania.
Charakter proponowanej metody: podobieństwo języka pozwala szacować dopasowanie komunikacji do zdefiniowanych motywacji. Nie jest bezpośrednim pomiarem procesów psychologicznych. Panozzo zaznaczyła, że wynik zależał m.in. od definicji analizowanych motywacji.
Postulat strategiczny prelegentki: tradycyjne metryki należy uzupełnić, a nie odrzucić. Dopasowanie do motywacji klientów przedstawiła jako potencjalną przewagę w wyszukiwaniu agentowym, w którym system wykonuje część poszukiwań i oceny za użytkownika.
Dane liczbowe i przykłady
Liczby w prezentacji opisywały model i ilustracje, nie wyniki wdrożenia:
- 3 grupy czynników wpływających na wybór: funkcjonalne, społeczne i emocjonalne.
- 4 główne etapy pracy: profil odbiorców, profil komunikacji marki, porównanie luk, działania zmniejszające rozbieżności.
- 500 integracji: element przykładowej makiety strony oprogramowania. Ilustrował komunikację skoncentrowaną na funkcjach, nie rezultat badania.
- 1 rekomendowana para butów: w pokazanym przykładzie asystent uwzględnił wcześniej znany kontekst dotyczący prelegentki. Była to ilustracja personalizacji rekomendacji, nie dowód na działanie wszystkich systemów w ten sam sposób.
Praktyczne rady
- Najpierw zdefiniuj motywacje. Ustal, co w analizie oznaczają zaufanie, jakość, wygoda, wartość czy dowód społeczny. Te definicje będą punktami odniesienia dla porównania języka.
- Połącz dane z kilku źródeł. Oprócz zapytań wykorzystaj wyszukiwarkę wewnętrzną, wywiady z klientami i dane z CRM (Customer Relationship Management / system zarządzania relacjami z klientami).
- Analizuj komunikację szerzej niż samą treść poradnikową. Uwzględnij strony produktowe, reklamy, strony docelowe, artykuły i propozycje wartości.
- Porównuj motywacje na odpowiednich etapach ścieżki. Argument potrzebny do zainteresowania ofertą nie musi być tym samym, który pomaga podjąć ostateczną decyzję.
- Traktuj luki jako wskazówki do działań międzyzespołowych. Problem może dotyczyć komunikacji, ale jego rozwiązanie nie musi ograniczać się do redakcji tekstu.
Knowledge bombs
1. Wszystkie metryki SEO, stare i nowe, mierzą skutek decyzji, która już zapadła.
Rankingi, CTR, konwersje, wzmianki o marce, cytowania w AI: każda z nich pojawia się w analityce dopiero wtedy, gdy człowiek lub agent dokonał już wyboru. Klik mówi, że ktoś kliknął, odrzucenie mówi, że ktoś wyszedł, ale żadna nie mówi, dlaczego jeden wynik był bardziej przekonujący ani jaka potrzeba nie została zaspokojona. Panozzo nazywa to „dużym martwym punktem”, który istniał zawsze, a AI go tylko powiększyło.
„And actually, by the time they’re measured, they’re already old. They measure the outcome of a decision that has already been taken.”
2. ChatGPT filtruje opcje z użyciem ludzkich błędów poznawczych, zanim użytkownik zobaczy stronę.
Kiedyś użytkownik otwierał dziesięć kart i sam porównywał; dziś system AI streszcza i zawęża opcje przed wizytą, dokładając własne kryteria (historia zakupów, styl). Według Panozzo są dowody, że ChatGPT wykorzystuje efekt świeżości i pierwszeństwa. Marketer traci warstwę widoczności w to, jak ludzie wybierają, bo część decyzji zapada poza serwisem i poza narzędziami.
„So there is evidence, actually, that ChargerPT is working with some of this existing bias that we use normally to make decisions, like recency and primacy.”
3. Kategoria wprowadza markę do rozmowy, ale o wpływie decyduje powód wyboru.
Na prośbę o polecenie butów ChatGPT zwrócił jedną opcję, dopasowaną do wcześniejszych zakupów i stylu, których użytkowniczka nie podawała w zapytaniu. Dopasowanie do kategorii zapytania to warunek wejścia; żeby użytkownik kontynuował ścieżkę, marka musi od początku spełniać kryteria, na których agent i człowiek opierają ocenę.
„So now category gets you into the conversation, but it’s the reason behind the choice that gets you, that influence, needed for the user to carry on with their journey.”
4. Bycie łatwym do pobrania przez AI i bycie wartym wyboru przez człowieka to dwa różne problemy.
Branża dołożyła nową warstwę pomiaru (widoczność w AI, cytowania) i pomyliła ją z celem. Marka widoczna, ale niedostarczająca tego, czego użytkownik potrzebuje do wyboru, ma ten sam problem co wcześniej. Tradycyjne wyszukiwanie nagradzało dopasowanie do zapytania; wyszukiwanie agentowe nagradza dopasowanie do tego, co faktycznie napędza decyzję.
„We added an entire new measurement layer, but we have forgotten that being visible and being easy to retrieve for an AI system is fundamentally not the same challenge and not the same problem as worth being chosen by a human.”
5. Dystans decyzyjny to odległość między tym, co napędza wybór, a tym, co marka komunikuje na każdym etapie ścieżki.
Im większy dystans, tym większe tarcie: użytkownik lub agent nie uzasadni czasu na ocenę nieznanej marki, która nie odpowiada wprost jego potrzebom. Ludzie jako „istoty wygody” nie robią gimnastyki umysłowej, żeby dopasować niejasną ofertę do swoich wymagań, tylko wybierają opcję z mniejszym tarciem. Konwersja wynika nie z treści samej w sobie, lecz z tego, co treść przekazuje w ocenie, którą odbiorca i tak już robił.
„Decision distance is the distance between what drives a choice and what the brand communicates at every stage of the journey.”
6. Zapytania fan-out zdradzają, czego szuka agent, a strona główna często odpowiada na coś innego.
Przykład SaaS: zapytania składowe generowane przez AI dotyczą bezpieczeństwa danych, zgodności z regulacjami, reputacji dostawcy i due diligence, czyli zaufania i bezpieczeństwa. Strona główna mówi o „potężnych funkcjach, 500 integracjach i dashboardach”. To rozbieżność między motywacją odbiorcy a pozycjonowaniem opartym na funkcjach; strona główna jest pierwszym, co widzi człowiek i agent, więc tam dystans trzeba domykać najpierw.
„All of these, to me, tell me something. They tell me that the audience or the agent is looking for trust and safety. That’s one of the core drivers.”
7. Dystans decyzyjny da się policzyć: osadzenia zdań i podobieństwo semantyczne między językiem odbiorców a językiem marki.
Procedura w czterech krokach: najpierw zdefiniować zestaw motywacji (jakość, dowód społeczny, zaufanie, wygoda, wartość) i opisać je precyzyjnie, bo definicje są punktem odniesienia dla całej analizy; potem zbudować profil odbiorców z danych z wyszukiwania, CRM, wyszukiwarki wewnętrznej i wywiadów; następnie ten sam profil dla marki z podstron produktowych, reklam, propozycji wartości i artykułów; na końcu porównać oba profile i wskazać motywacje, które odbiorcy podkreślają, a marka niedoreprezentuje. Wynik jest orientacyjny i zależy od definicji motywacji.
„I use sentence embeddings and semantic similarity to estimate. Drivers from the audience language and then from your own language as a brand.”
8. Motywacje zmieniają się wzdłuż ścieżki: na etapie świadomości wygoda, zaufanie i jakość, przy zakupie dowód społeczny, status i wartość.
Na podstawie źródła języka (np. typ zapytania) można przypisać motywacje do etapu ścieżki. To, co przekonuje kogoś do dalszego rozważania na początku, nie jest tym, czego potrzebuje, gdy jest gotów się zobowiązać; jeden komunikat na wszystkie etapy zwiększa dystans przynajmniej na jednym z nich.
„for example, in the stage of awareness, convenience, trust, and quality seem to be the drivers that are most likely to come up and the most prominent. Whereas, when it comes to the purchase stage, then we have social proof. We have status, curiosity. We’ve got value that come up quite a lot.”
Zdjęcia: Giulia Panozzo
5 kadrów · Fot. Robert Nowaczyk