Program dnia
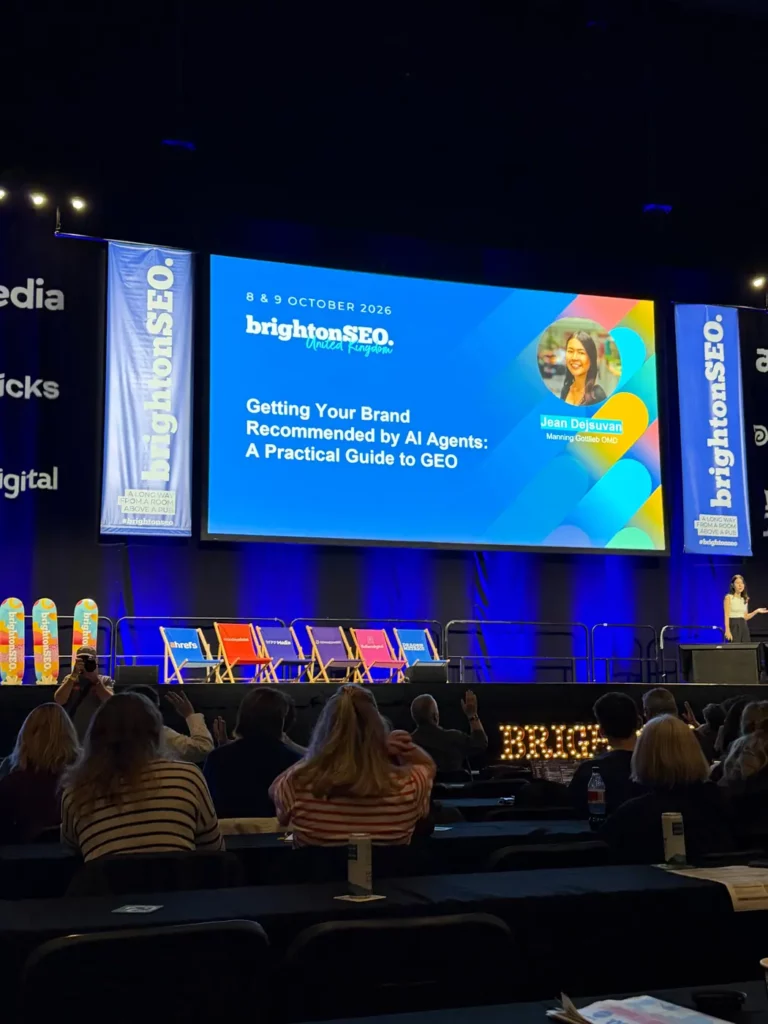
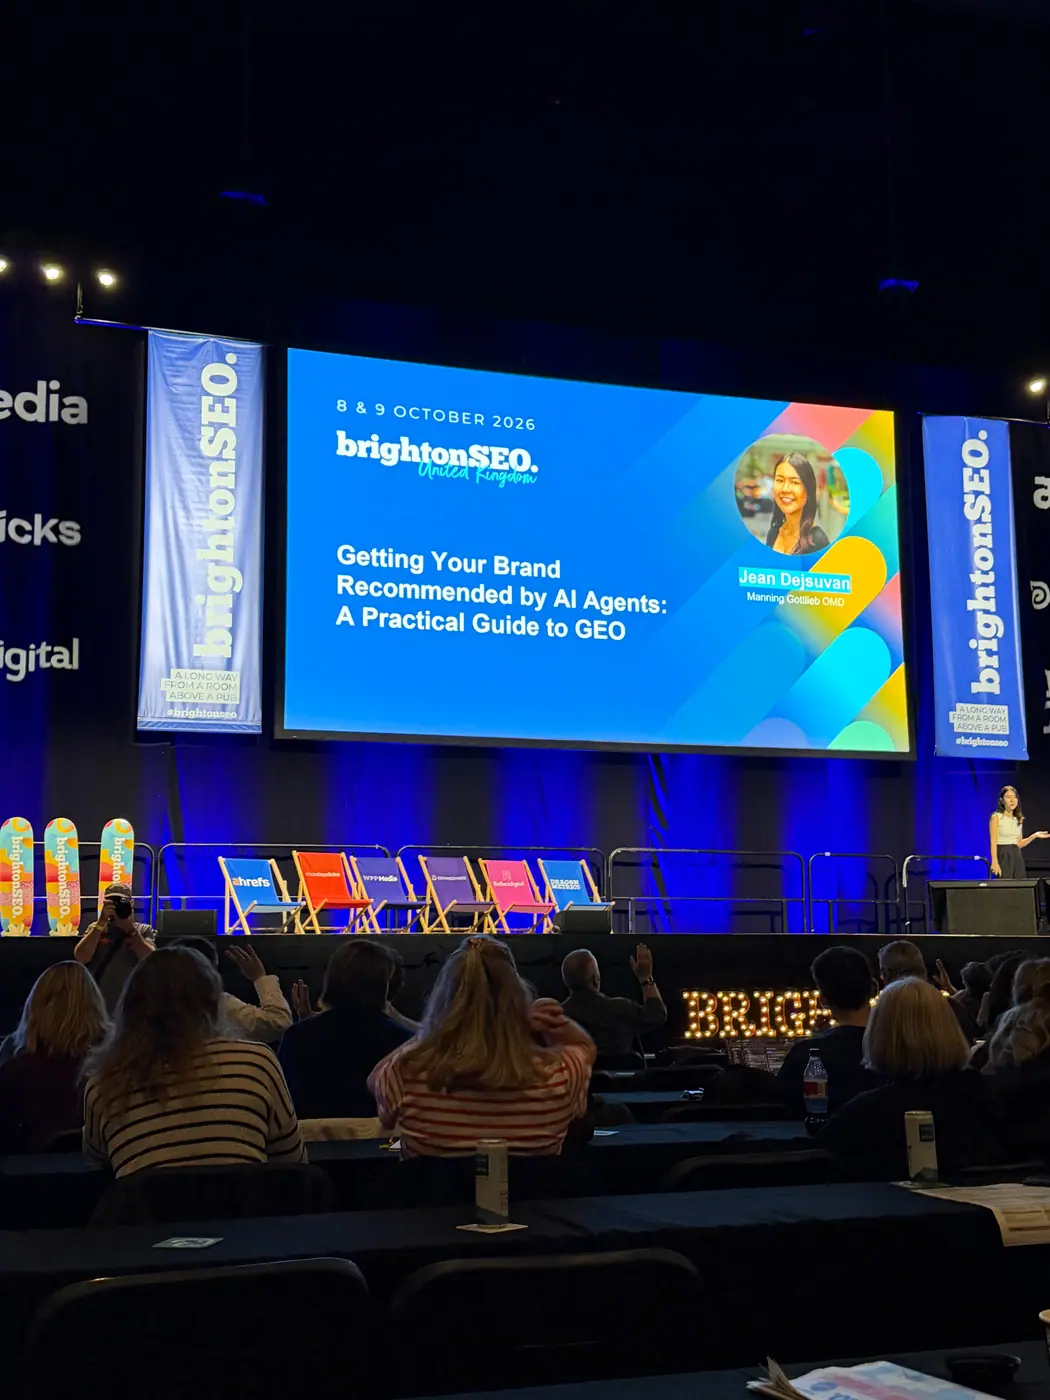
- 09:30 – Jean Sarunporn: Getting Your Brand Recommended by AI Agents: A Practical Guide to GEO
- 09:50 – Paris Childress: Information Gain: The Missing Metric in Every GEO Content Strategy?
- 10:10 – Samanyou Garg: Drowning in prompts? How to build an AEO program around the data that matters
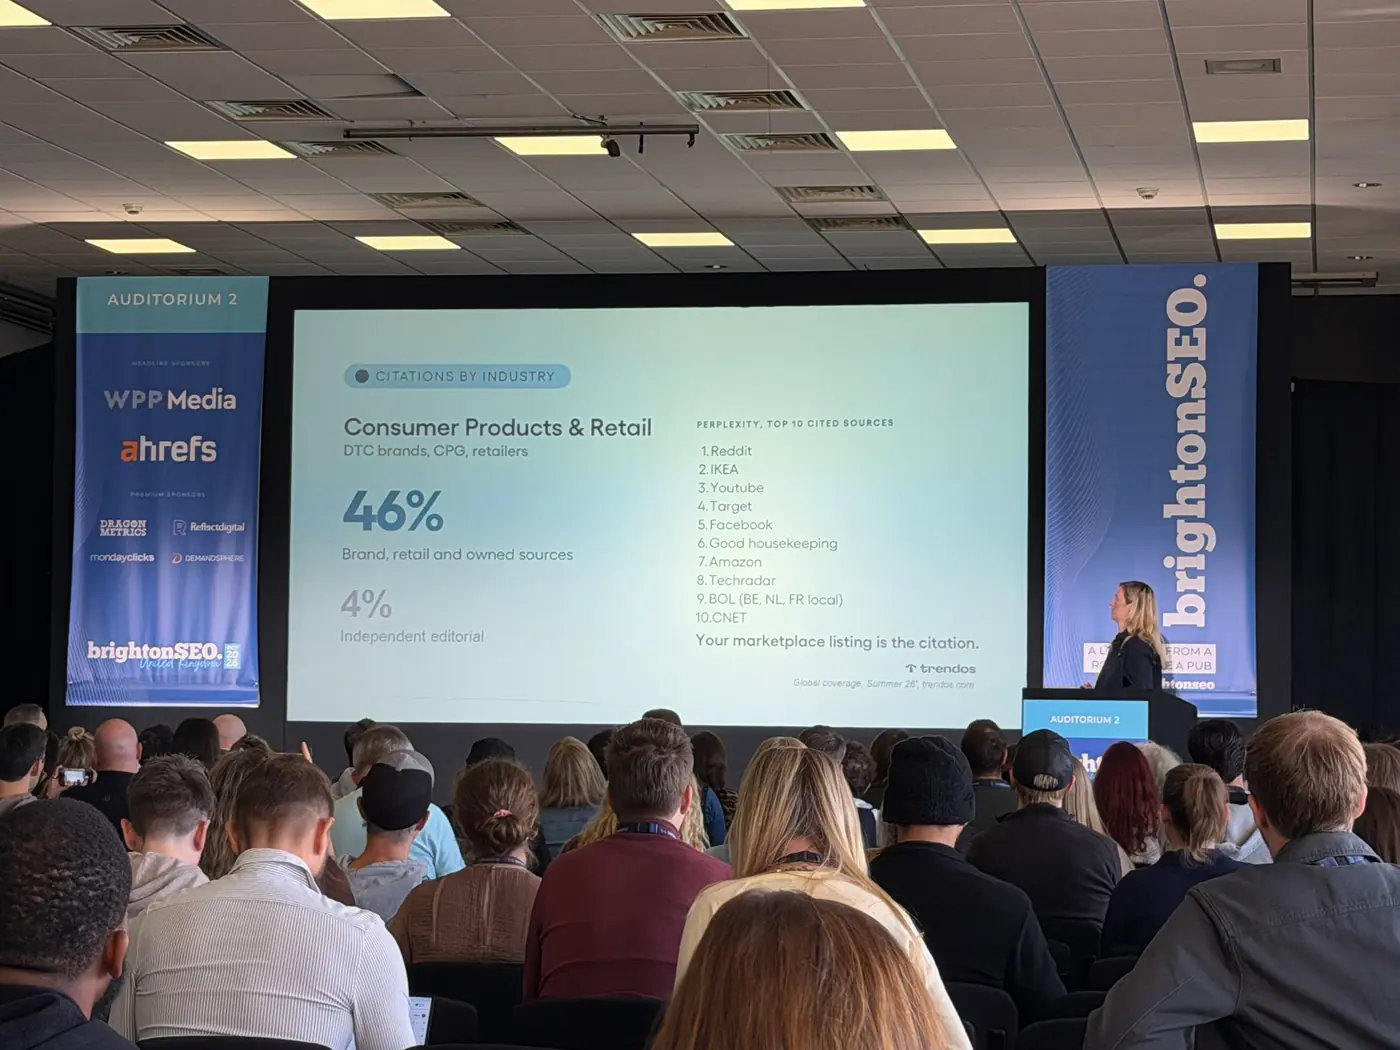
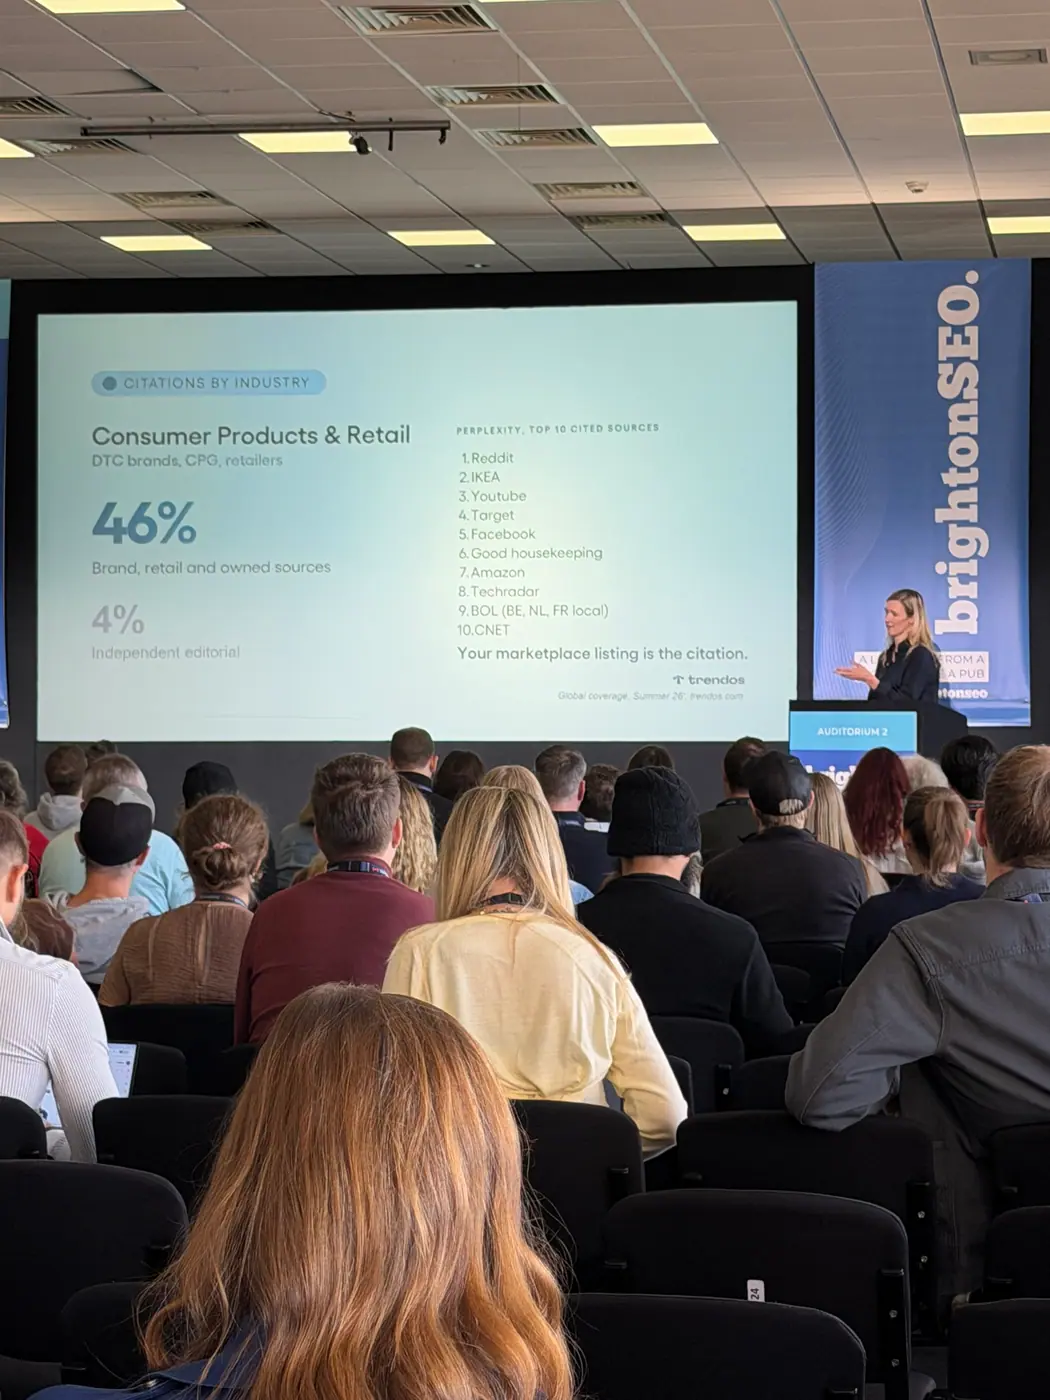
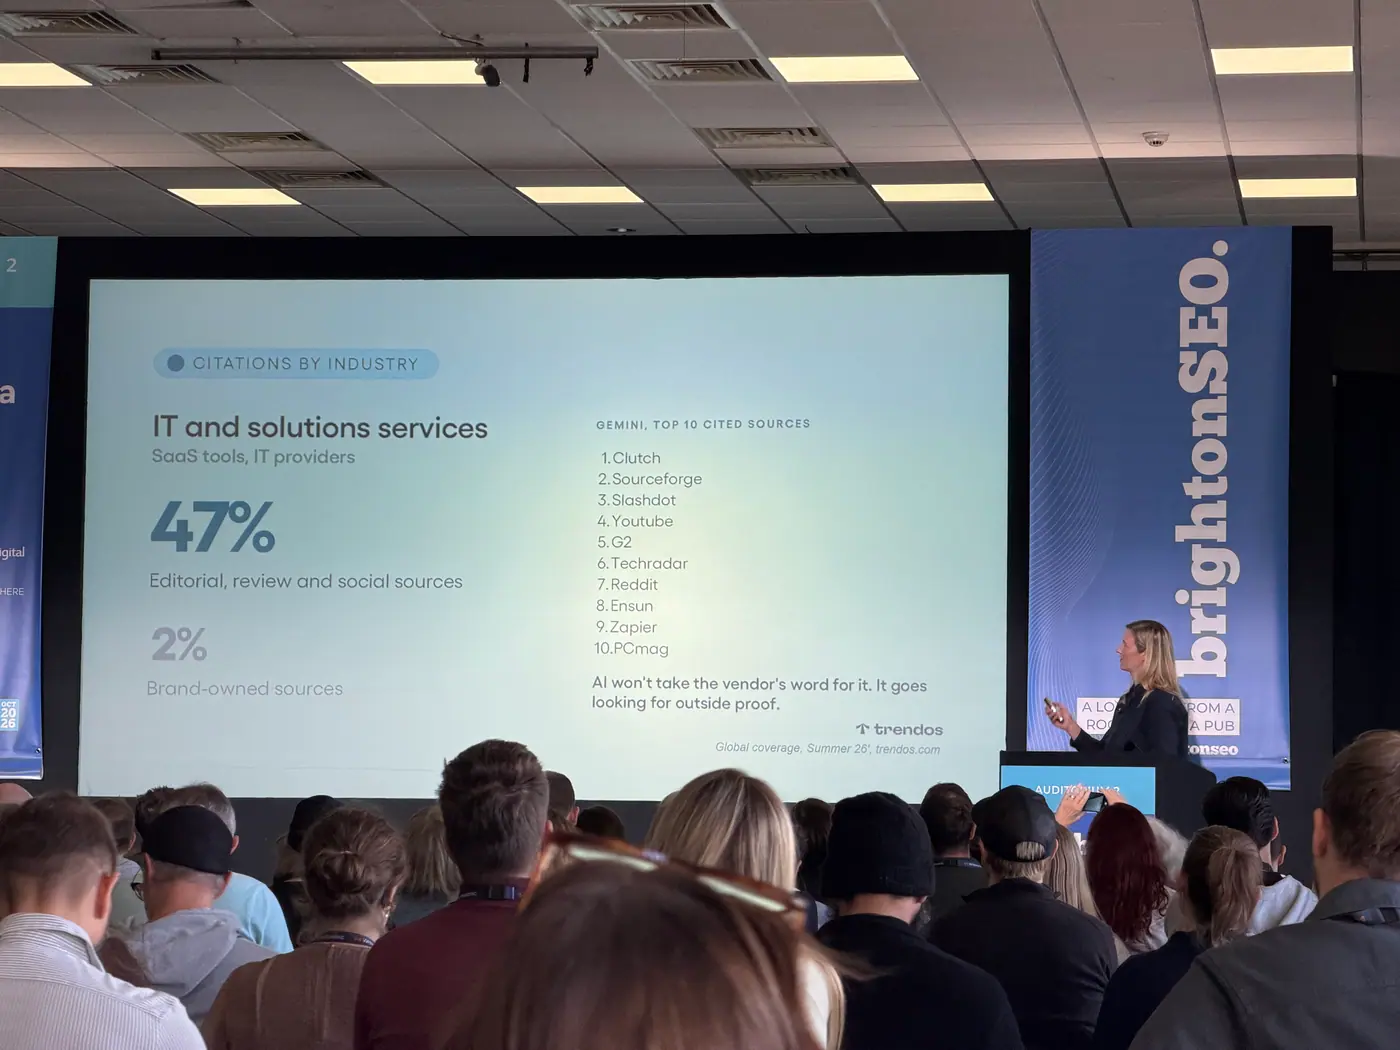
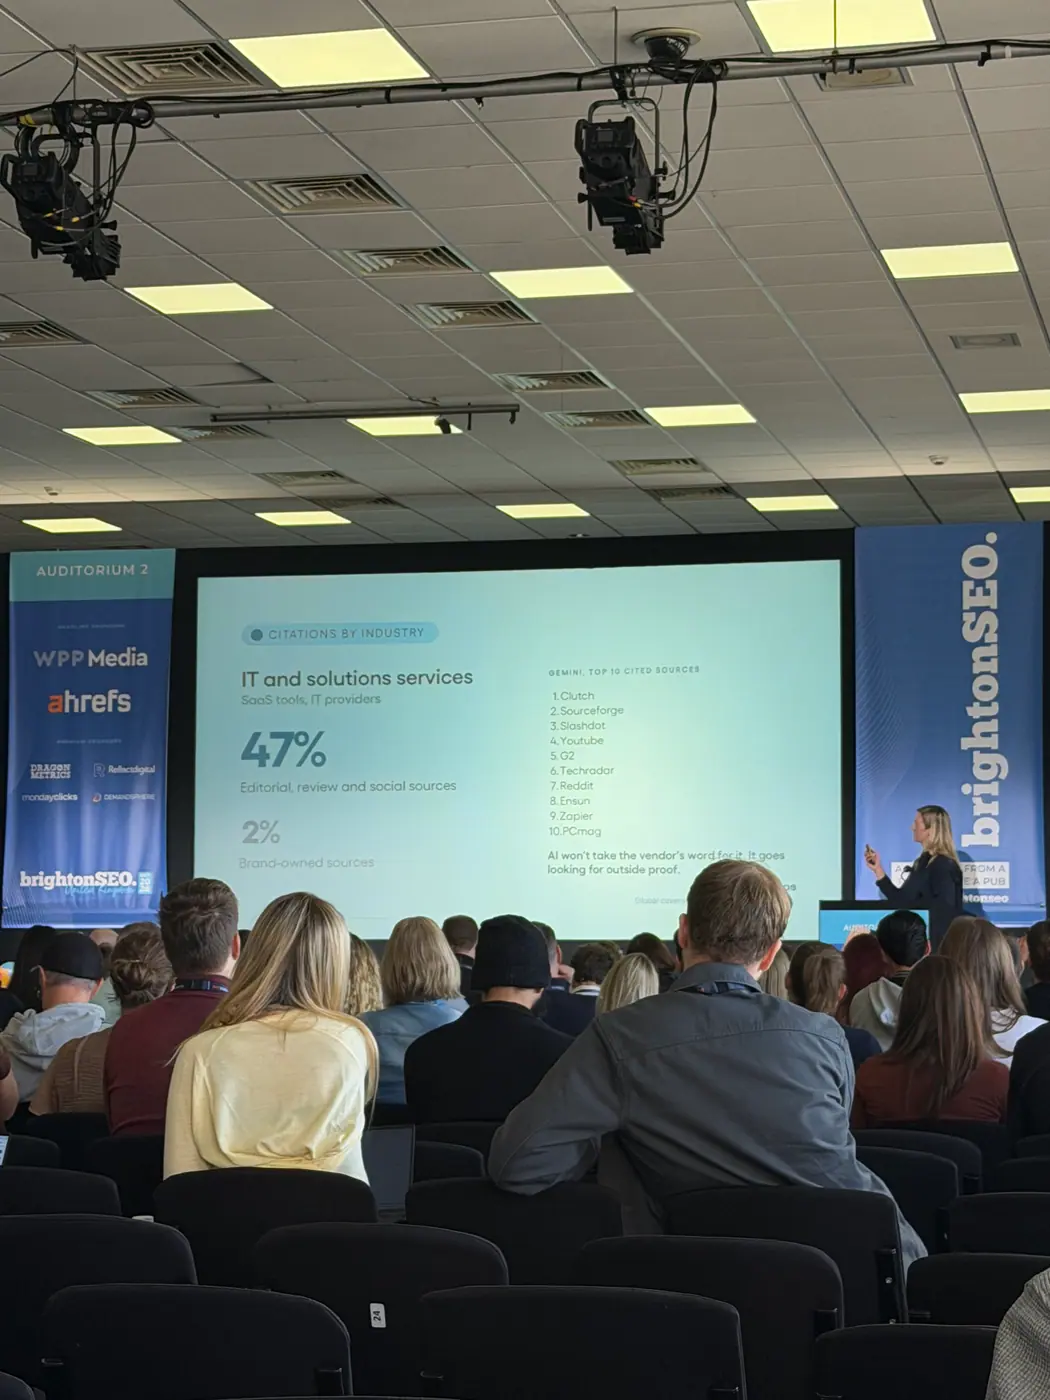
- 10:30 – Gintarė Rimolaitytė: Who AI Cites Now: How Source Patterns Shifted Since December 2025
- 11:20 – Christian Goodrich: How Claude Code Helped Me Transform Reporting and Delivery for AI Search and SEO
- 11:40 – Shoaib Ahmed: The Future of B2B Marketing: The LinkedIn Social Selling & Personal Brand Matrix
- 12:00 – Christian Rigg: Best of Both Worlds: AI Content Systems with True Human EEAT
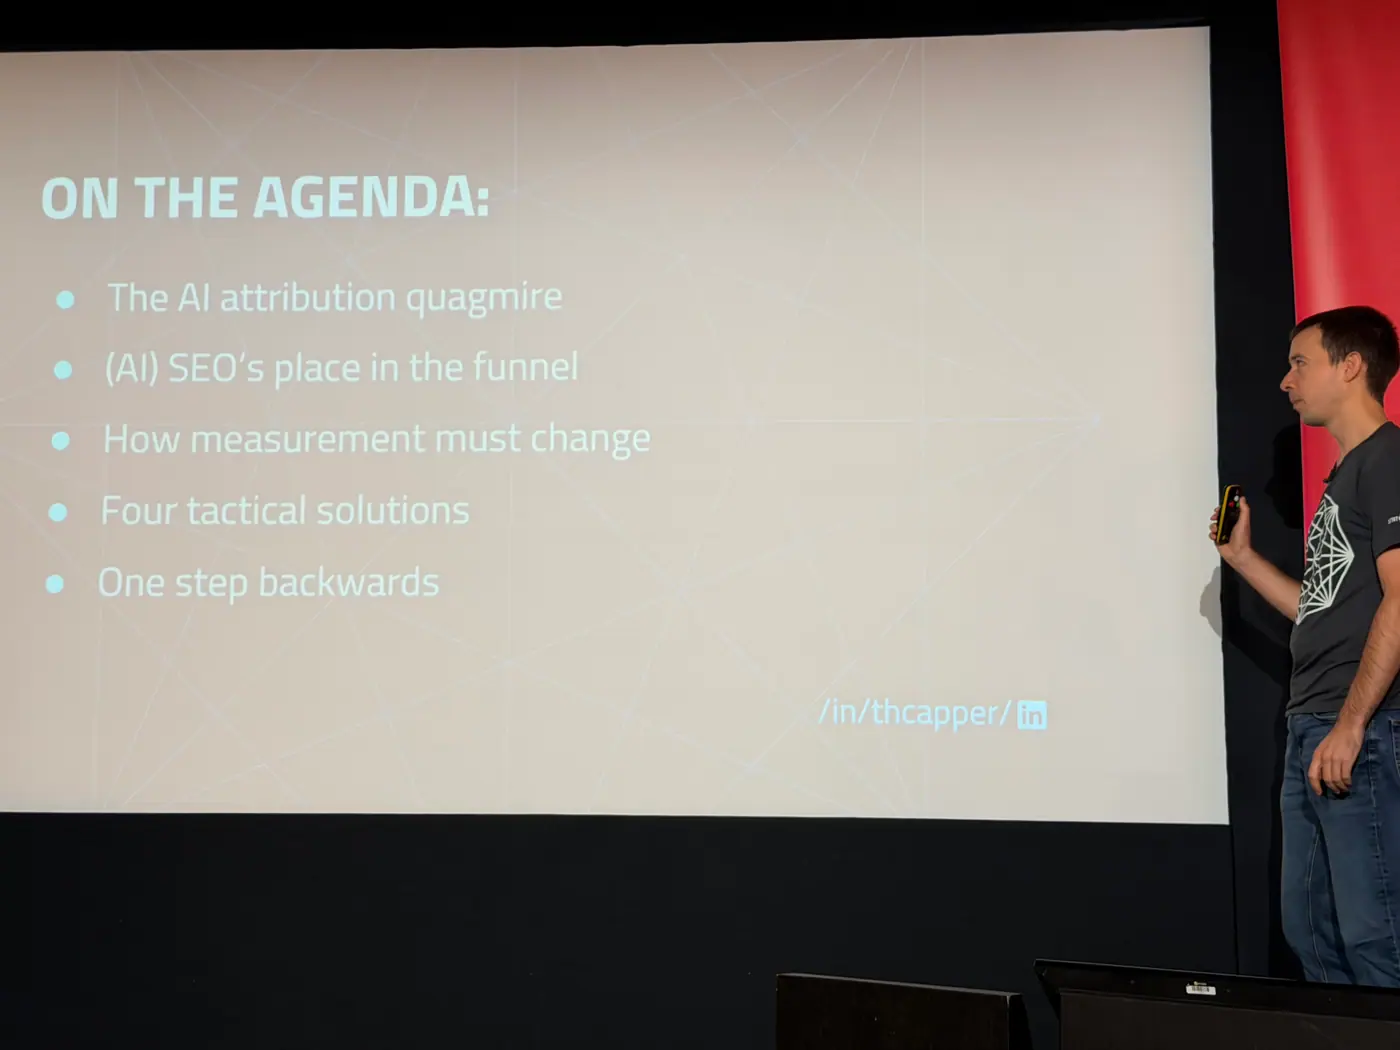
- 12:20 – Tom Capper: How not to measure AI
- 14:00 – Jeremy McDonald: From Gut Checks to Guardrails: Deploying Trustworthy AI for Marketing QA
- 14:20 – Gus Pelogia: When MCP Servers are (and aren’t) the Right Choice
- 14:20 – Sam Page: Win at Local AEO: The Wild West of AI Search
- 14:40 – Abbie Dando: From Query to Sale: Engineering Search Journeys That Convert
- 15:30 – Christian Hustle: AEO/GEO Myths Busters: 5 things you can really do to drive your conversion & more traffic to your store
- 15:50 – Jessica Hulbert: Stop Training Links, Start Training AI: Your Guide For E-E-A-T First Digital PR
- 16:10 – Jane Hunt: Prove It: A Digital PR Playbook for Winning AI Citations and Reporting GEO Impact
- 17:00 – John Iwuozor: 5 Things Google Patents Reveal About Why SEO Feels Harder in 2026
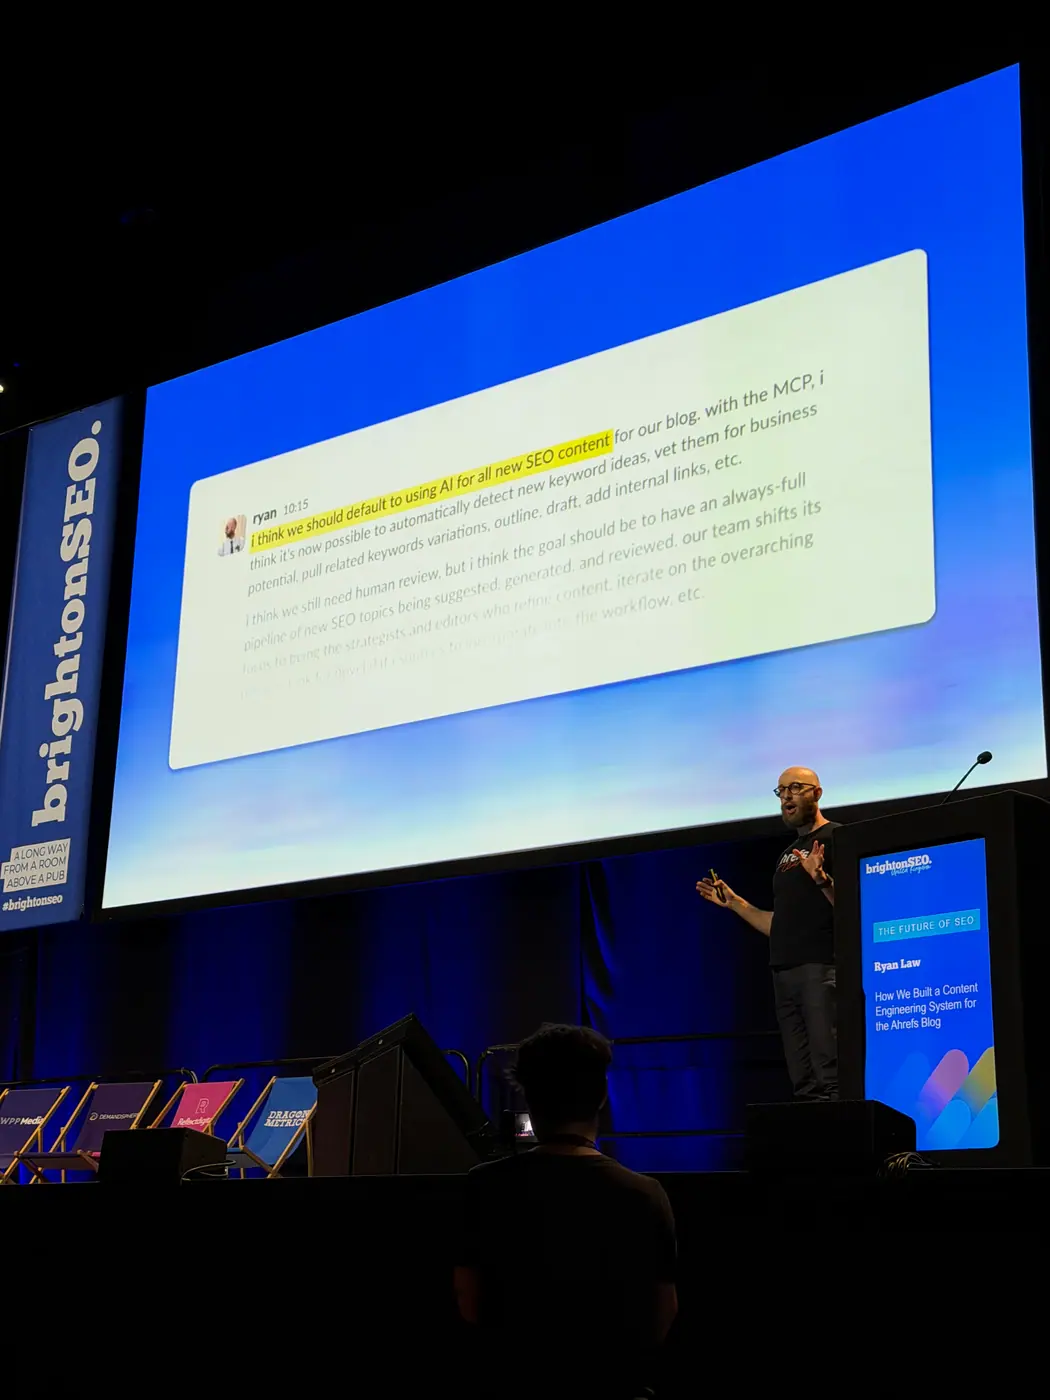
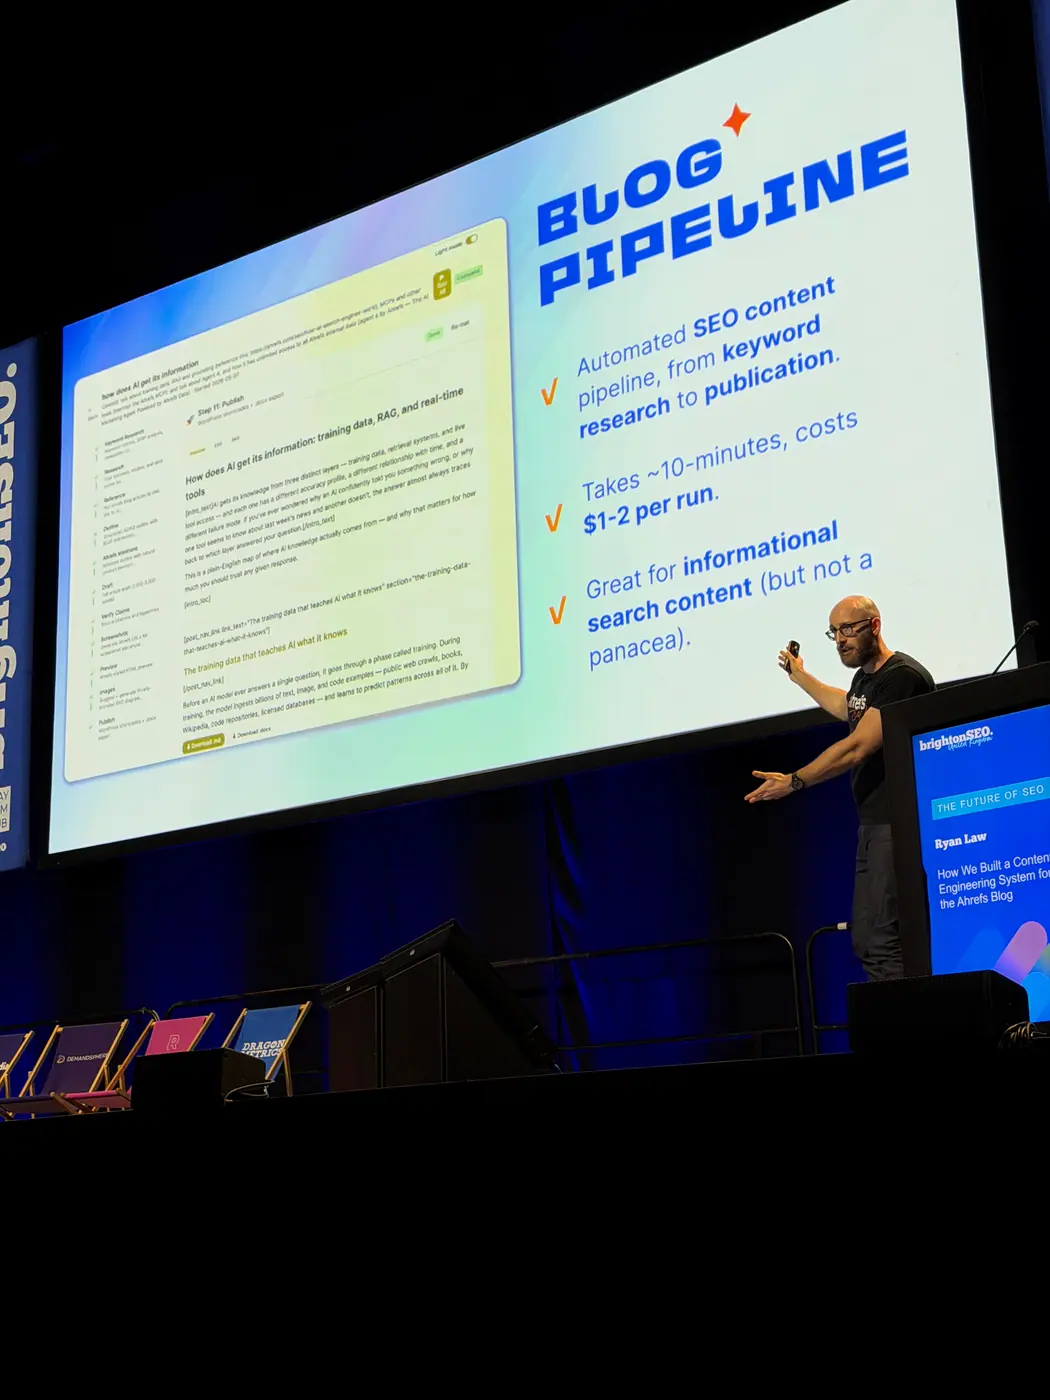
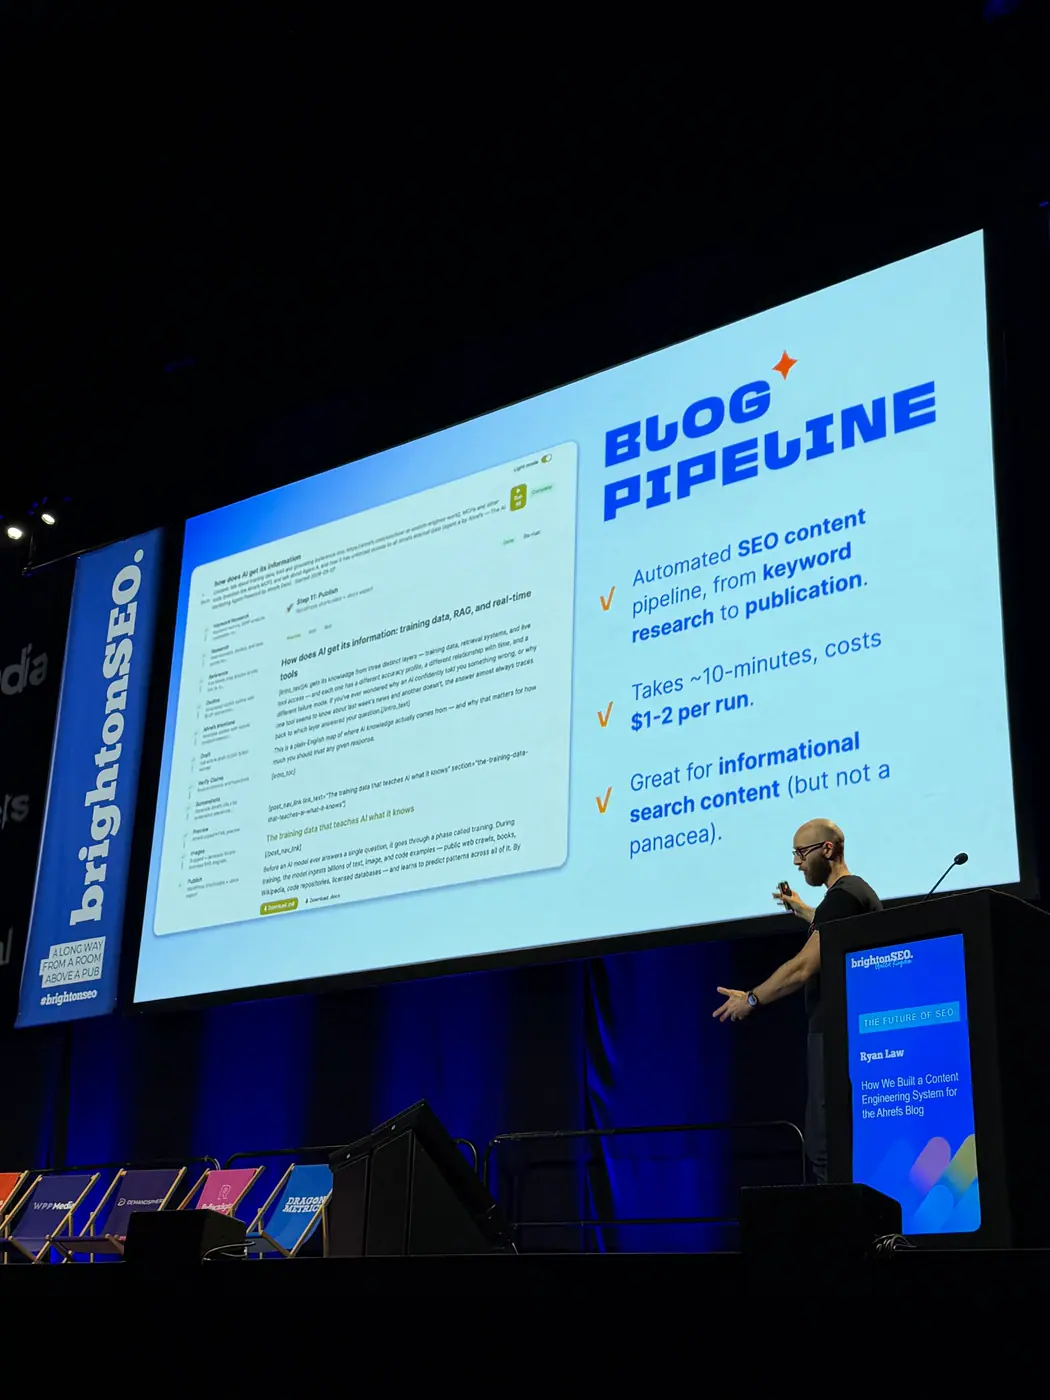
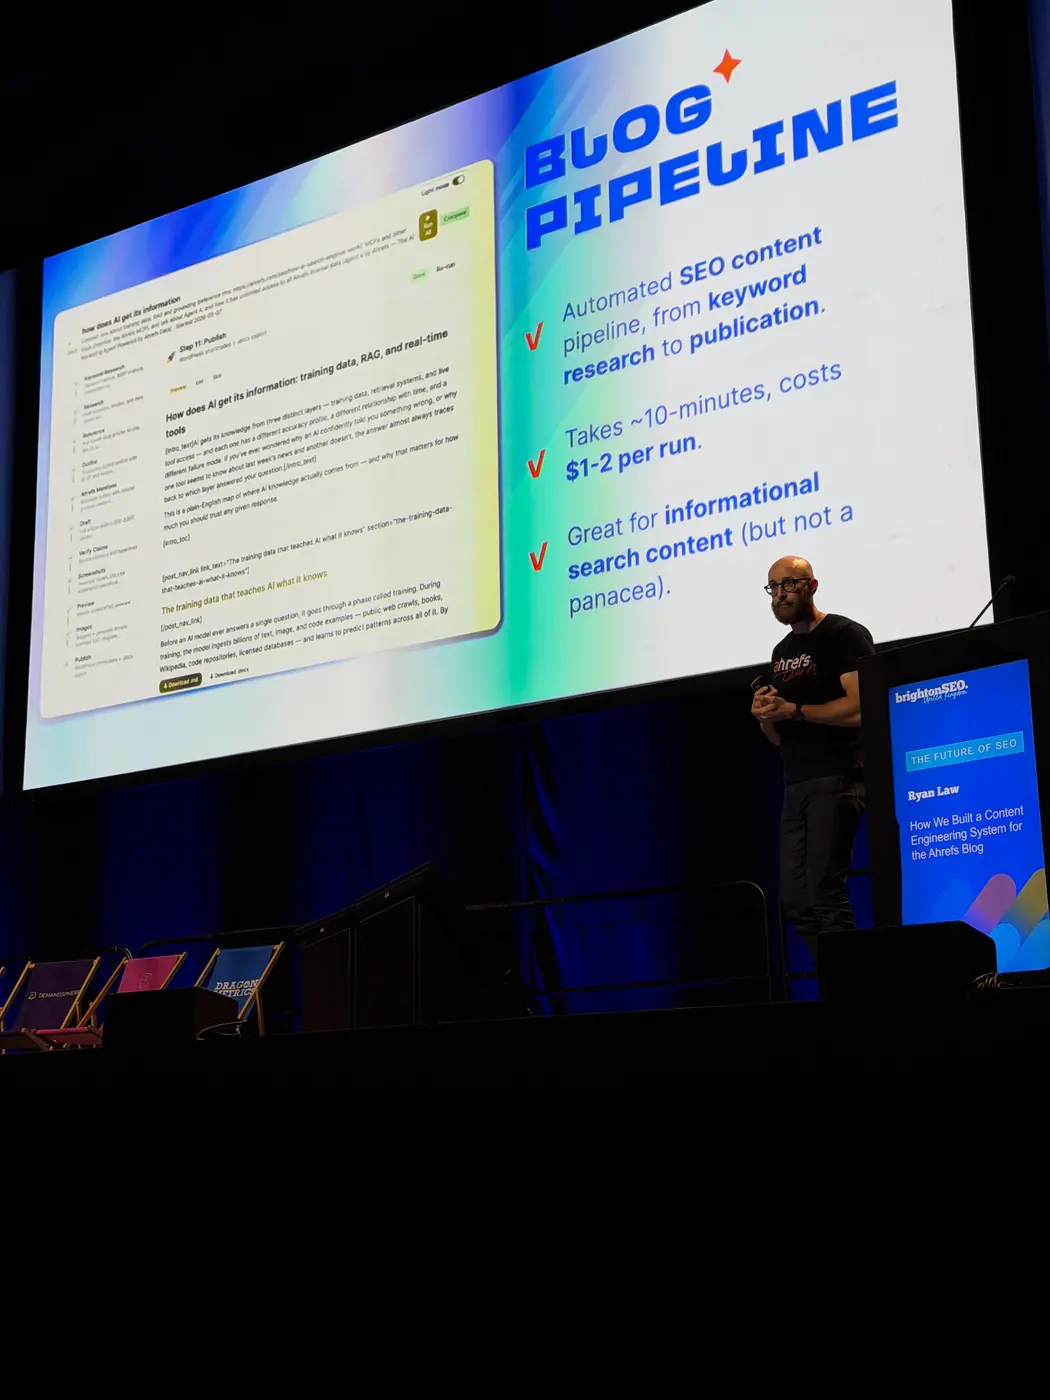
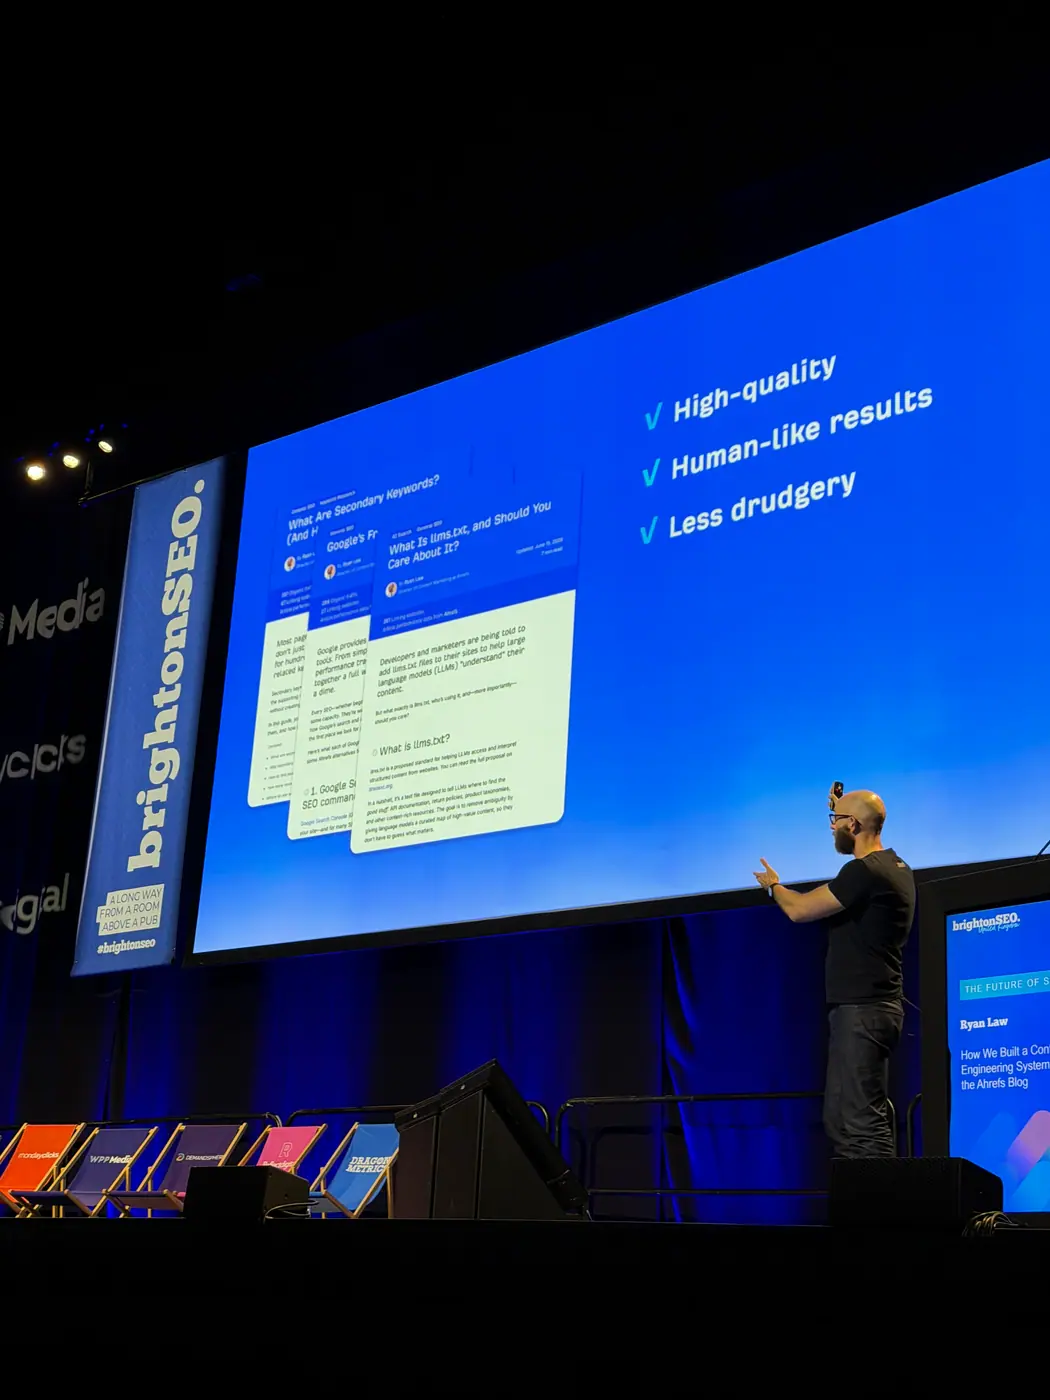
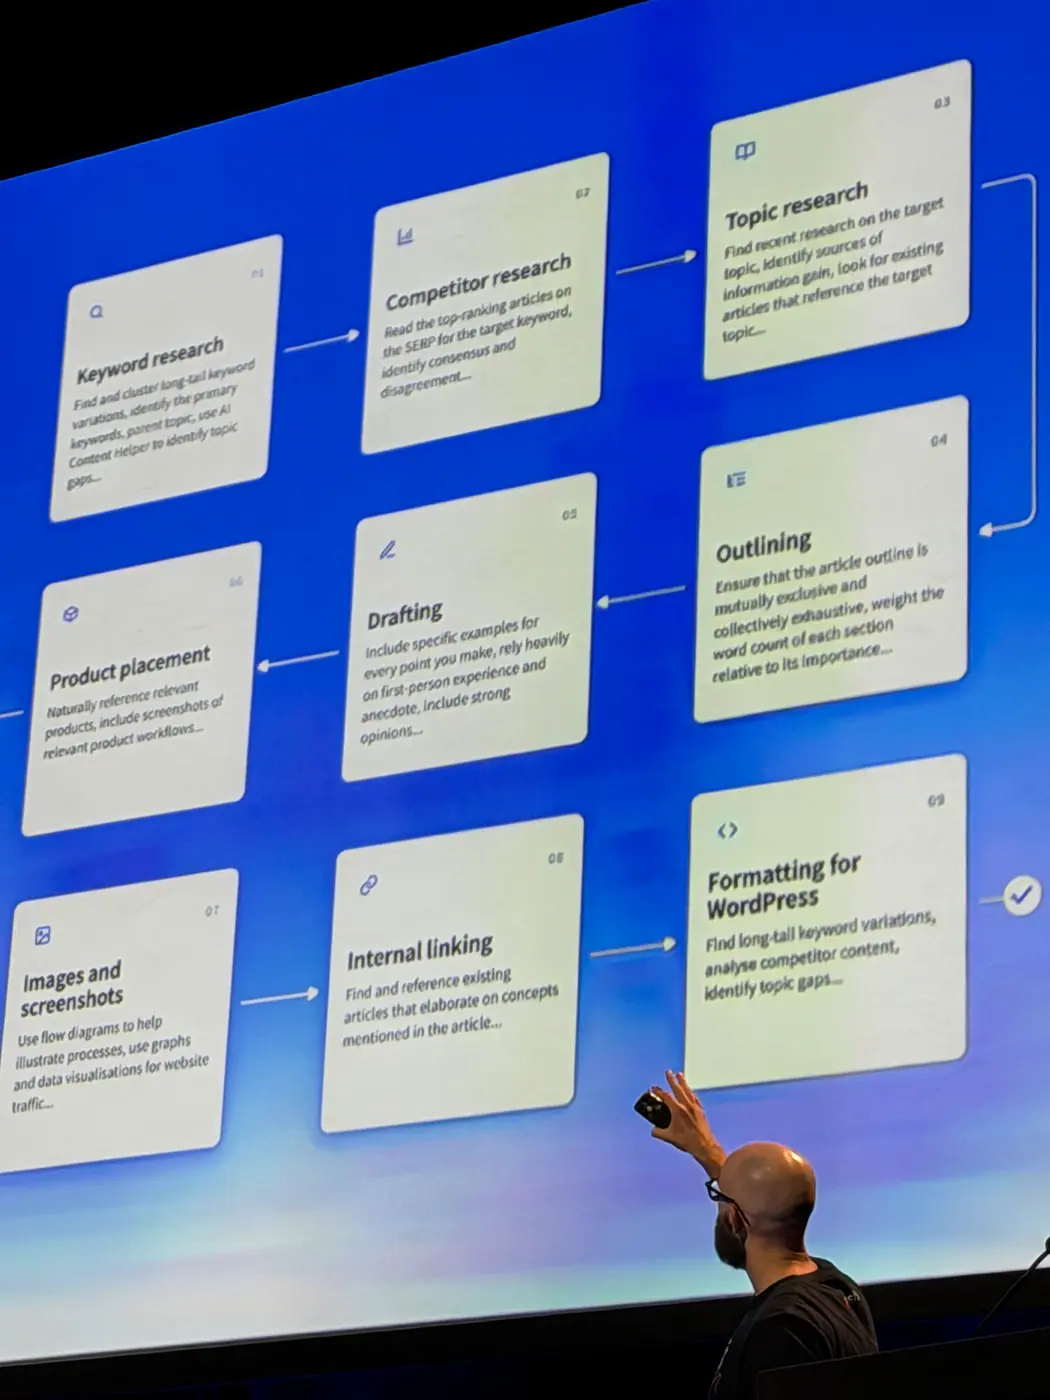
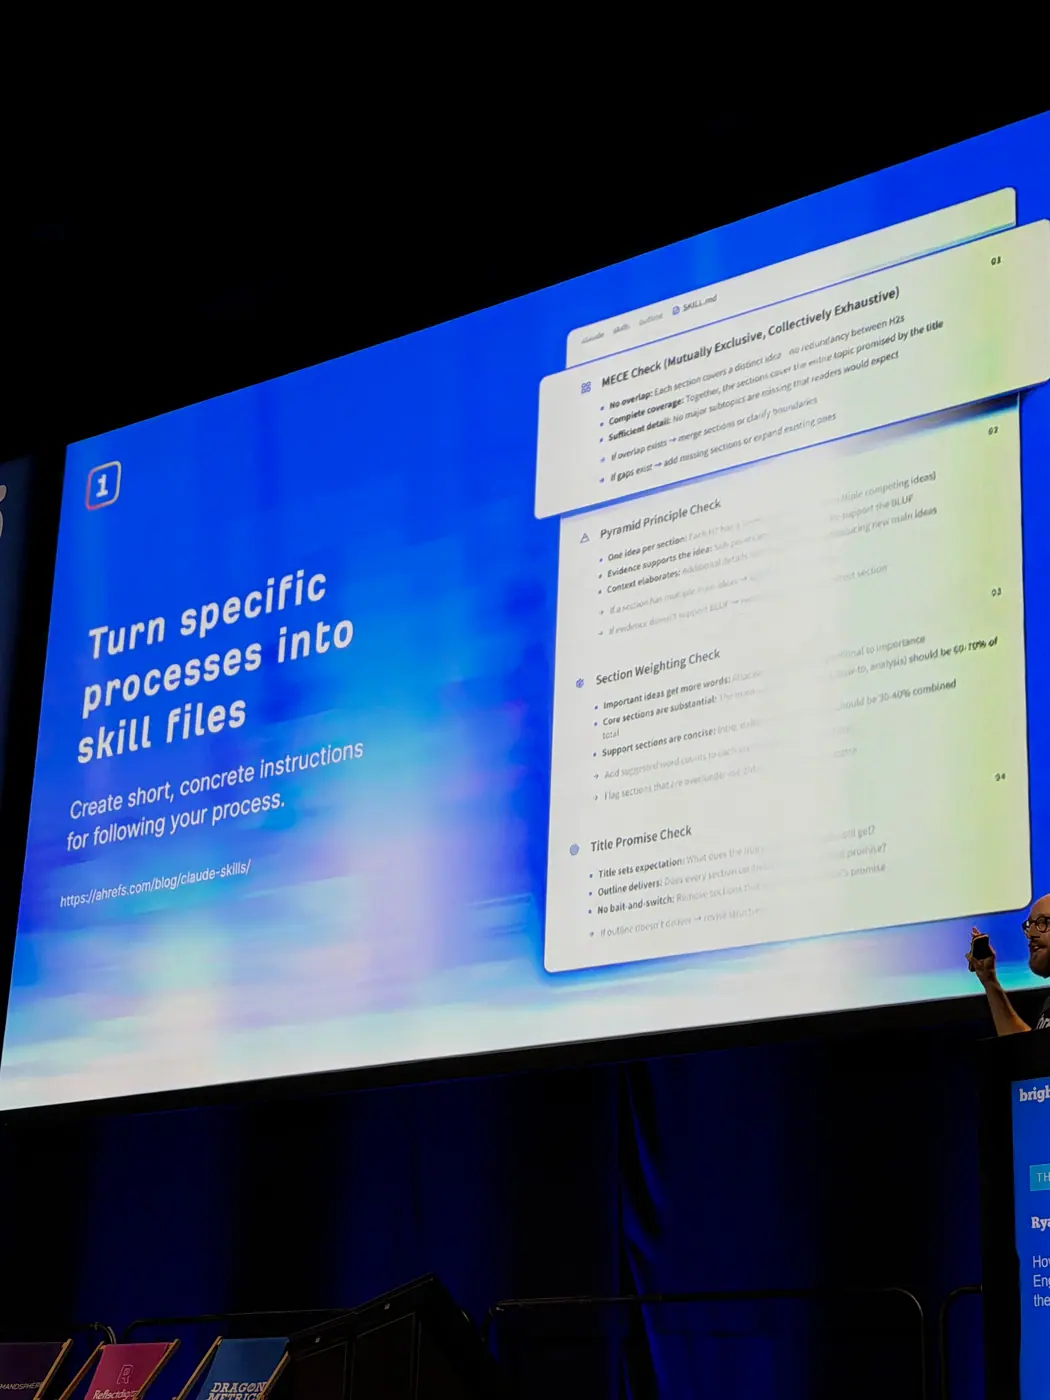
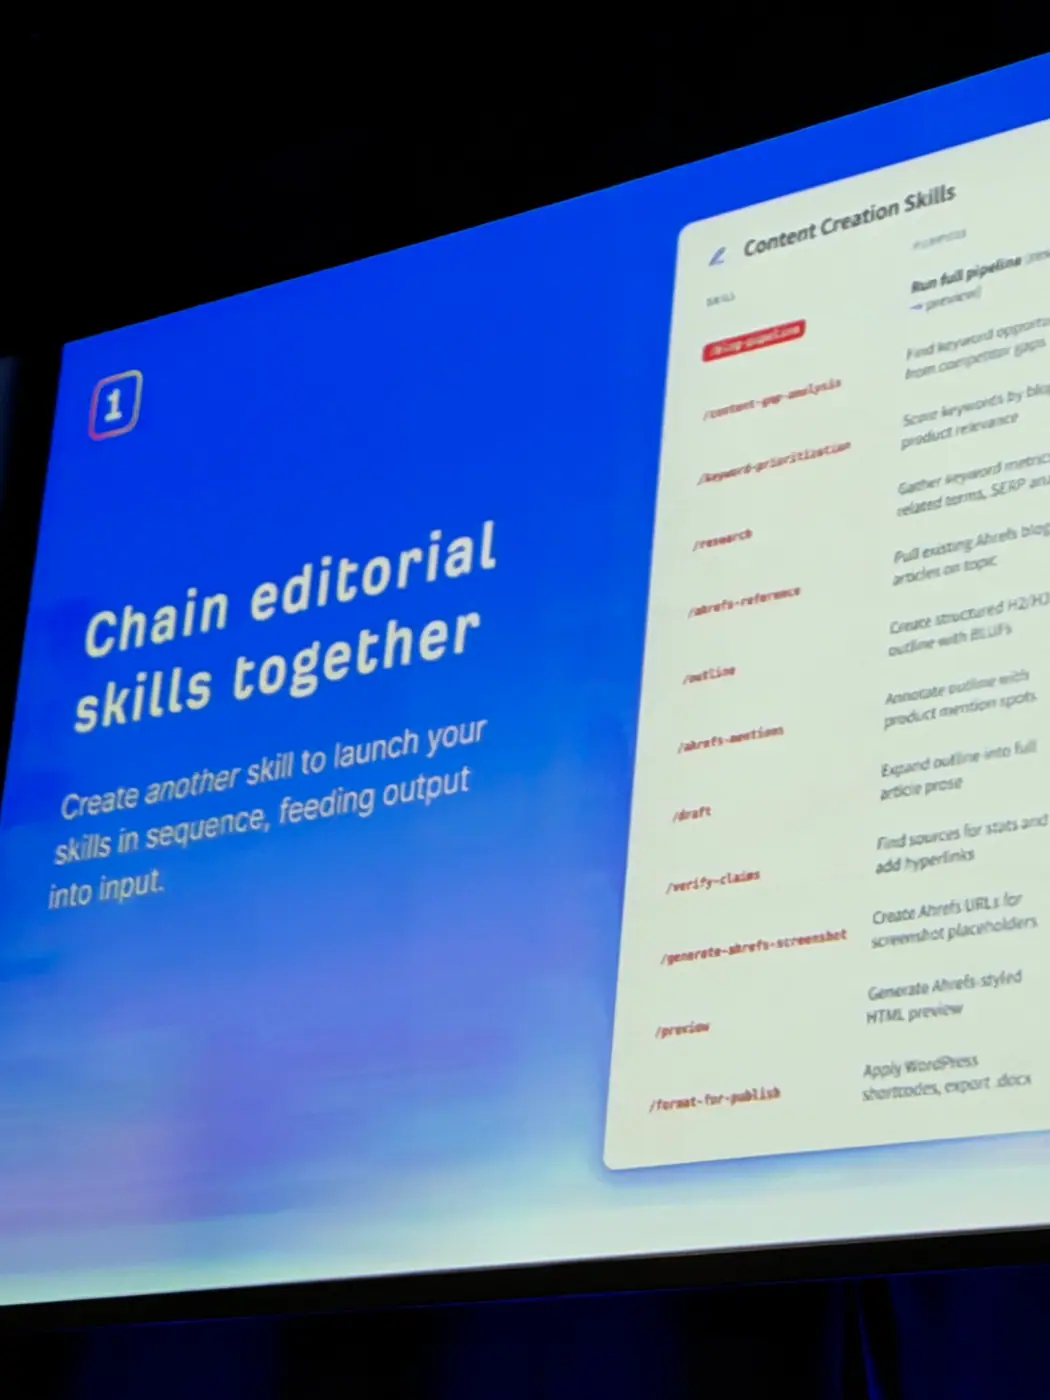
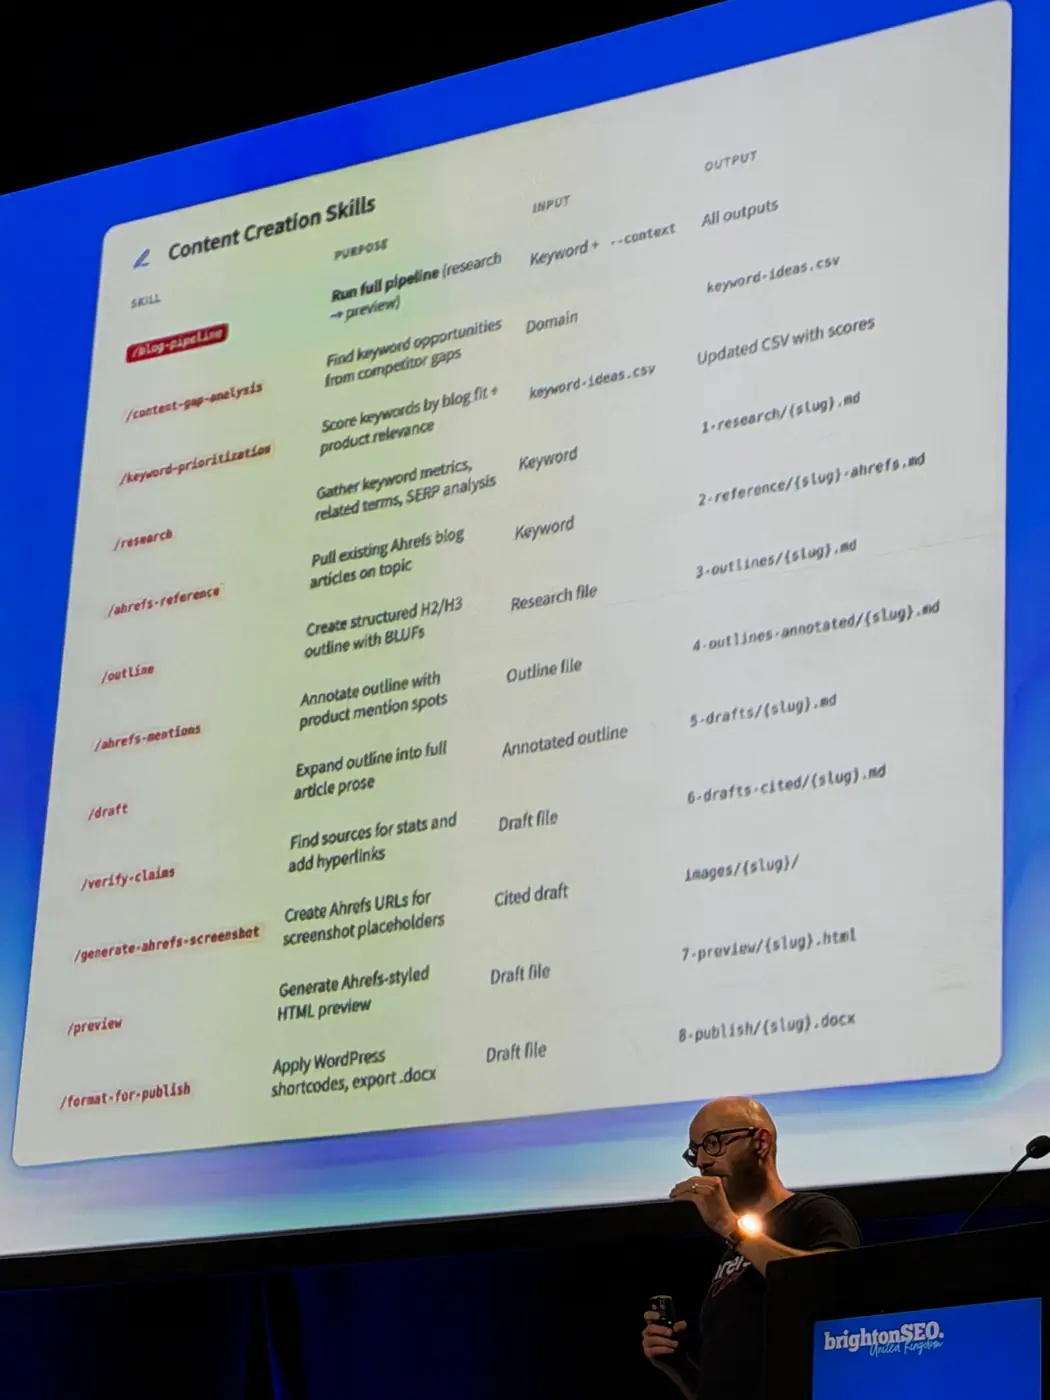
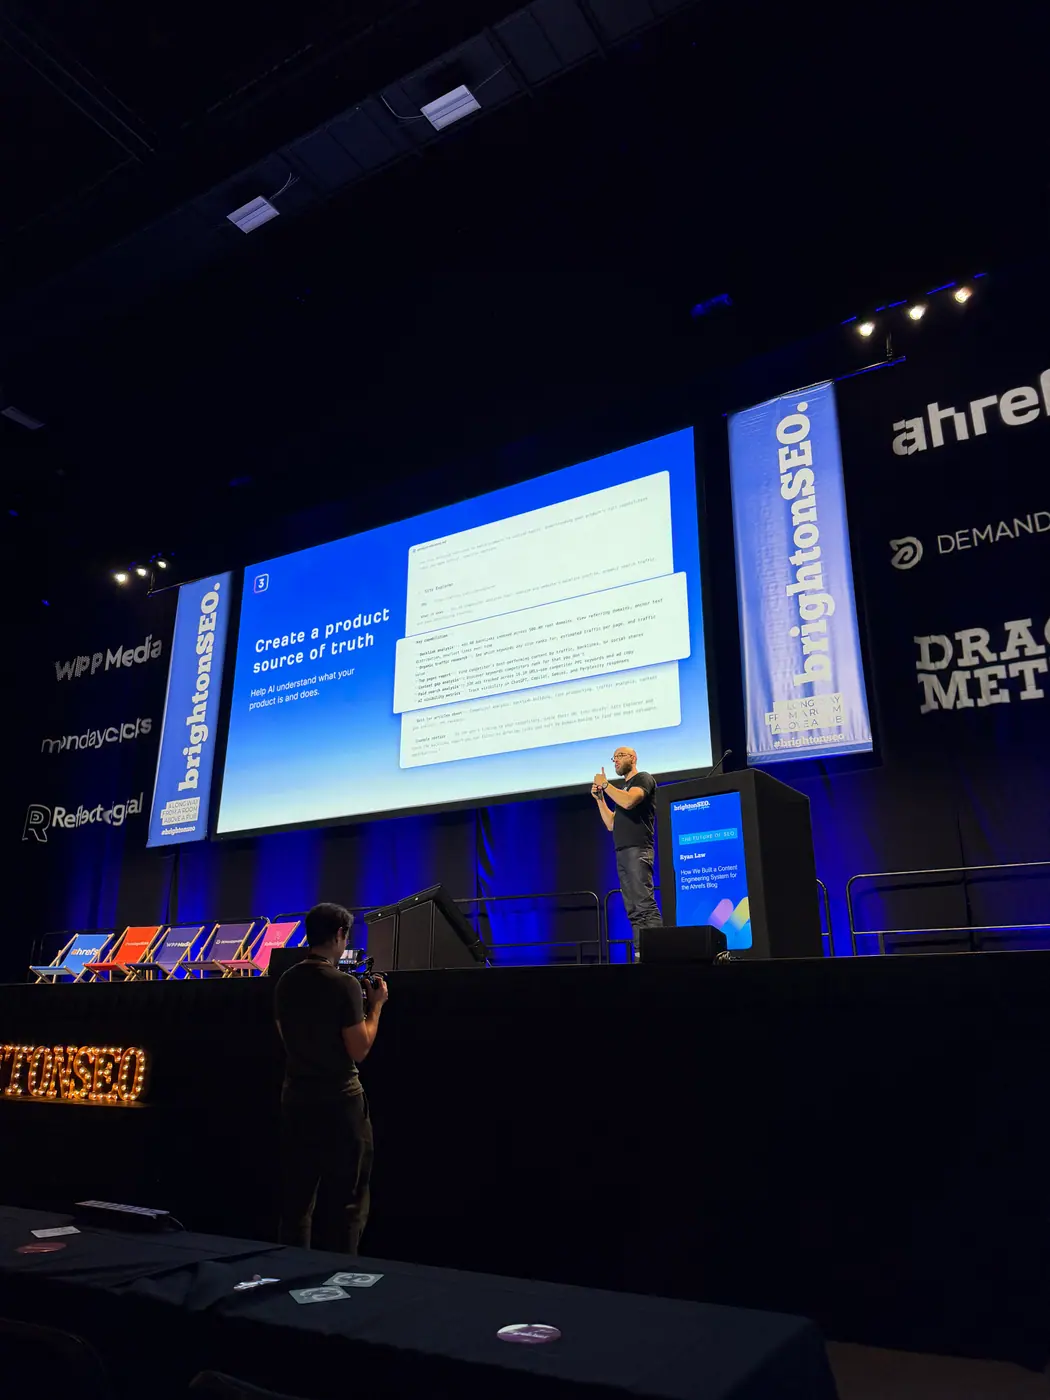
- 17:20 – Ryan Law: How We Built a Content Engineering System for the Ahrefs Blog
Jean Sarunporn: Getting Your Brand Recommended by AI Agents: A Practical Guide to GEO
09:30 · Auditorium 1
Streszczenie
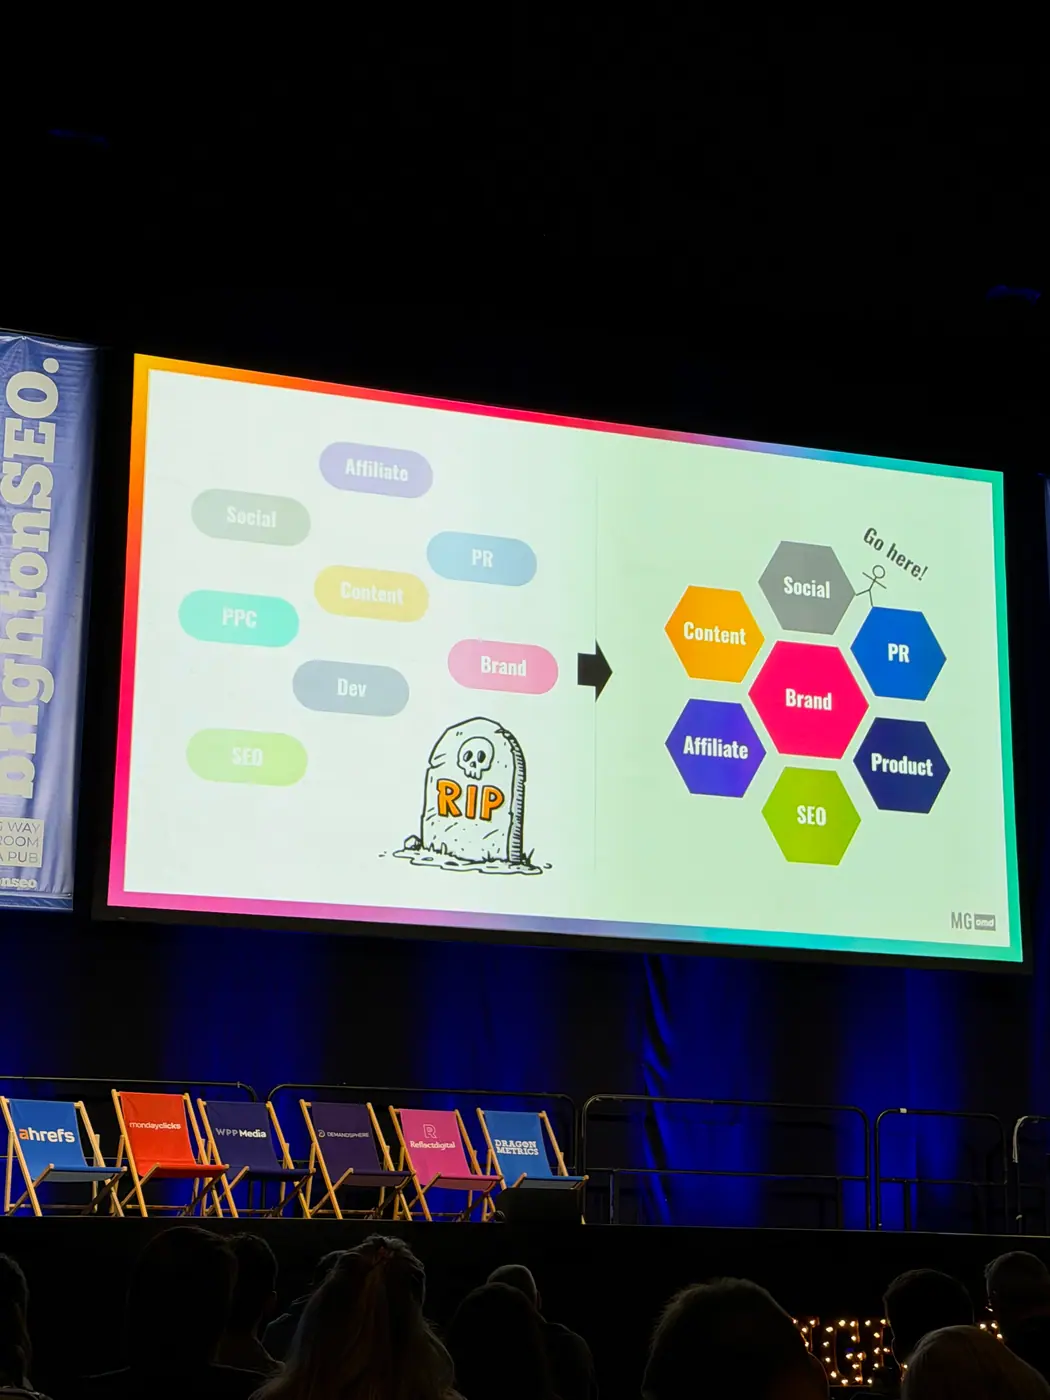
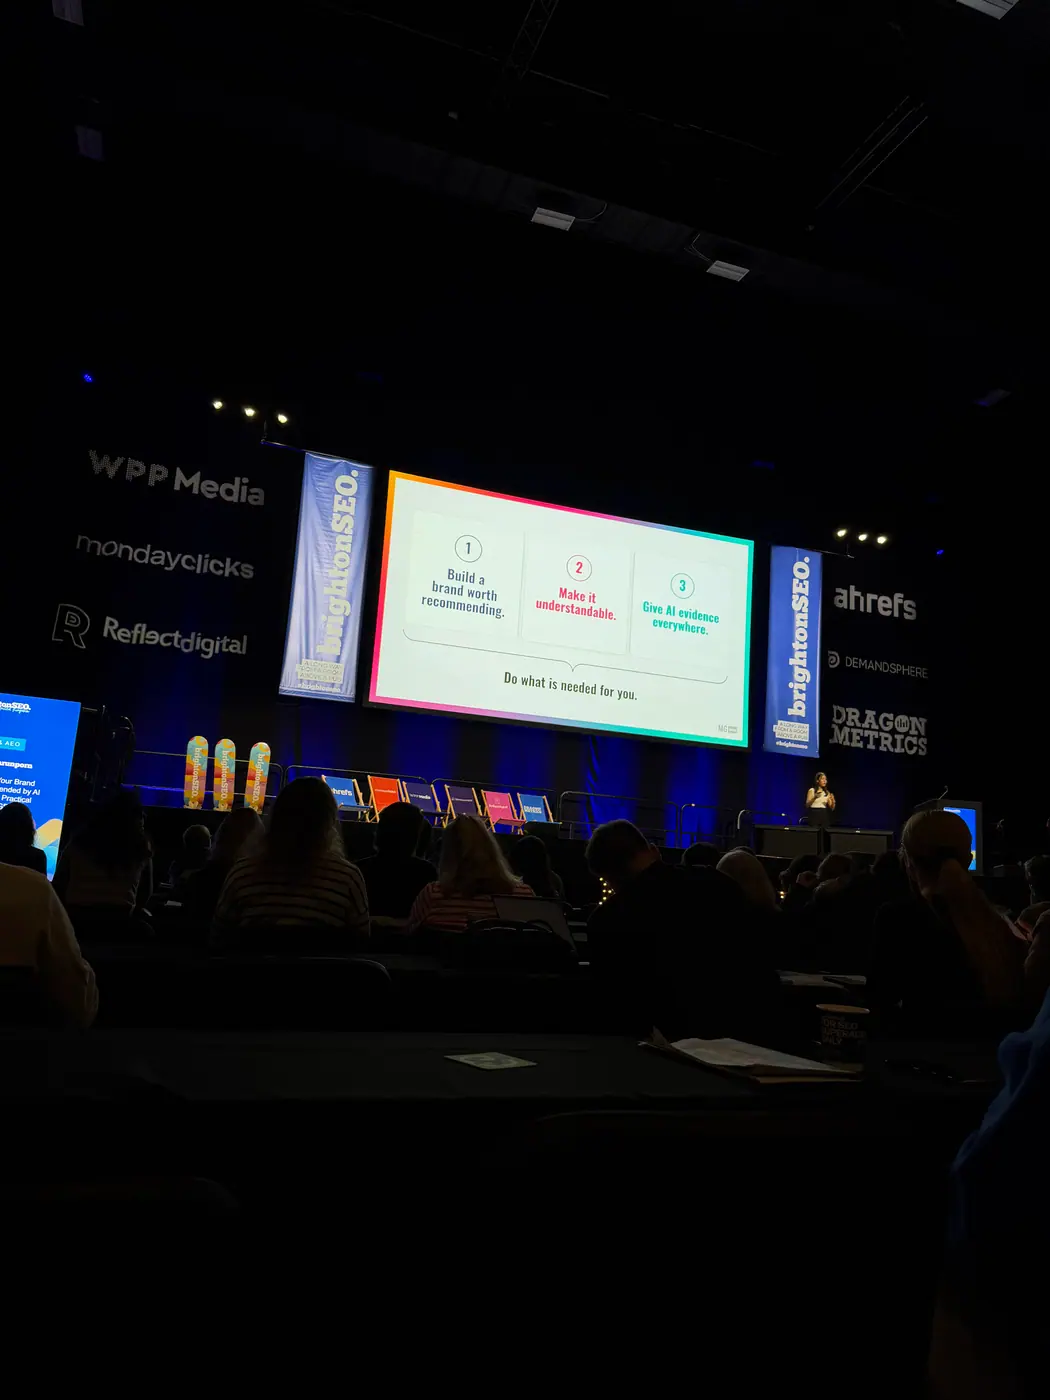
Jean Sarunporn przedstawiła trzy fundamenty rekomendacji przez AI (Artificial Intelligence / sztuczna inteligencja): produkt wart polecenia, zrozumiałe informacje o marce i dowody jej wiarygodności dostępne poza własną stroną.
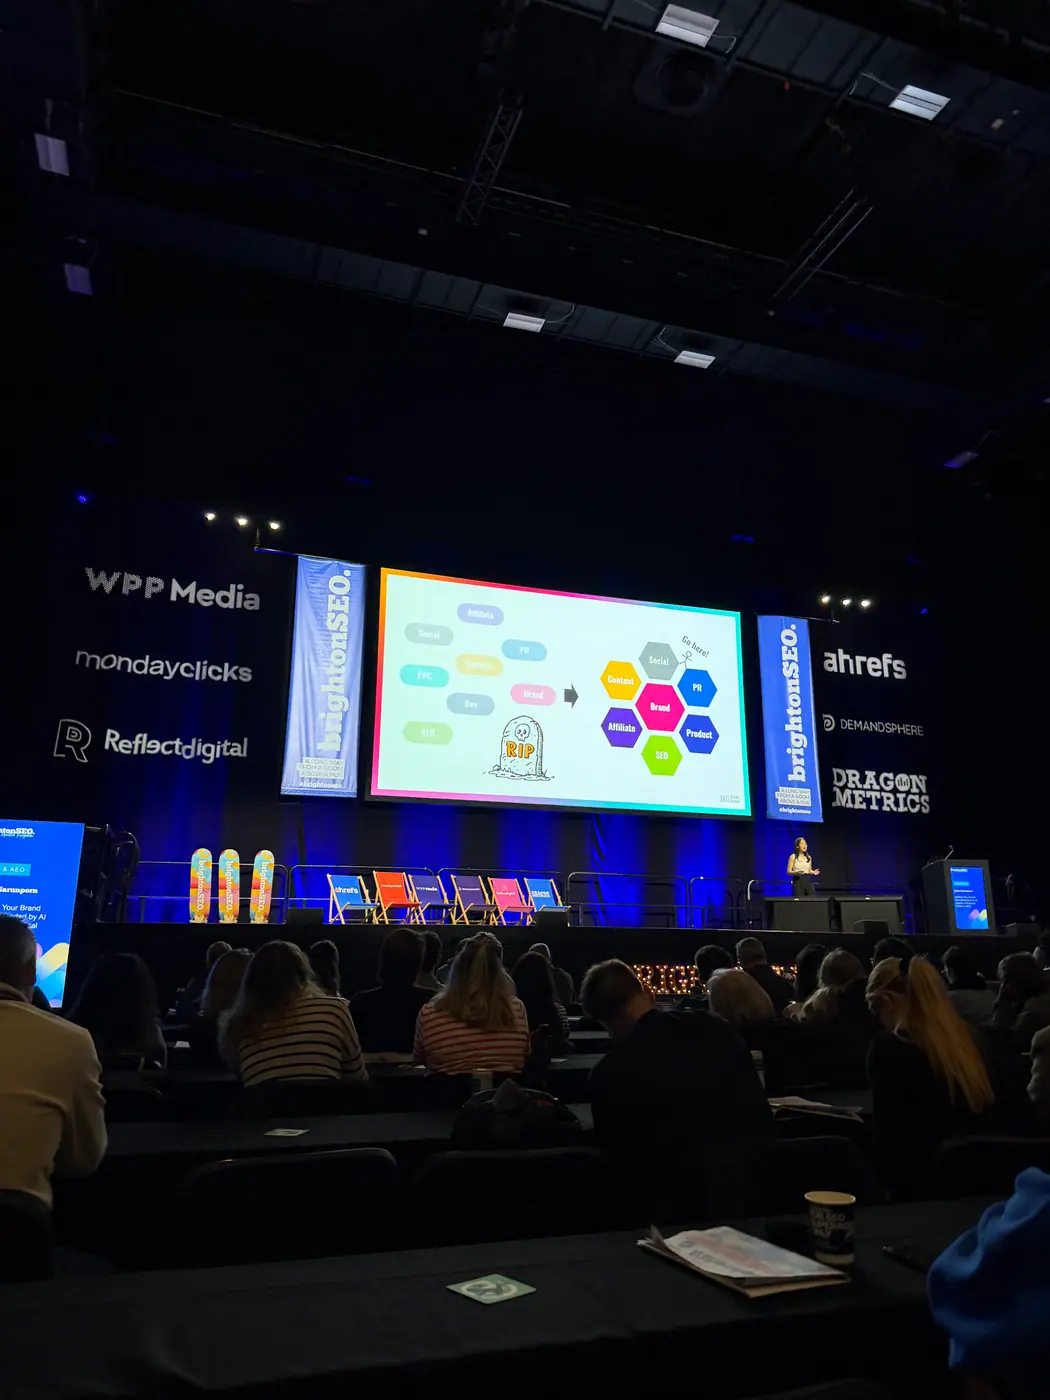
Przekonywała, że GEO (Generative Engine Optimization / optymalizacja widoczności w wyszukiwarkach generatywnych) nie powinno być wyłącznie zadaniem zespołu SEO (Search Engine Optimization / optymalizacja pod kątem wyszukiwarek). W jej ujęciu to projekt obejmujący produkt, komunikację, reputację i techniczne uporządkowanie informacji.
Najważniejsze wnioski
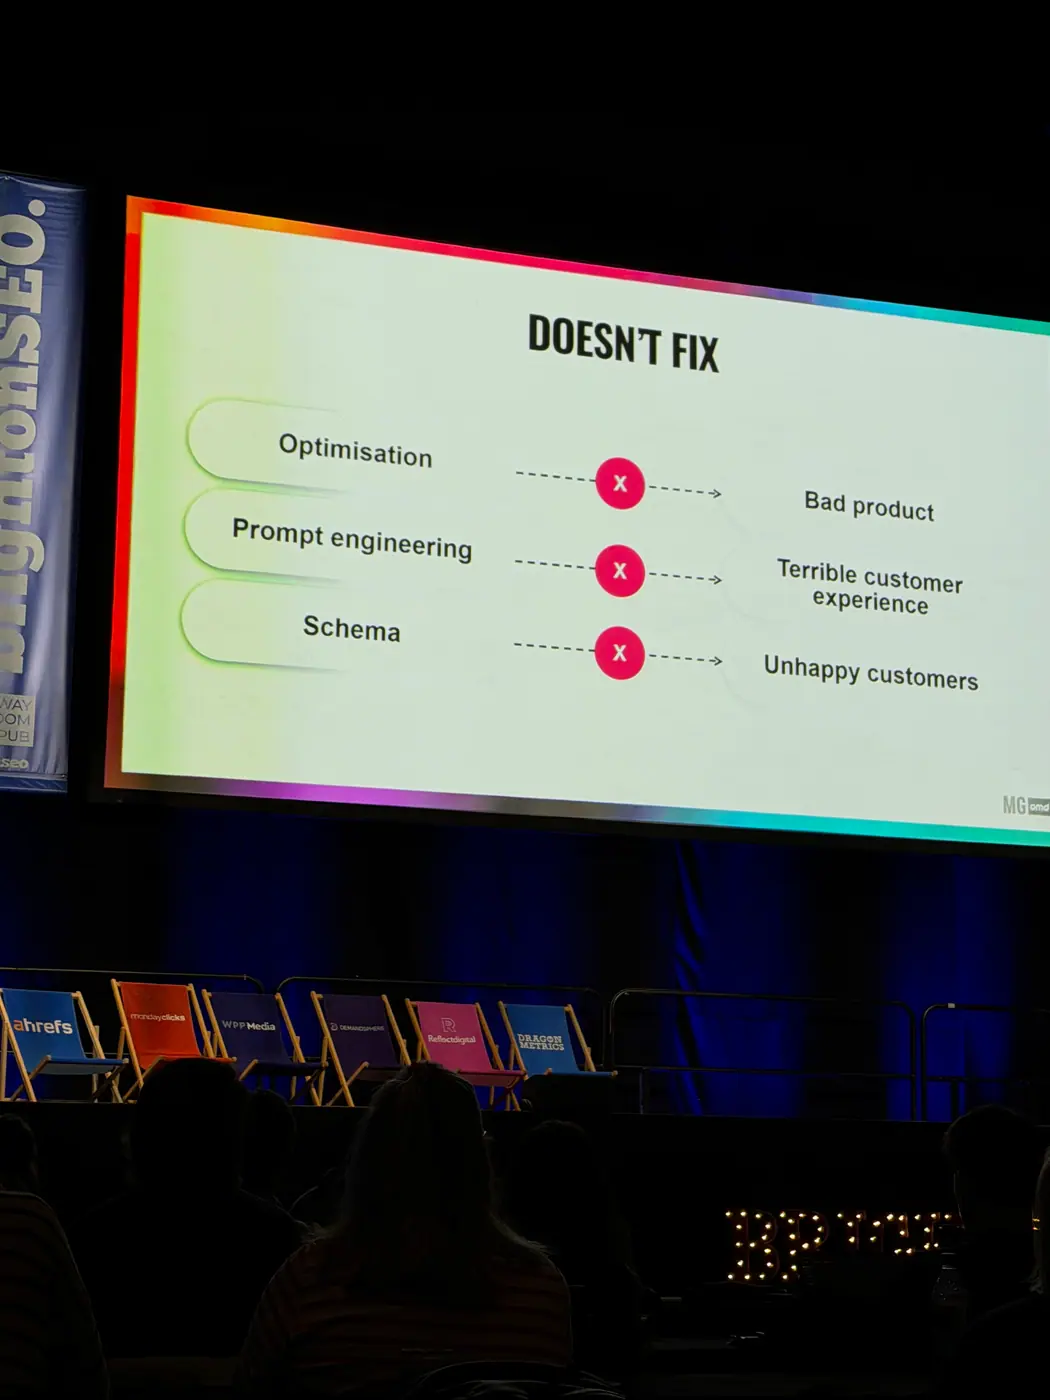
Jakość produktu jest punktem wyjścia. Prelegentka argumentowała, że optymalizacja treści i danych strukturalnych nie zastąpi dobrego doświadczenia klienta.
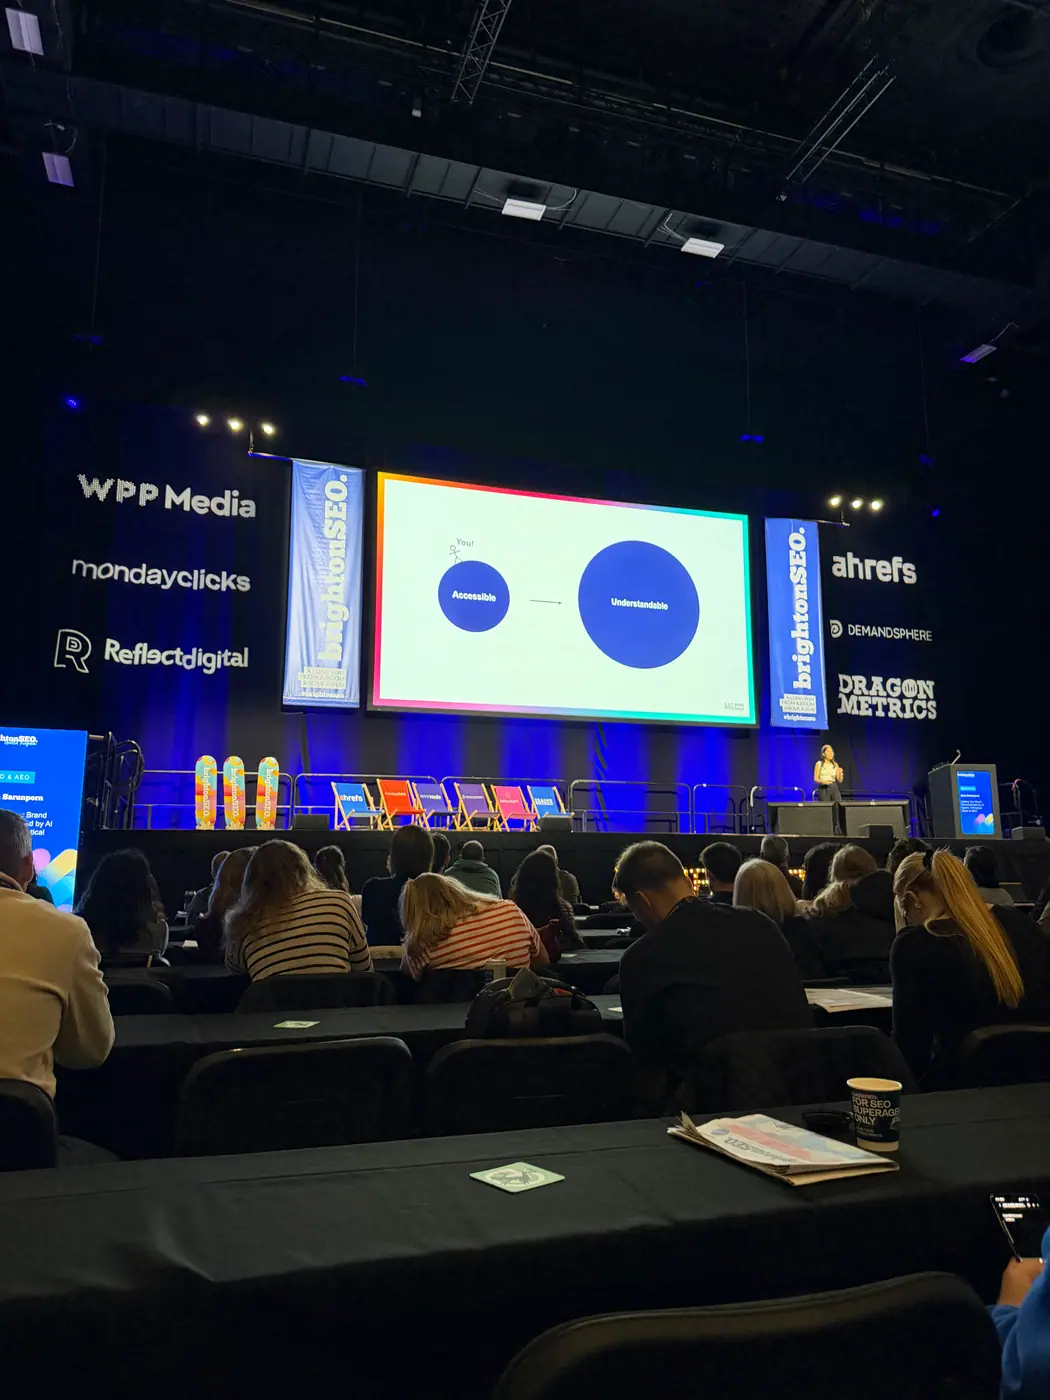
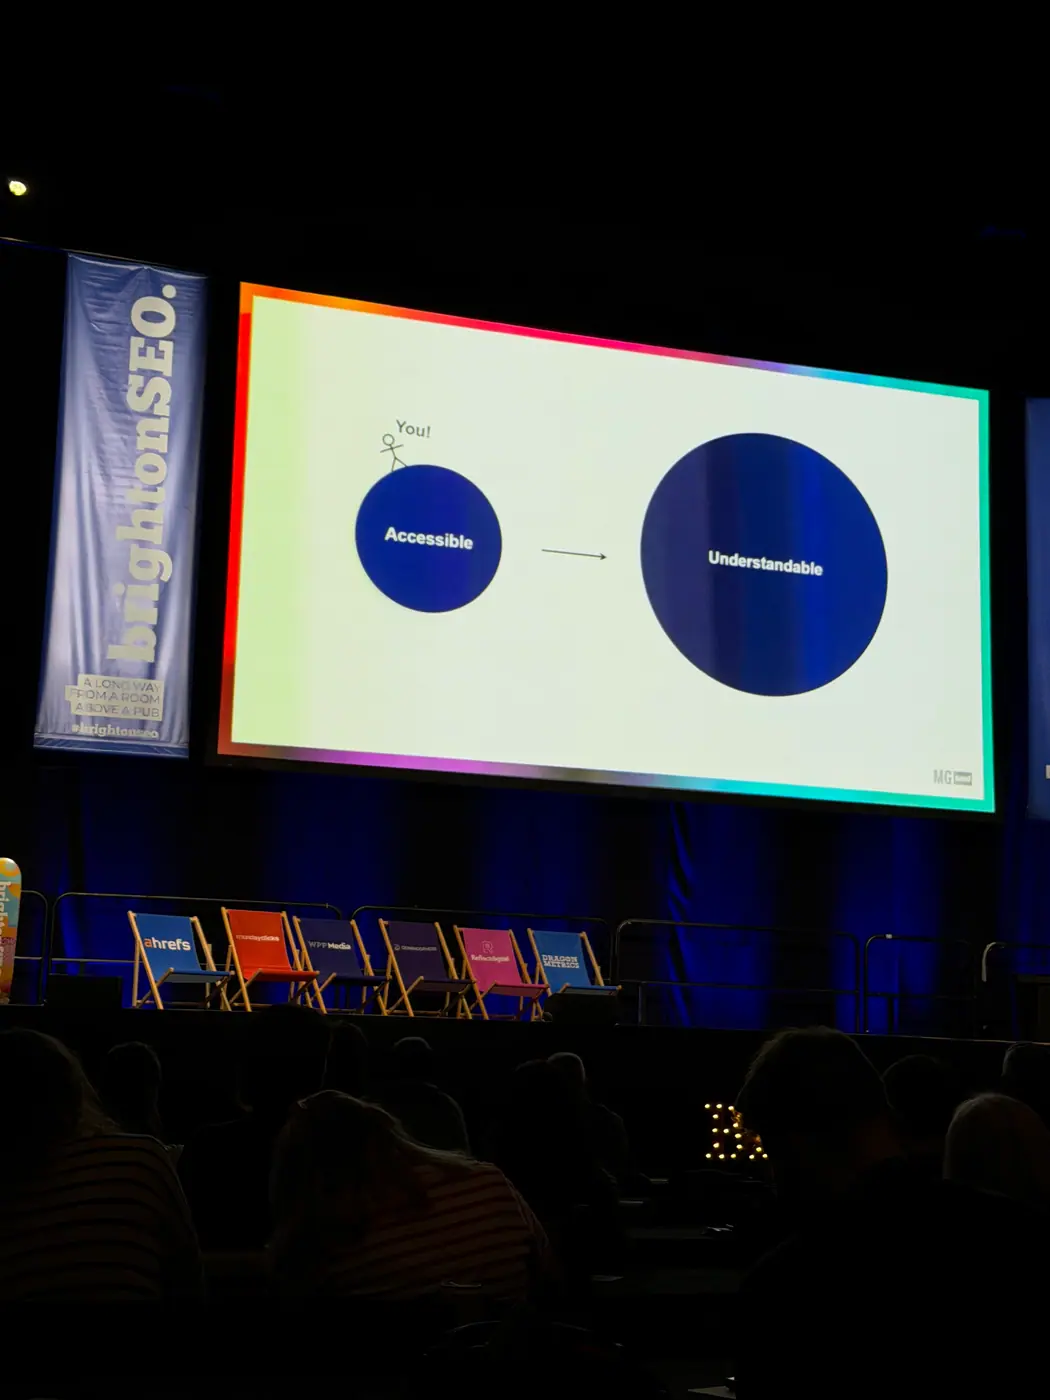
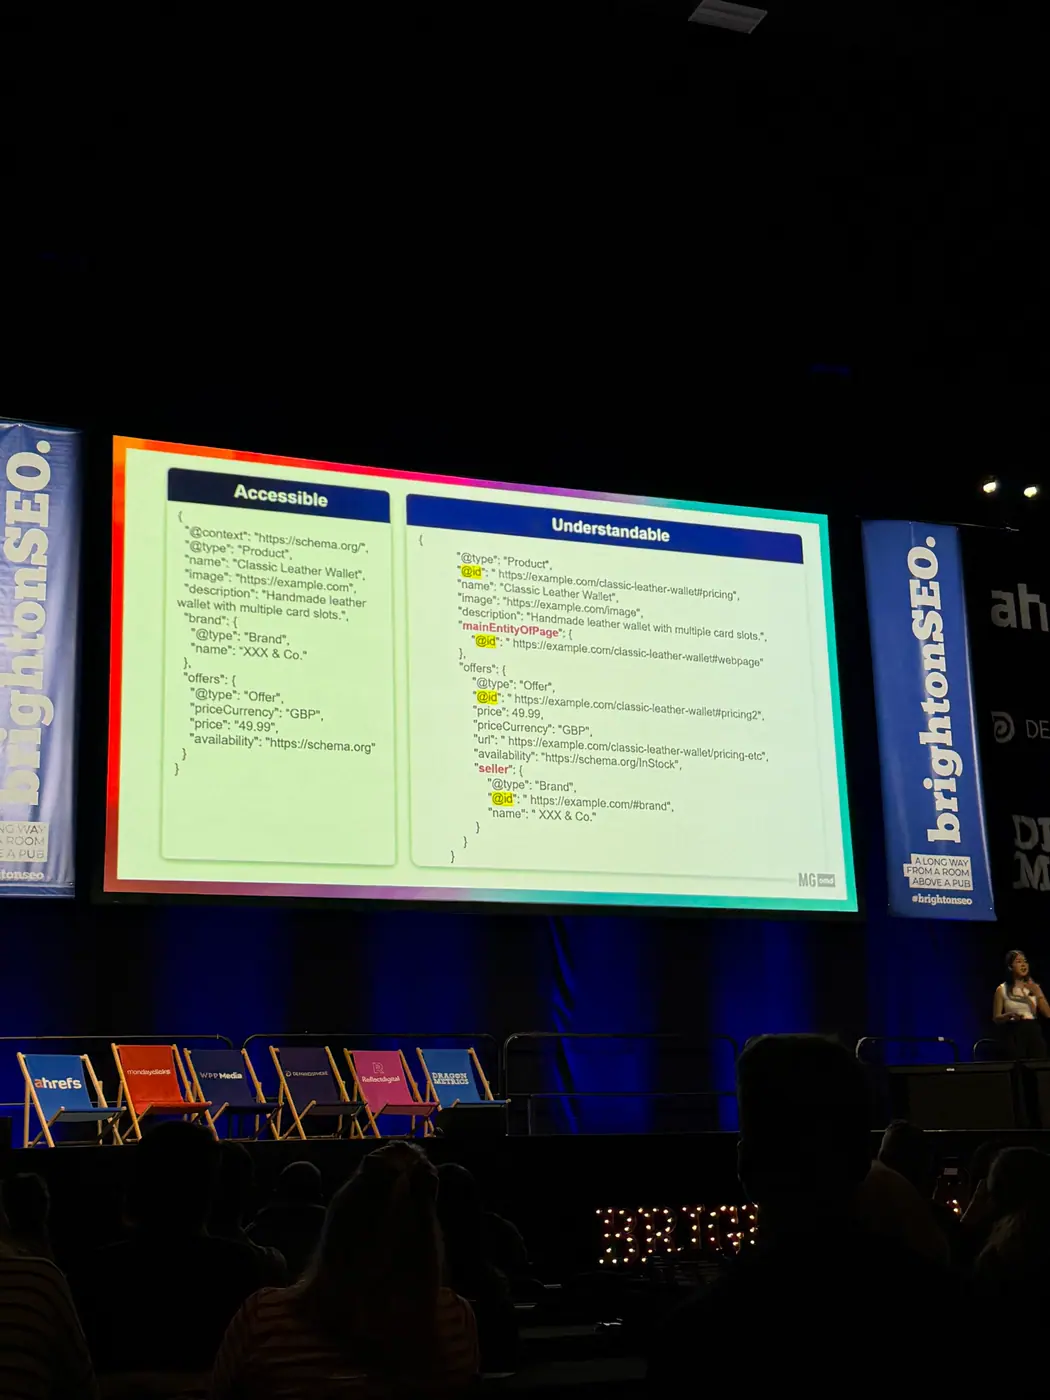
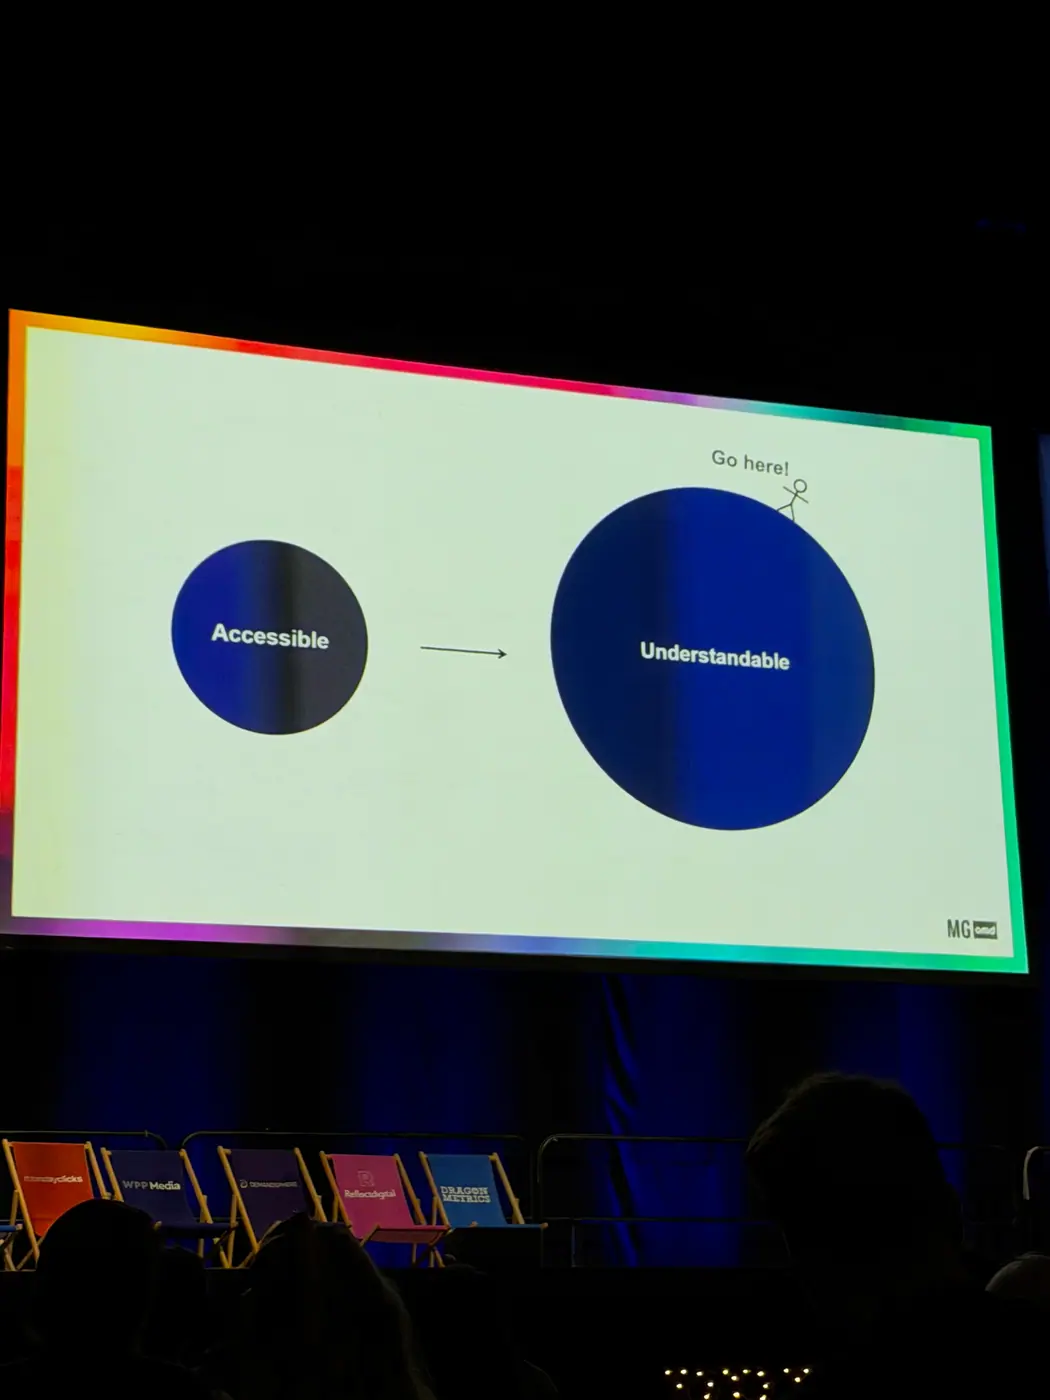
Dostępność informacji to nie to samo co ich zrozumiałość. Zalecała łączenie danych o produkcie, stronie i organizacji za pomocą spójnych identyfikatorów, zamiast traktowania znaczników na poszczególnych stronach jako osobnych wdrożeń.
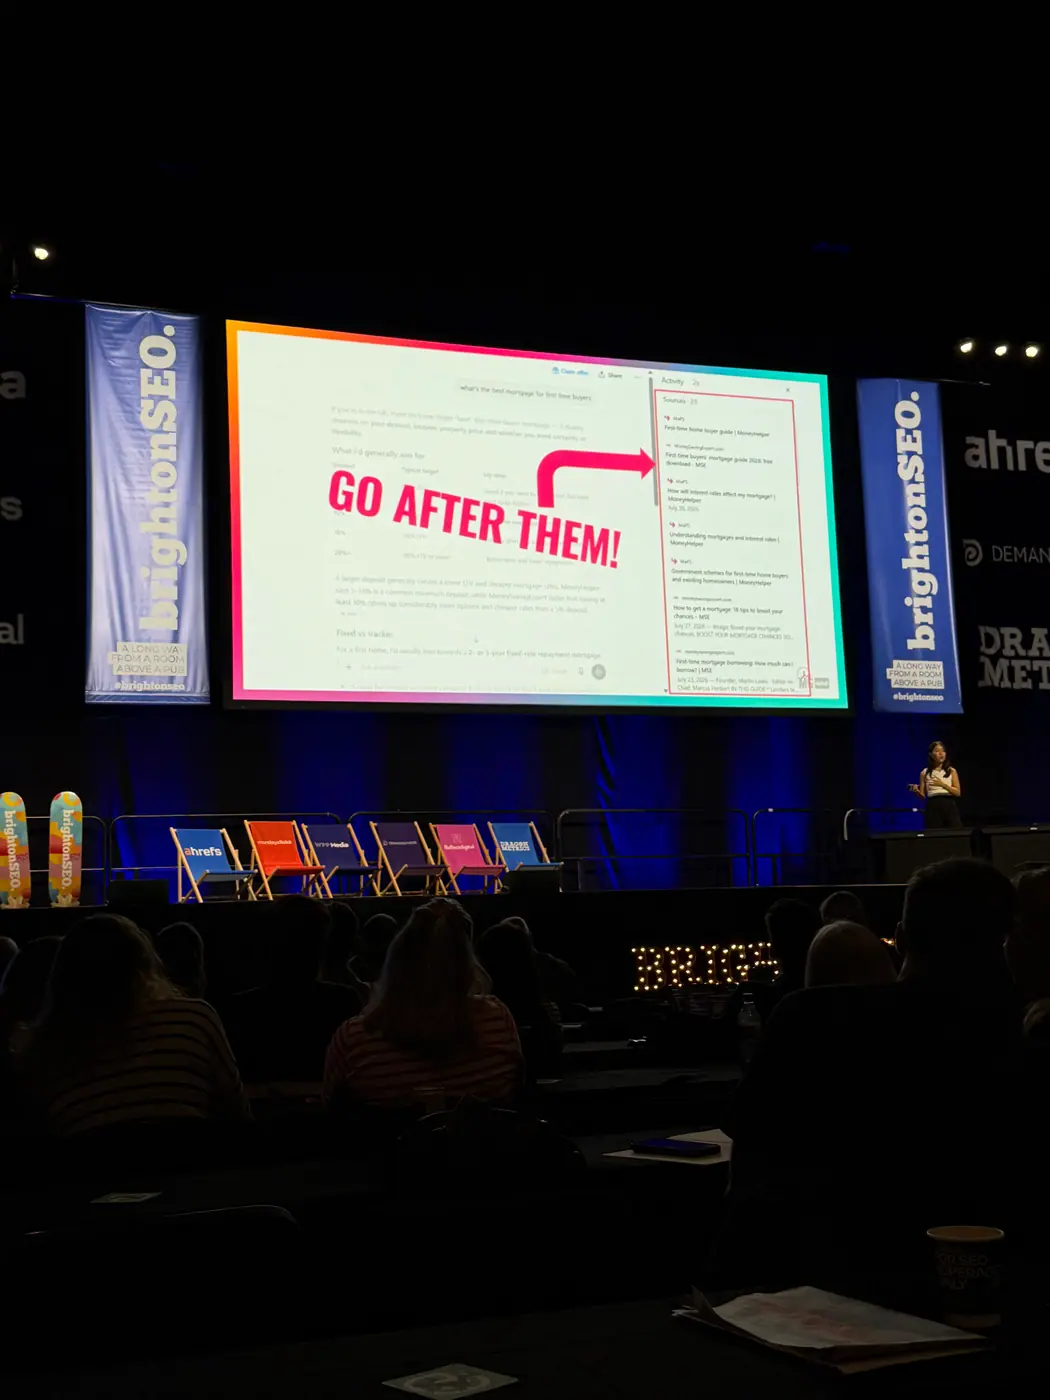
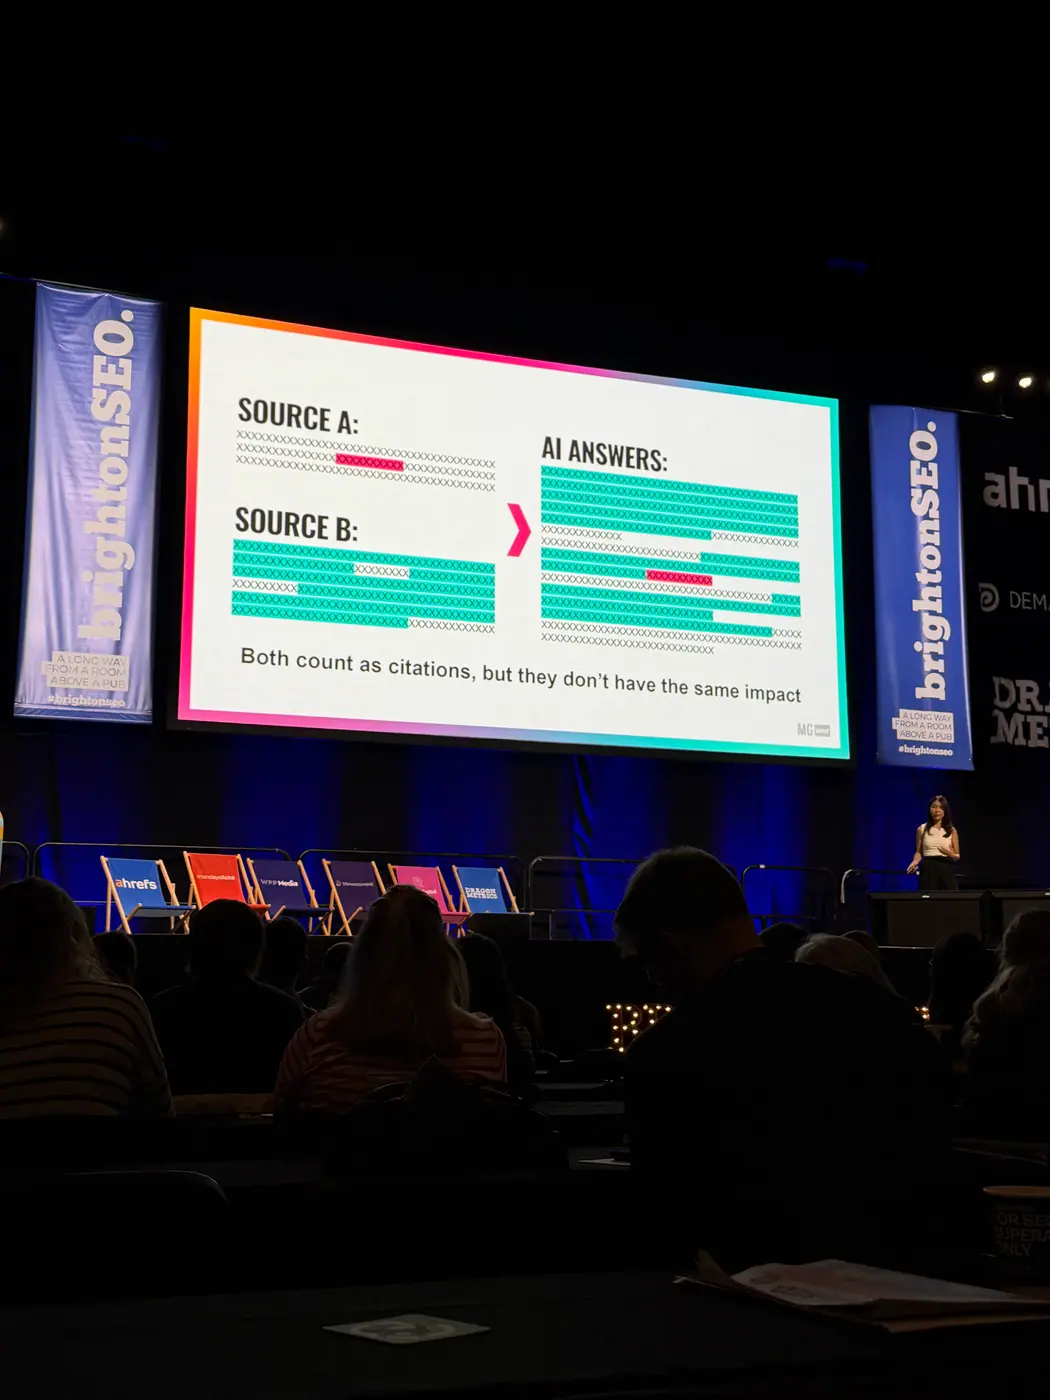
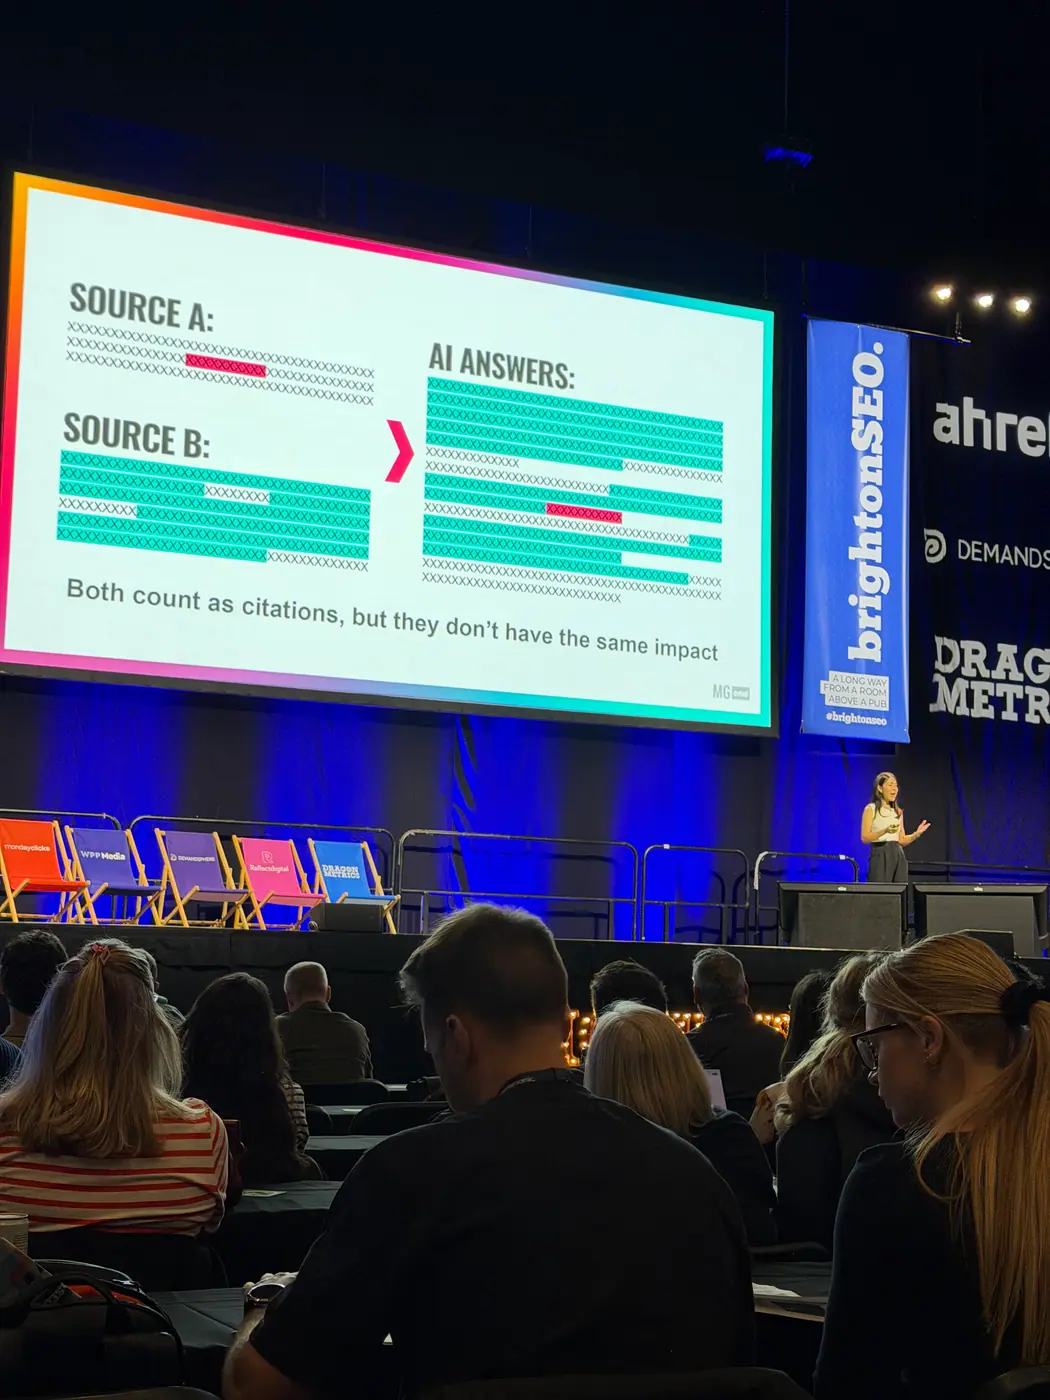
Wzmianka lub cytowanie nie oznacza jednakowego wpływu na rekomendację. Rekomendowała porównywanie treści wskazanych źródeł z odpowiedziami AI, aby ustalić, które informacje znalazły w nich odzwierciedlenie.
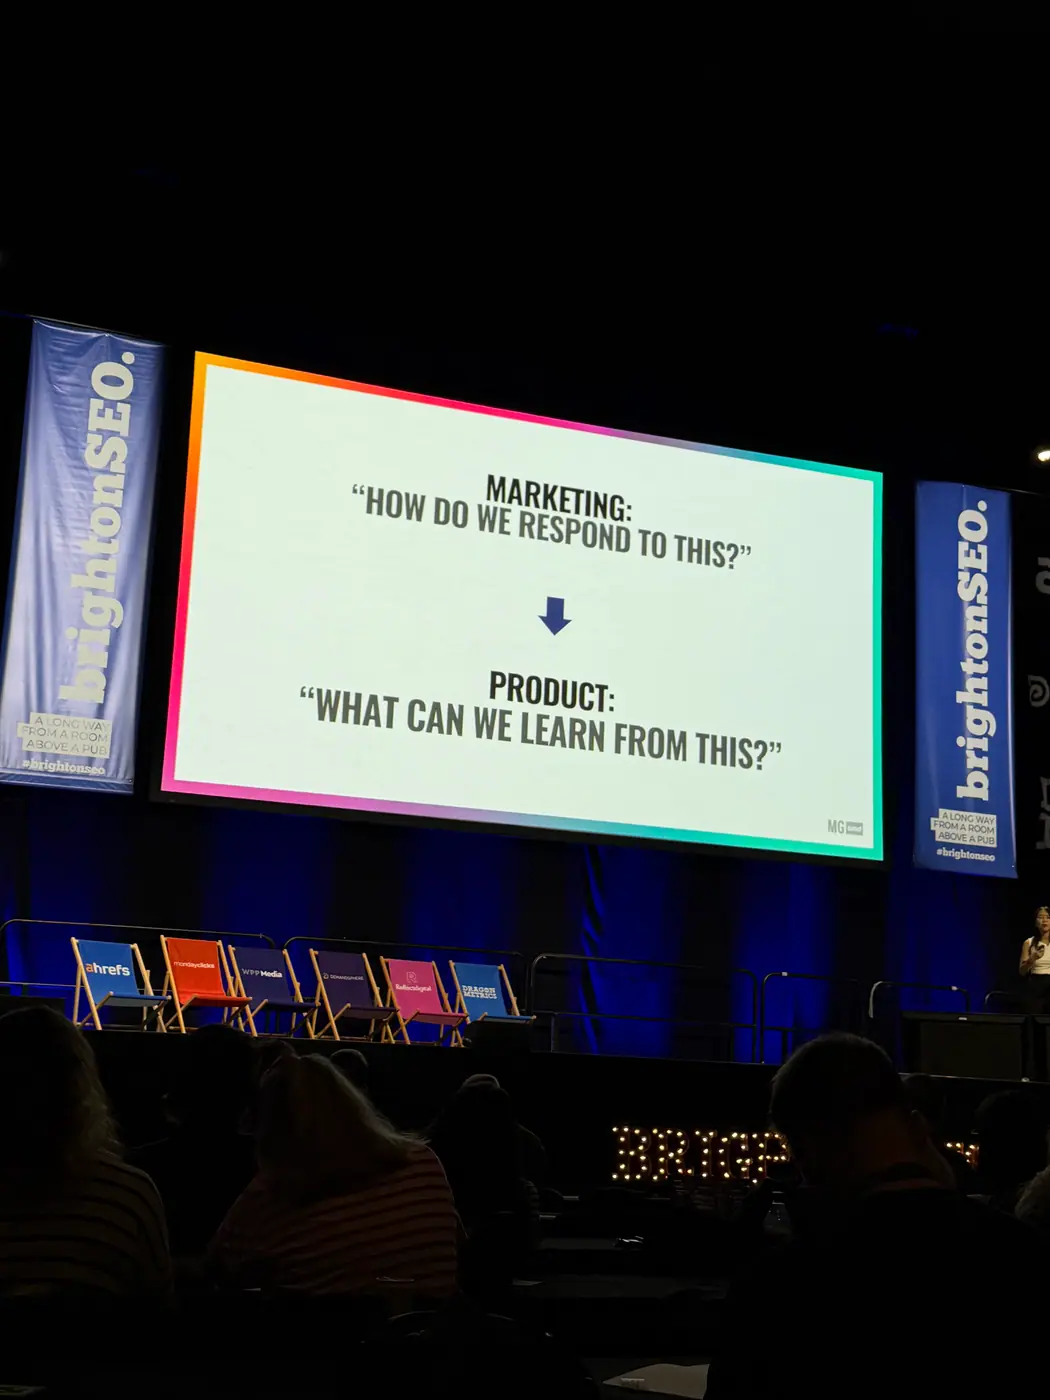
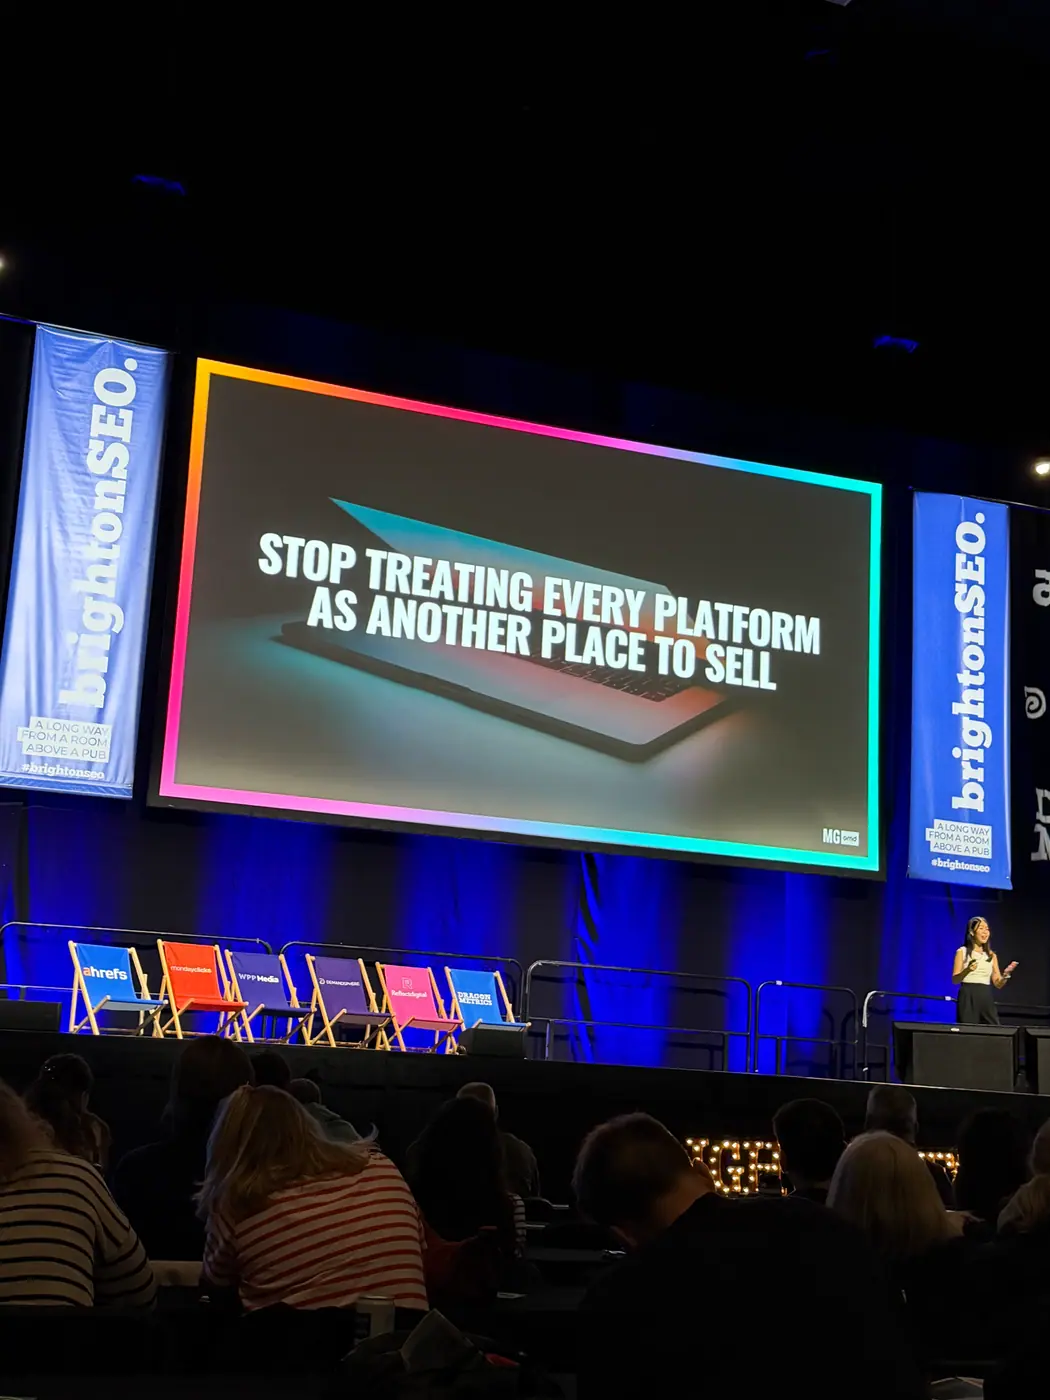
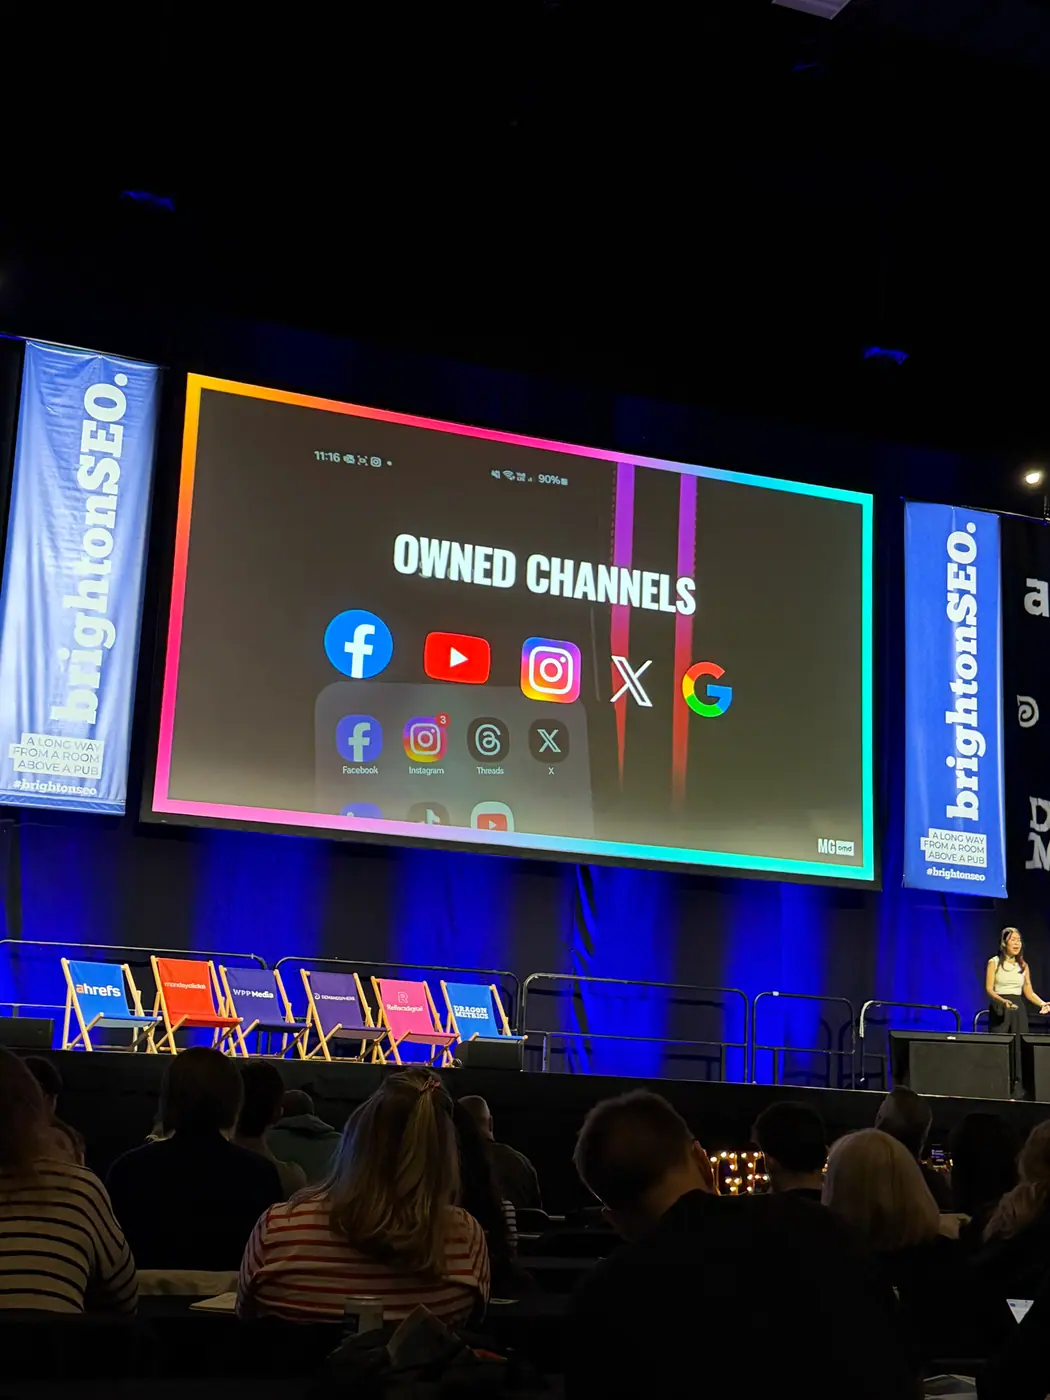
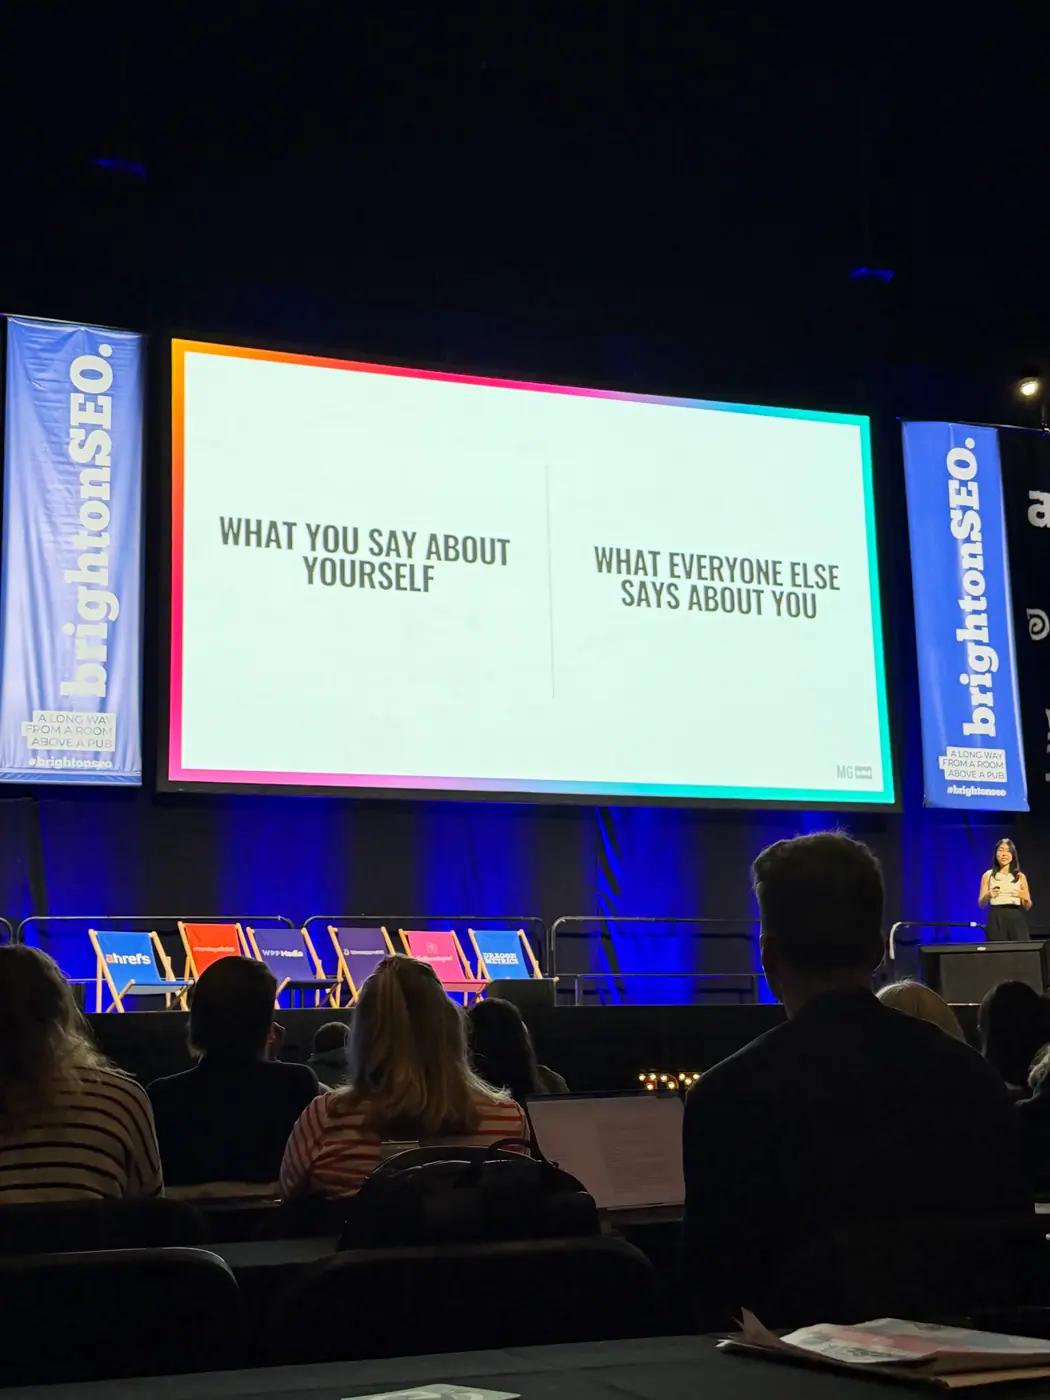
Poszczególne platformy pełnią różne funkcje. Wikipedia służy faktom, Reddit rozmowom społeczności, a własna strona wyjaśnianiu oferty i konwersji. Prelegentka przestrzegała przed traktowaniem każdego miejsca jak powierzchni reklamowej.
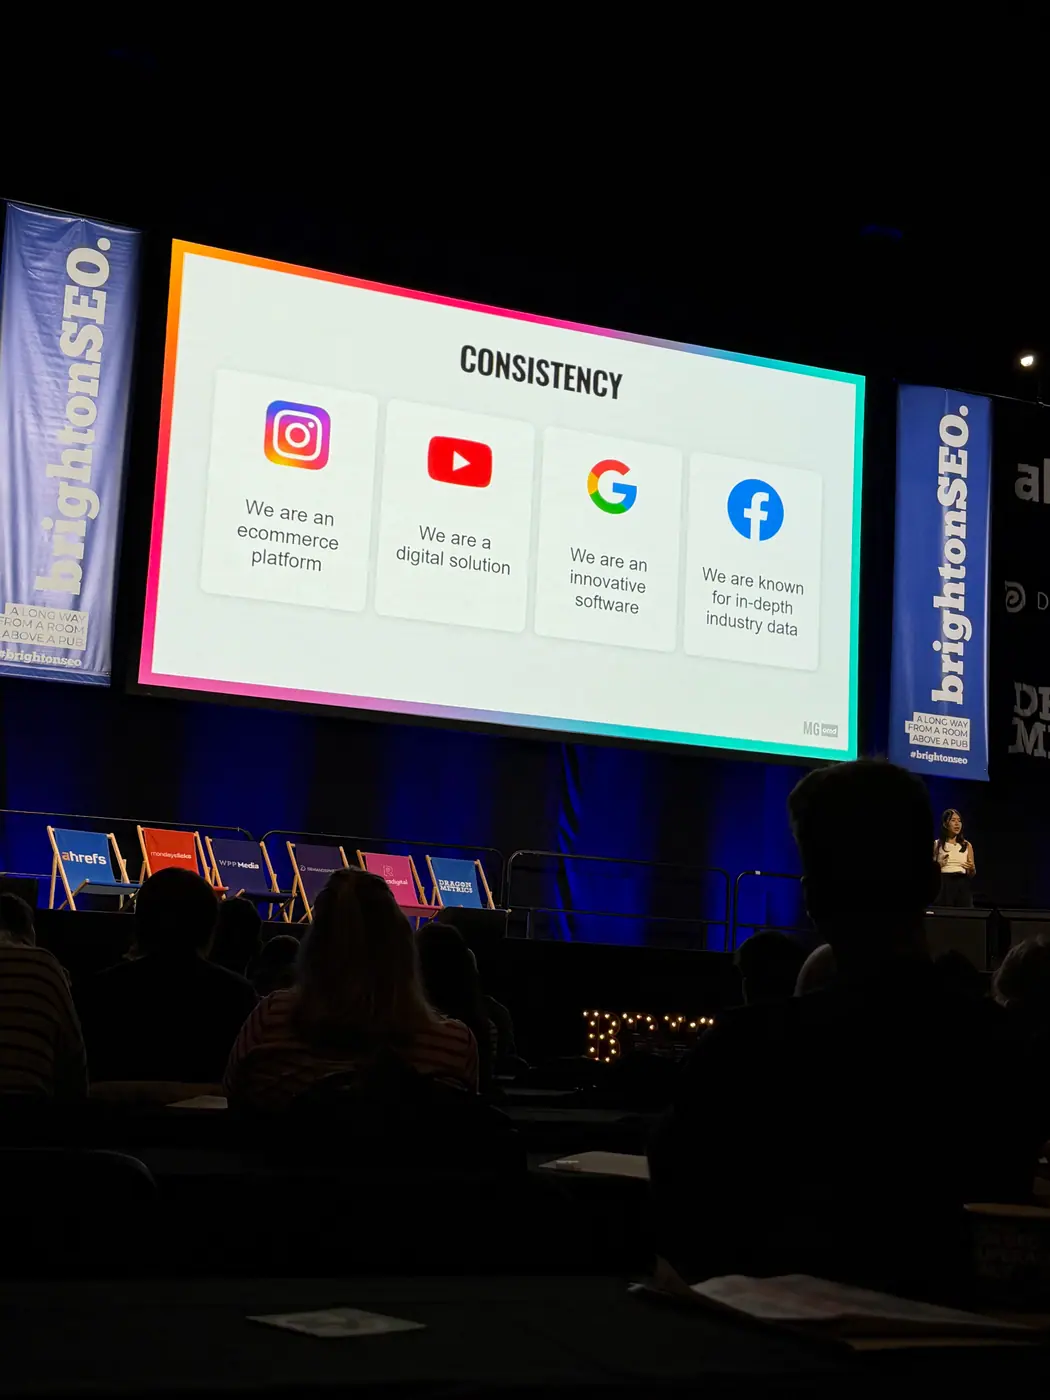
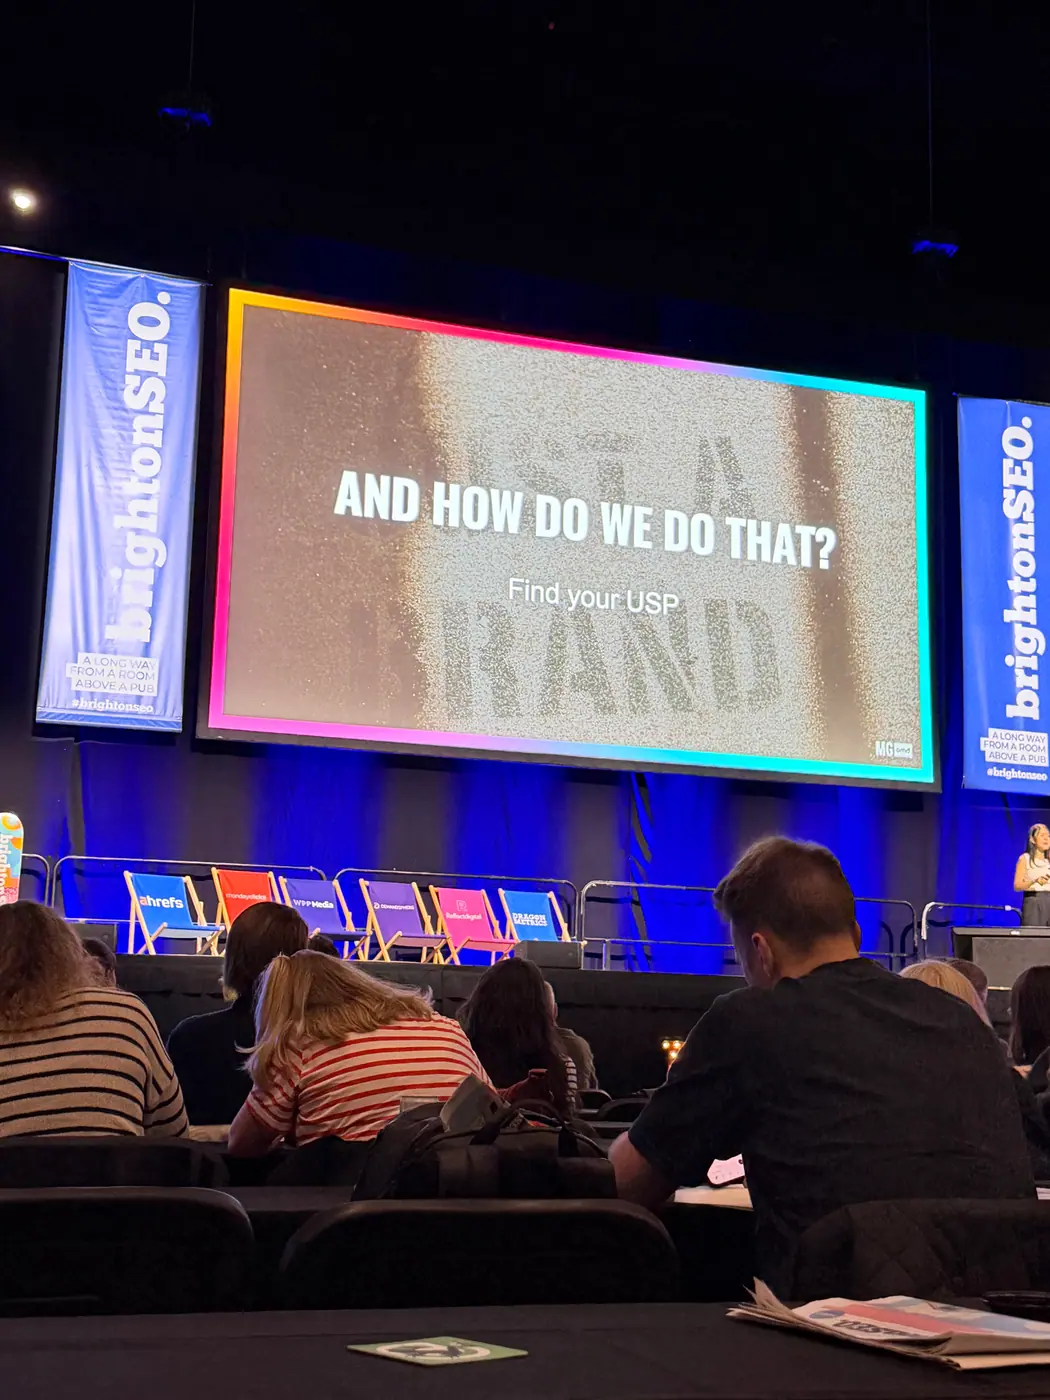
Marka potrzebuje konkretnego i spójnego wyróżnika. Zalecała określenie USP (Unique Selling Proposition / unikalna propozycja sprzedażowa), które będzie konsekwentnie komunikowane w różnych kanałach.
Priorytet powinien wynikać z największej bariery firmy. Przekonywała, że etap rozwoju produktu, strony lub rynku jest ważniejszy niż popularność kolejnej taktyki.
Dane liczbowe i przykłady
- Około 50% osób na sali: tak prelegentka oszacowała liczbę uczestników, którzy nadal mieli podniesione ręce pod koniec serii pytań o zagadnienia związane z AI, danymi strukturalnymi i plikiem
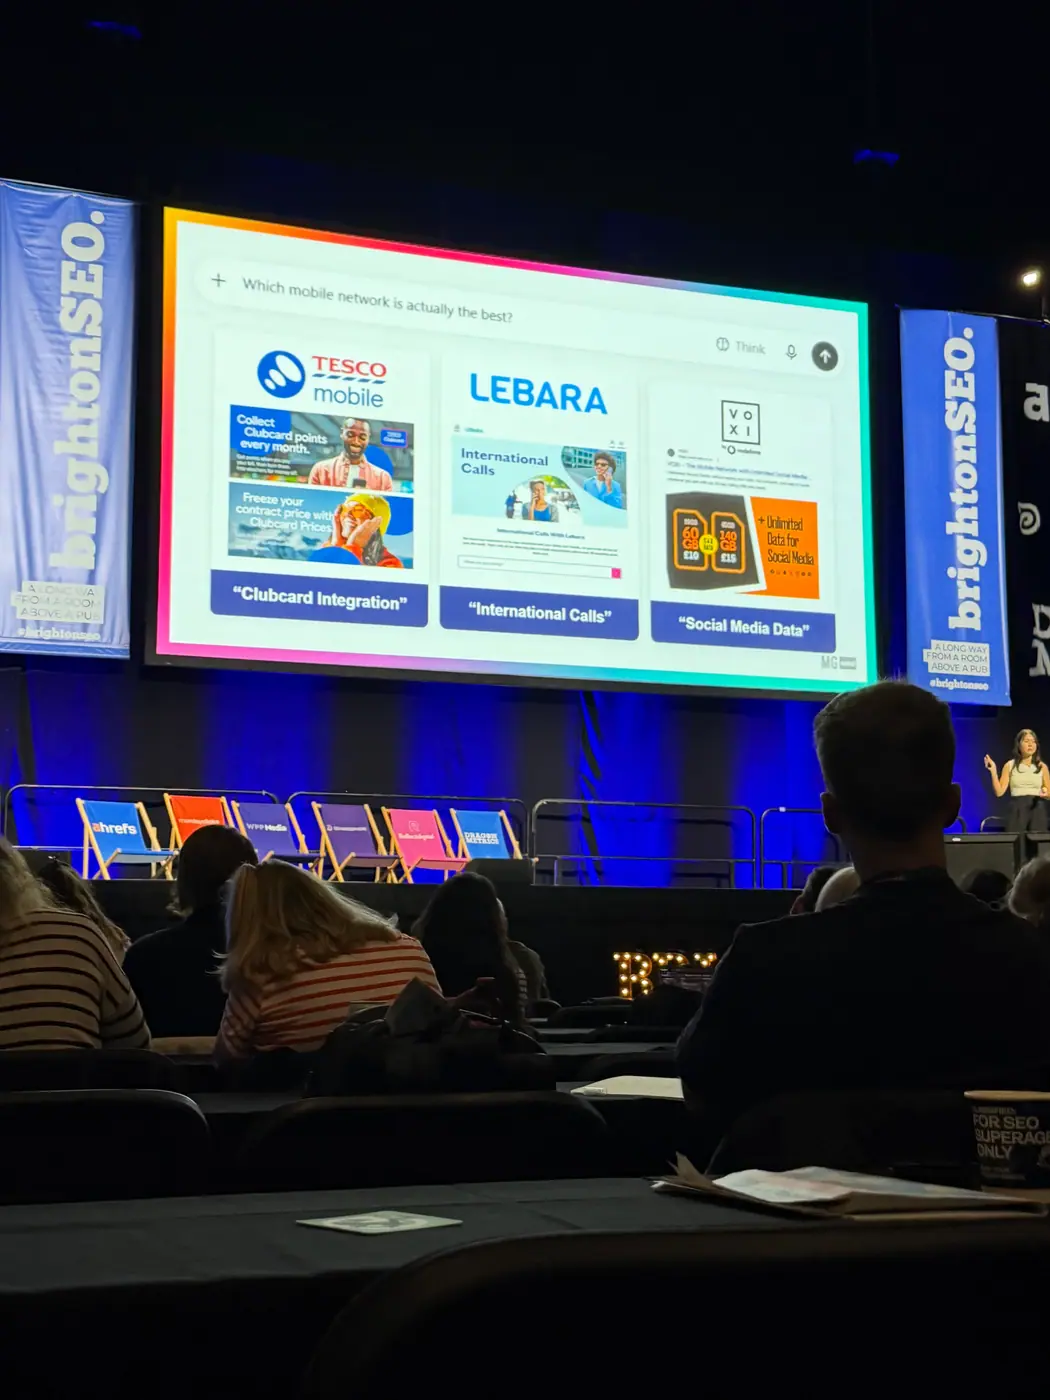
llms.txt. Była to obserwacja z sali, nie wynik badania rynku. - Przykład operatora komórkowego: Sarunporn opisała markę oferującą nielimitowane dane do korzystania z mediów społecznościowych. Wyróżnik pojawiał się w tytule strony głównej, głównym banerze, dedykowanych treściach i kanałach społecznościowych. Prelegentka wiązała tę spójność z częstym pojawianiem się operatora w obserwowanych przez nią rekomendacjach AI.
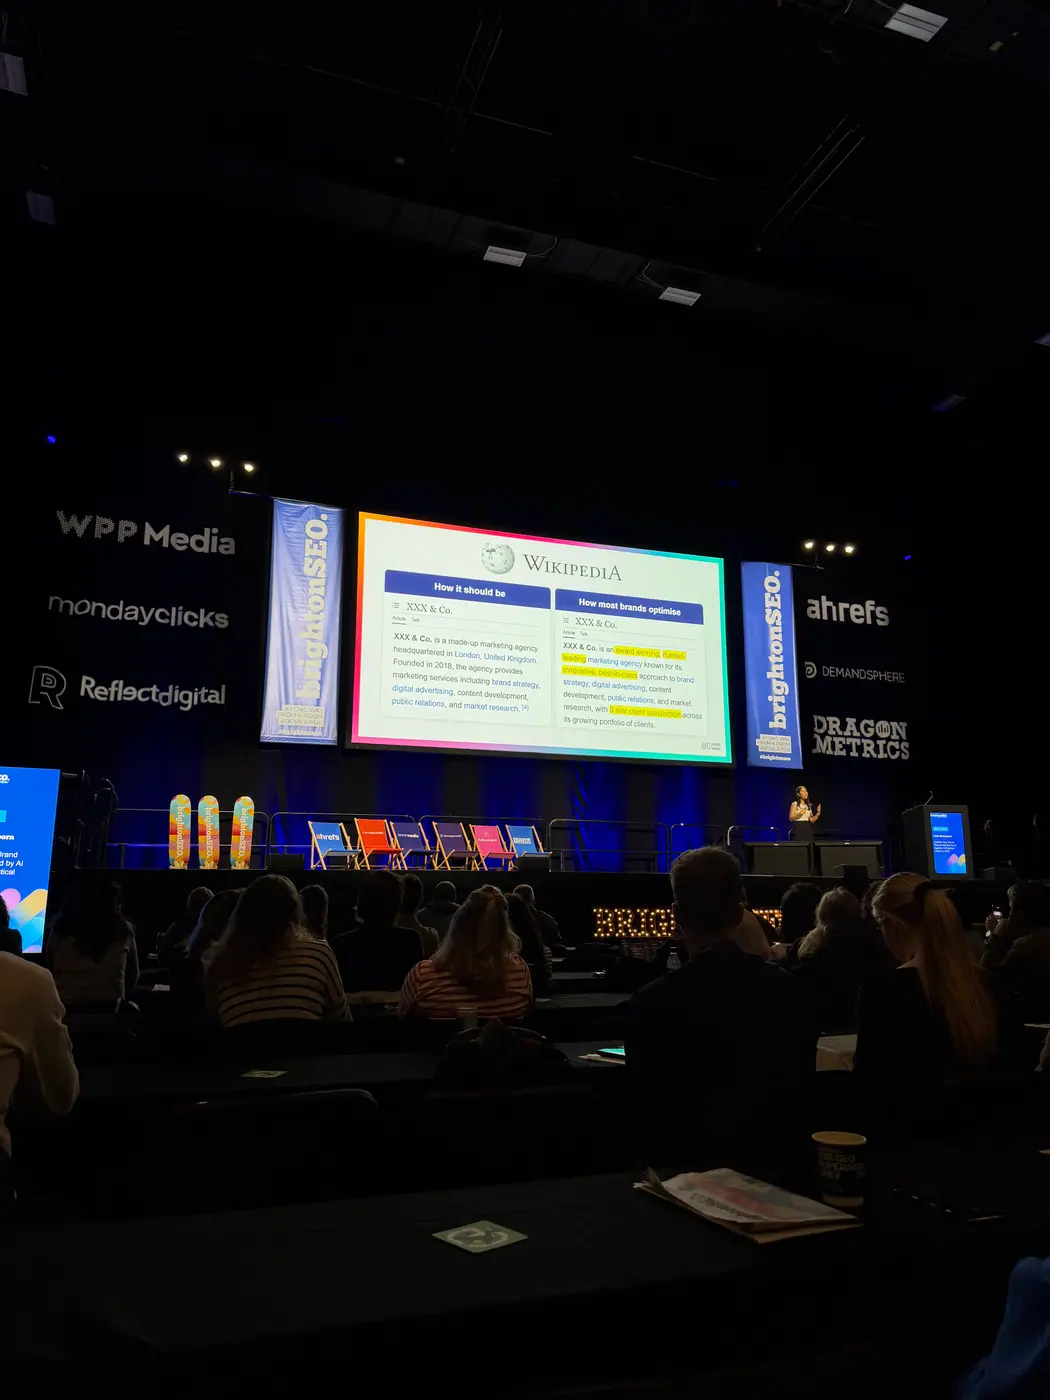
- Przykłady niewłaściwych działań: zamienianie wpisu encyklopedycznego w reklamową broszurę oraz odpowiadanie na skargi społeczności ogólnymi komunikatami zamiast rozwiązywania problemów produktu.
Praktyczne rady
- Sprawdź pytania, przy których marka nie jest polecana, i przeanalizuj źródła wskazane w odpowiedziach.
- Porównuj zawartość tych źródeł z treścią rekomendacji, zamiast ograniczać analizę do liczby cytowań.
- Zweryfikuj, czy dane strukturalne łączą produkt, stronę i organizację.
- Ustal jeden konkretny wyróżnik oferty i sprawdź jego spójność we własnych kanałach.
- Wykorzystuj skargi społeczności jako materiał dla zespołu produktowego.
- Przed kolejnym eksperymentem wybierz problem, którego rozwiązanie może obecnie przynieść firmie największą zmianę.
Knowledge bombs
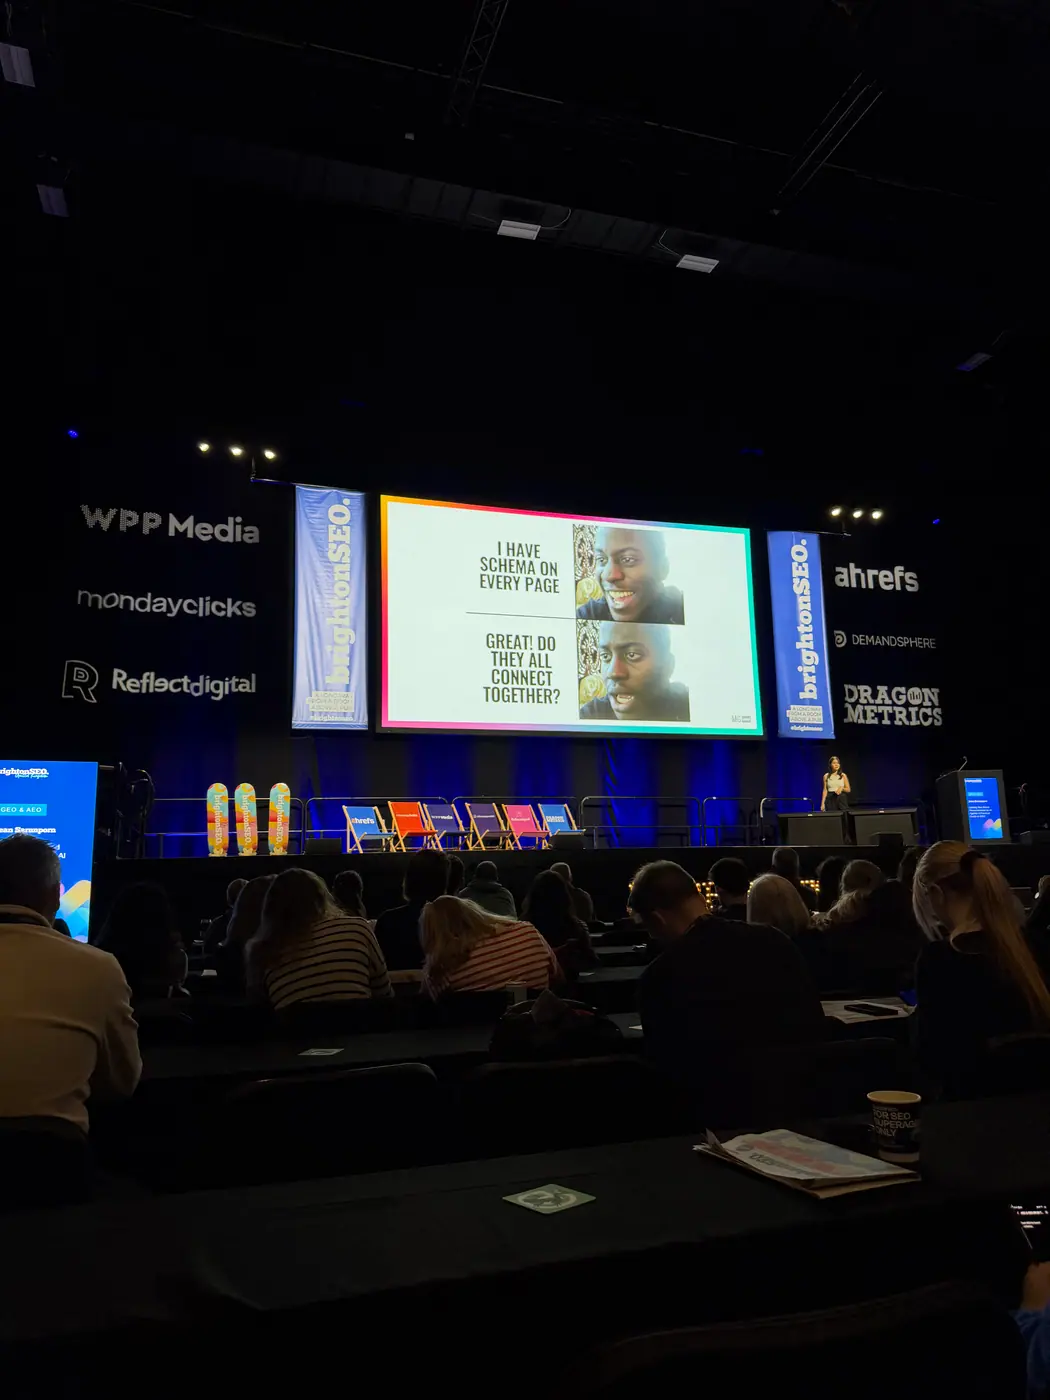
1. Schema „na każdej stronie” to za mało – liczy się to, czy encje są ze sobą powiązane.
Typowa reakcja klientów: „mamy schema wszędzie, SEO zrobione”. Jej pytanie kontrolne brzmi: „jak te byty łączą się ze sobą?”. Konkretnie: spójne identyfikatory @id – produkt wskazuje stronę przez mainEntityOfPage, a sprzedawcę (seller) przez @id organizacji. Chodzi o to, by przejść od „dostępne dla maszyn” do „zrozumiałe dla maszyn” (logika knowledge graphu).
„And you can use consistent identifiers like the ID element within the product schema. You can use within the main entity of the page, link it to the webpage ID. Within the seller element, link it to your organization ID.”
2. Nie każde źródło cytowane przez AI realnie wpływa na odpowiedź – porównuj treść źródła z treścią odpowiedzi.
Sama lista cytowań myli, bo AI potrafi „zacytować” stronę za jedno zdanie. Jej workflow: dla promptów, w których marki nie ma, zebrać źródła, a potem zestawić treść tych stron z treścią odpowiedzi AI. W ten sposób widać, które źródła faktycznie kształtują rekomendacje i sposób mówienia o marce, i to je traktuje się priorytetowo (afiliacja → zespół afiliacyjny, organiczne → PR).
„Because AI can take one sentence from a website and call it a source. They are all citations. What I would do is recommend you to take one step further and looking at comparing the on-page content of those sources with the AI answers.”
3. Reddit to sprawa zespołu produktowego, nie marketingu.
Zamiast „kontrolować narrację” korporacyjnymi formułkami albo kłócić się z użytkownikami, potraktuj wątki z Reddita jak darmową grupę fokusową. Najpierw popraw coś realnie w produkcie, a dopiero potem wejdź do dyskusji i wyjaśnij, co się zmieniło.
„Who should be focusing on Reddit isn’t your marketing team at all. They should be your product team.”
4. Nie przerabiaj Wikipedii na broszurę – popraw braki i nieaktualne dane, a potem zostaw ją w spokoju.
Marki, które wiedzą, że AI czerpie z Wikipedii, wpychają tam „award-winning, market-leading”. Jej „strategia wikipedyjna” to uzupełnić braki, zaktualizować nieaktualne fakty i nic poza tym. Zasada ogólna: Wikipedia służy do faktów, Reddit do rozmowy społeczności, a strona marki do wyjaśniania i konwersji.
„But that is missing the point of Wikipedia. Because Wikipedia is there to be factual, mutual, verifiable.”
5. Złota reguła testowania USP: jeśli nie nadaje się na stronę główną, to nie jest USP.
Gdy różne zespoły opisują firmę różnie („platforma e-commerce”, „rozwiązanie cyfrowe”, „innowacyjne oprogramowanie”), AI trudniej powtórzyć jeden przekaz o marce. Wybierz jedną rzecz, z którą marka ma się kojarzyć, i powtarzaj ją we wszystkich kanałach. Prosty test:
„If it’s not strong enough to be on your homepage, it’s not a strong enough USP.”
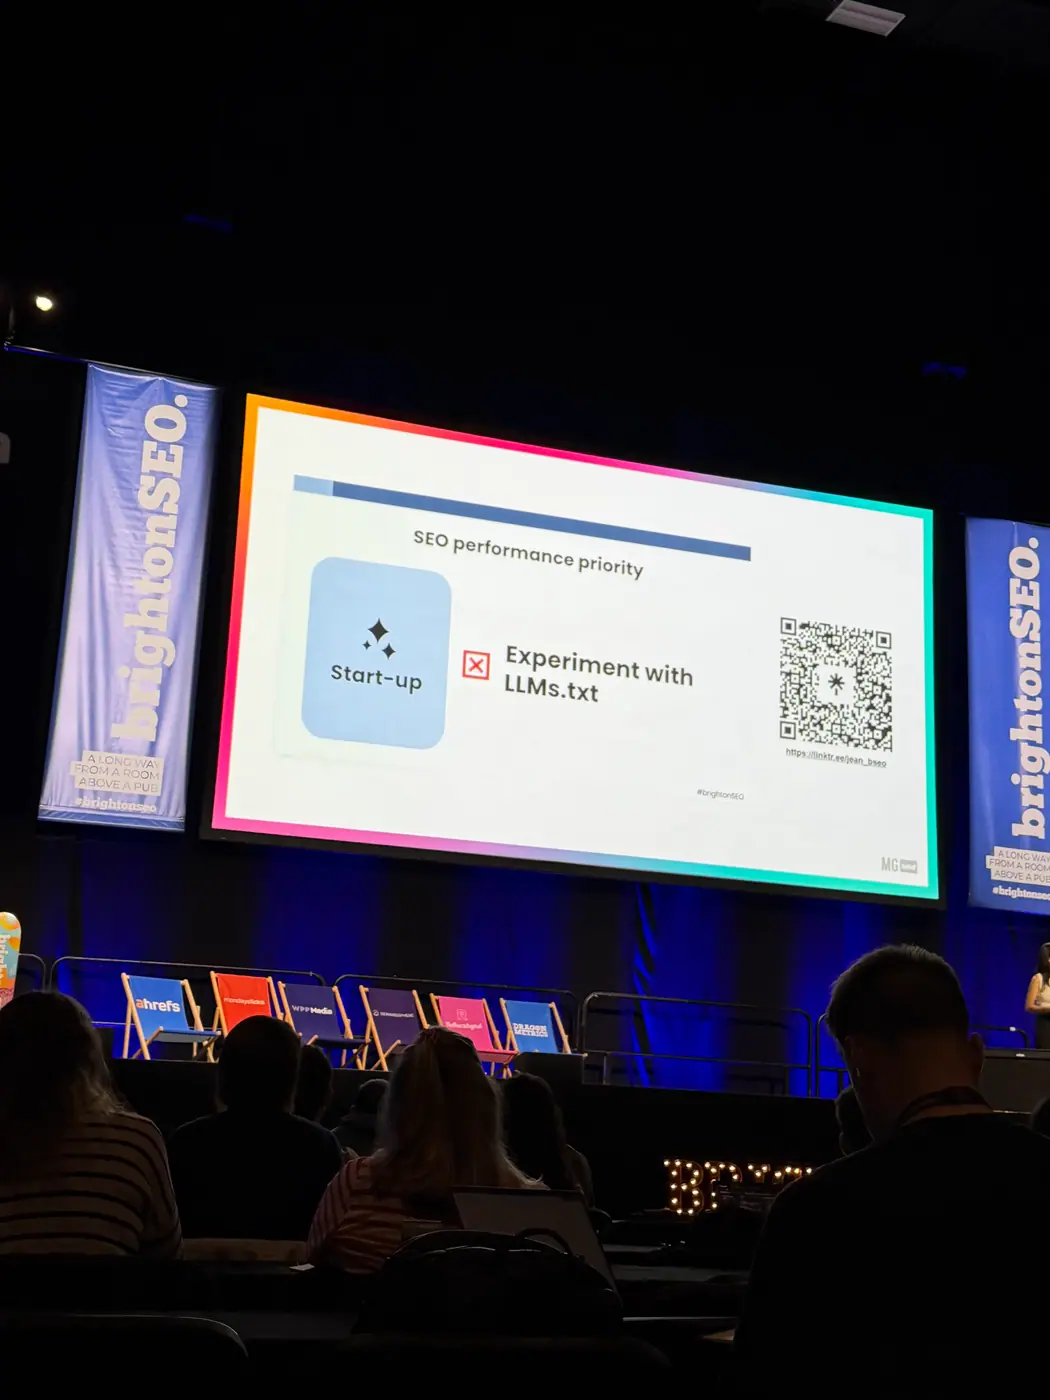
6. Na etapie startowym eksperymenty z llms.txt to strata czasu.
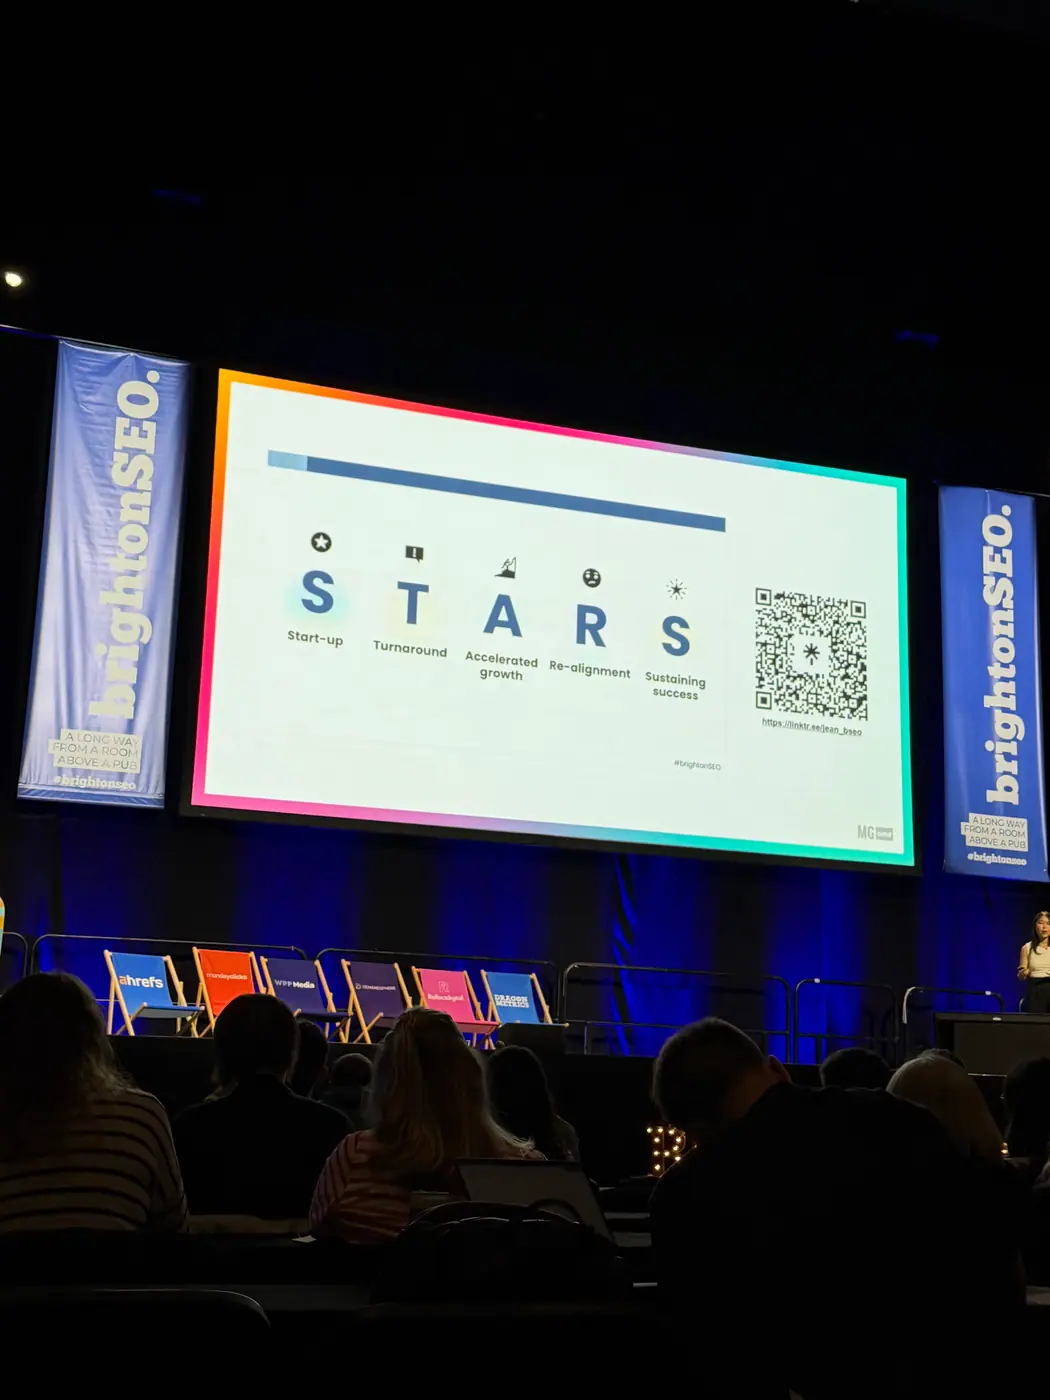
Według jej frameworku STARS priorytety zależą od etapu, na którym jest marka. Przy nowym produkcie, nowym rynku albo nowej stronie (brak sitemapy, zerowy popyt brandowy) zabawa w llms.txt nie ma sensu. Zamiast pytać „co dalej?”, lepiej zapytać, co najbardziej hamuje markę teraz. (W transkrypcji „elements.txt” to llms.txt).
„Your sitemap might not be even set up yet, or maybe there’s no brand search demand at all. It wouldn’t be right for you to start experimenting with elements.txt, for example.”
Zdjęcia: Jean Sarunporn
45 kadrów · Fot. Robert Nowaczyk
Paris Childress: Information Gain: The Missing Metric in Every GEO Content Strategy?
09:50 · Auditorium 1
Streszczenie
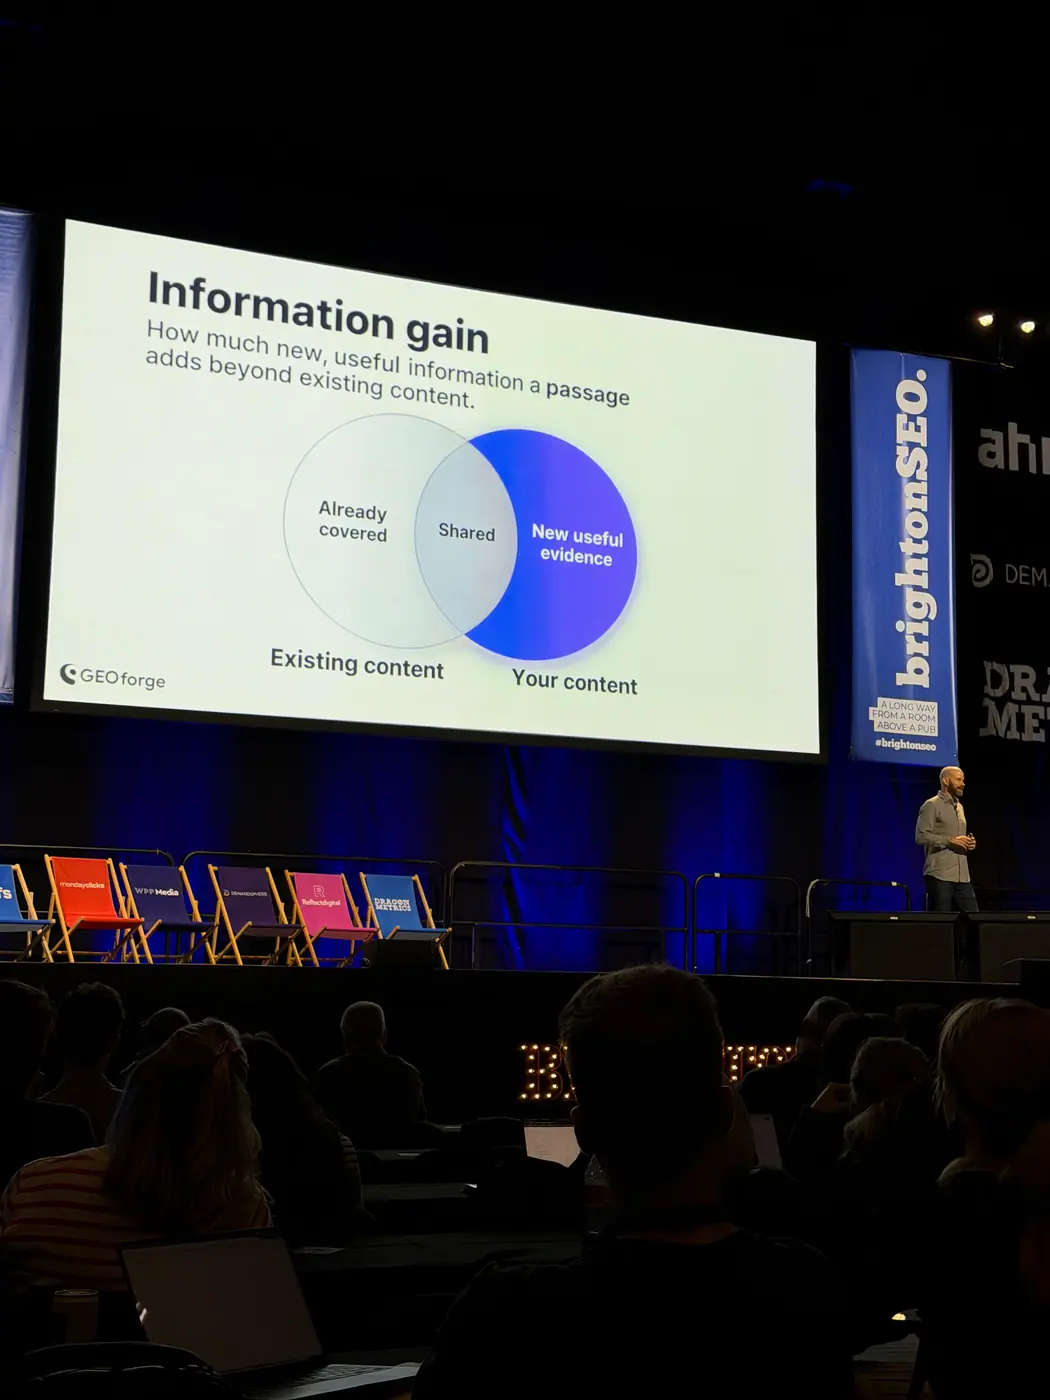
Podczas brightonSEO Paris Childress przedstawił information gain, czyli przyrost nowej, użytecznej informacji, jako potencjalnie brakujący element strategii GEO (Generative Engine Optimization / optymalizacja widoczności w wyszukiwarkach generatywnych).
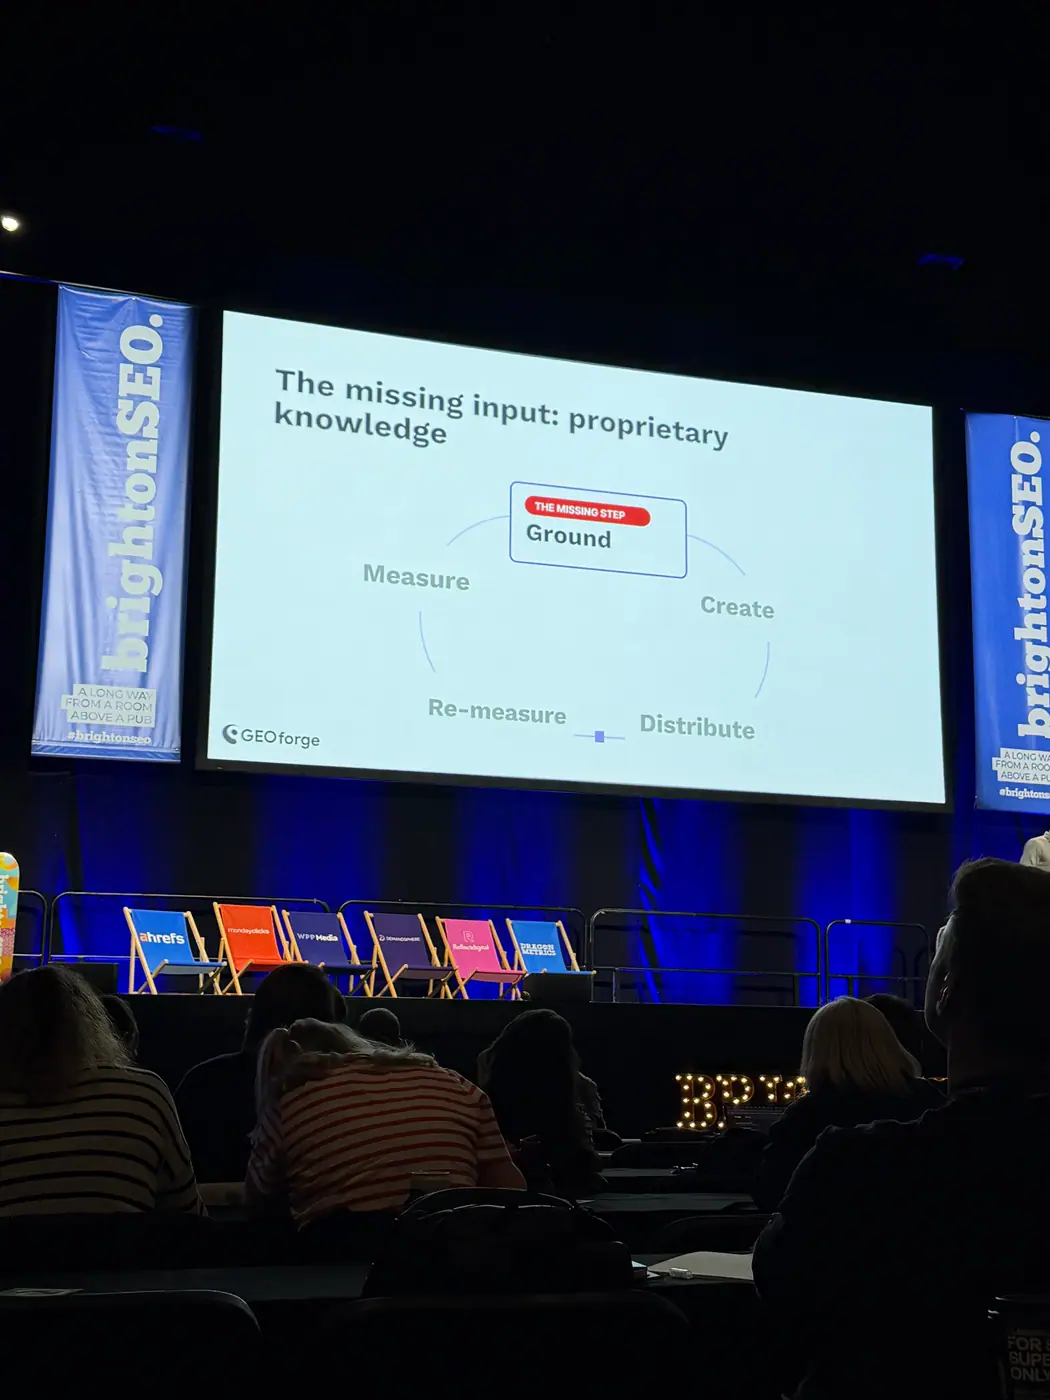
Jego główna teza: przewagę treści tworzonych z pomocą AI (Artificial Intelligence / sztuczna inteligencja) warto budować na wiedzy, której nie ma jeszcze w publicznie dostępnych materiałach. Źródłem mogą być własne badania, rozmowy handlowe i doświadczenie ekspertów.
Prelegent połączył tę koncepcję z trzema obszarami: oceną treści przed publikacją, przygotowywaniem szkiców na podstawie firmowej wiedzy oraz pomiarem efektów wykraczającym poza samą widoczność marki.
Najważniejsze wnioski
Propozycja strategiczna: oceniać wkład informacyjny, nie tylko poprawność tekstu.
Childress zaproponował sprawdzanie, czy publikacja wnosi coś ponad syntezę istniejących materiałów. Wskazał przede wszystkim własne dane, badania i nieopublikowaną wiedzę ekspertów.Obserwacja z wdrożenia: wartościowe treści uzyskiwały cytowania, ale nie dowiedziono przyczynowości.
Prelegent przedstawił wyniki jednej firmy biotechnologicznej. Zaznaczył, że nie dowodził bezpośredniego związku między oceną information gain a cytowaniami. Stosowana skala była jego narzędziem redakcyjnym, nie ujawnioną metryką wyszukiwarek.Propozycja procesowa: kontrolę jakości przesunąć przed pierwszy szkic.
Zamiast generować ogólny tekst i dopiero później szukać dla niego potwierdzeń, Childress zalecił najpierw dostarczyć wiarygodne materiały. Opisał wykorzystanie RAG (Retrieval-Augmented Generation / generowanie wspomagane wyszukiwaniem informacji), łączenie twierdzeń ze źródłami i kontrolę ujawniania danych wrażliwych.Obserwacja pomiarowa: zbiorcza widoczność ukrywa różnice między systemami.
W przedstawionym przypadku większość wzrostu pochodziła z Google AI Overviews i AI Mode, a nie z ChatGPT. Prelegent zalecił analizowanie każdego środowiska osobno, zamiast opierania oceny wyłącznie na łącznym share of voice, czyli udziale marki w widoczności na tle konkurencji.Opinia i kierunek rozwoju: widoczność powinna prowadzić do pomiaru szans sprzedażowych.
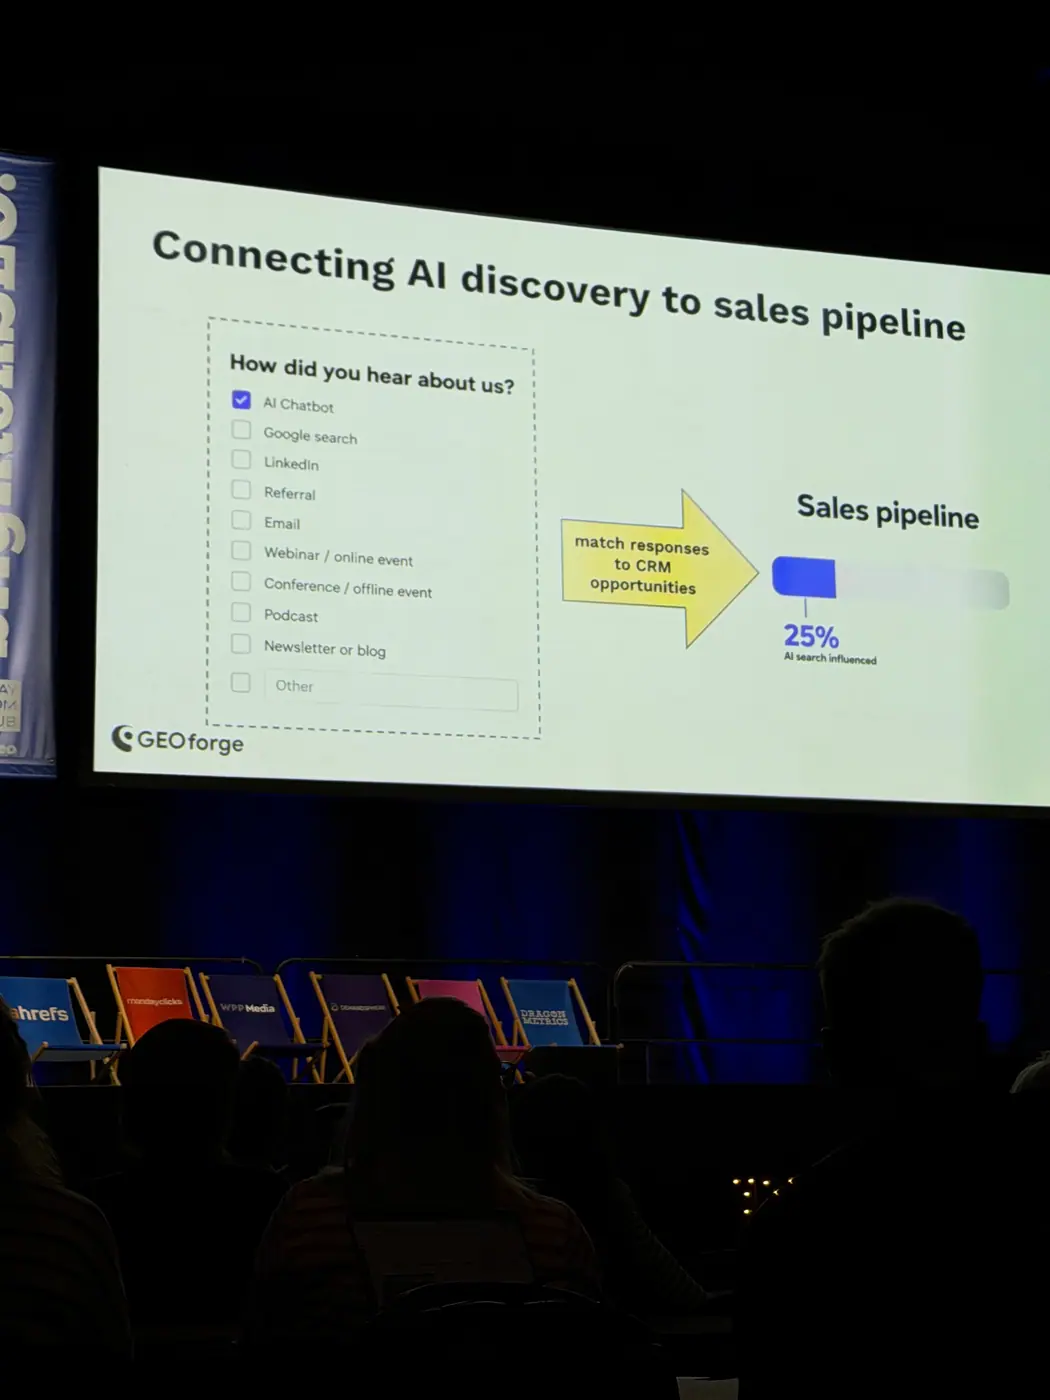
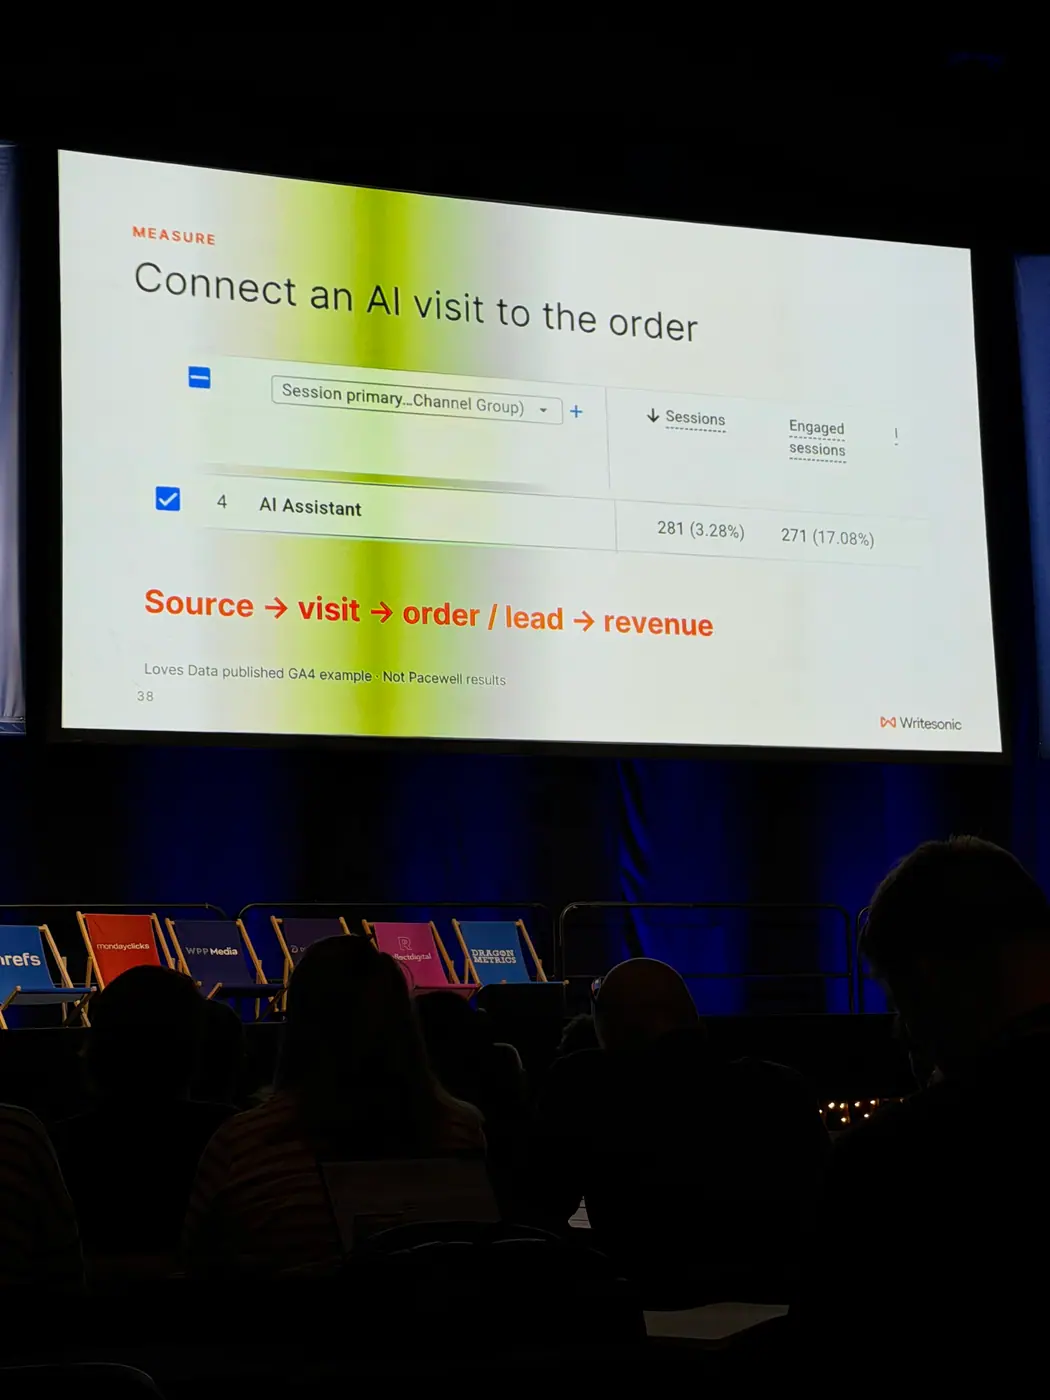
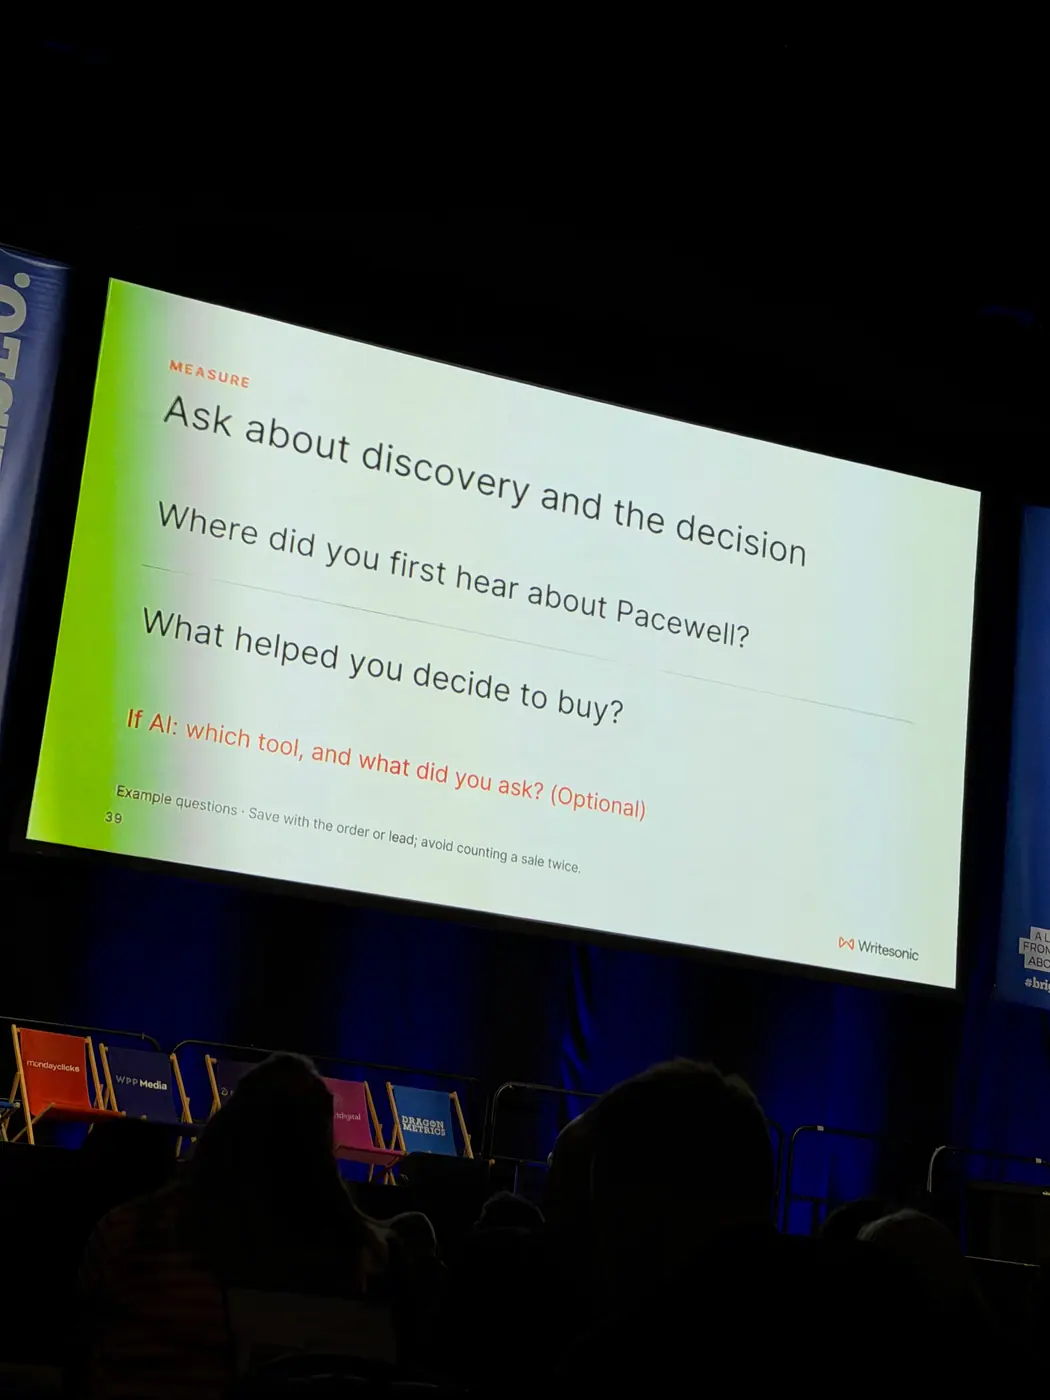
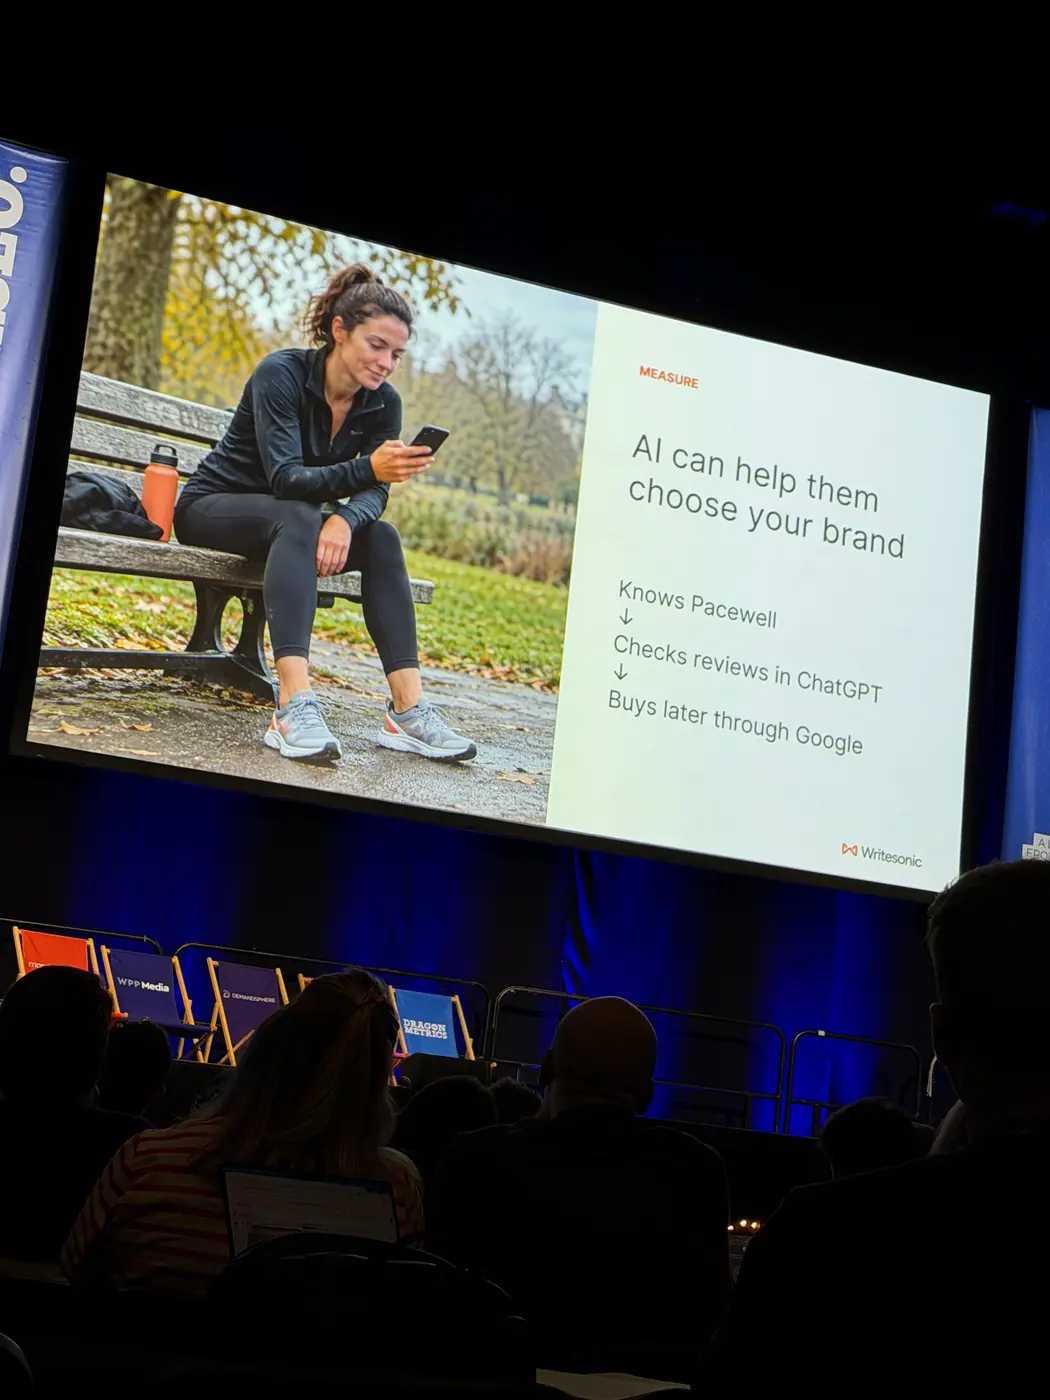
Childress ocenił samą widoczność jako potencjalnie powierzchowną miarę sukcesu. Zaproponował zbieranie deklaracji klientów o źródle kontaktu i łączenie ich z dalszymi etapami sprzedaży. To dodatkowy sygnał atrybucyjny, nie samodzielny dowód wpływu GEO na przychody.Ważne rozróżnienie interpretacyjne: udostępnienie wiedzy nie oznacza trenowania modelu.
W prezentacji pojawiał się język „uczenia AI”. Praktyczny proces dotyczył jednak również wyszukiwania i wykorzystywania opublikowanych informacji przy tworzeniu odpowiedzi. Nie należy przedstawiać publikacji treści jako gwarancji aktualizacji wiedzy modelu ani późniejszego cytowania.
Dane liczbowe i przykłady
| Dane | Co oznaczały w prezentacji |
|---|---|
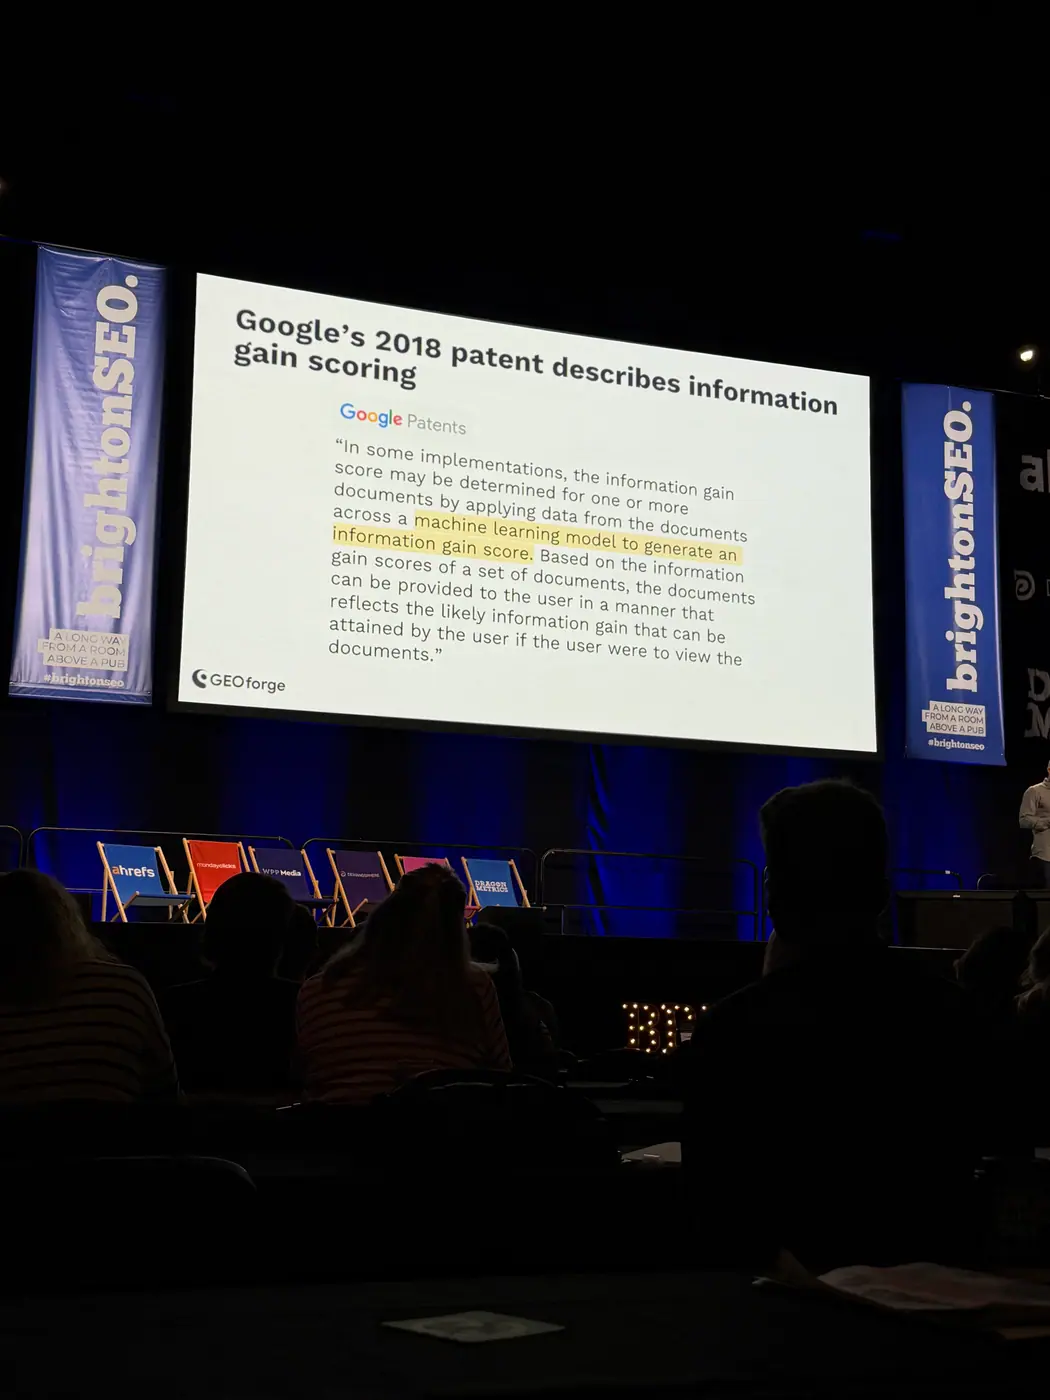
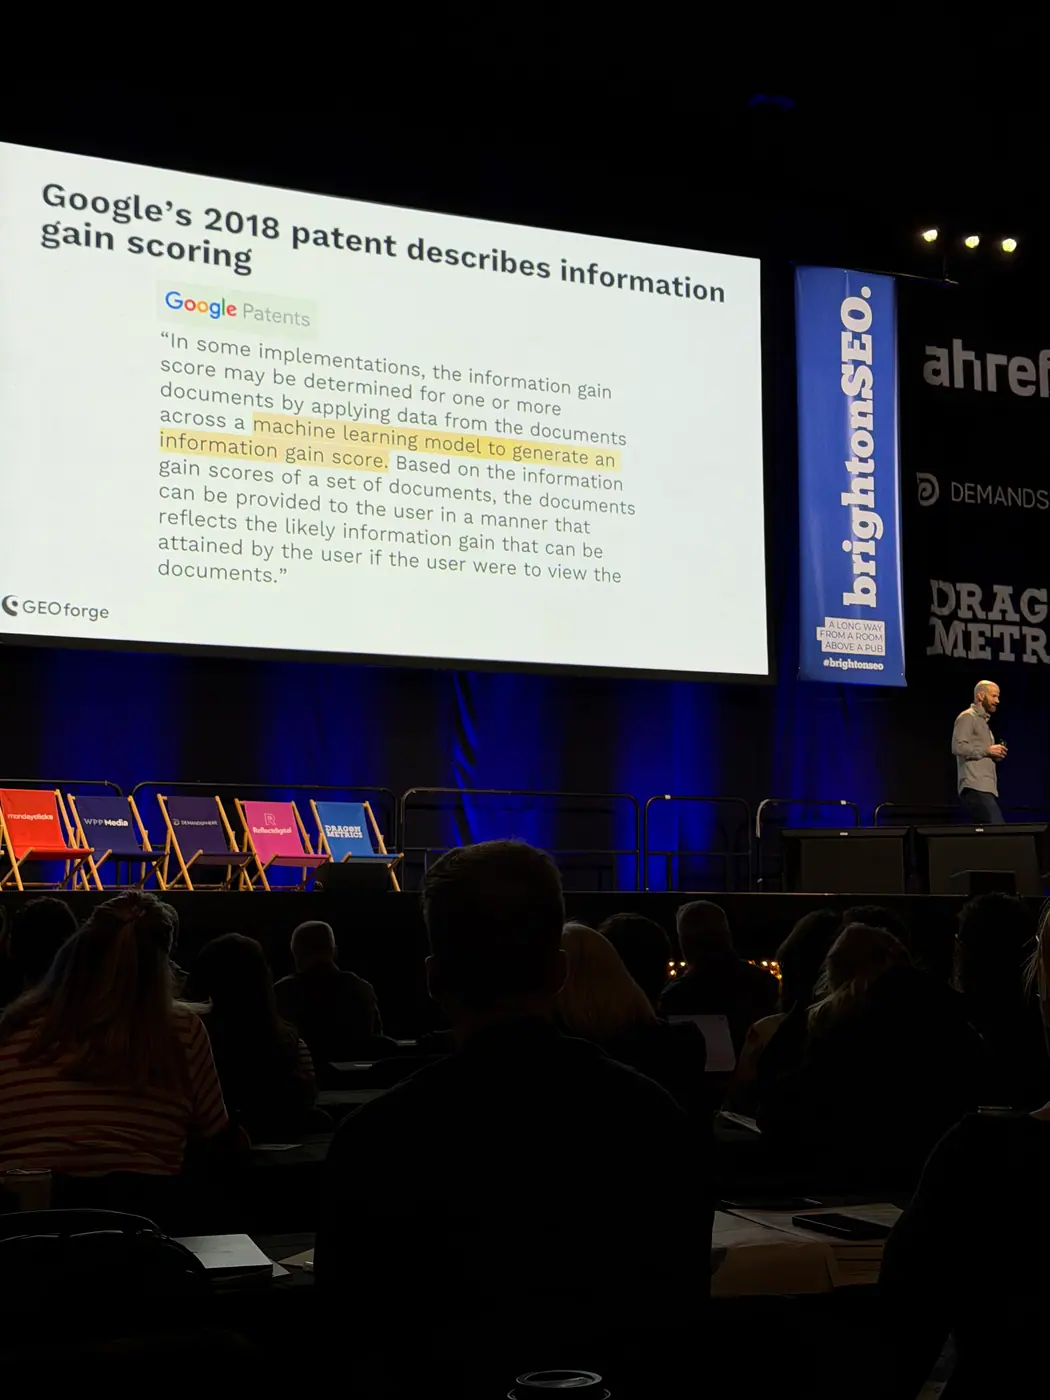
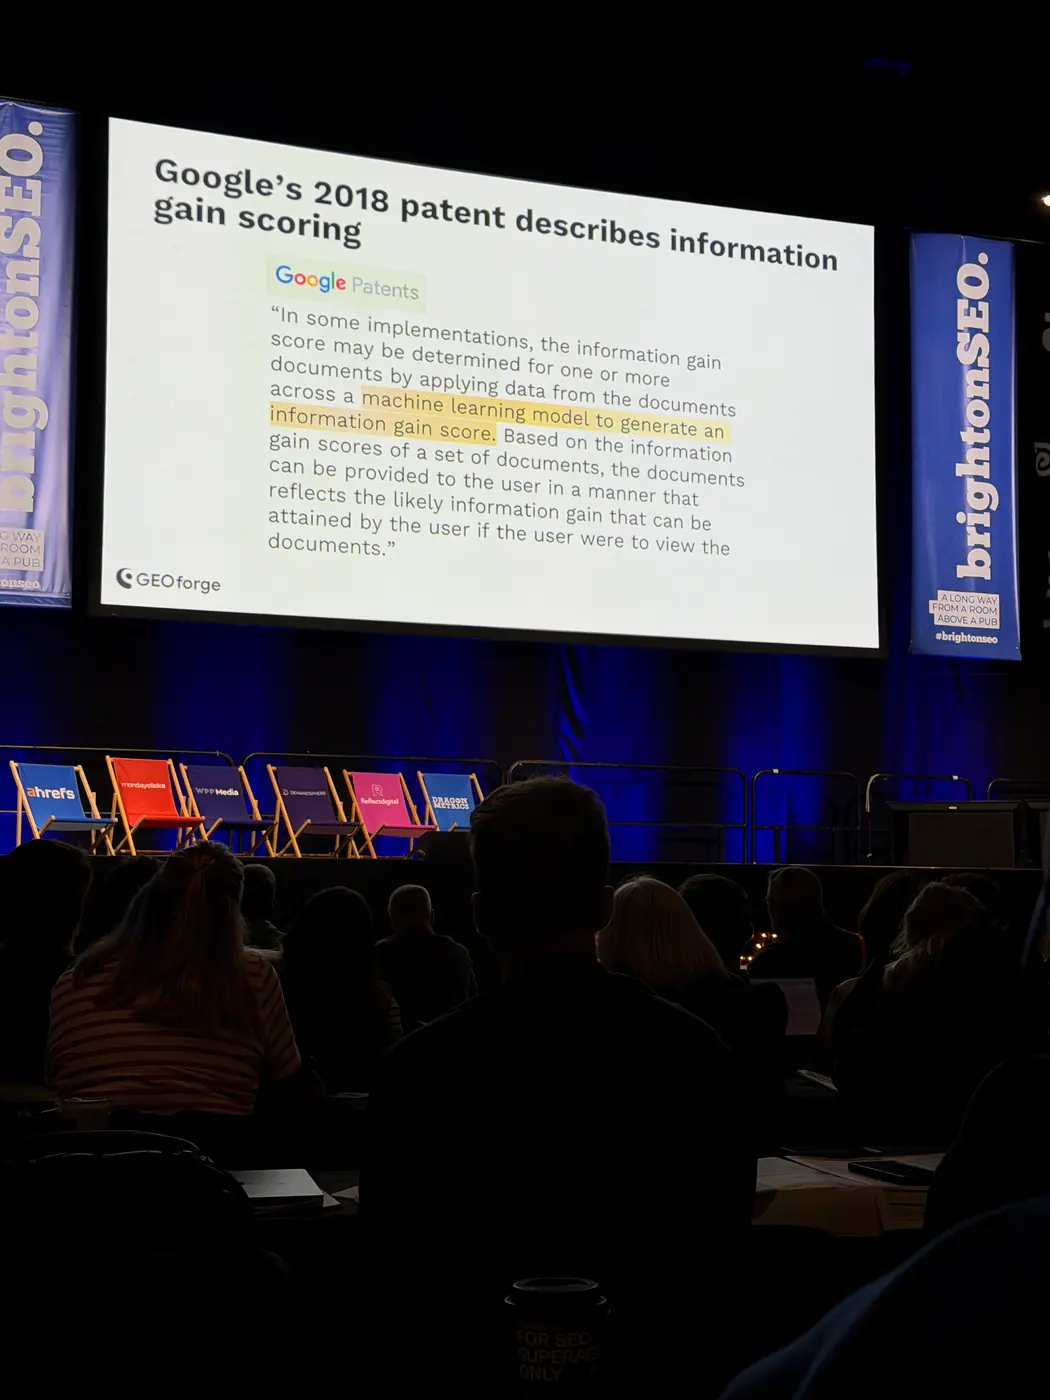
| 2018 i 2022 | Childress podał te lata jako daty zgłoszenia i przyznania patentu Google dotyczącego information gain. Przywołanie patentu nie potwierdzało wykorzystania jego własnej skali w rankingach. |
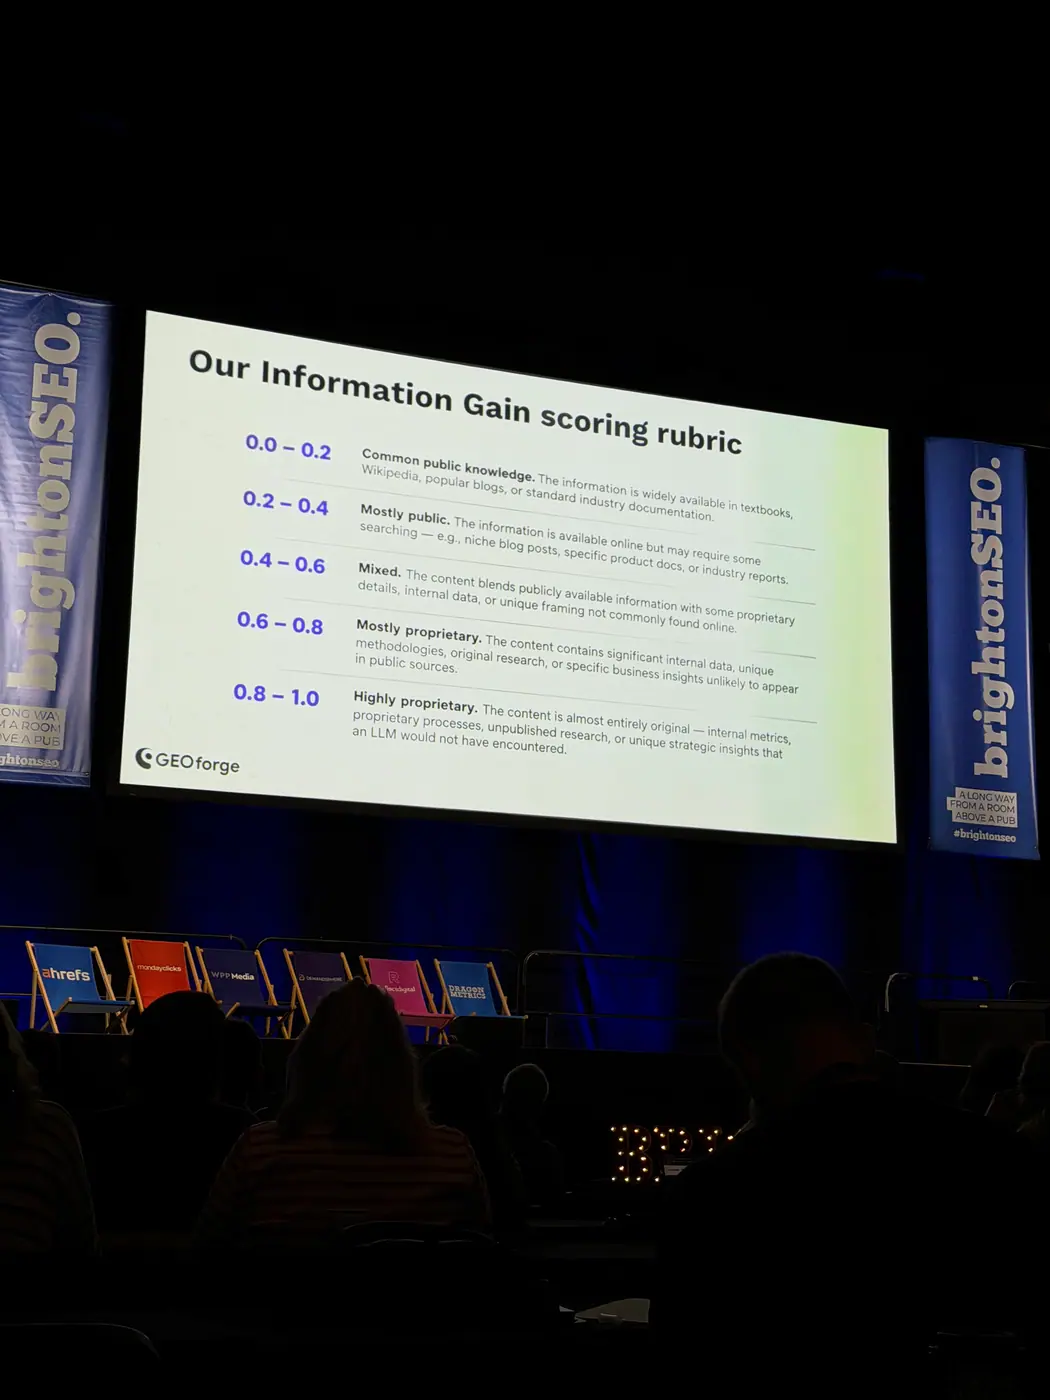
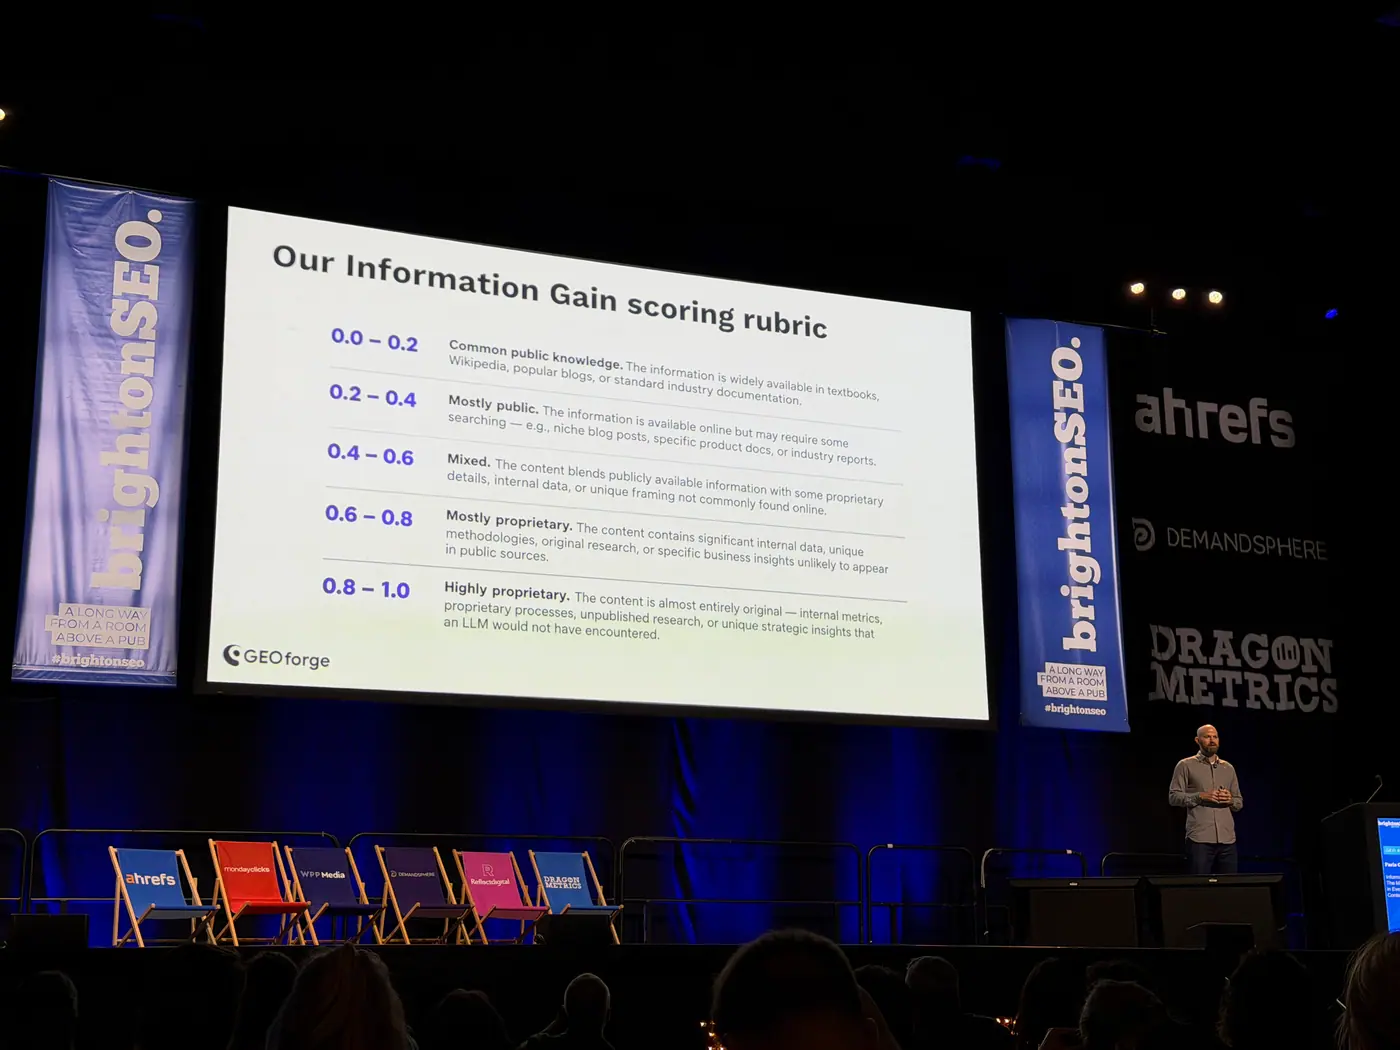
| 0–0,2 oraz 80–90% | W autorskiej ocenie niski wynik oznaczał treść niewnoszącą istotnej nowej wiedzy. Przy wysokim wyniku prelegent oczekiwał lepszych rezultatów. Była to propozycja oceny, nie uniwersalny standard. |
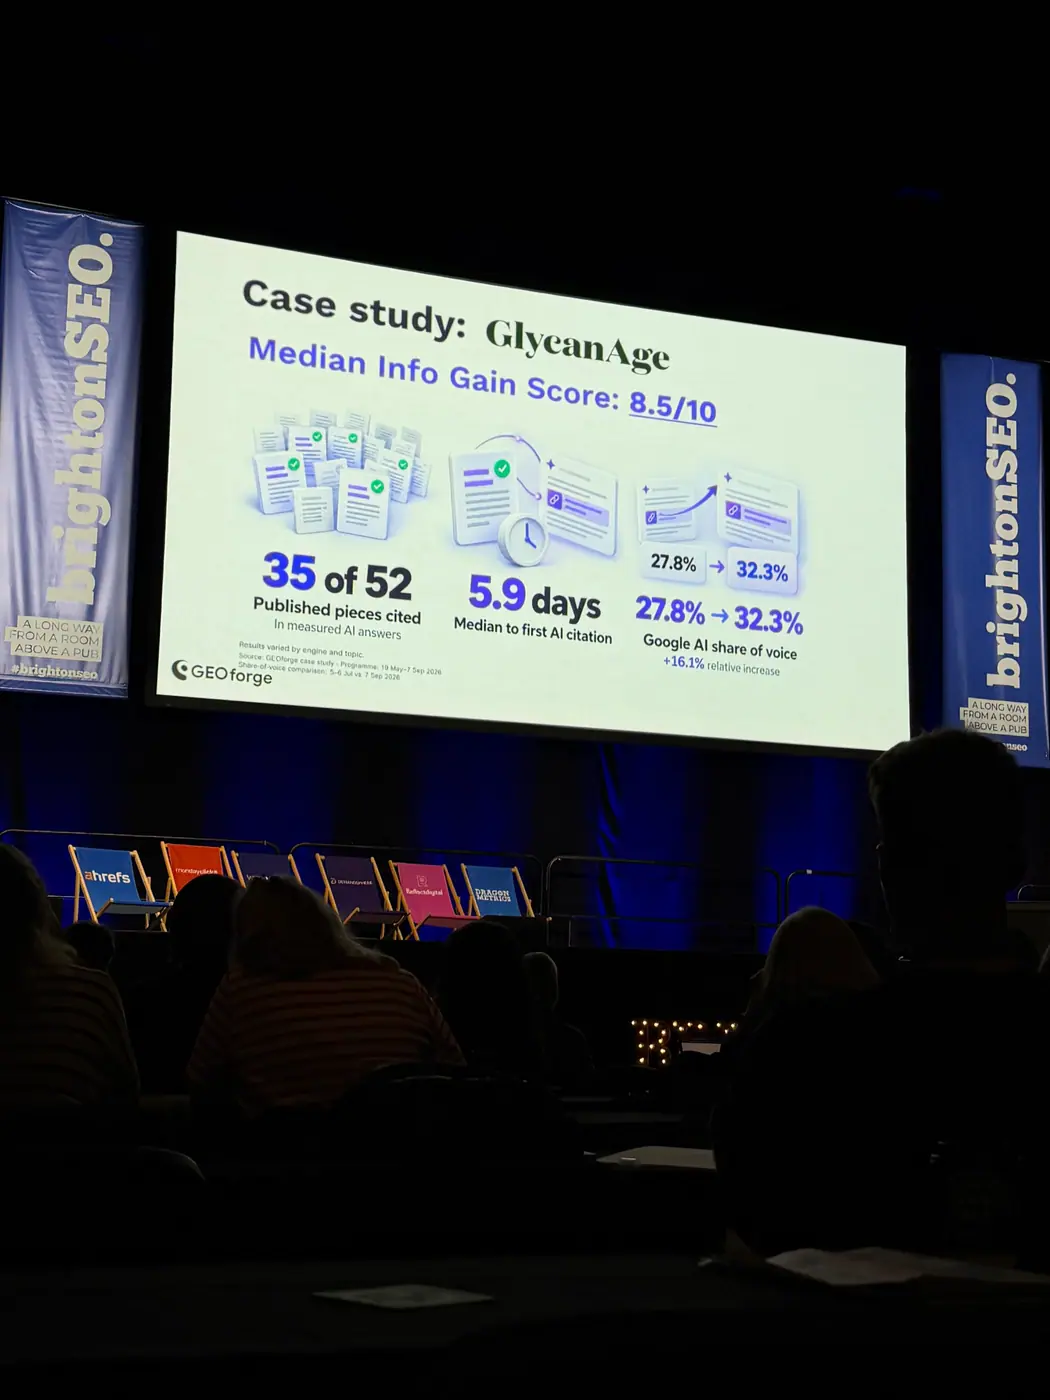
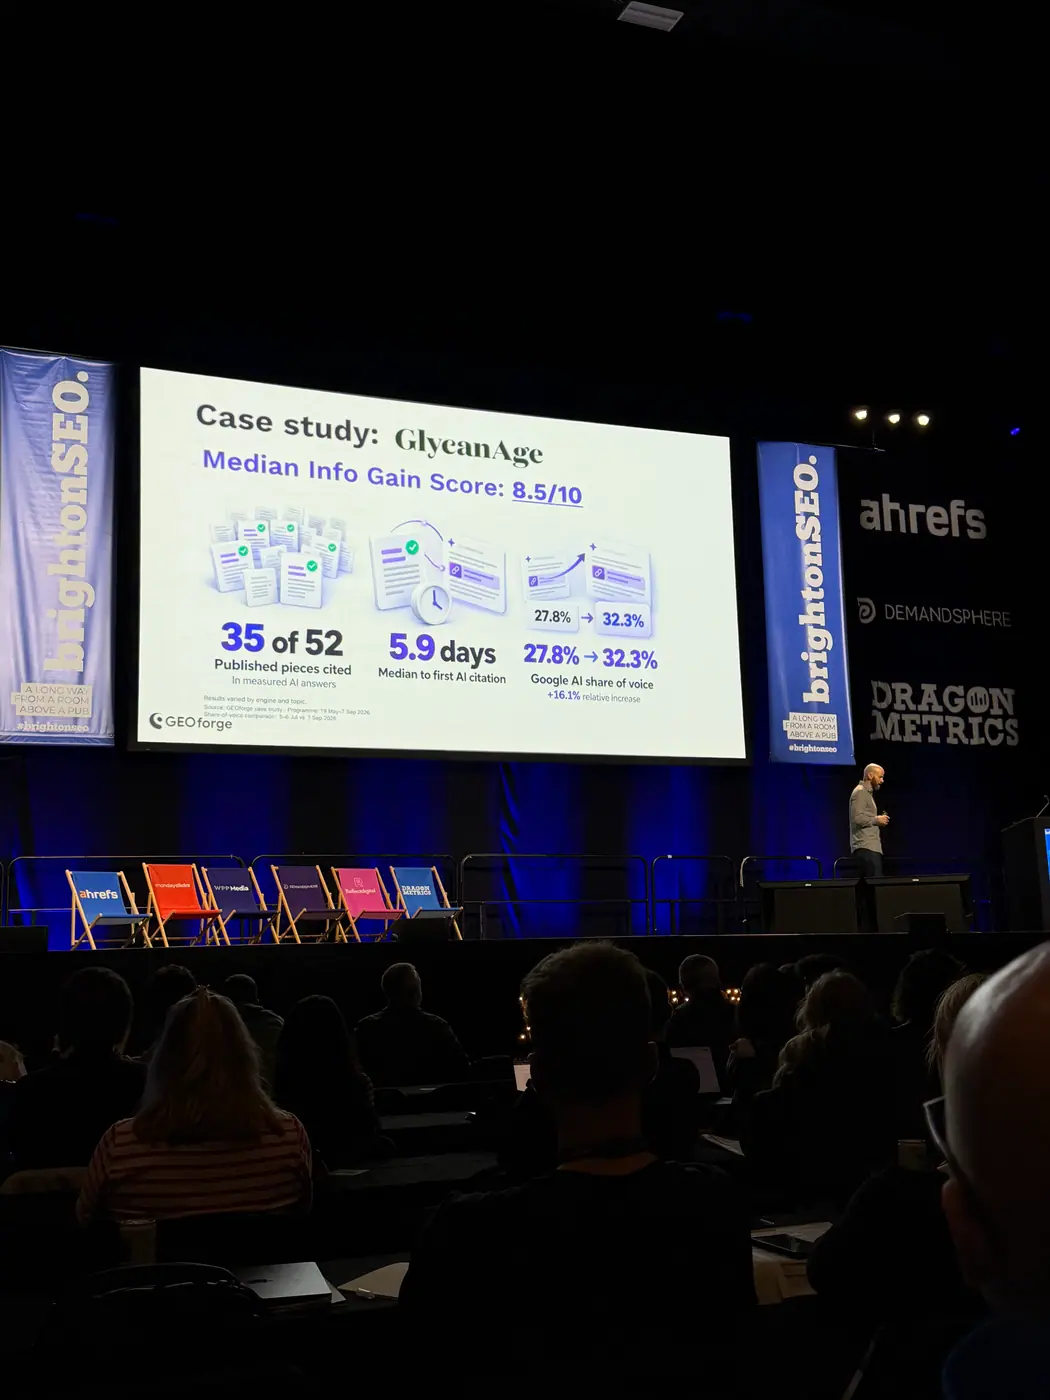
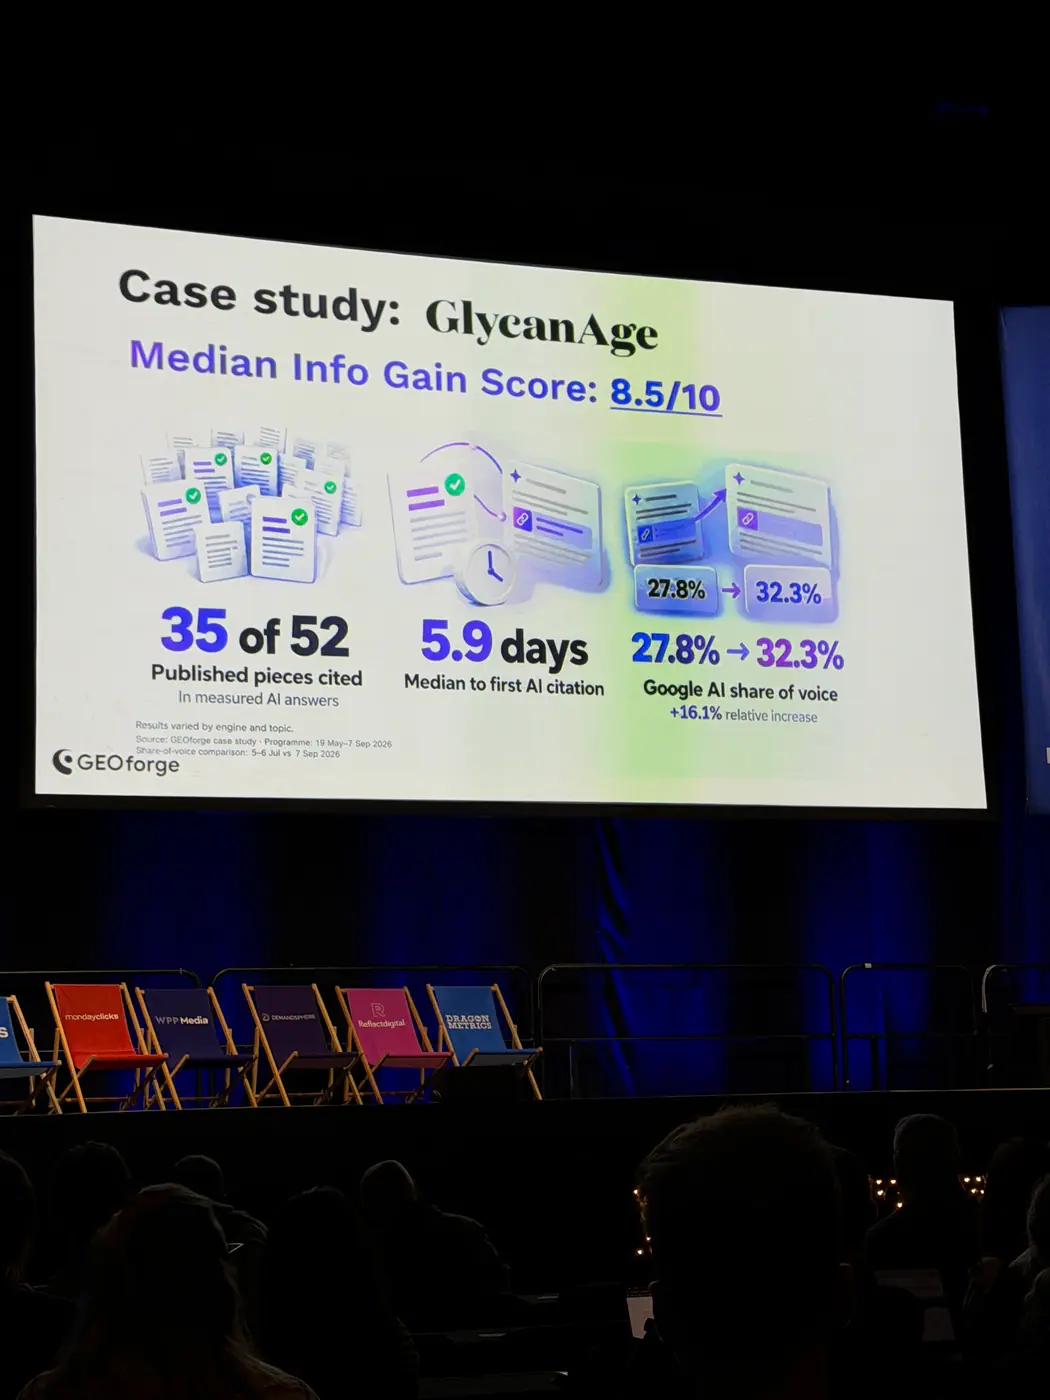
| Nieco ponad 52 publikacje; 35 cytowanych w mniej niż 6 dni | Wynik zaraportowany dla jednej firmy biotechnologicznej. |
| Średnio 8,5/10 | Przeciętna ocena information gain publikowanych treści tej firmy. |
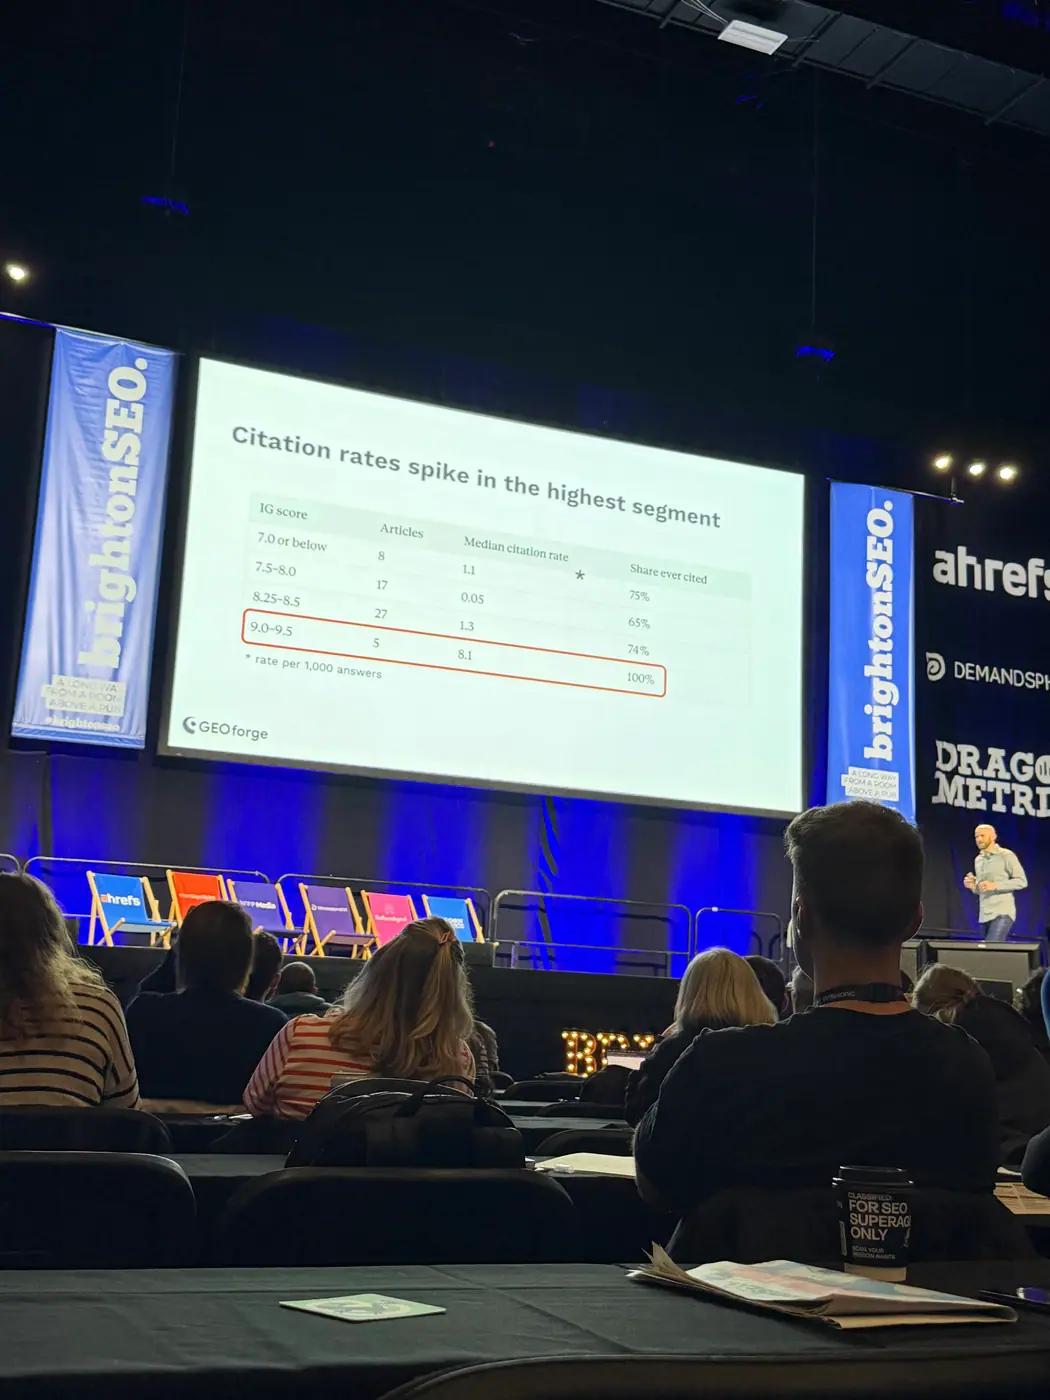
| Około 9/10 | W okolicach tego poziomu Childress zaobserwował skok częstotliwości wzmianek o marce. Nie opisał regularnej zależności w całym zakresie ocen. |
| Około 15% uczestników | Szacunek prelegenta po podniesieniu rąk przez osoby nagrywające wszystkie spotkania. Nie był to wynik badania rynku. |
| 10–15 minut | Proponowany czas wywiadu z ekspertem, pozwalającego pozyskać wiedzę bez wymagania od niego napisania artykułu. |
| Wzrost z 10% do 20% po dwóch kwartałach | Hipotetyczny przykład udziału leadów deklarujących kontakt przez AI. To wzrost o 10 punktów procentowych, nie przedstawiony wynik klienta ani dowód wzrostu wartości sprzedaży. |
Praktyczne rady
- Zacznij od inwentaryzacji wiedzy. Sprawdź własne badania, dokumentację, rozmowy z klientami i materiały ekspertów. Oddziel wiedzę możliwą do publikacji od informacji poufnych.
- Dostarczaj dowody przed generowaniem tekstu. Przygotuj materiały źródłowe i wymagaj powiązania kluczowych twierdzeń z konkretnymi źródłami. Takie podejście może ograniczać pracę redakcyjną, ale nie uzasadnia rezygnacji z weryfikacji.
- Wprowadź ocenę wkładu informacyjnego przed publikacją. Sprawdzaj, jakie nowe dane, przykłady lub odpowiedzi otrzyma odbiorca. Traktuj ocenę jako kontrolę jakości, nie obietnicę cytowania.
- Rozdziel pomiar widoczności. Analizuj osobno poszczególne systemy, cytowania publikacji i wzmianki o marce.
- Połącz deklaracje klientów ze sprzedażą. Pytaj neutralnie, jak dowiedzieli się o firmie, i zapisuj odpowiedzi w CRM (Customer Relationship Management / system zarządzania relacjami z klientami). Sugerowane przez prelegenta umieszczenie opcji „chatbot AI” na pierwszym miejscu mogłoby wpływać na wybór odpowiedzi, dlatego nie warto traktować tego jako sposobu poprawiania pomiaru.
Knowledge bombs
1. Ocena „information gain” każdej treści przed publikacją – poniżej 0,2 nie warto publikować.
Jego zespół ocenia każdy tekst przed publikacją według rubryki zbudowanej z pomocą AI: ile nowej wiedzy wniesie dla crawlerów AI. Wynik 0–0,2 oznacza „nie publikować”, a okolice 80–90% to treść, po której spodziewają się dobrych wyników. Prelegent przypomina, że koncepcja ma korzenie w patencie Google na system oceny information gain (zgłoszony w 2018, przyznany w 2022).
„And so if we have a piece of content that’s a zero to a 0.2, it’s probably not ready to publish, and we probably shouldn’t even bother, actually, because it will not contribute any net new knowledge or training to AI.”
2. Efekt progowy: wzmianki rosną skokowo dopiero przy wyniku information gain około 9/10.
U klienta z branży biotech (w transkrypcji „Viking Age”) nie widzą korelacji między wynikiem a wzmiankami aż do około 9/10, a powyżej tego progu wskaźnik wzmianek marki wyraźnie skacze. Prelegent zaznacza, że zbiór danych jest niewielki. Wniosek praktyczny: treść „całkiem niezła” może nie dawać żadnego efektu w AI.
„there is really no correlation until you get to an information gain score of let’s say 9 out of 10, and then we see a spike in the brand mention rate.”
3. Treści o wysokim information gain przynosiły wzrosty głównie w Google AI Overviews / AI Mode, a nie w ChatGPT.
W tym samym case większość wzrostu share of voice pochodziła z AI Overviews i AI Mode. Prelegent podkreśla, że share of voice trzeba rozbijać na poszczególne modele, bo zachowują się bardzo różnie. Wynik „blended” ukrywa te różnice.
„the majority of the share of voice gains are coming more from Google AI overviews and AI mode as opposed to chat GPT.”
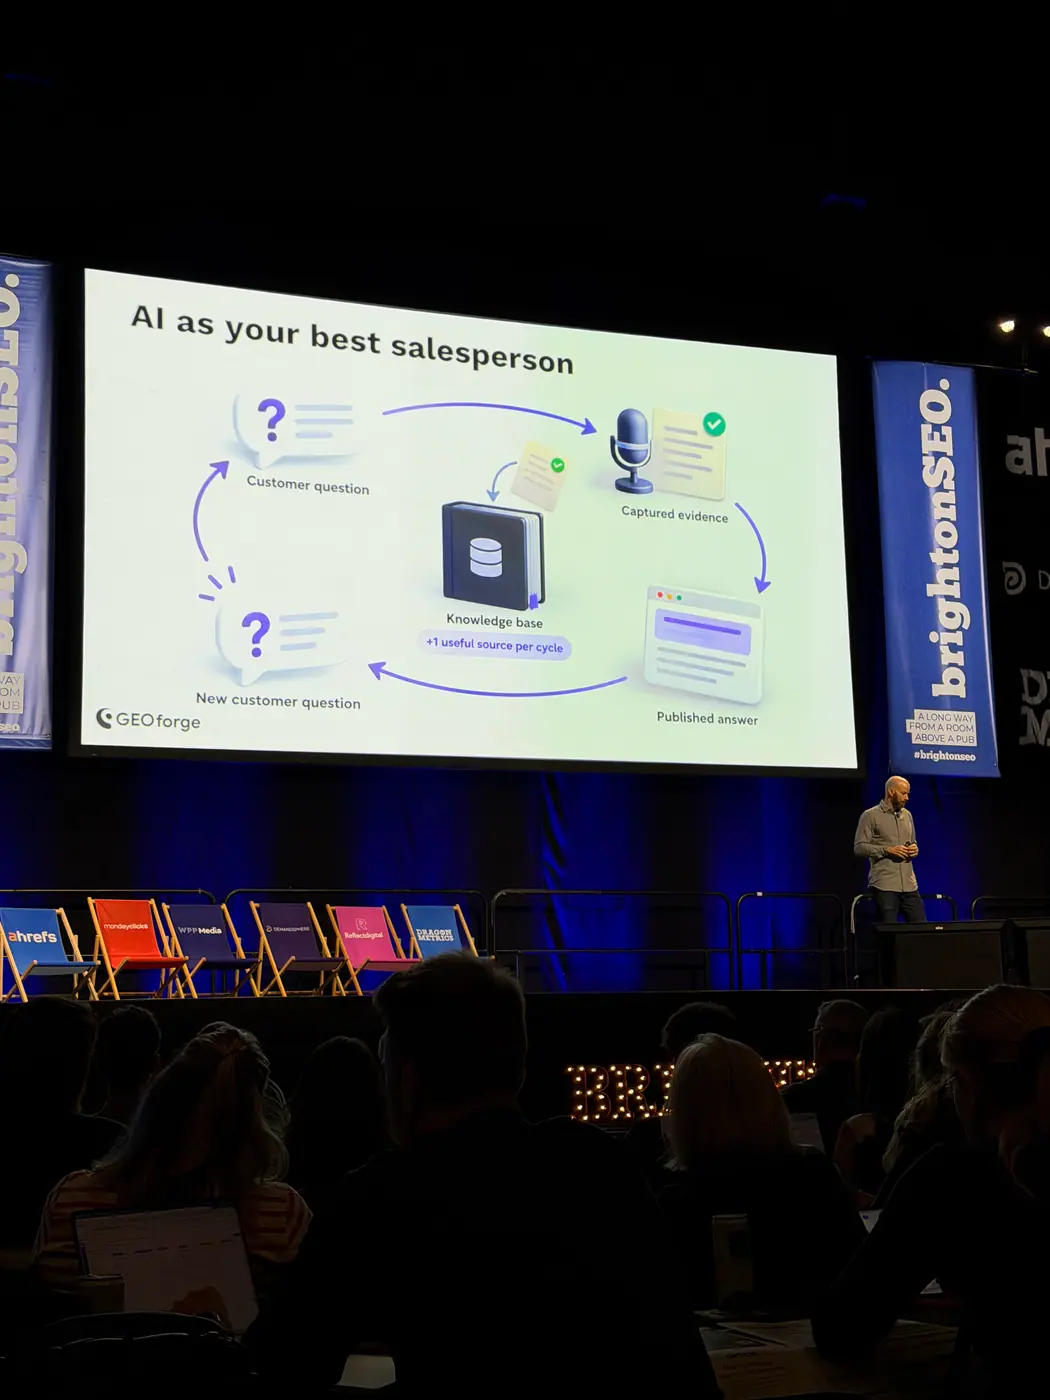
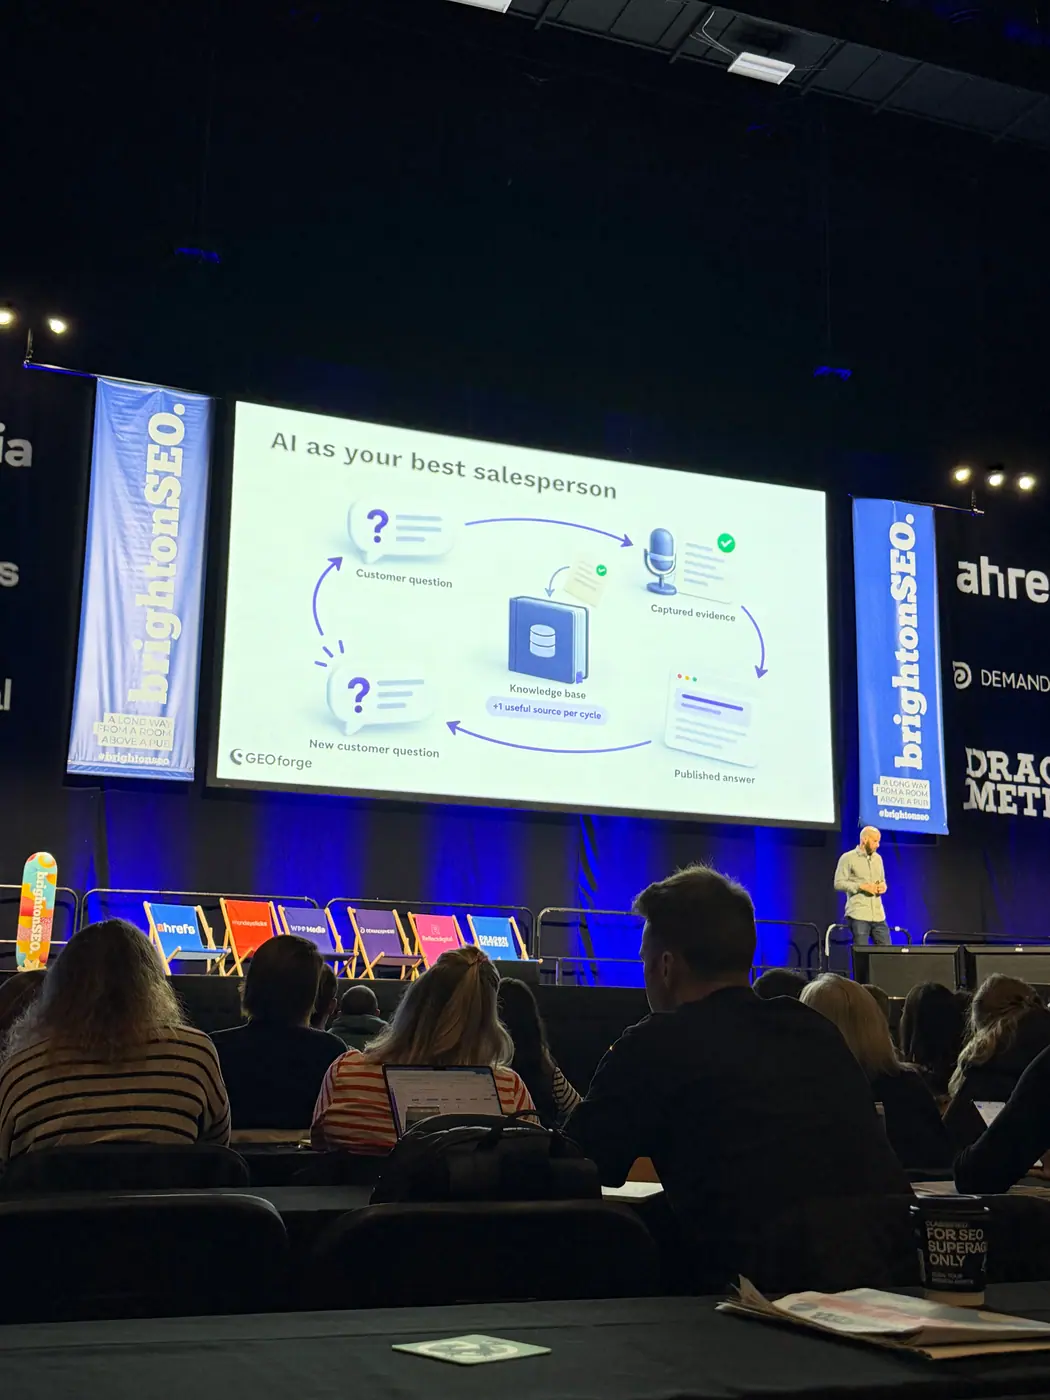
4. Zbuduj własny RAG do contentu: wektorowa baza wiedzy firmy jako źródło „ugruntowanych” draftów.
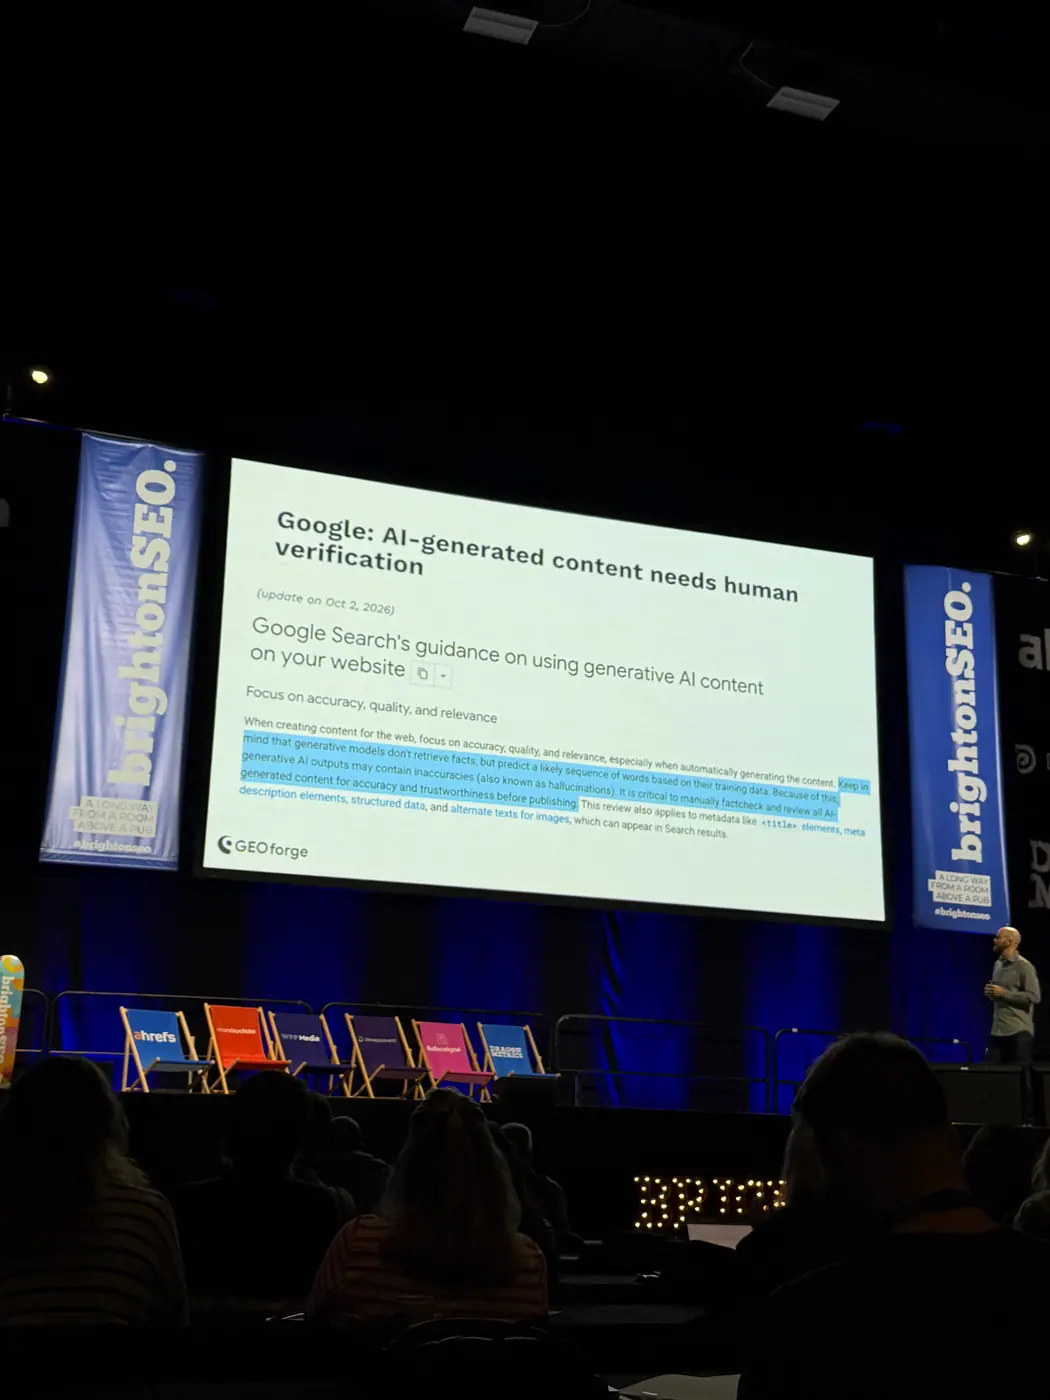
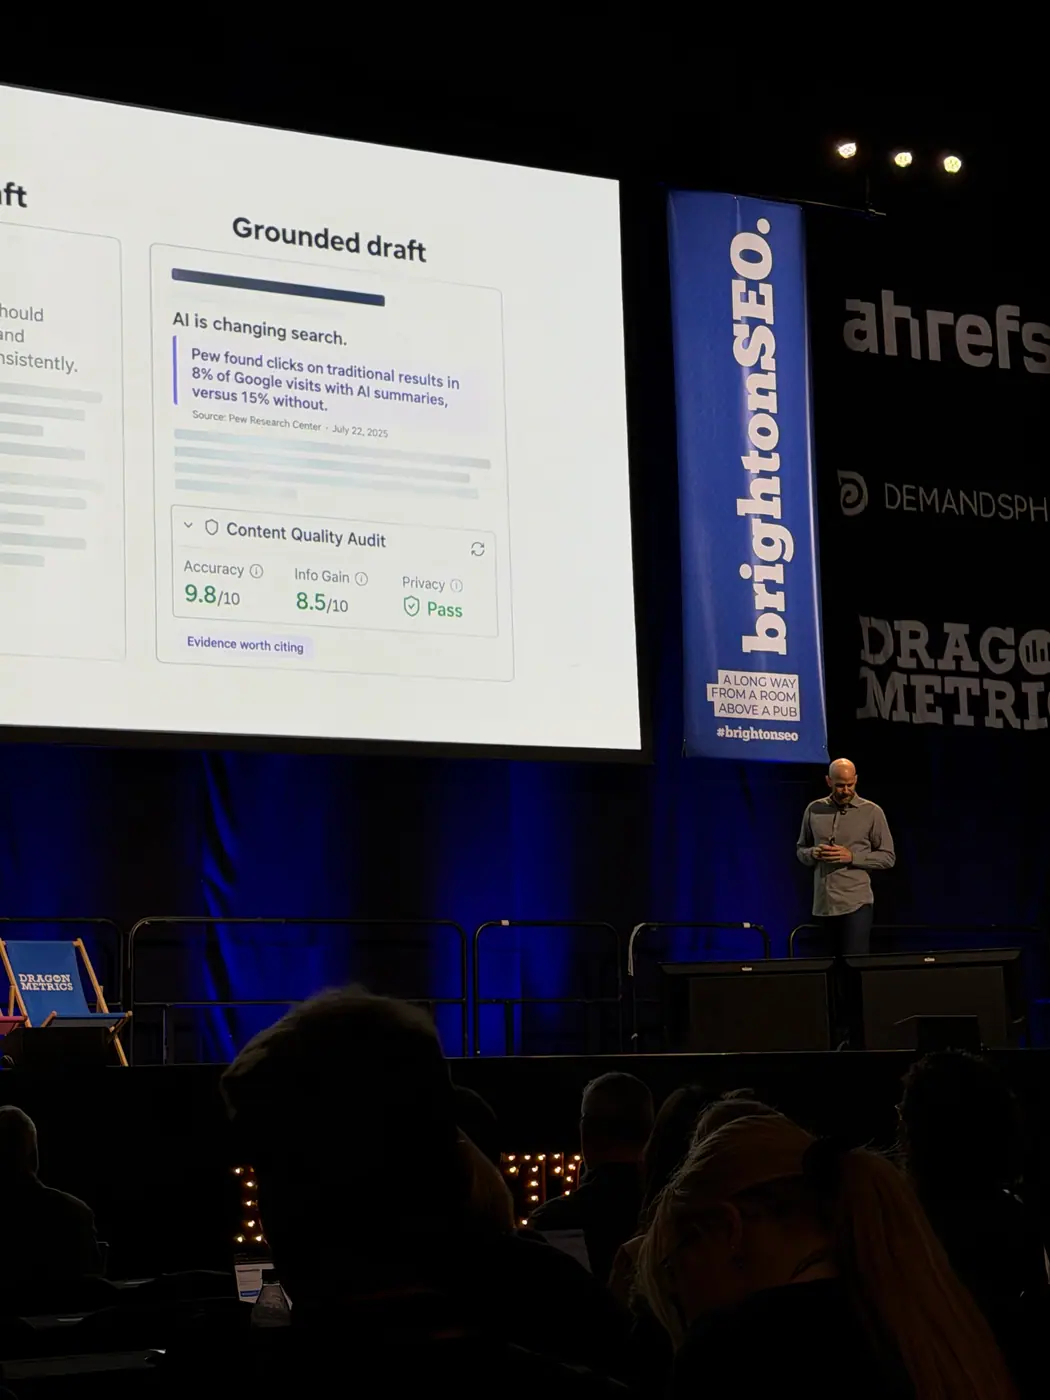
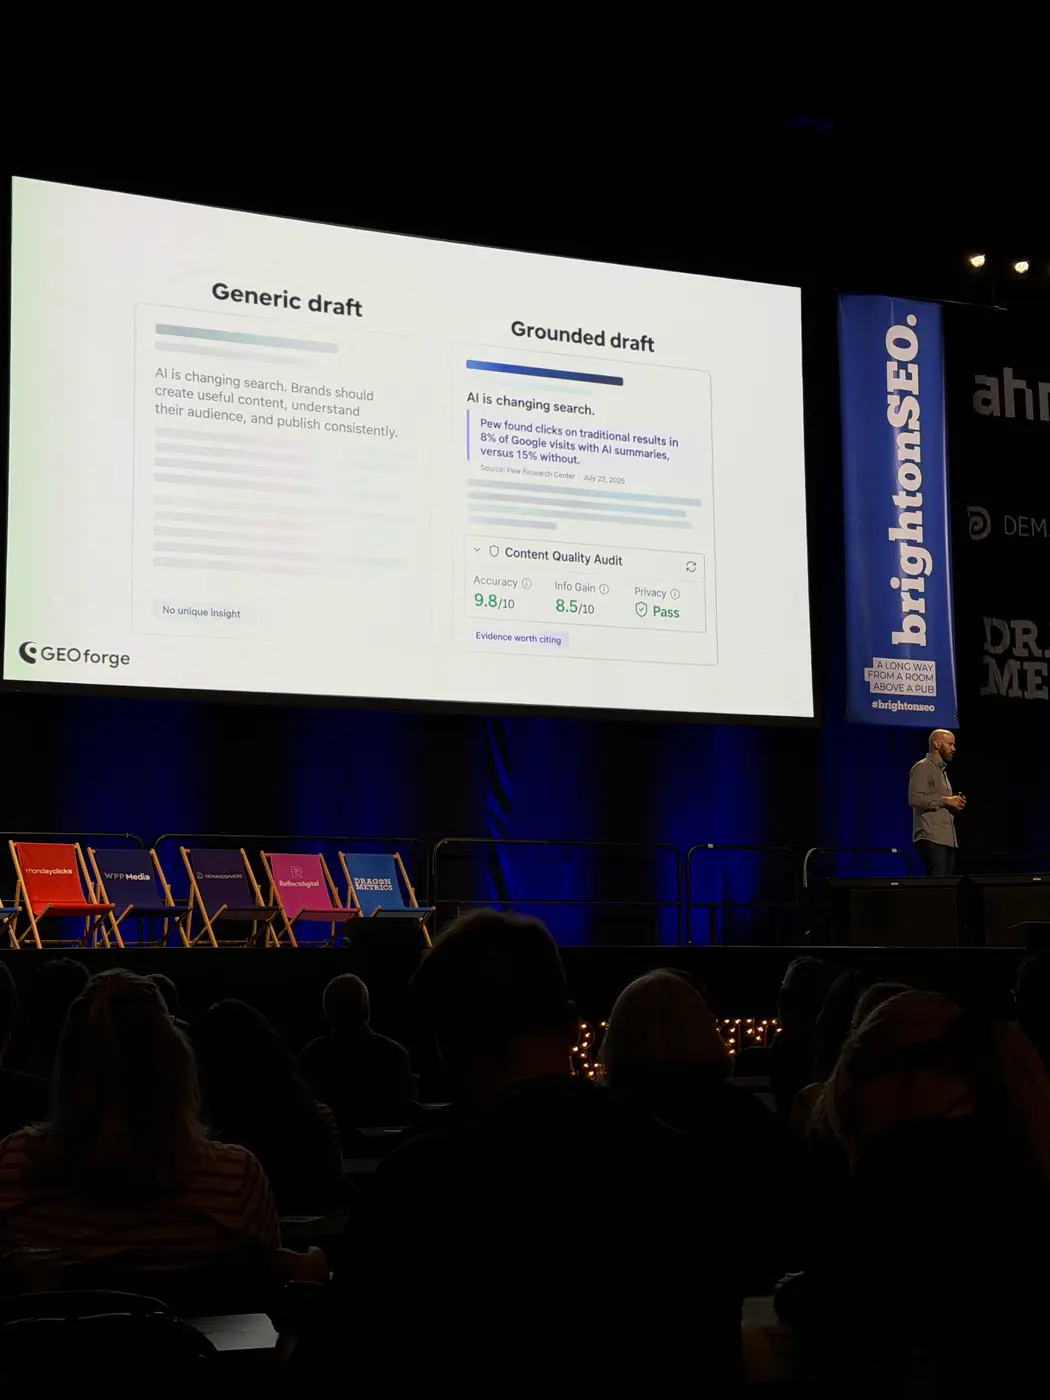
Odpowiedź na apel Google o rygorystyczną redakcję treści AI to przesunięcie kontroli jakości przed etap draftu. Wiedzę firmy (PDF-y, transkrypcje, audio, wideo) dzieli się na chunki w bazie wektorowej, a draft powstaje na jej podstawie. Każdy draft ocenia się pod kątem trafności względem bazy i information gain oraz przepuszcza przez etap pass/fail, który sprawdza, czy nie wyciekły dane wrażliwe. Efekt to mniej fact-checkingu po fakcie.
„Build a vector database, contribute knowledge into that database on an ongoing basis so that we can ground our content production from that knowledge base and we can tether it.”
5. Najlepsze źródło unikalnej wiedzy to nagrania rozmów sprzedażowych i krótkie wywiady głosowe z ekspertami.
Codzienne transkrypcje rozmów handlowych dają długi ogon pytań kupujących, czyli tych samych pytań, które zadają oni ChatGPT, Gemini i Claude przed demo. Eksperci, którzy nigdy nie napisaliby bloga, chętnie przejdą 10–15-minutowy wywiad z voice AI. Prelegent ocenił, że nagrywa wszystkie spotkania tylko około 15% sali.
„subject matter experts who in prior days would never sit down and write a blog post for you, with AI, especially with voice AI, you can put them through a 10 or 15 minute interview process that’s actually fun and they get to share their knowledge”
6. Share of voice to metryka próżności, a w formularzu „skąd o nas wiesz?” odpowiedź „AI chatbot” daj na górę listy.
Childress uważa share of voice za odpowiednik pozycji w SEO, czyli vanity metric. Proponuje deklaratywną atrybucję w formularzu konwersji, połączoną z CRM i szansami sprzedażowymi. Trik psychologiczny polega na tym, żeby postawić „AI chatbot” jako pierwszą opcję, bo użytkownicy często nie odróżniają AI Overview od zwykłego Google.
„where they answer this question, how did you hear about us? And it’s a little psychological trick to put AI chat bot at the top because some people may not remember”
Zdjęcia: Paris Childress
27 kadrów · Fot. Robert Nowaczyk
Samanyou Garg: Drowning in prompts? How to build an AEO program around the data that matters
10:10 · Auditorium 1
Streszczenie
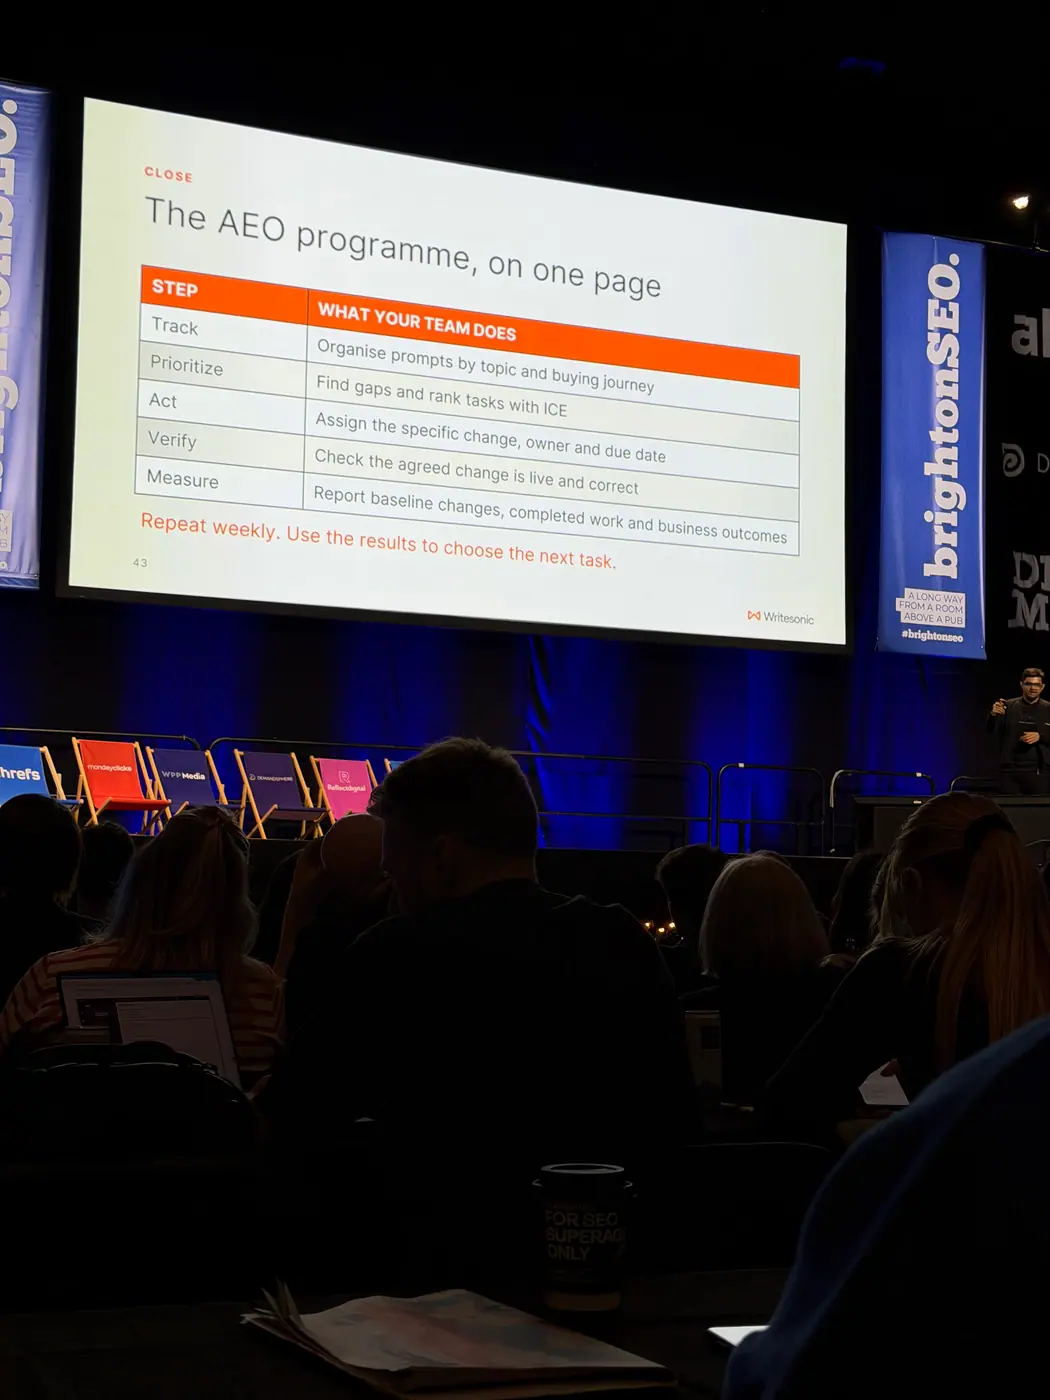
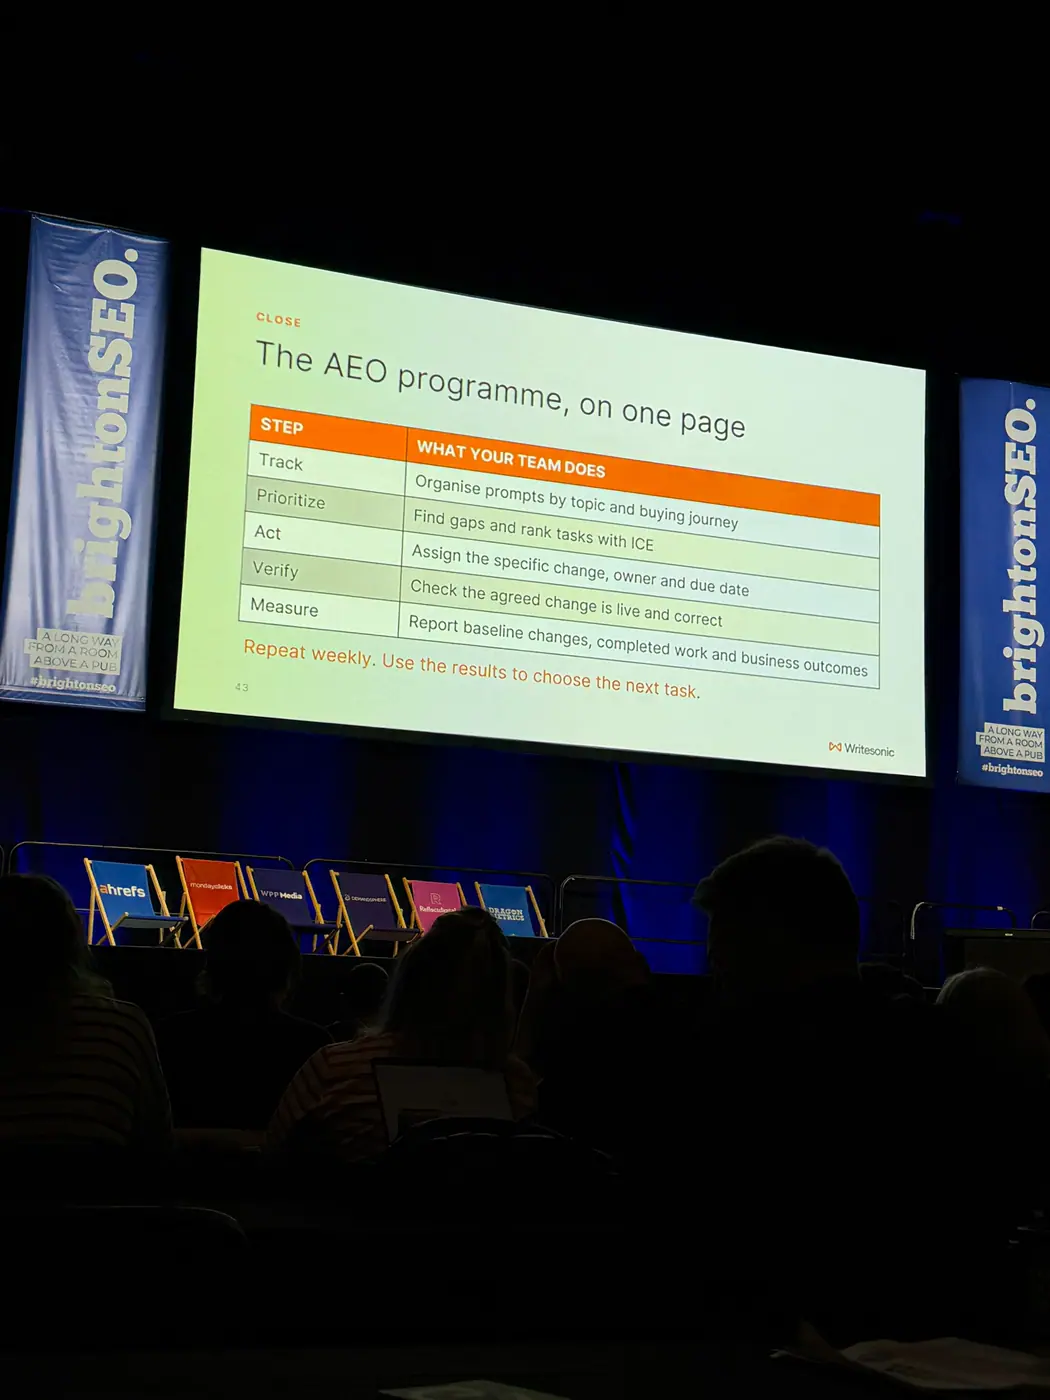
Podczas brightonSEO 8 października 2026 Samanyou Garg przedstawił pięcioetapowy program AEO (Answer Engine Optimization / optymalizacja pod silniki odpowiedzi): monitorowanie, priorytetyzacja, działanie, weryfikacja i pomiar.
Jego główna teza: sam monitoring odpowiedzi nie wskazuje jeszcze, nad czym powinien pracować zespół. Potrzebny jest proces, który zamienia luki w widoczności na konkretne zadania, a następnie oddziela wykonanie tych zadań od ich efektów biznesowych.
Najważniejsze wnioski
Łączna widoczność marki może ukrywać problem w ważnej kategorii. Garg rekomendował grupowanie promptów według kategorii produktów, usług i etapów decyzji zakupowej. Dopiero taki podział pozwala wskazać obszary wymagające pracy.
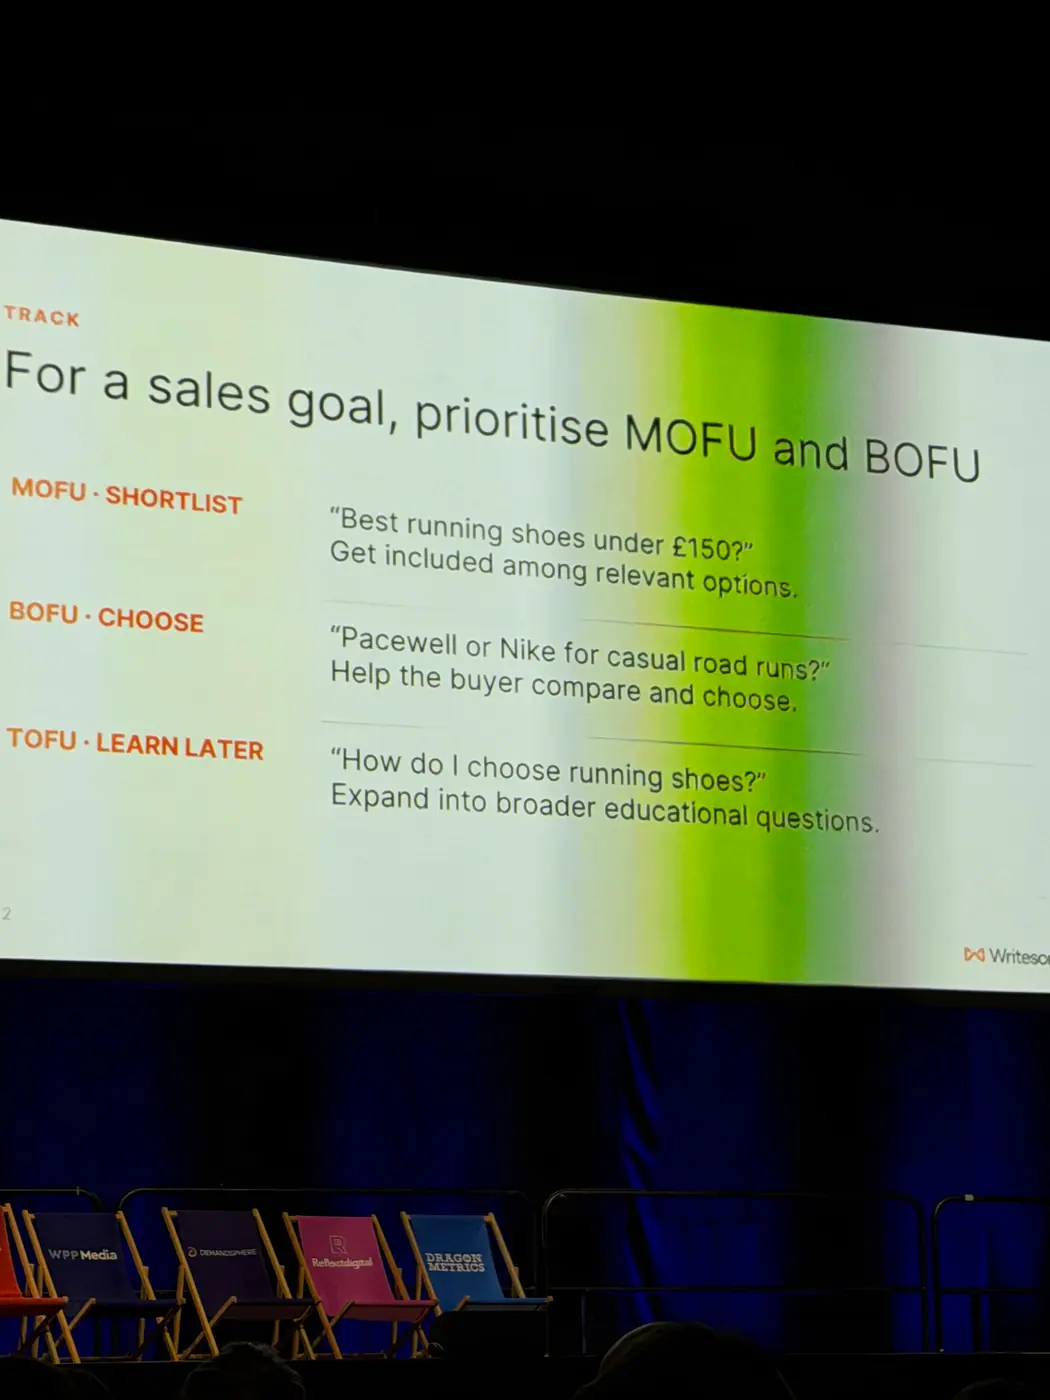
Monitoring powinien odzwierciedlać różne potrzeby klientów, nie warianty językowe tego samego pytania. Prelegent wskazał rozmowy sprzedażowe, zgłoszenia do obsługi i opinie klientów jako źródła rzeczywistych pytań zakupowych. Przy celu sprzedażowym zalecił rozpoczęcie od porównywania opcji i wyboru produktu.
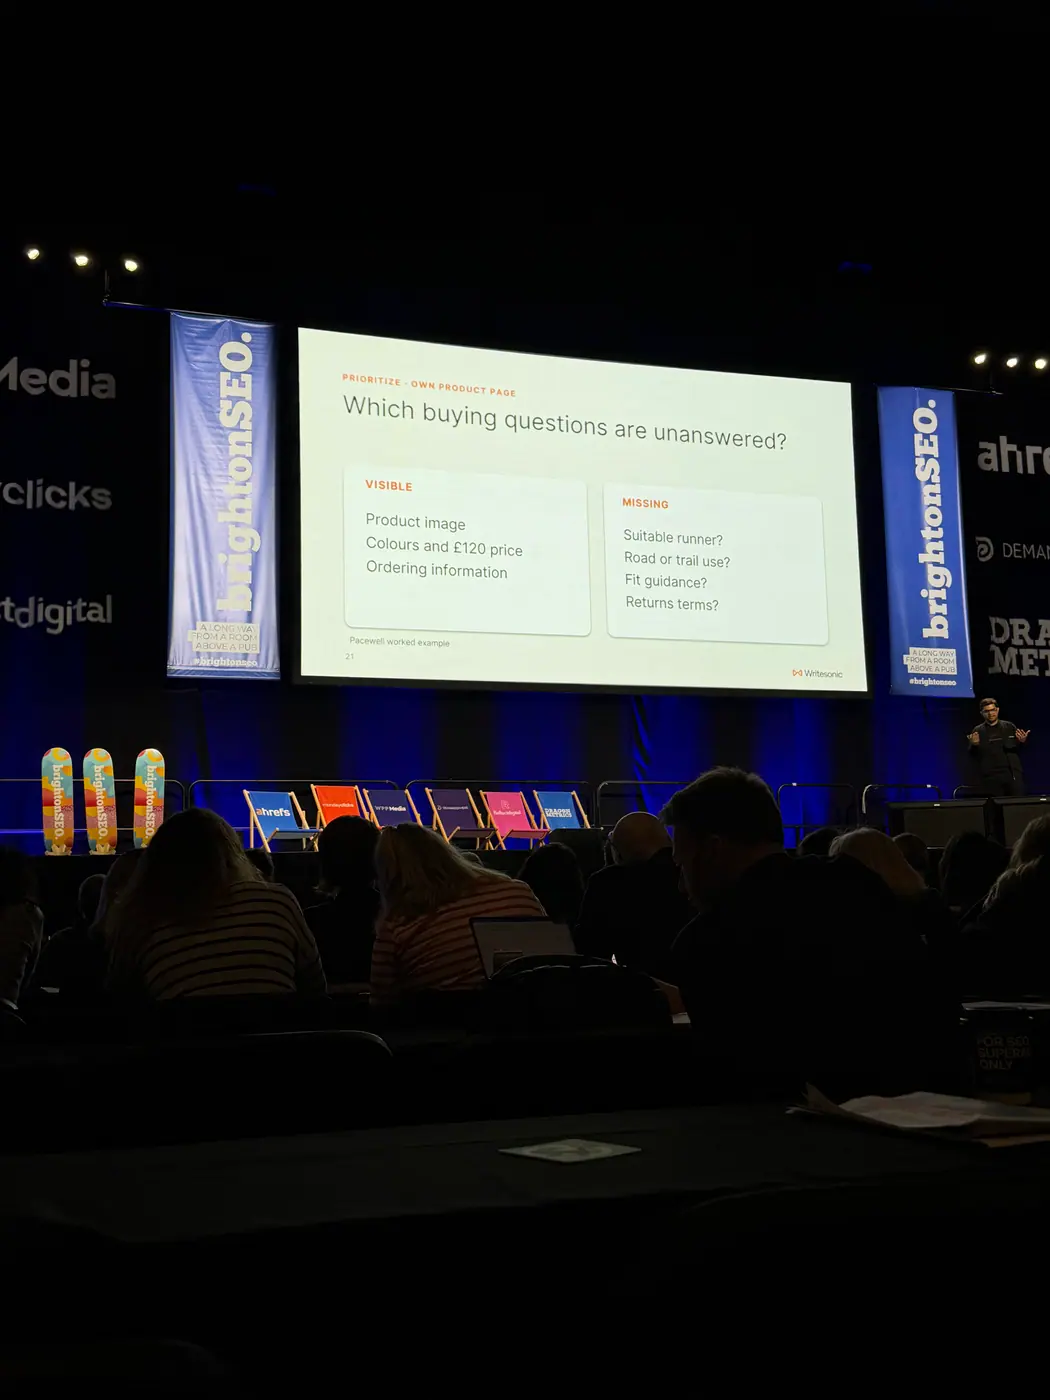
Priorytetem nie zawsze jest stworzenie nowej treści. Zadaniem może być poprawienie ceny, uzupełnienie odpowiedzi na pytanie zakupowe, aktualizacja zewnętrznego źródła albo naprawienie rzeczywistego problemu z produktem.
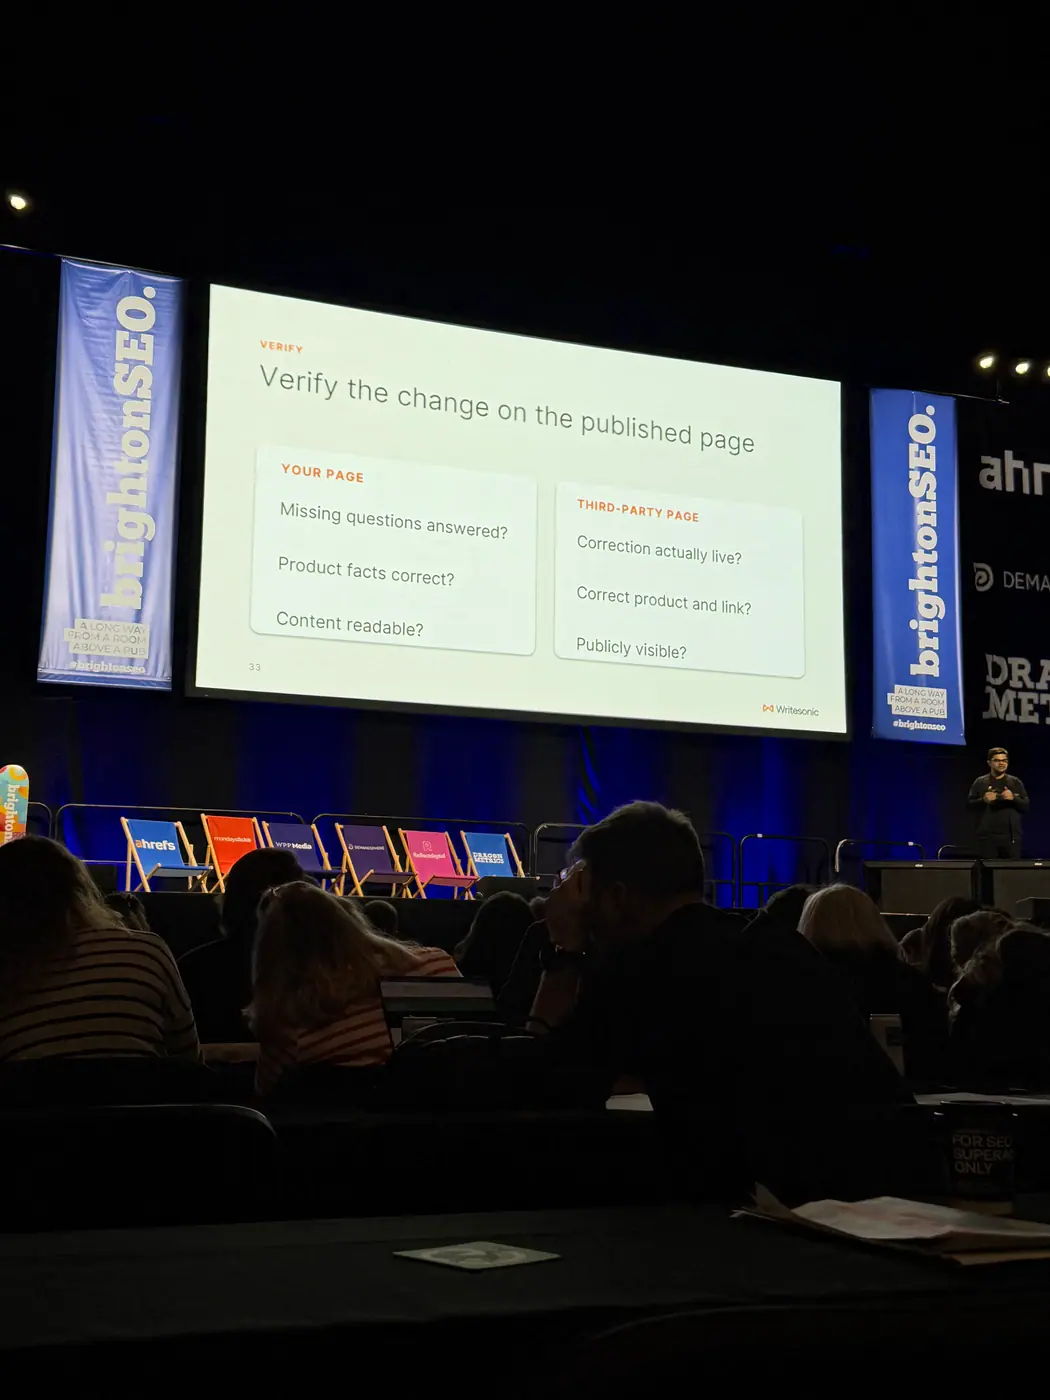
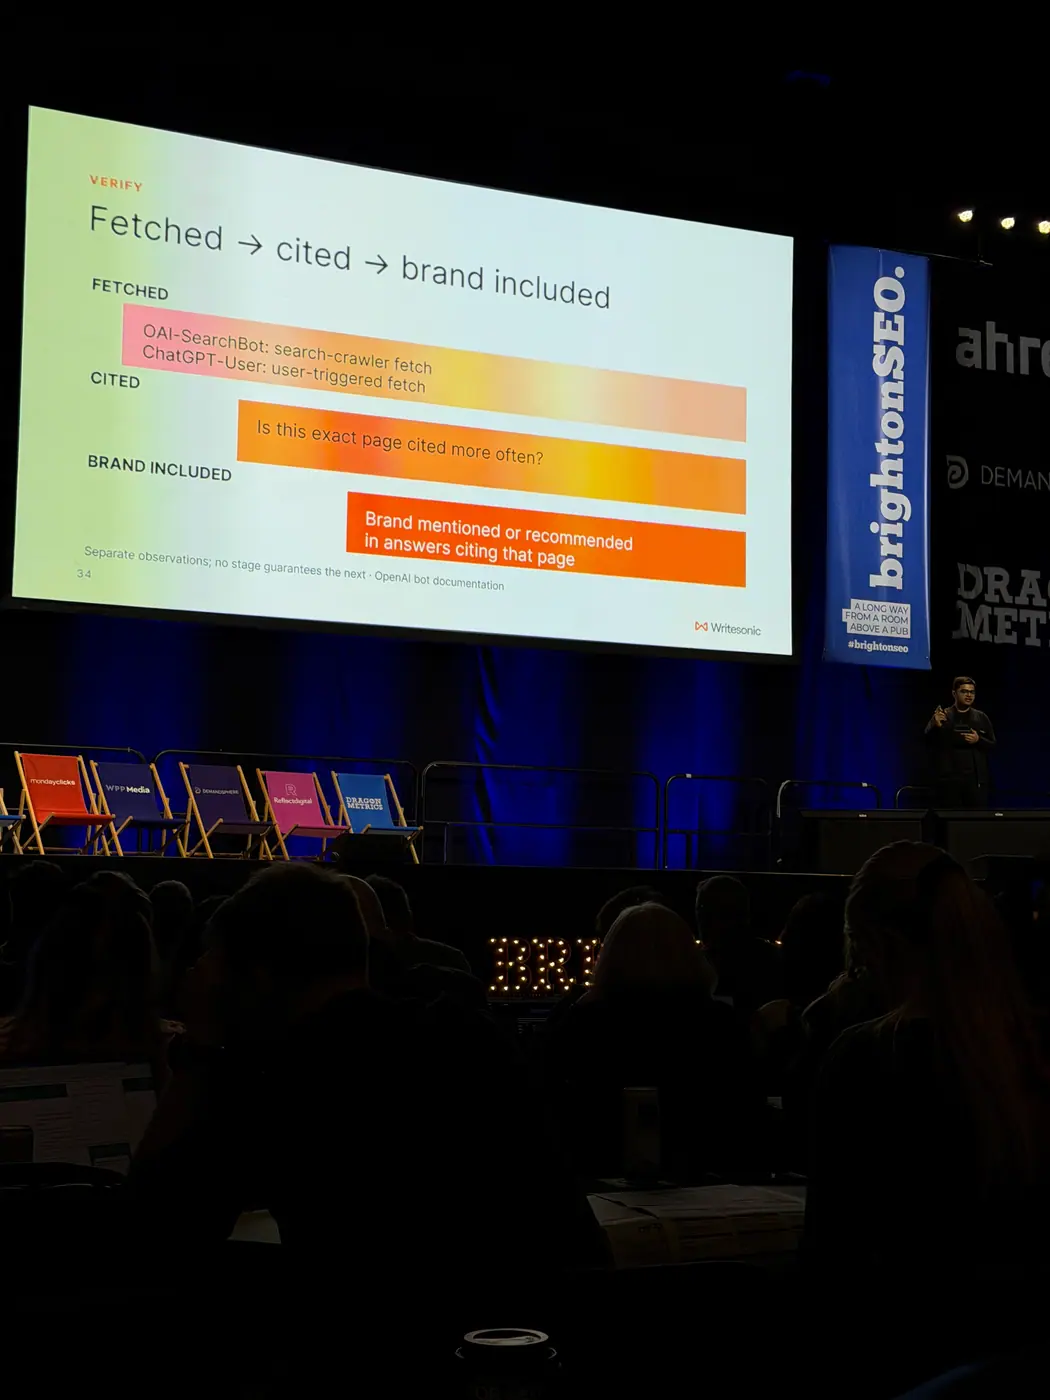
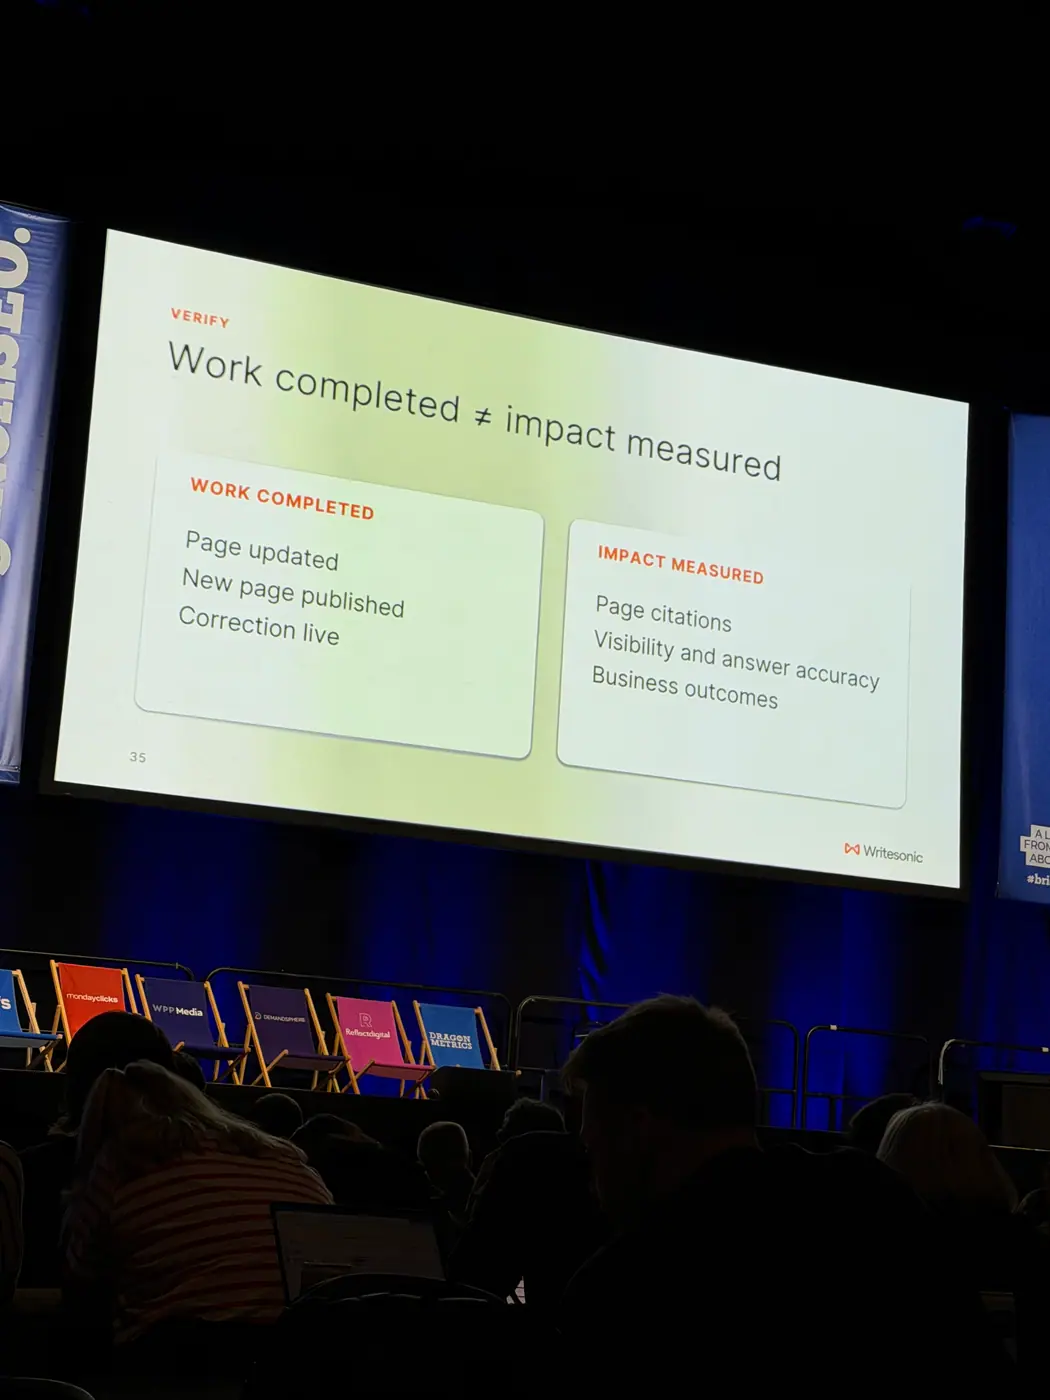
Wdrożenie poprawki i wykazanie jej skuteczności to osobne etapy. Publikacja, pobranie strony przez bota, cytowanie i rekomendacja marki odpowiadają na różne pytania. Nie należy traktować ich jako zamiennych dowodów sukcesu.
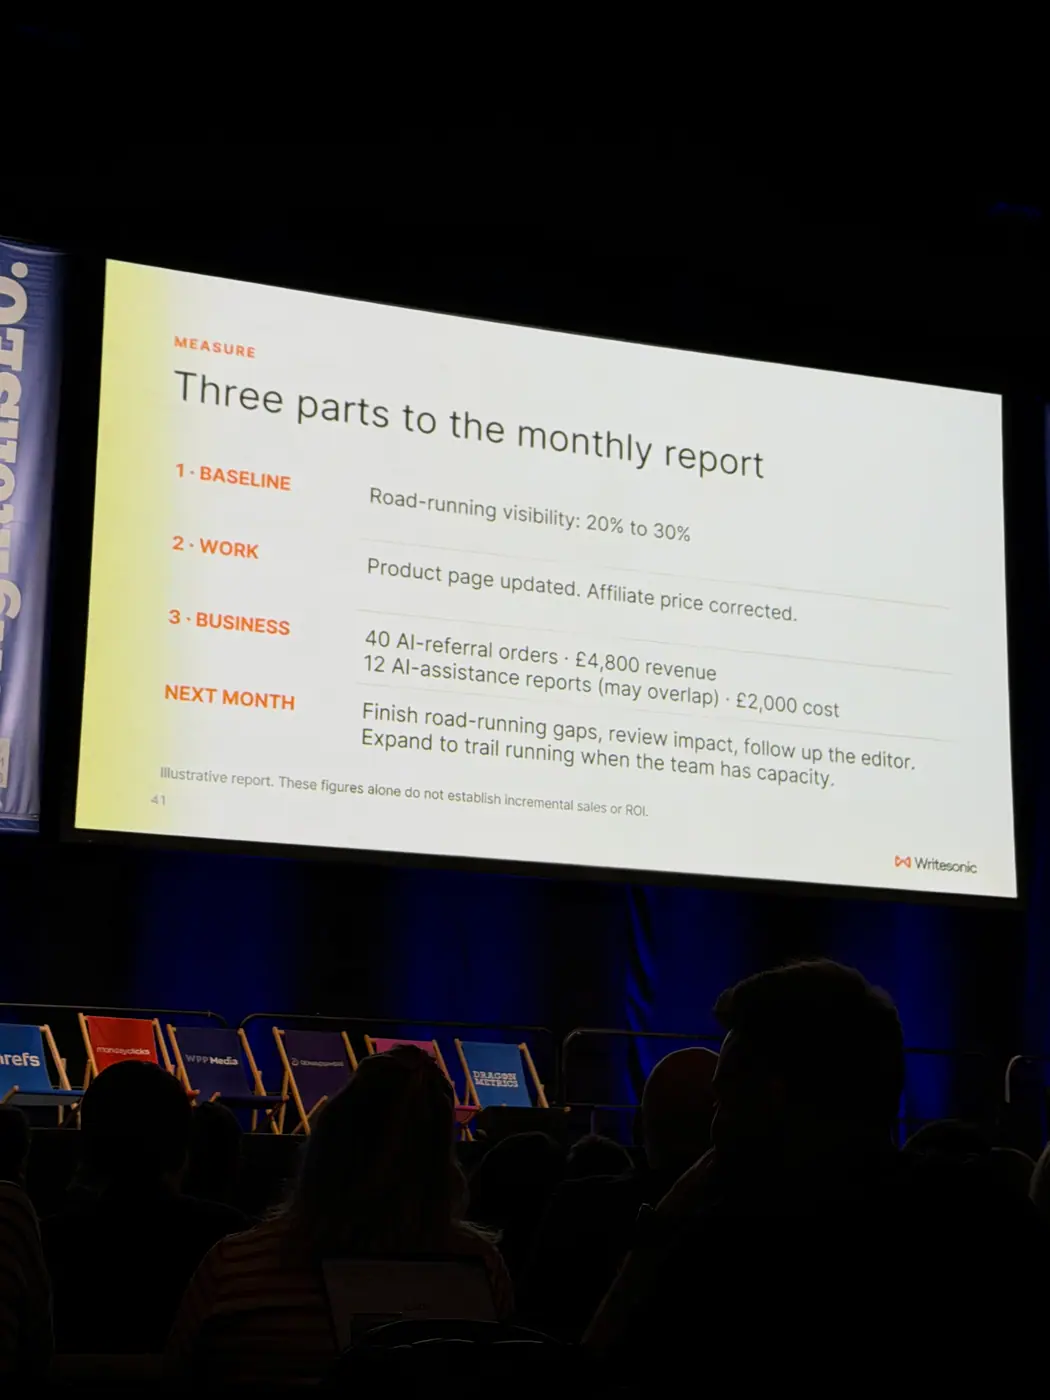
Raportowanie wymaga stałej podstawy porównania i szerszego spojrzenia na sprzedaż. Garg zalecił porównywanie tych samych promptów i modeli w porównywalnych okresach. Wskazał też, że asystent może pomóc klientowi odkryć markę albo ocenić produkt, który klient już znał.
Dane liczbowe i przykłady
| Liczba | Znaczenie i charakter informacji |
|---|---|
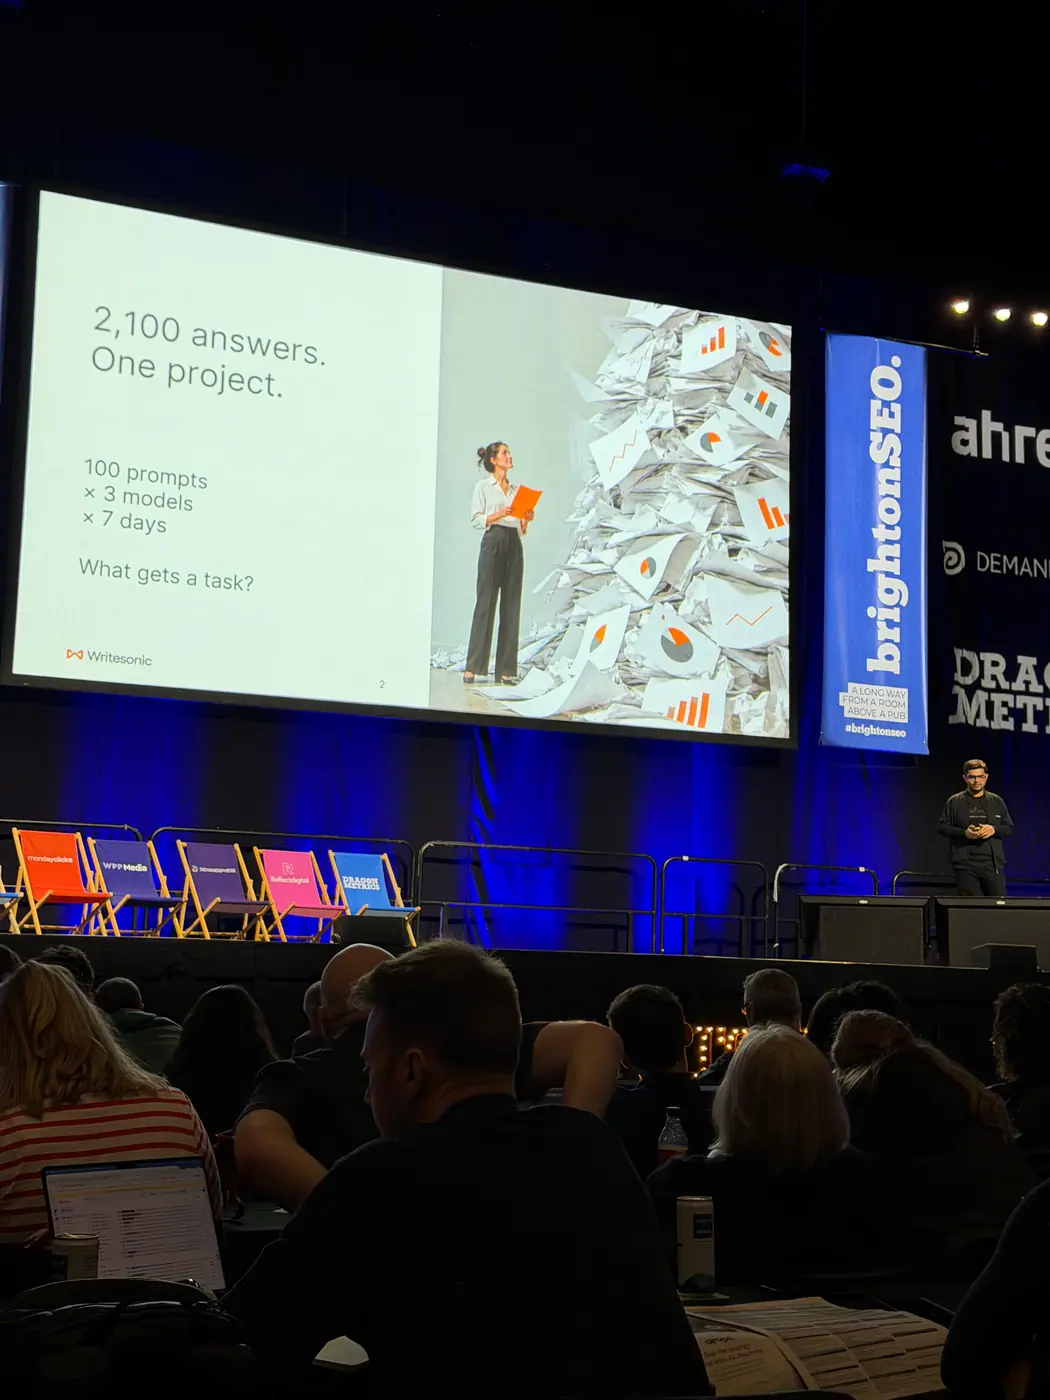
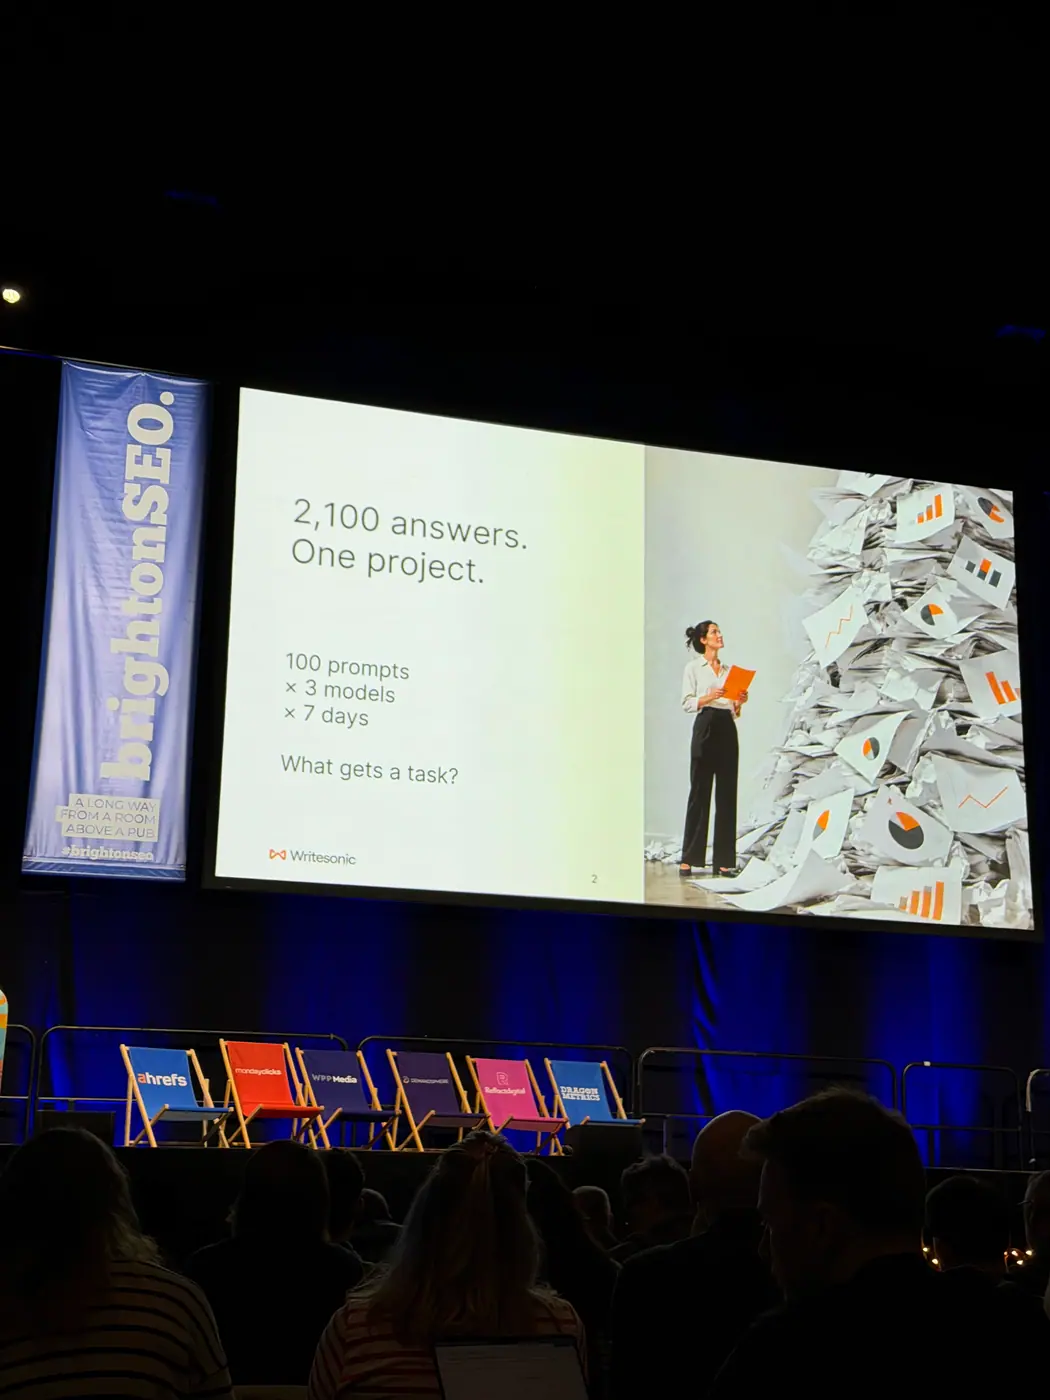
| 2100 odpowiedzi | Kalkulacja skali monitoringu: 100 promptów × 3 modele językowe × 7 dni. |
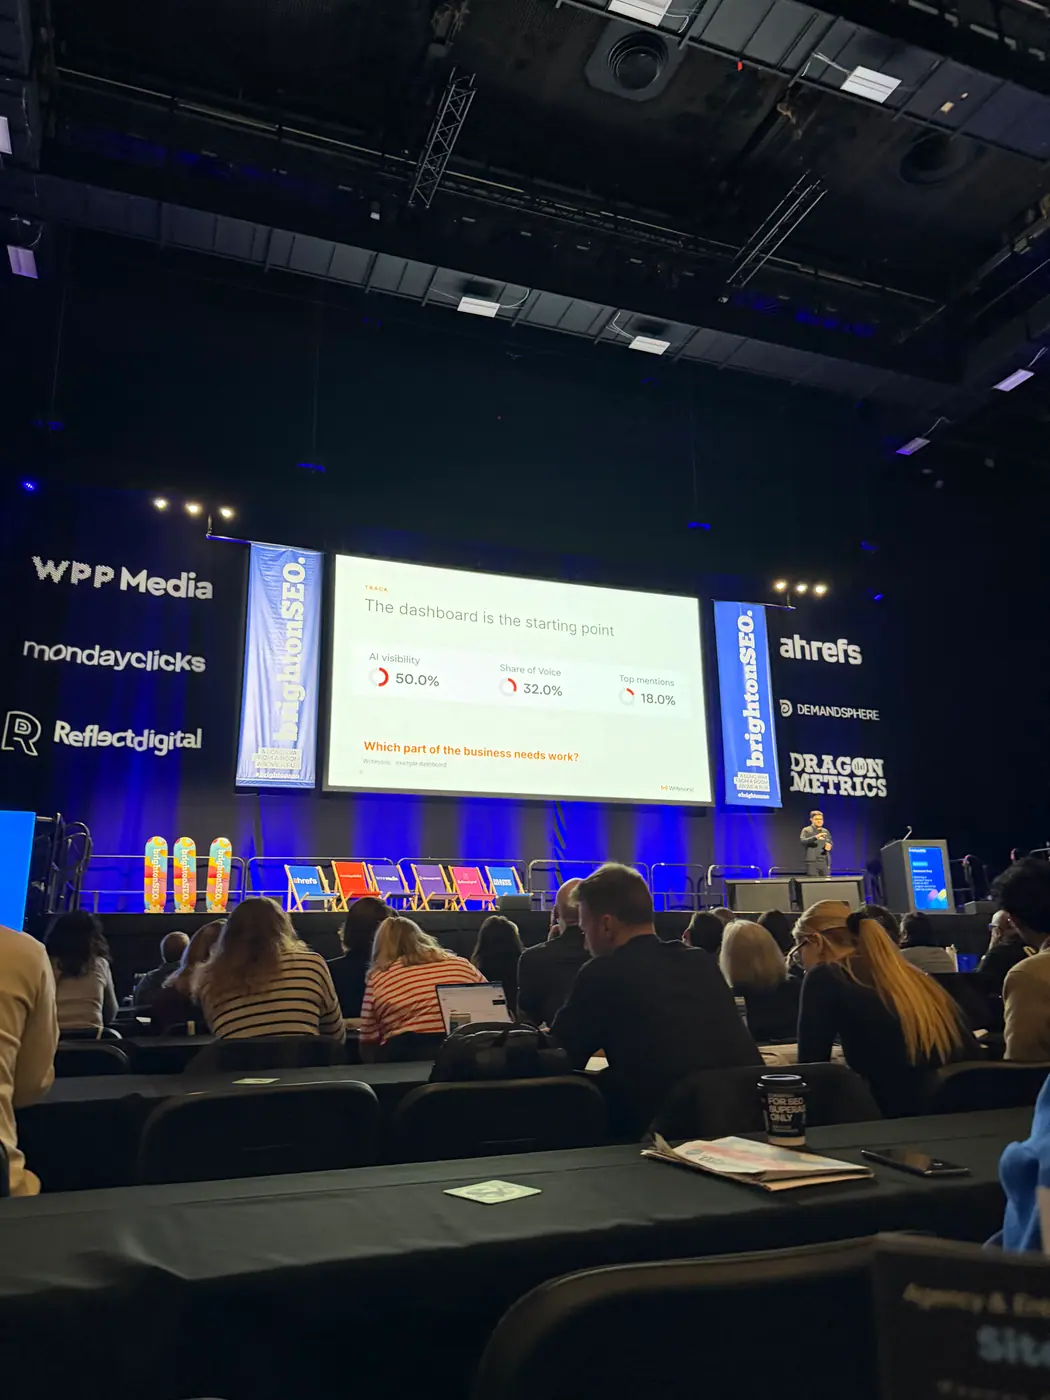
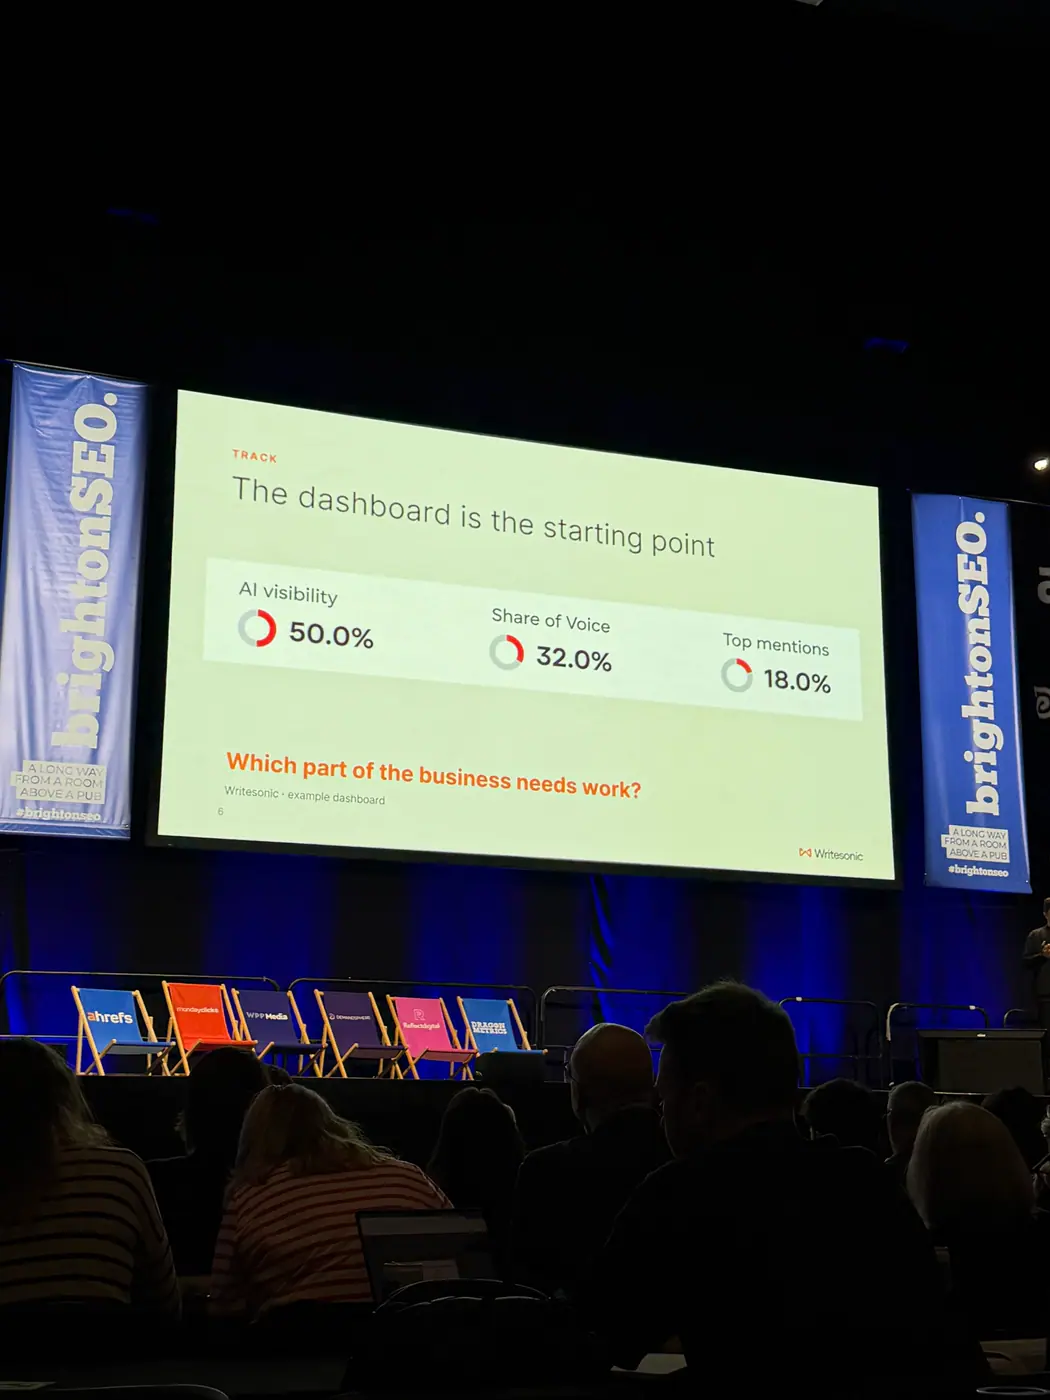
| 50% widoczności ogółem i 20% w jednej kategorii | Hipotetyczny przykład pokazujący, jak dobry wynik zbiorczy może maskować słabą obecność w konkretnym obszarze oferty. |
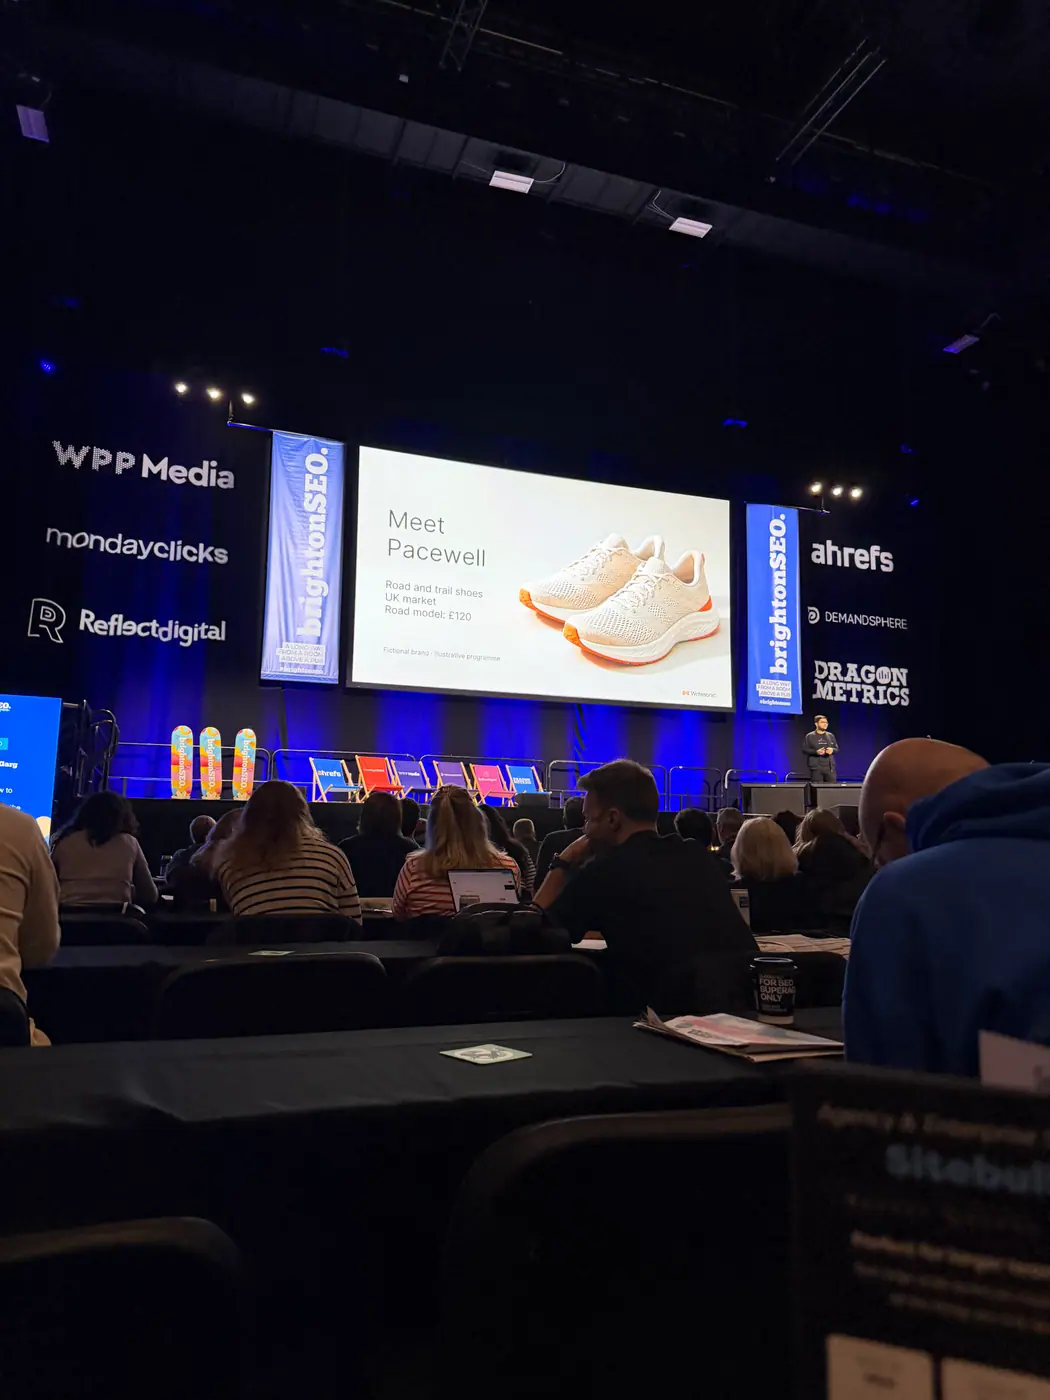
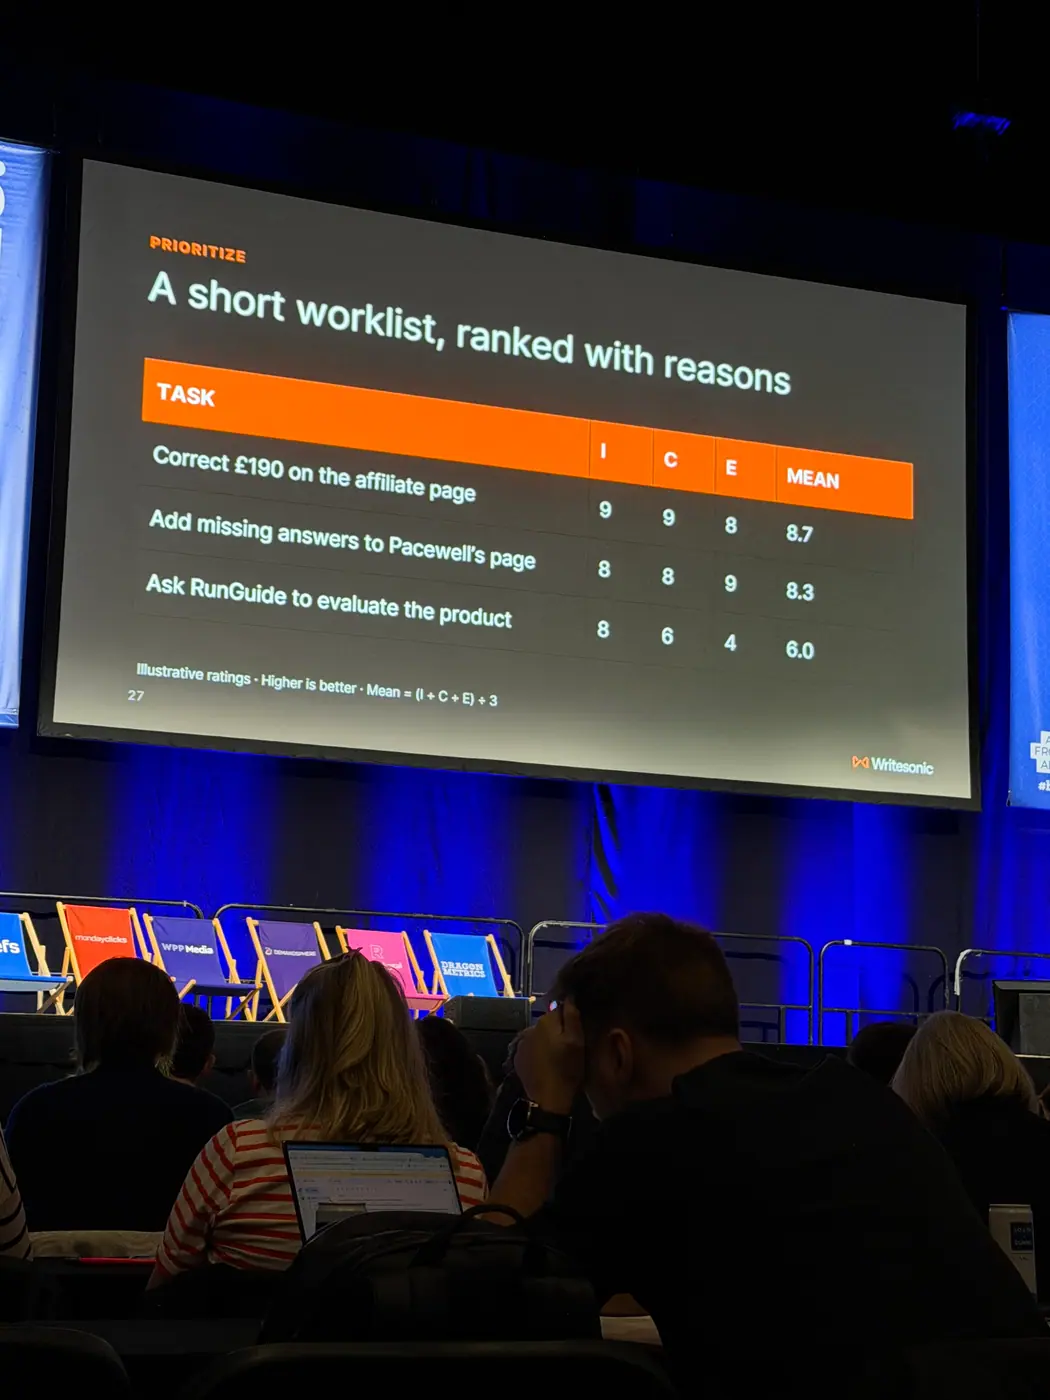
| 190 zamiast 120 funtów, przy budżecie 150 funtów | Hipotetyczny przykład nieaktualnej ceny, przez którą produkt może nie pojawić się w rekomendacjach, mimo że mieści się w budżecie klienta. |
| 80 promptów bez marki i 20 markowych | Przykładowy skład monitoringu. Zwiększenie udziału pytań markowych może podnieść wynik widoczności bez poprawy odkrywalności marki. |
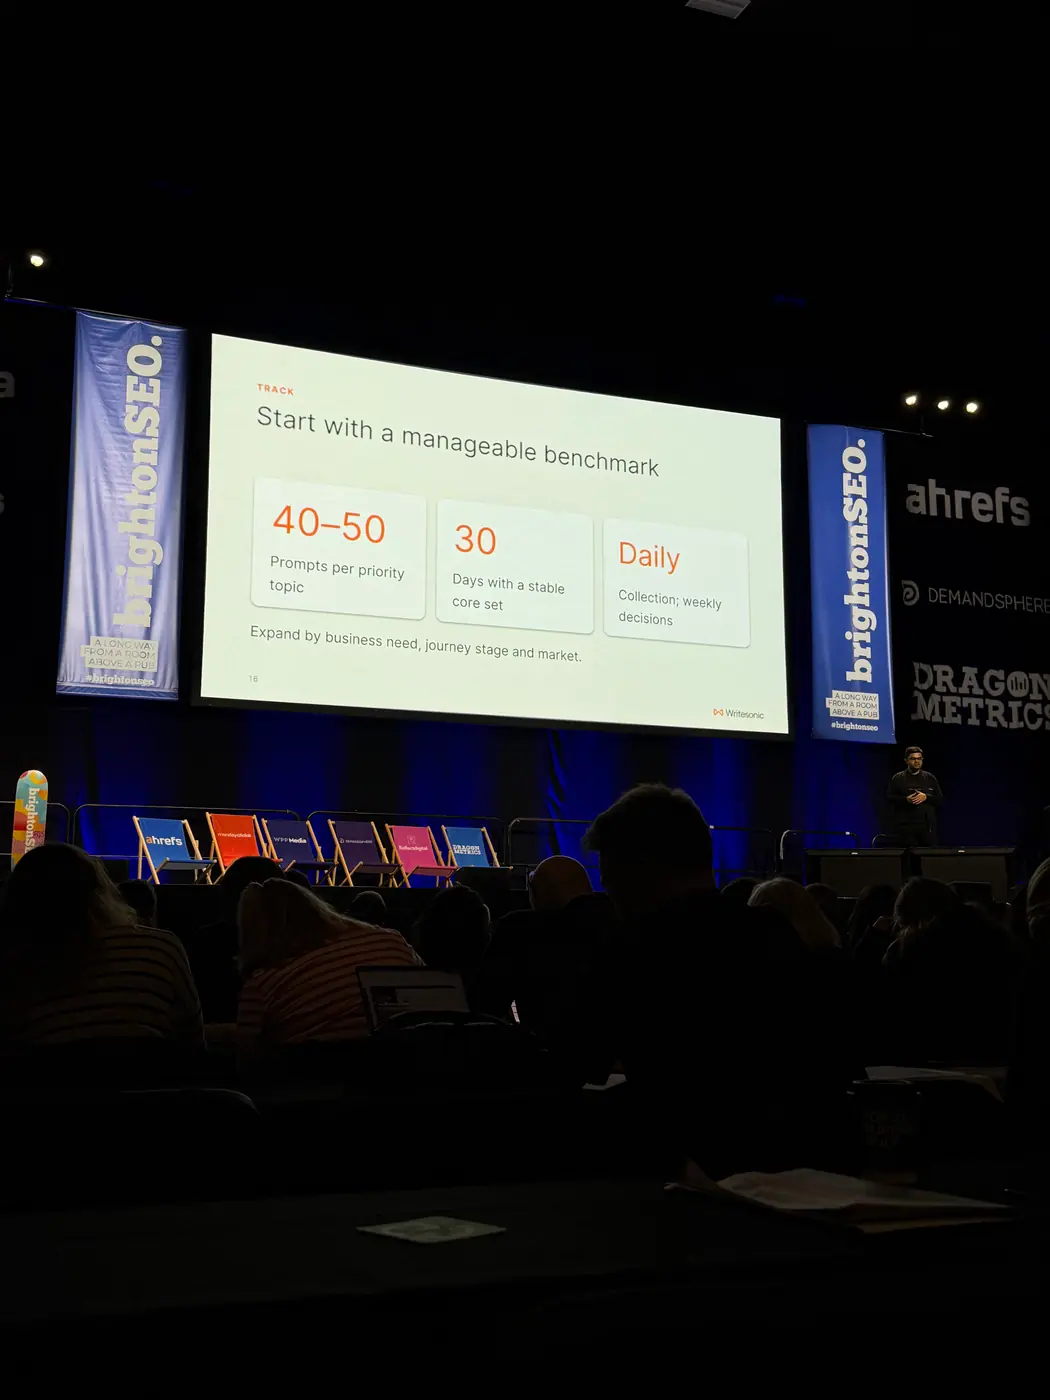
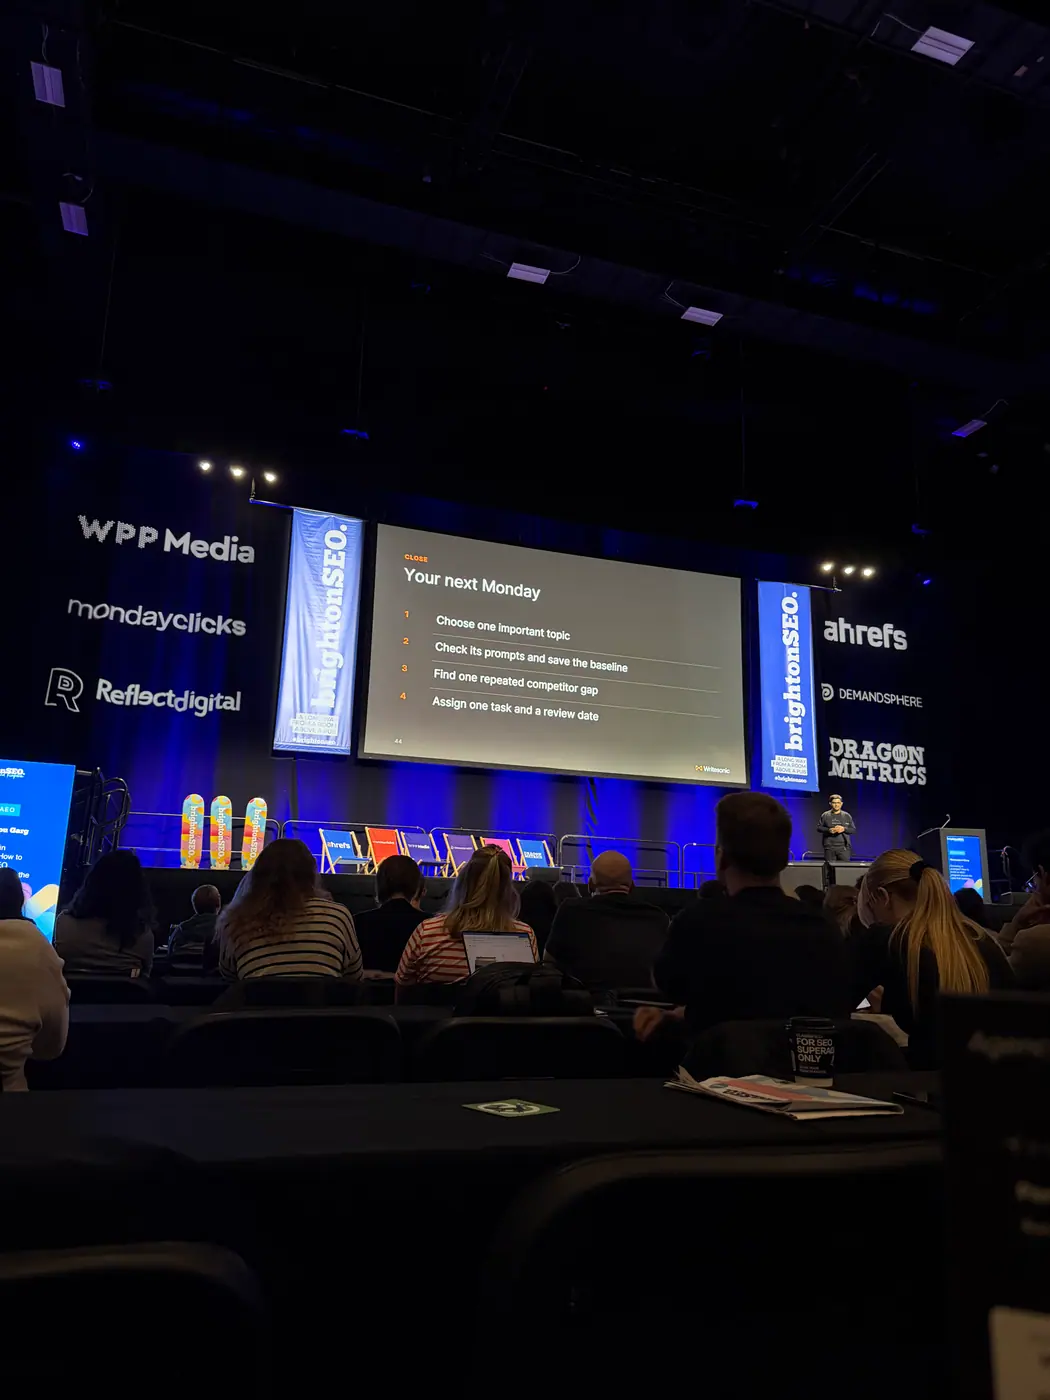
| 30–40 promptów przez 30 dni | Rekomendowany przez Garga pilotaż dla jednego ważnego tematu, z cotygodniowym przeglądem luk. |
| 2–3 zadania od początku do końca | Zalecany zakres pierwszego wdrożenia procesu przed rozszerzaniem monitoringu i automatyzacji. |
| Około 10% | Szacunek prelegenta dotyczący przychodów lub leadów możliwych do przypisania w analityce. Garg wiązał ograniczenia pomiaru z interakcjami niewymagającymi kliknięcia. Nie należy przedstawiać tej wartości jako uniwersalnego benchmarku. |
Praktyczne rady
- Zbuduj mapę pytań zakupowych. Połącz rozmowy sprzedażowe, zgłoszenia do obsługi i opinie klientów z frazami SEO (Search Engine Optimization / optymalizacja pod wyszukiwarki) oraz dyskusjami branżowymi. Rozdziel pytania kategoriowe, porównawcze i markowe, a następnie przypisz je do etapów decyzji.
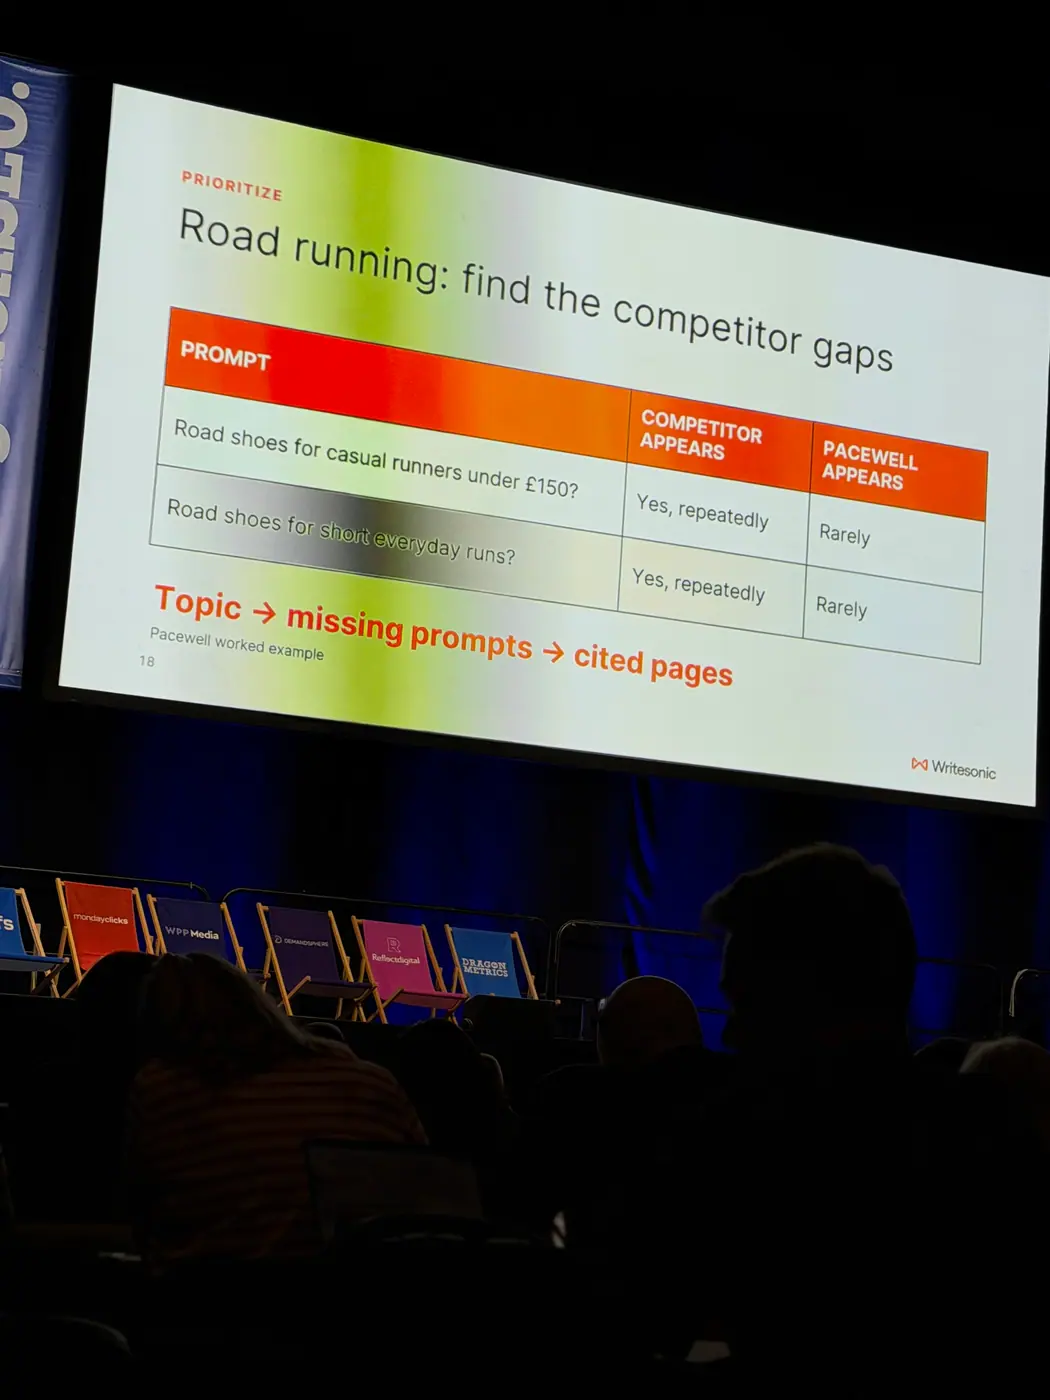
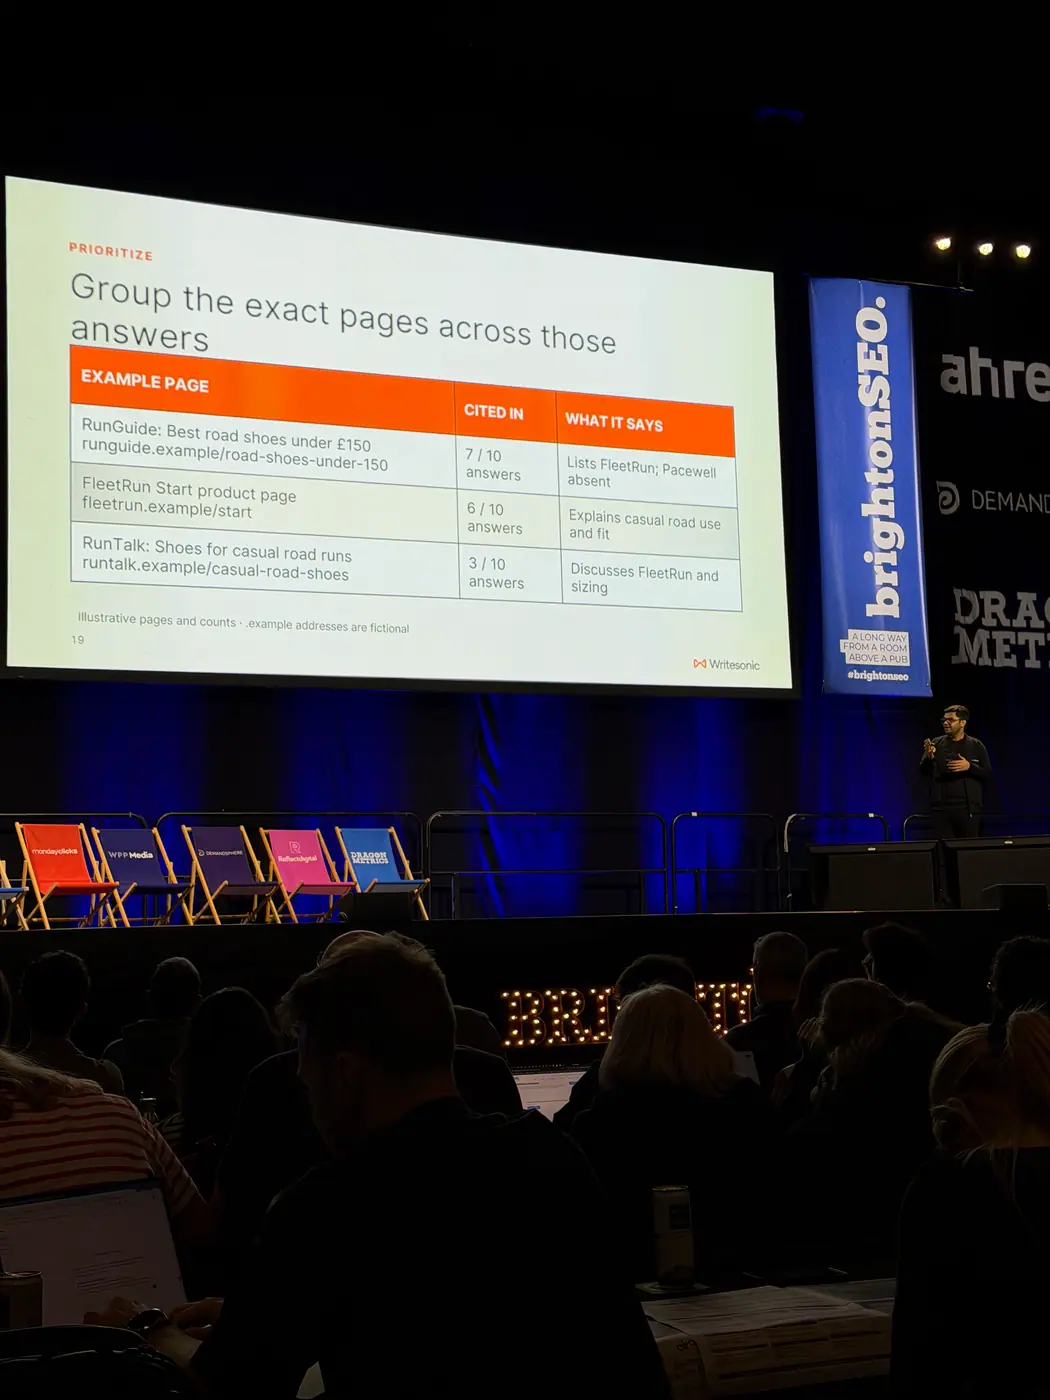
- Przechodź od brakującej rekomendacji do konkretnego źródła. Sprawdź, przy których pytaniach pojawia się konkurencja, a Twoja marka nie. Następnie przeanalizuj cytowane strony i brakujące informacje o produkcie.
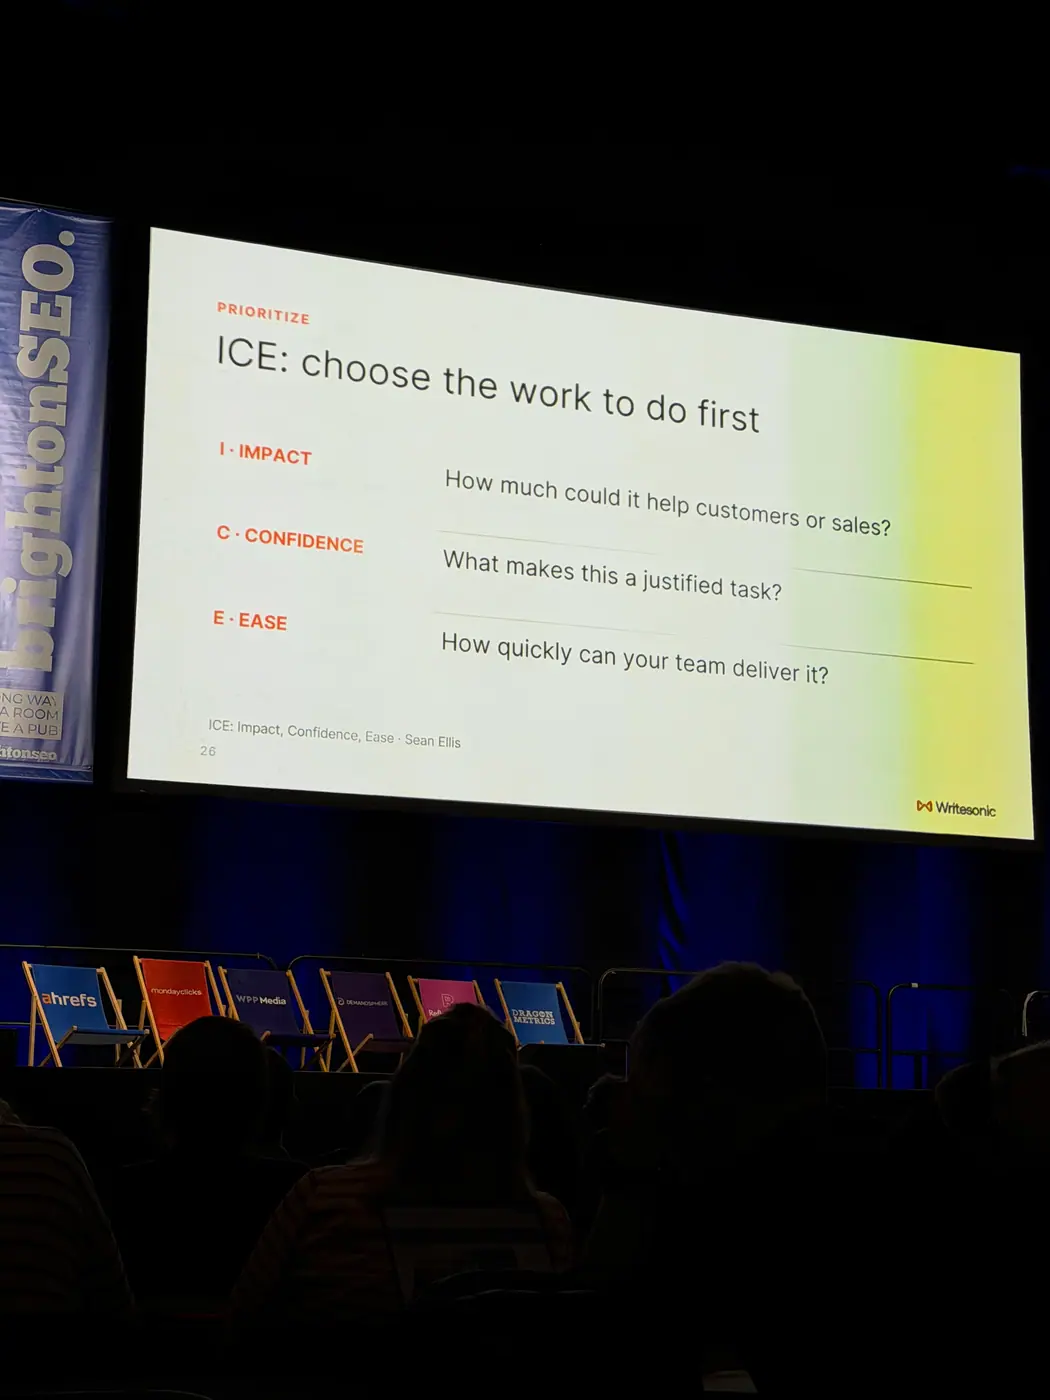
- Oceniaj zadania modelem ICE (Impact, Confidence, Ease / wpływ, pewność, łatwość realizacji). Garg proponował ranking oparty na średniej trzech ocen, zamiast wybierania zadań wyłącznie według liczby cytowań.
- Każdemu zadaniu przypisz stronę, zakres zmiany, właściciela i termin. Agenci mogą wspierać analizę luk i przygotowanie aktualizacji, natomiast kontrolę jakości i akceptację publikacji prelegent pozostawił ludziom.
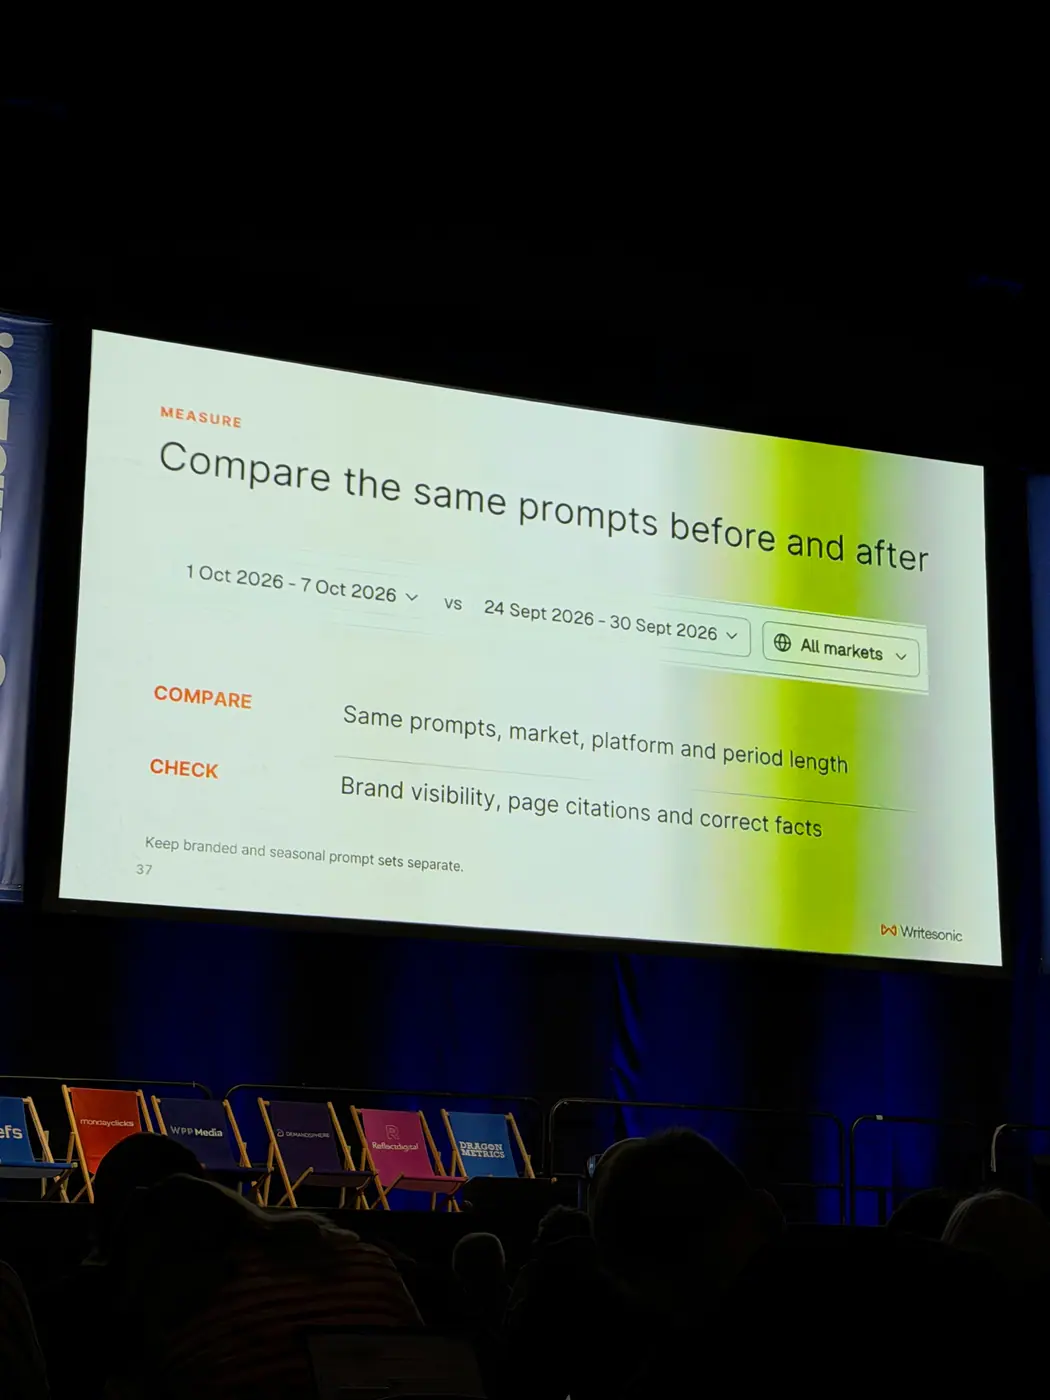
- Mierz na stałej podstawie. Porównuj ten sam zestaw promptów i modeli, np. siedem dni z poprzednimi siedmioma. Oddziel pytania markowe od niemarkowych oraz stałe od sezonowych. Analitykę uzupełniaj pytaniem klientów o źródło poznania marki.
Knowledge bombs
1. Nawet mały projekt to ponad 2000 odpowiedzi tygodniowo – bez grupowania w tematy nie da się tego przeanalizować.
100 promptów × 3 LLM-y × 7 dni daje około 2100 odpowiedzi. Nikt nie przeczyta ich ręcznie, więc trzeba szukać powtarzających się tematów i luk oraz priorytetyzować je według metryki biznesowej.
„most probably you’re tracking about 100 prompts, 3 LLMs over a 7-day period. That itself means you have about 2100 answers to focus on.”
2. Ogólna widoczność marki maskuje dziury w kluczowych kategoriach.
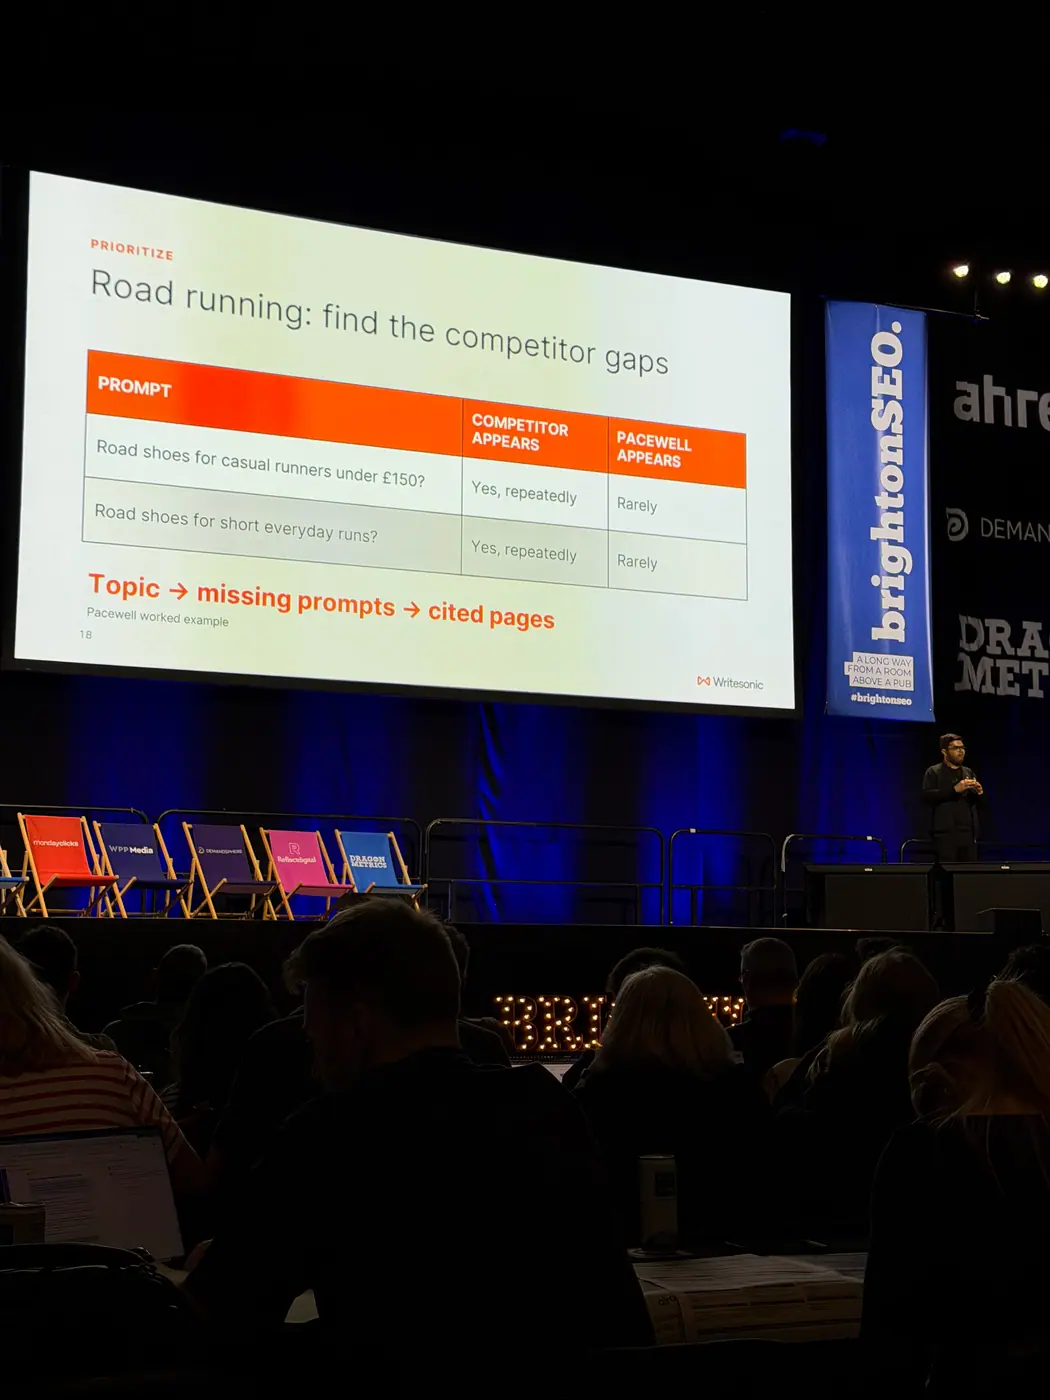
W przykładzie marka ma 50% widoczności ogółem, ale tylko 20% w kategorii butów szosowych. Prompty warto grupować według kategorii produktów lub usług i etapów ścieżki zakupowej w macierzy: typ promptu (kategoria / porównanie / brand) × TOFU/MOFU/BOFU.
„What you’ll see is that, oh, we were seeing a 50% overall visibility, but if you go deeper for the road running category, the visibility is only 20%.”
3. Uwaga na agencyjny trik: przesuwanie proporcji promptów brandowych i niebrandowych sztucznie „podbija” widoczność.
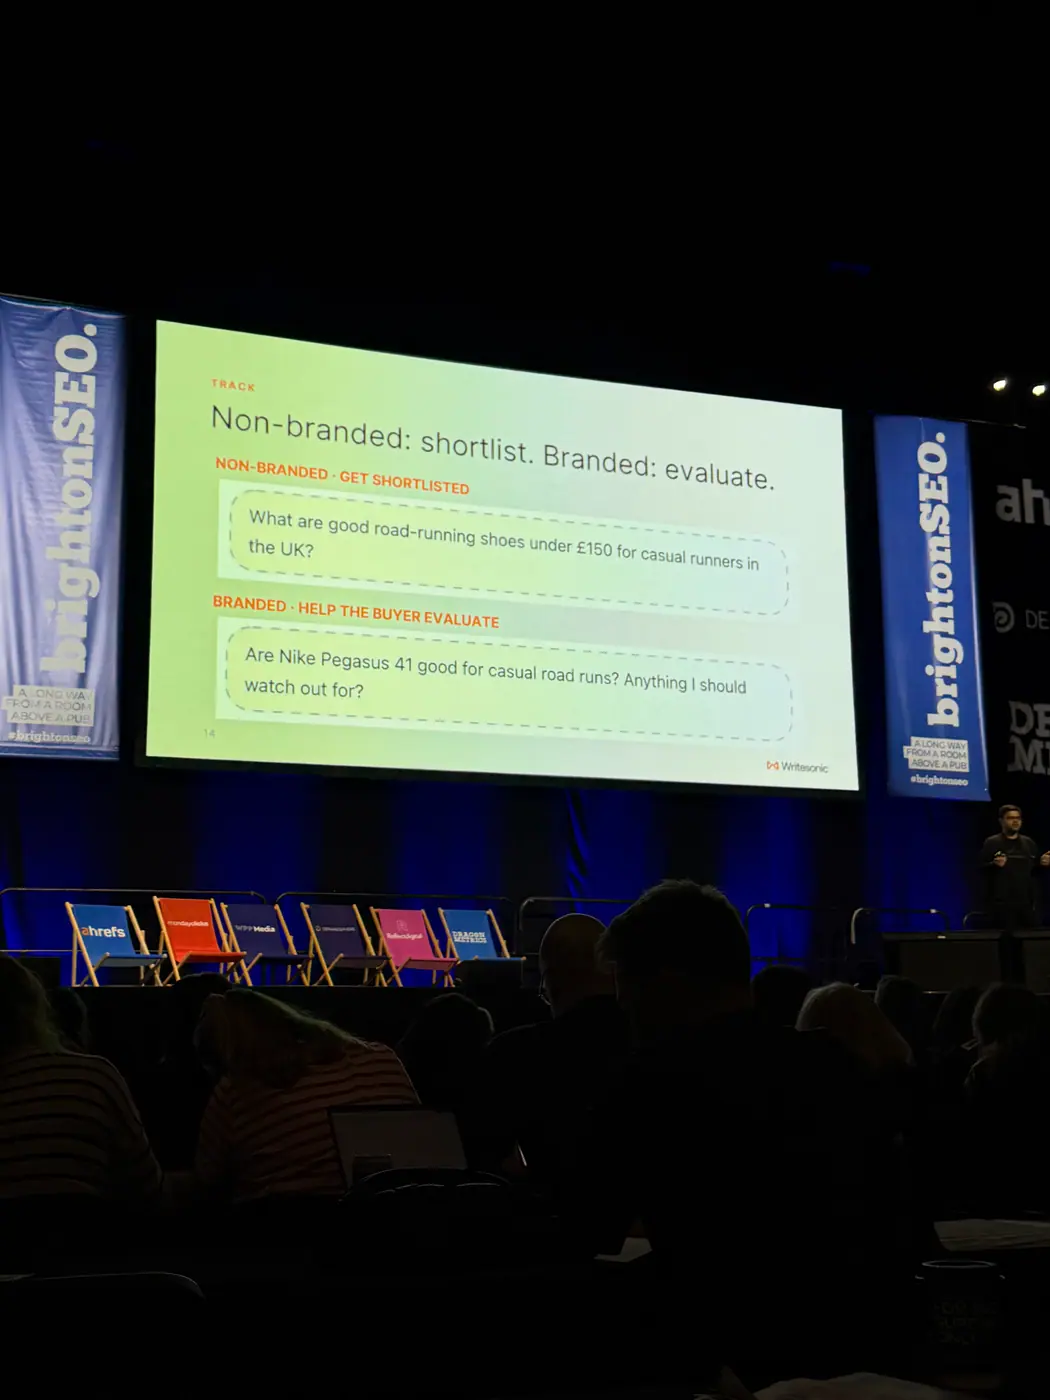
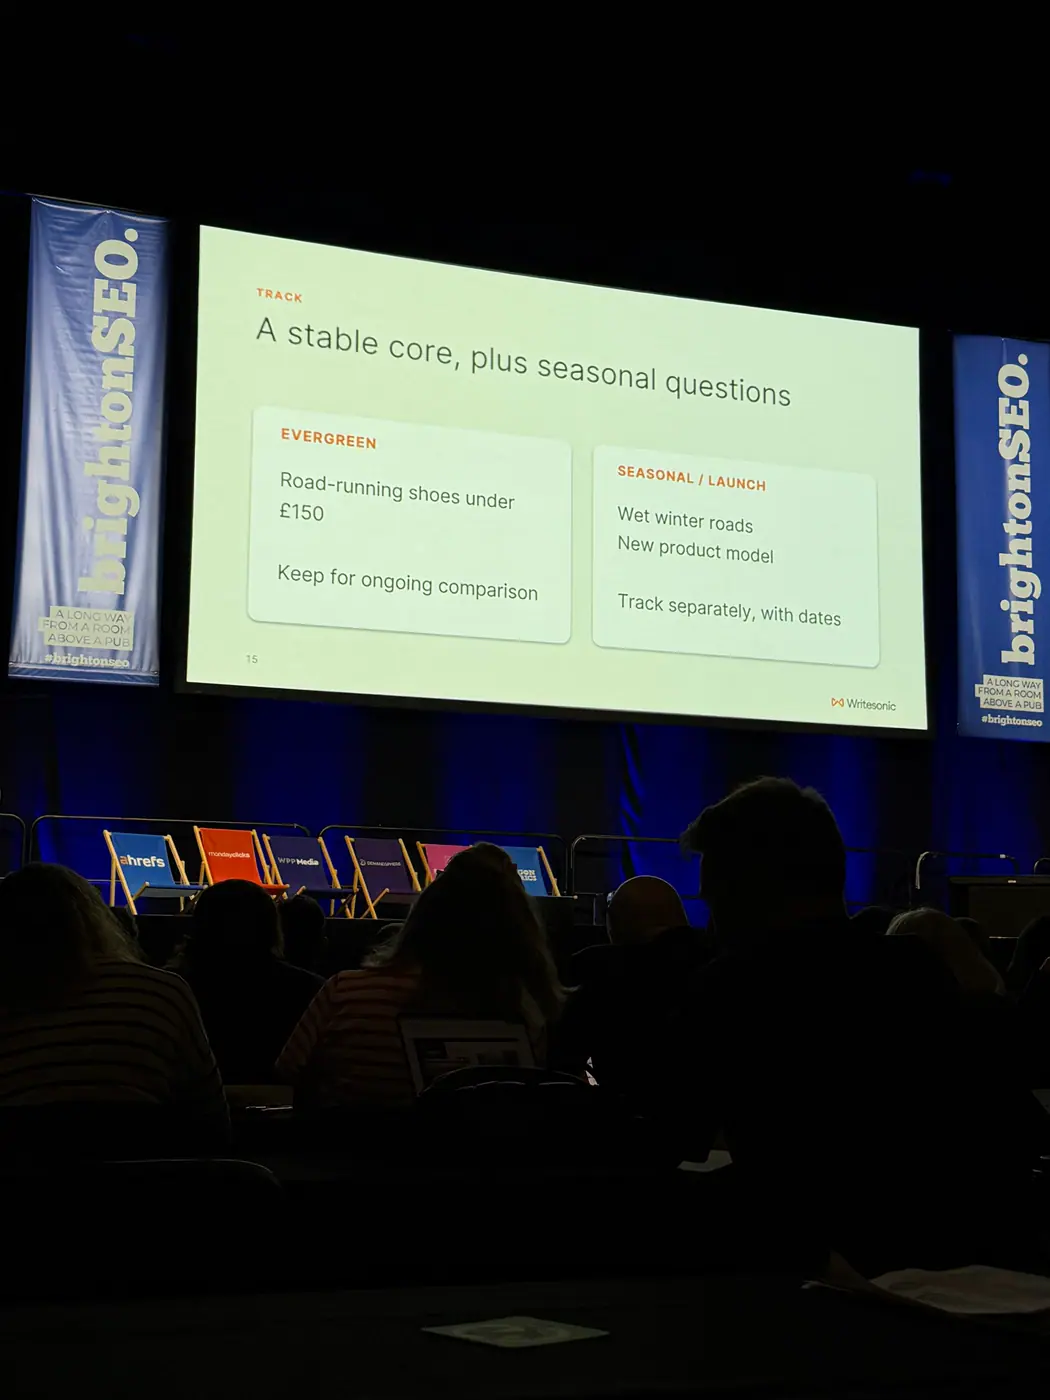
Garg widzi to często u agencji. Na początku miesiąca jest 80 promptów niebrandowych i 20 brandowych, a pod koniec miesiąca więcej brandowych, co daje fałszywy wzrost. Prompty brandowe (ewaluacja) i niebrandowe (odkrywanie, shortlista) trzeba raportować osobno. To samo dotyczy promptów evergreen i sezonowych.
„at the start of the month, they’ll have, let’s say, 100 prompts, where 80 of those are non-branded and 20 are branded. By the end of the month, they reduce the number of non-branded and increase branded to show like a fake increase in traffic, fake increase in visibility.”
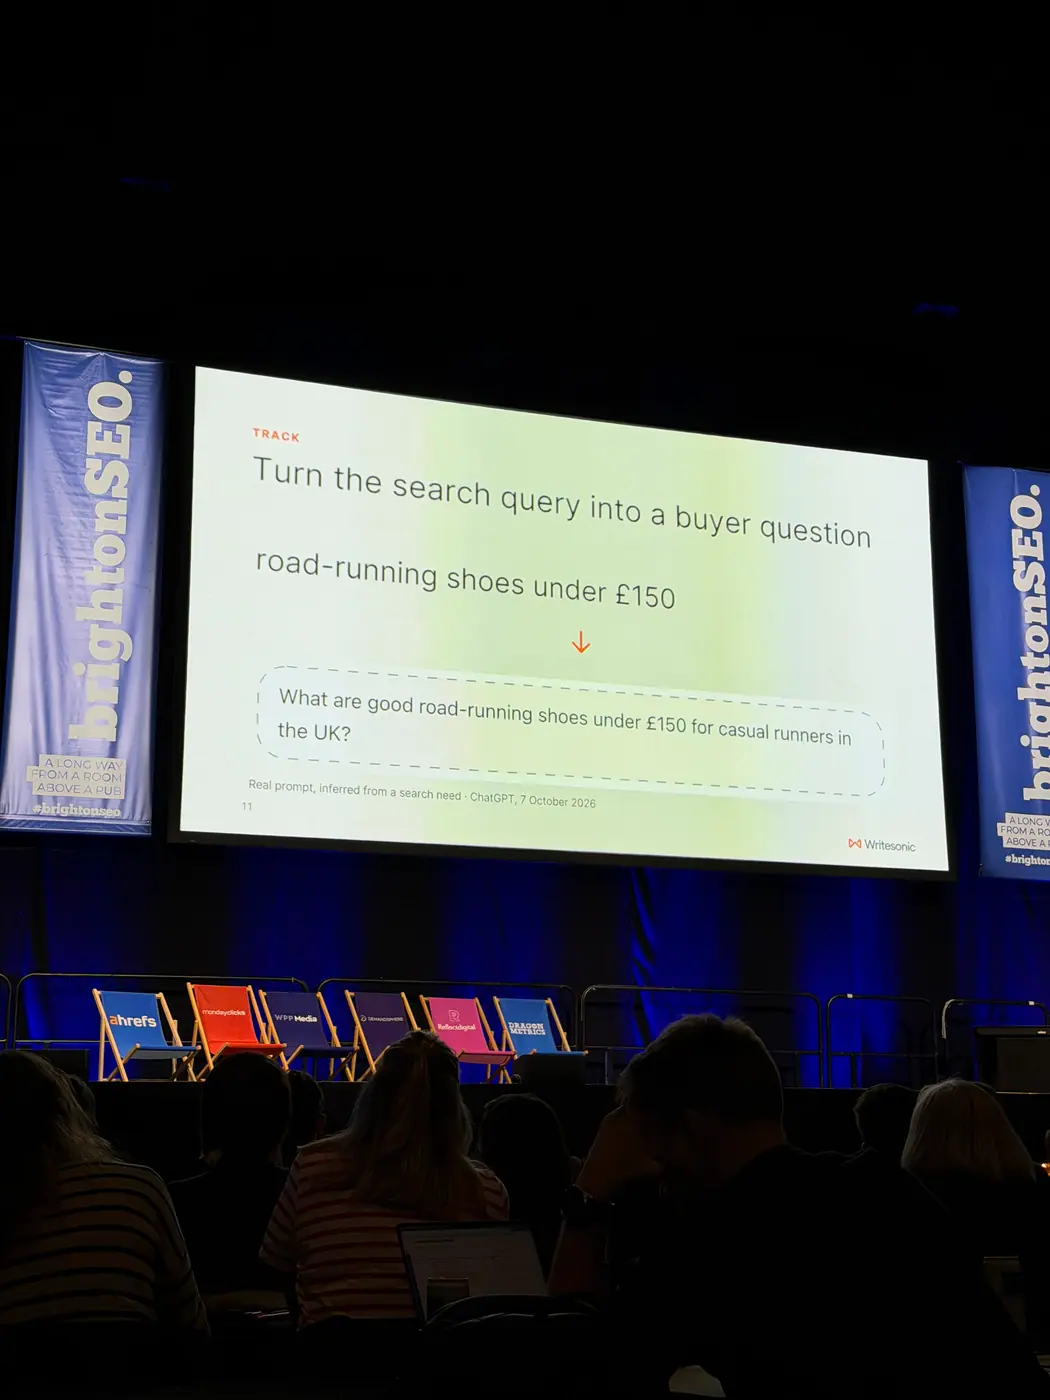
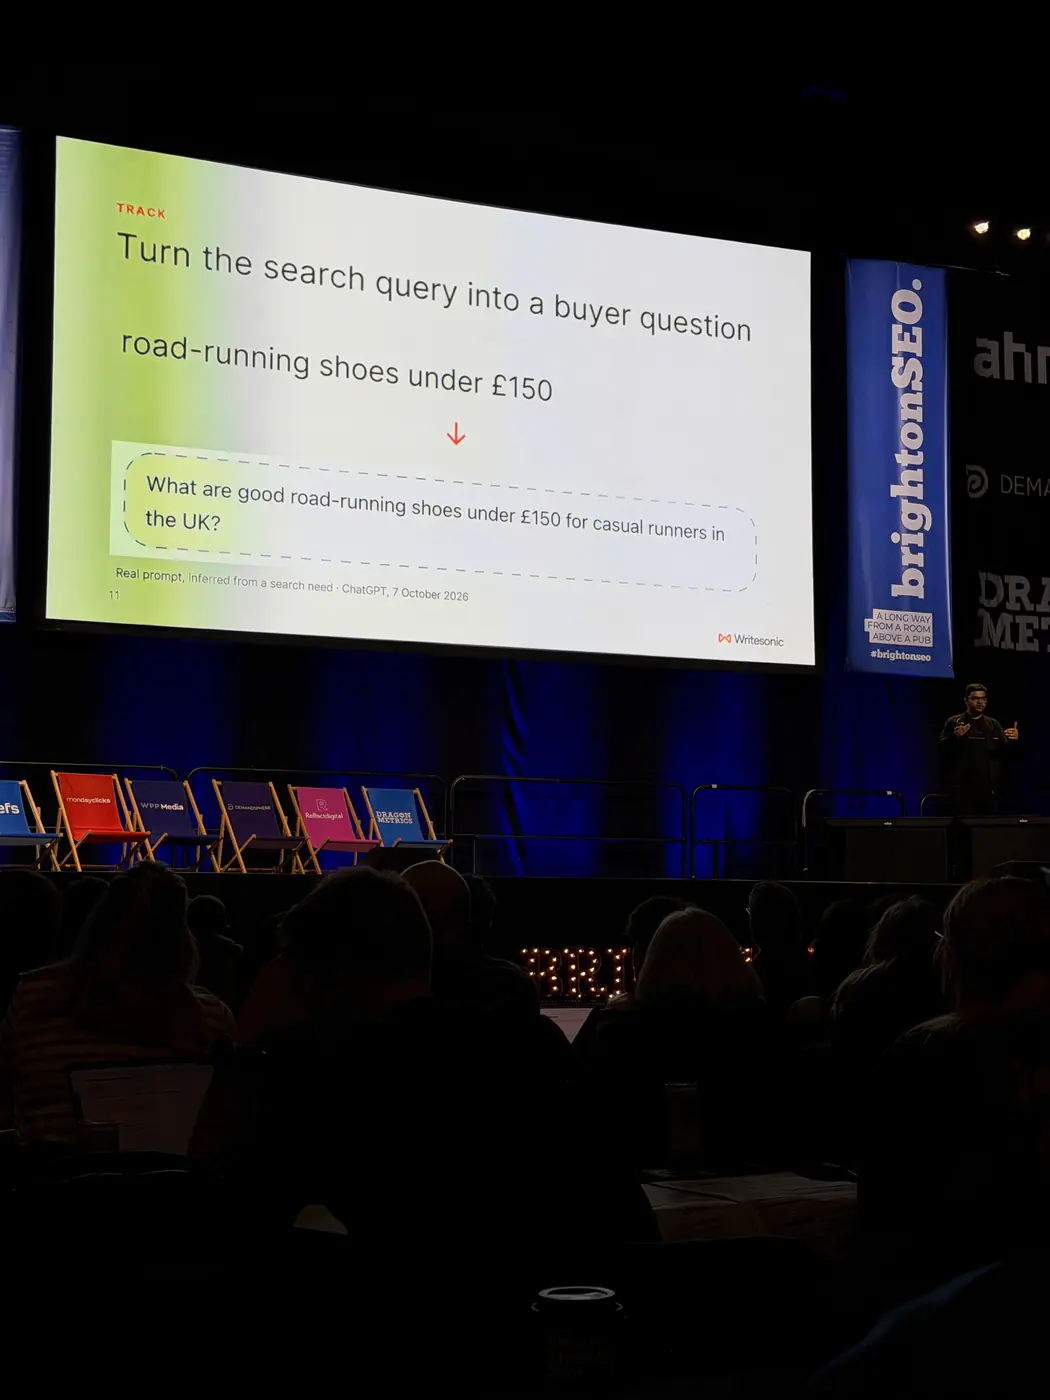
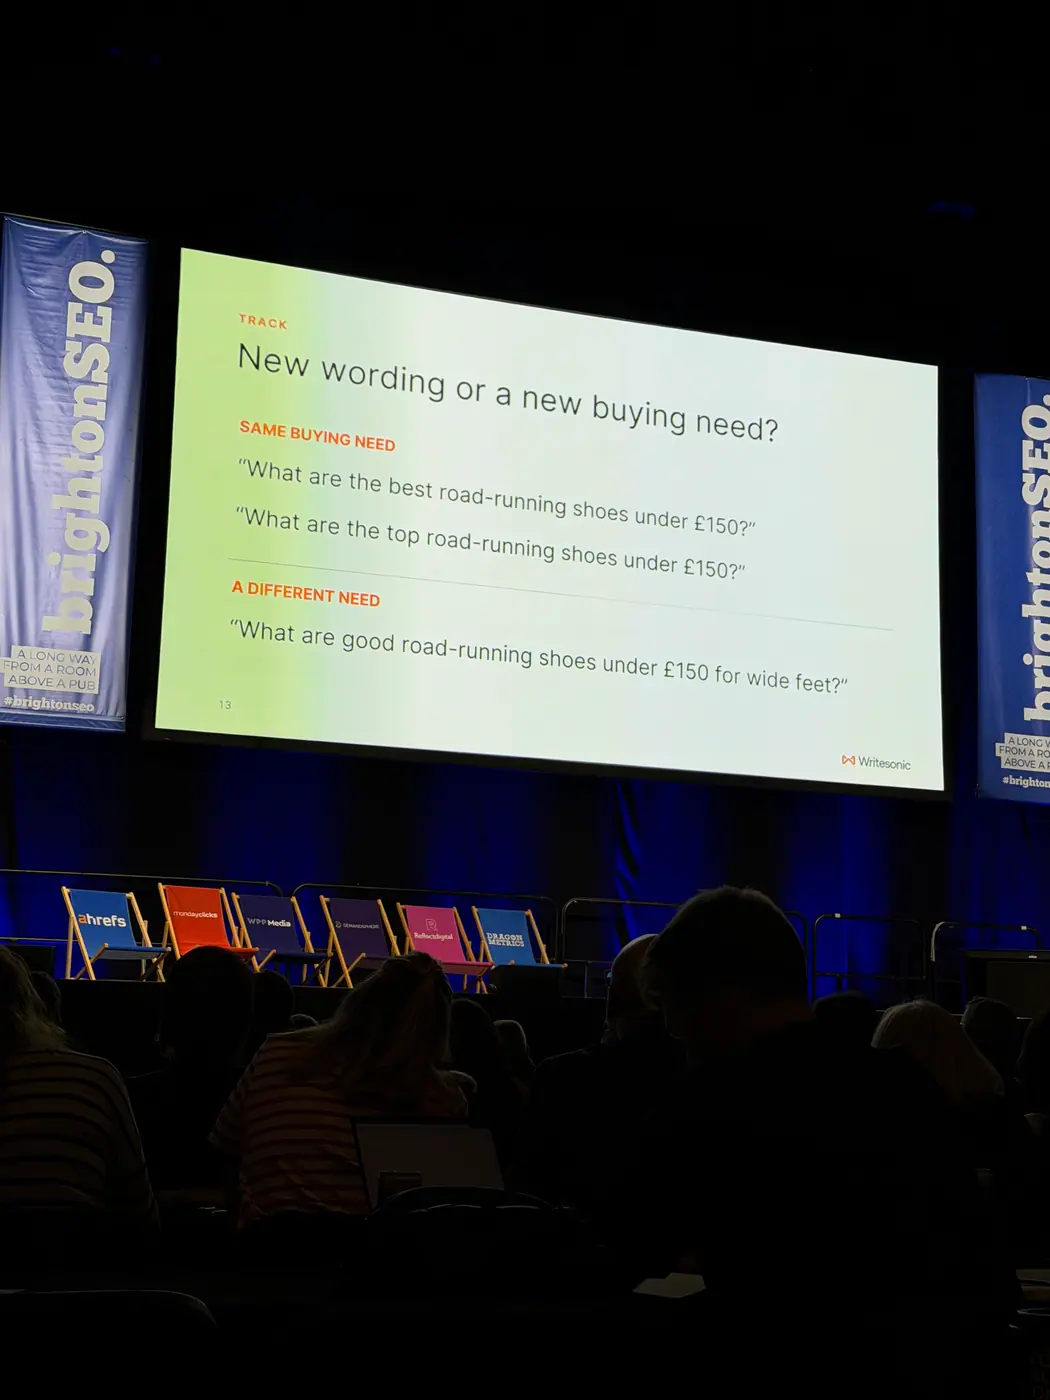
4. Nie śledź wariantów tego samego promptu – różnicuj potrzeby zakupowe i persony.
„Best road running shoes” i „top road running shoes” to ta sama intencja. Lepiej dodać inne potrzeby zakupowe (np. szeroka stopa, bieganie w deszczu) albo persony (np. „for casual runners in the UK”). Źródła promptów to notatki ze spotkań handlowych (np. z Granoli wrzucane co tydzień do Claude), zgłoszenia do helpdesku, recenzje, frazy SEO, Reddit i fora branżowe.
„So if you keep doing all of these near duplicate prompts, it will give you like thousands of different prompts, which will make your life like tougher. So it’s better to focus on a different buying need or a different intent.”
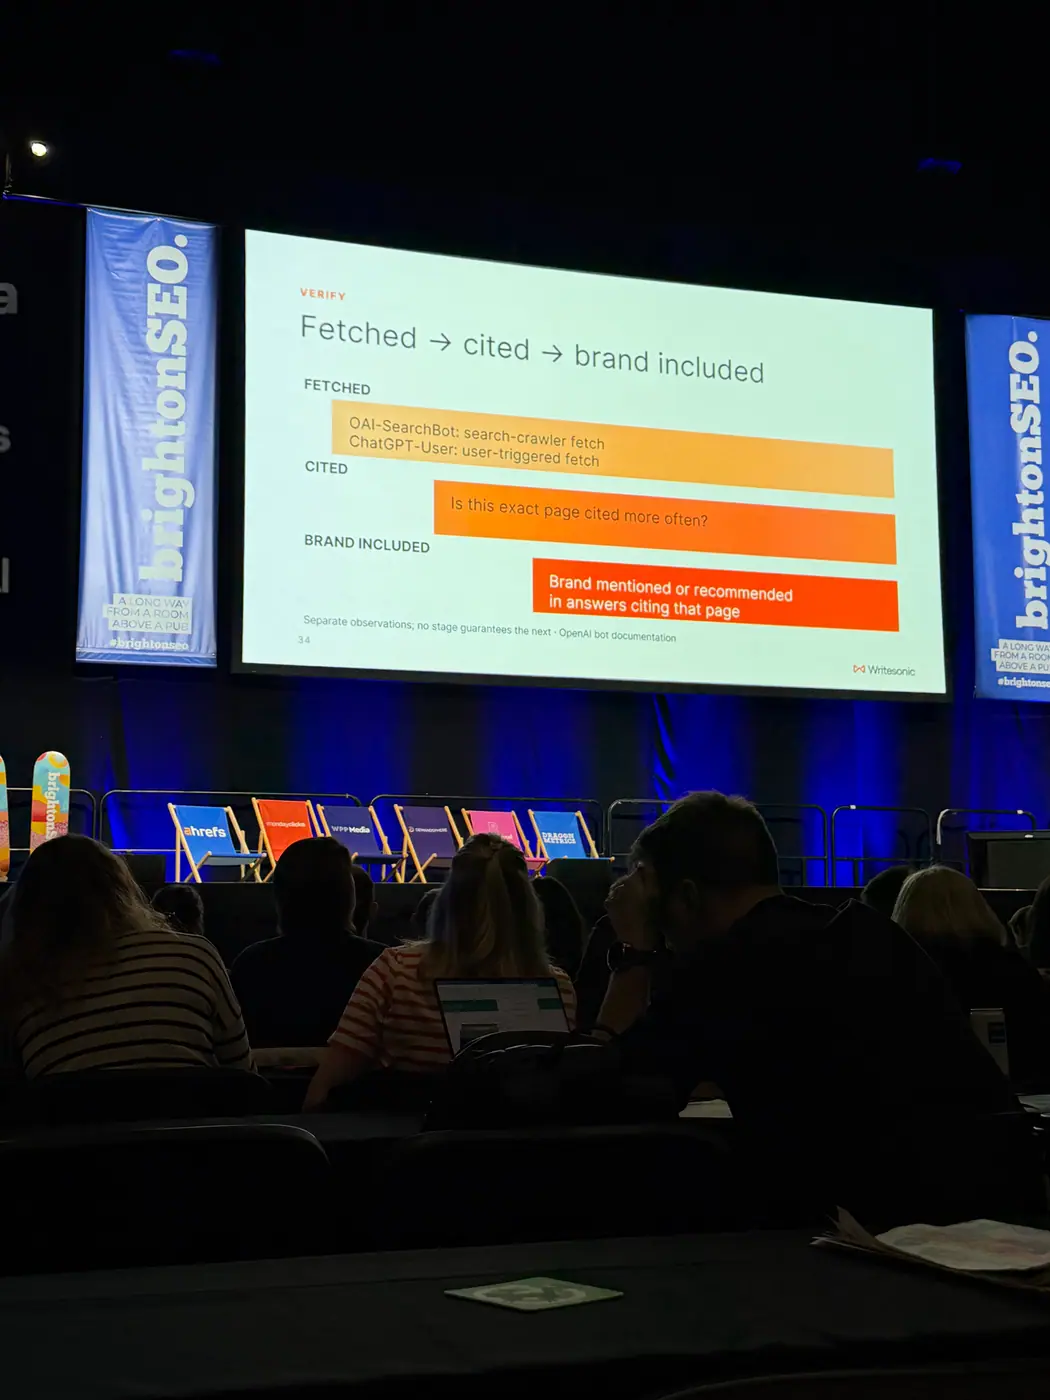
5. Weryfikacja „indeksacji” w LLM przez logi serwera: najpierw OAI-SearchBot, potem ChatGPT-User.
Jeśli masz śledzenie botów po stronie serwera, sprawdź dwie rzeczy. Po pierwsze, czy bot wyszukiwania OpenAI pobrał zaktualizowaną stronę (strona jest odkrywalna). Po drugie, czy pojawia się na niej bot ChatGPT-User, co oznacza, że ktoś zadał prompt, a ChatGPT przeczytał stronę na żywo. Dopiero potem patrzy się na wzrost cytowań i wzmianek.
„one thing you can check is, did the OpenAI search bot actually fetch that specific page that you updated or just built?”
6. Priorytetyzacja ICE: błąd w cenie z Twojej strony to szybka wygrana, ten sam błąd na Reddicie już nie.
Zadaniom przypisuje się ocenę Impact × Confidence × Ease, liczy średnią i sortuje listę. Zespół bierze z niej 5–10 zadań tygodniowo. „Ease” zależy od źródła: własną stronę lub kontrolowany blog poprawisz od ręki, komentarzy na Reddicie nie zmienisz.
„But let’s say if it is coming from Reddit, that’s a much trickier thing to do because you can’t control or edit the comments”
7. W pomiarze mianownik się nie zmienia: ten sam zestaw promptów, modeli i okres.
„Work completed does not mean impact measured”. Porównuj 7 dni do poprzednich 7 dni na identycznym zestawie promptów i modeli, nigdy 7 dni do miesiąca. Na start: jeden temat, 30–40 promptów, 30 dni śledzenia, przegląd luk co tydzień.
„The prompts, basically the denominator should not change.”
Zdjęcia: Samanyou Garg
46 kadrów · Fot. Robert Nowaczyk
Gintarė Rimolaitytė: Who AI Cites Now: How Source Patterns Shifted Since December 2025
10:30 · Auditorium 2
Streszczenie
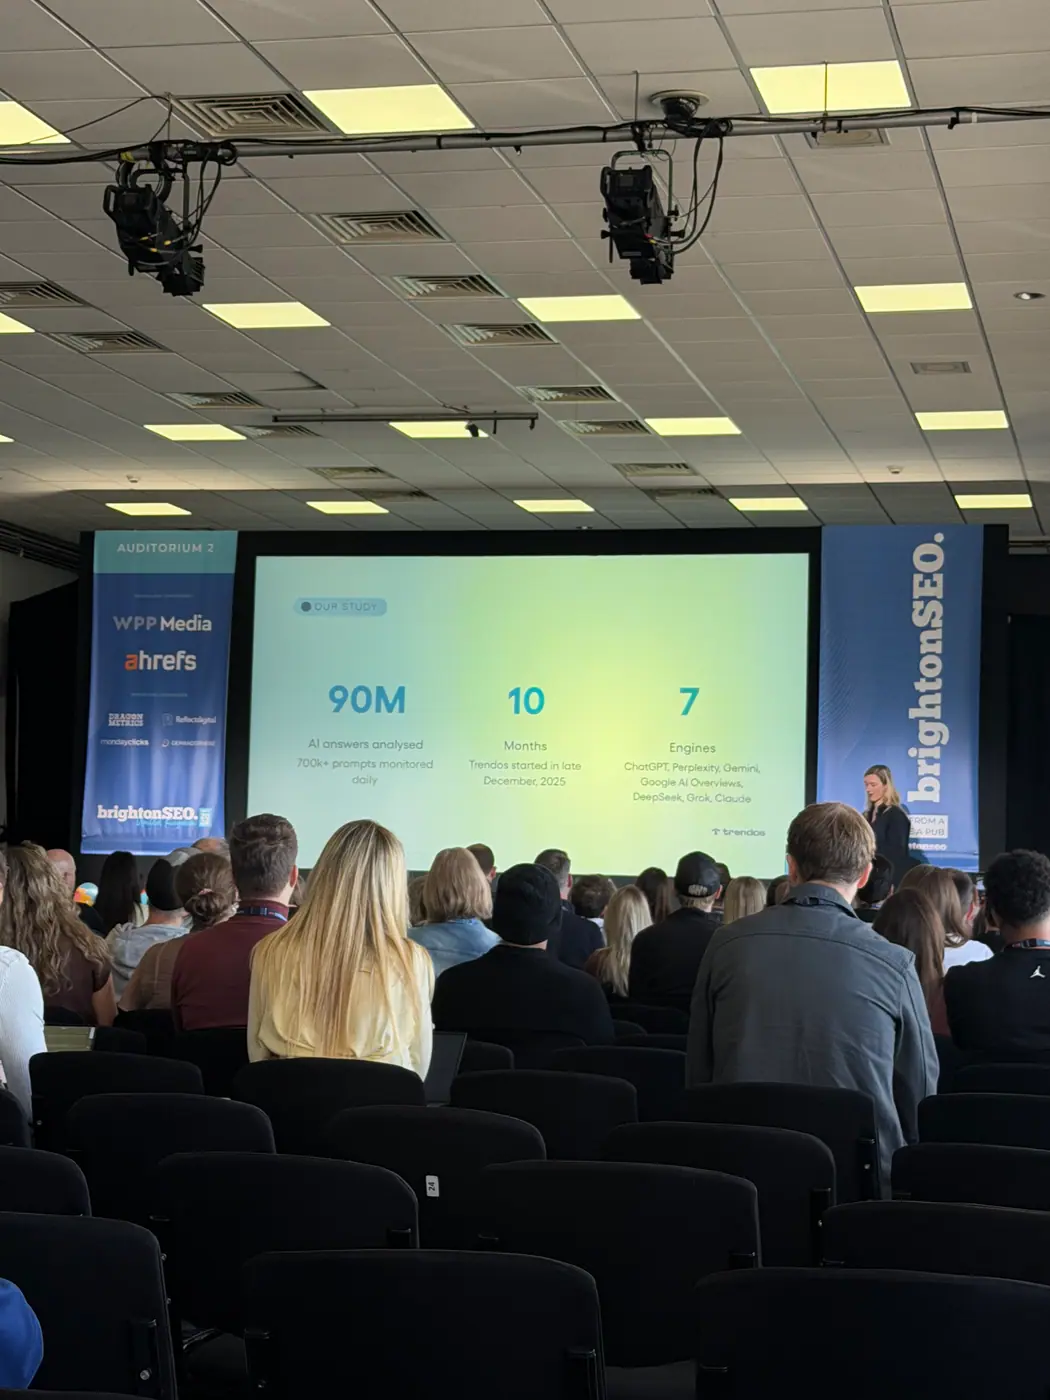
Gintarė Rimolaitytė podczas brightonSEO 8 października 2026 r. przedstawiła analizę widoczności marek i źródeł cytowanych przez silniki AI (Artificial Intelligence / sztuczna inteligencja).
Główna myśl: obecność marki w odpowiedzi, pozytywna rekomendacja i cytowanie jej strony to trzy różne rzeczy. Źródła informacji zmieniały się zależnie od branży, silnika i momentu pomiaru.
Dla SEO (Search Engine Optimization / optymalizacja pod wyszukiwarki) oznacza to konieczność analizowania nie tylko własnej witryny, ale również zewnętrznych treści, na podstawie których powstaje obraz marki.
Najważniejsze wnioski
Obserwacje przedstawione przez prelegentkę
Widoczność w jednym silniku nie oznacza obecności w pozostałych.
Część badanych marek nie pojawiała się w żadnym z siedmiu silników. Inne były widoczne tylko w niektórych. Prelegentka zalecała dobór monitorowanych silników do odbiorców firmy, zamiast traktowania jednego narzędzia jako reprezentacji całego rynku.Wzmianka nie jest równoznaczna z rekomendacją.
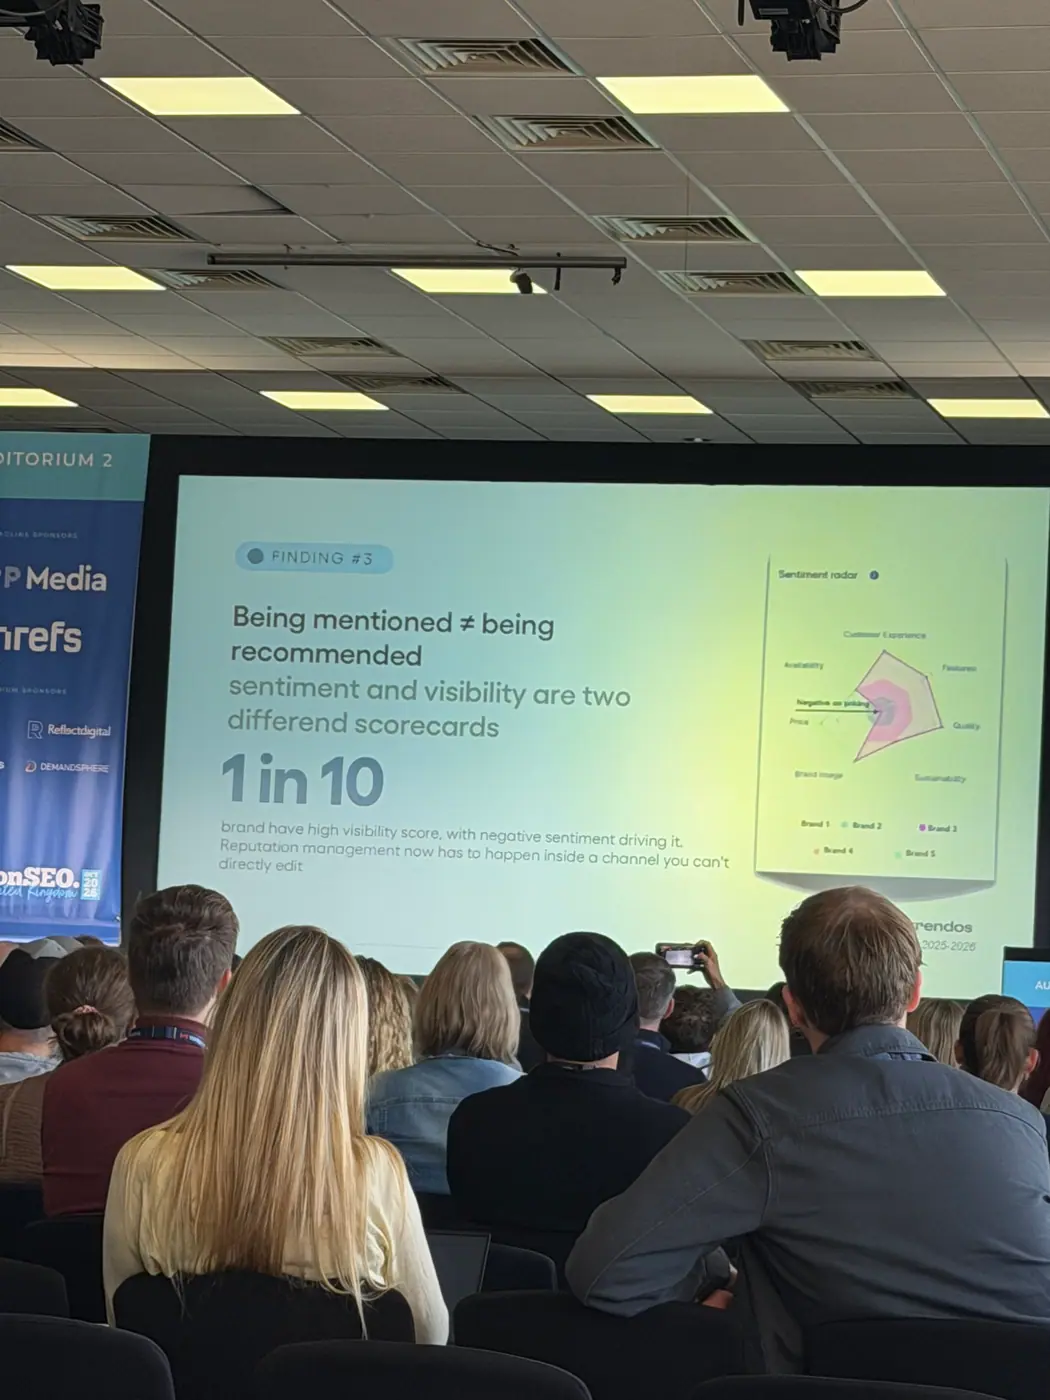
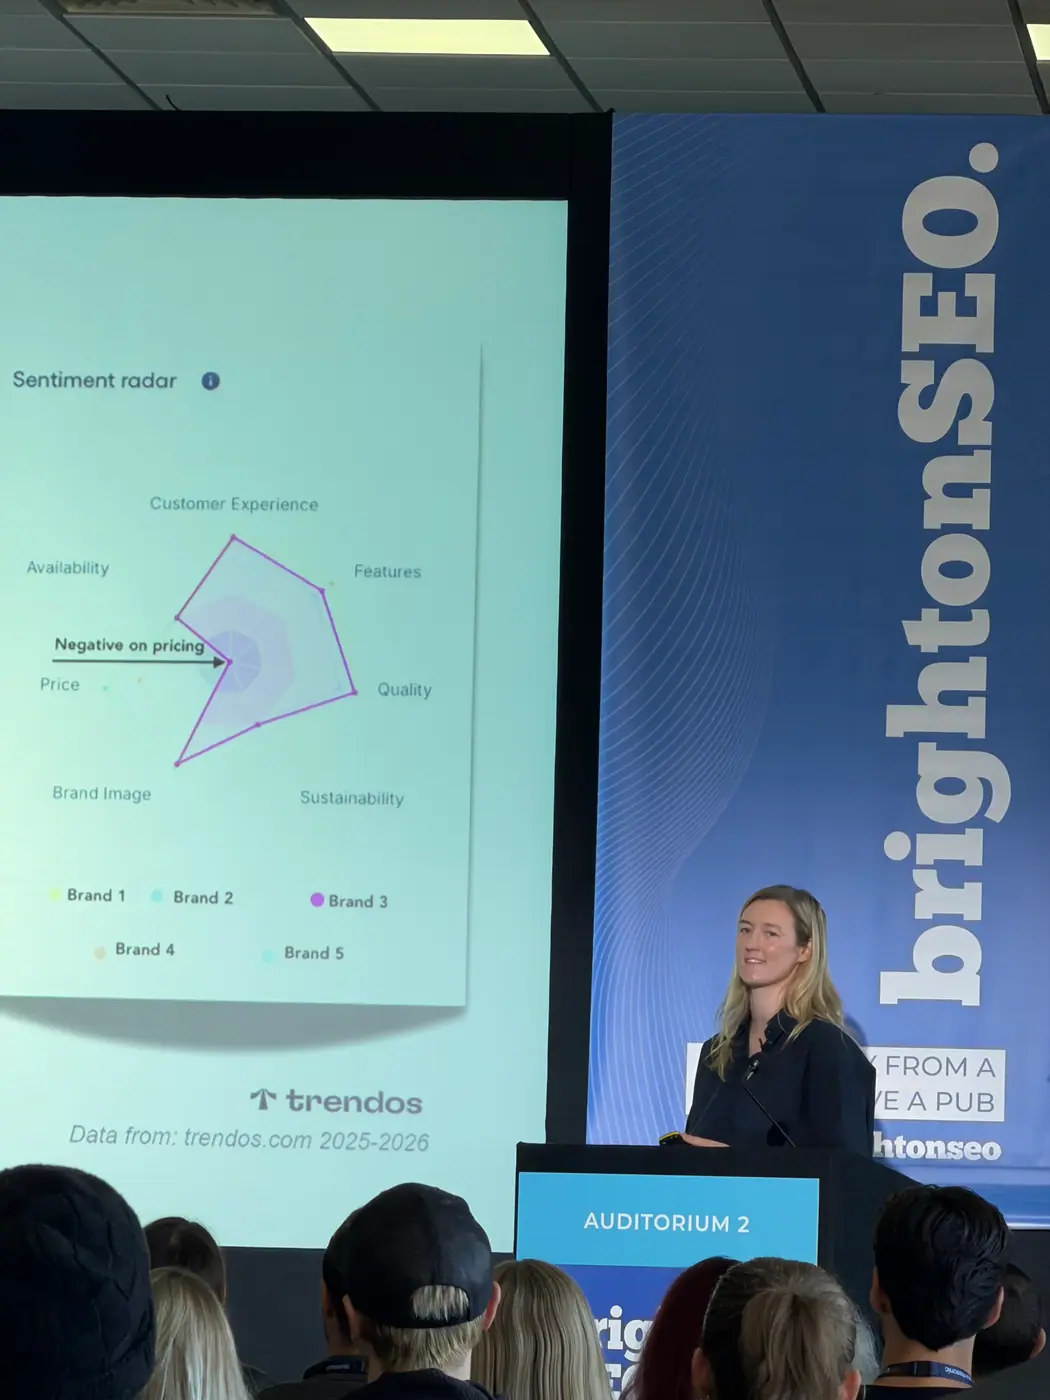
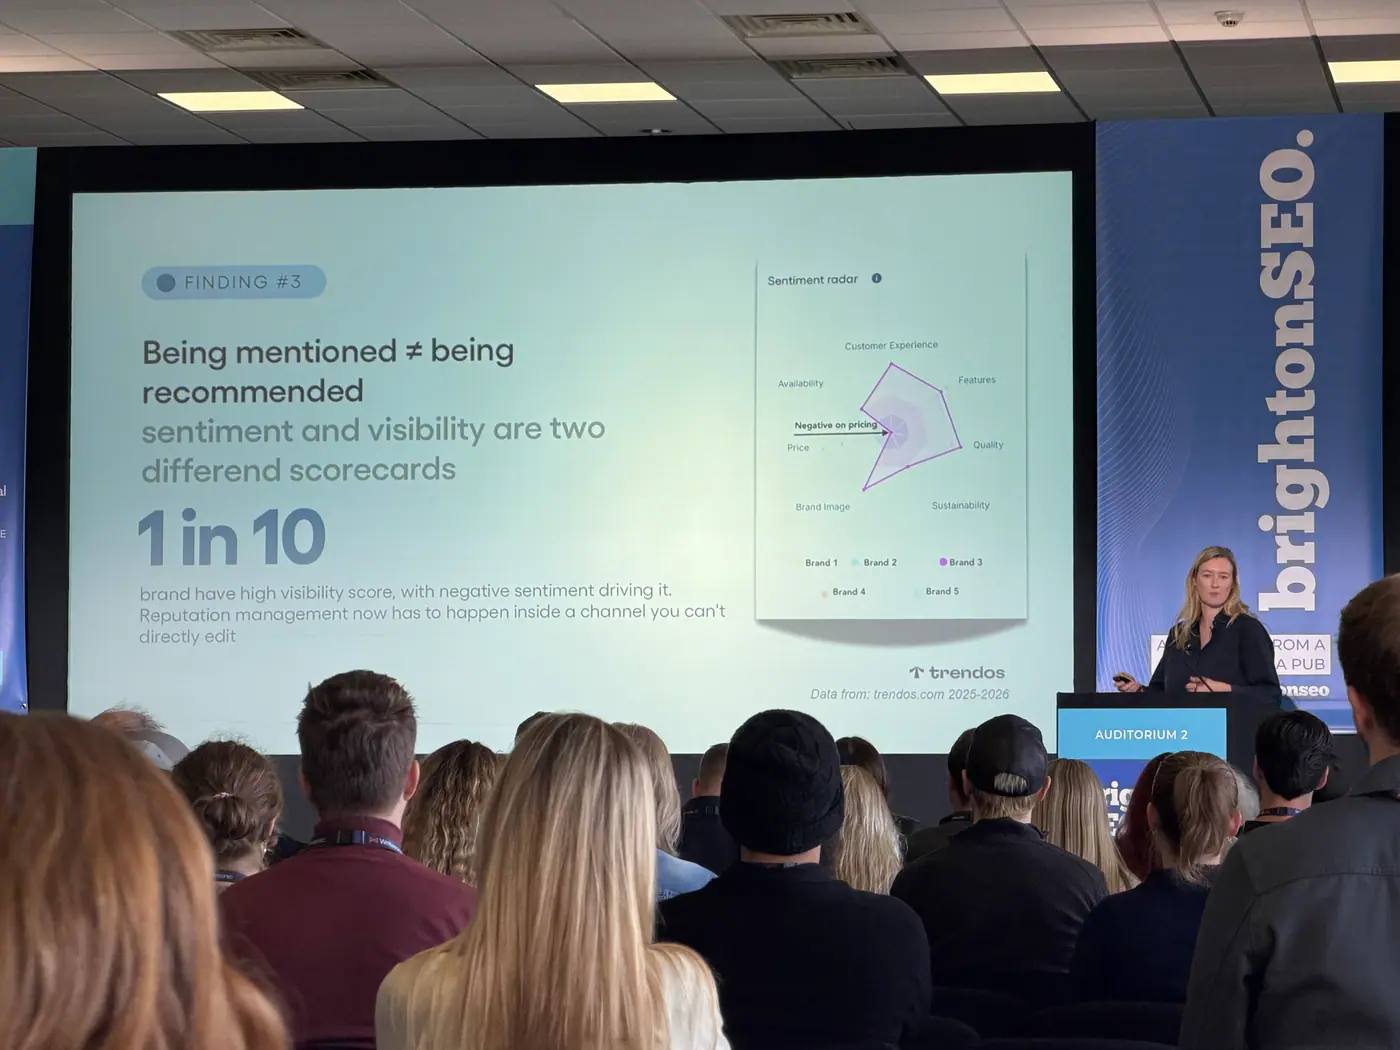
Rimolaitytė pokazała markę z wysoką widocznością, której oferta była opisywana jako zbyt droga i niewarta swojej ceny. Wynik widoczności wyglądał dobrze, ale treść odpowiedzi nie wspierała wyboru tej firmy.Własna domena nie musi być głównym źródłem informacji o marce.
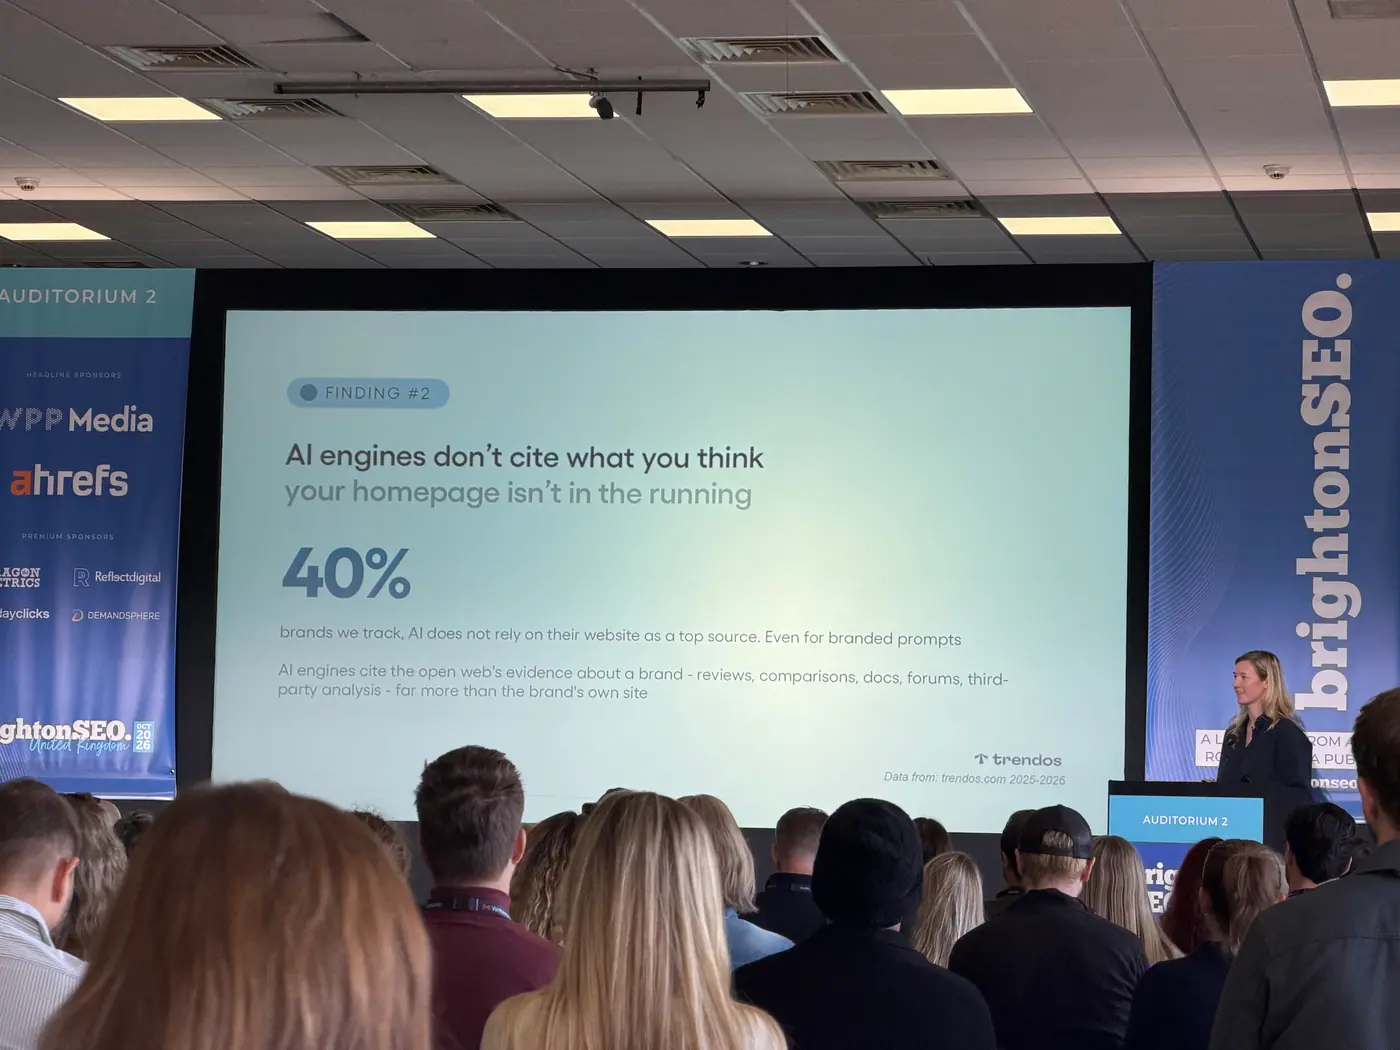
Silniki korzystały również z recenzji, porównań, dokumentacji, forów i materiałów wideo. Jednocześnie prelegentka podkreśliła, że aktualność i jakość firmowej witryny nadal miały znaczenie.Struktura źródeł zależała od branży.
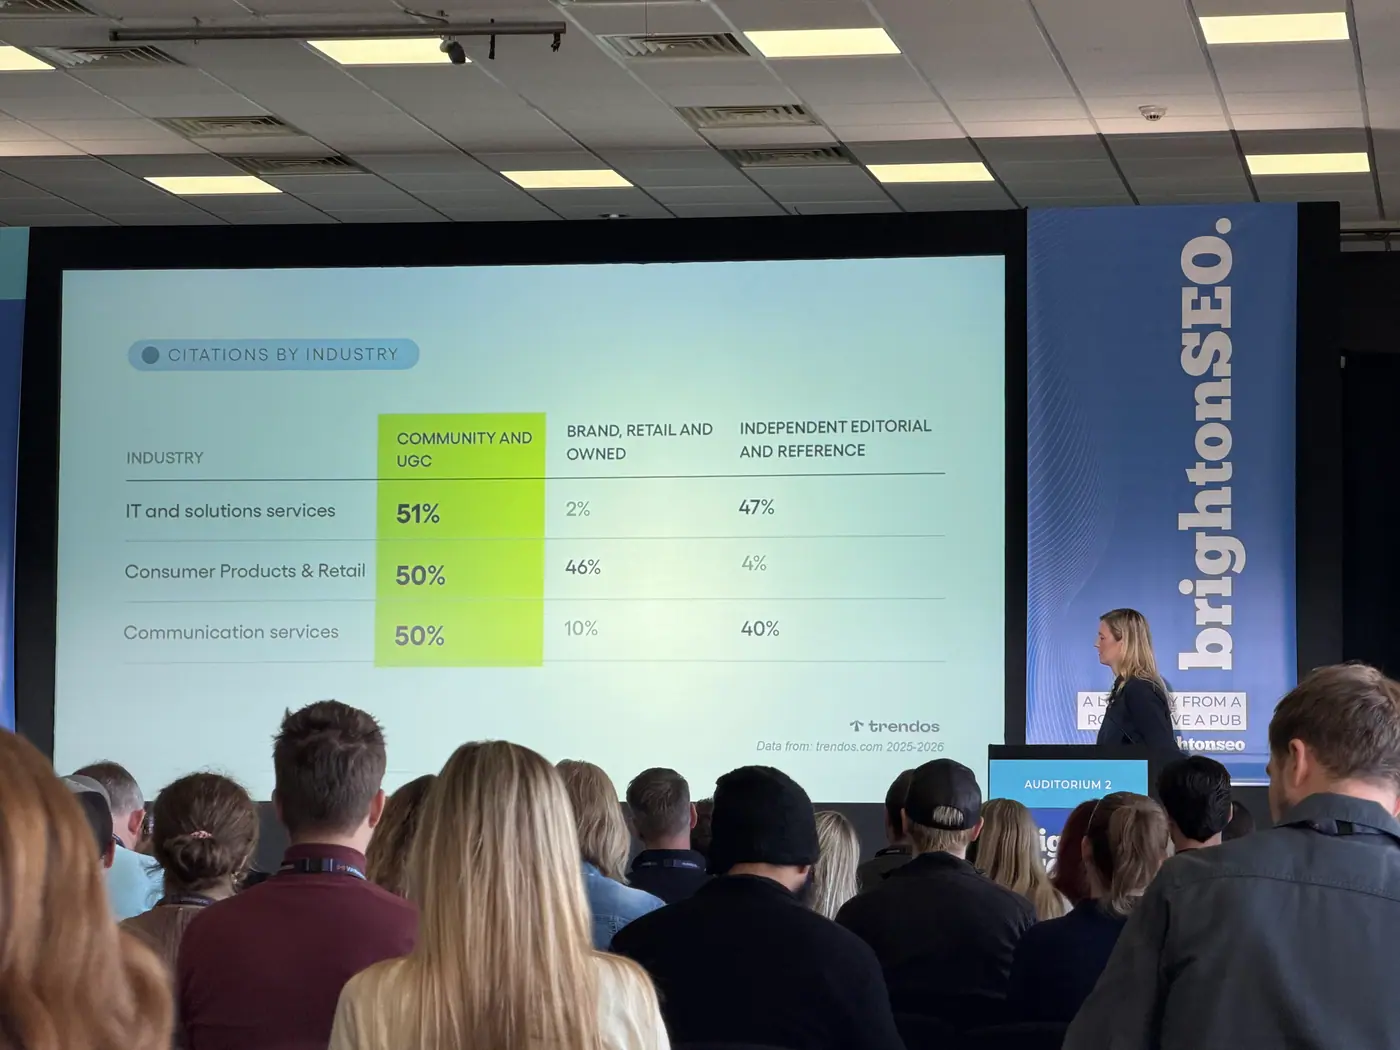
- Produkty konsumenckie i handel: istotna rola stron marek, sprzedawców oraz lokalnych wersji serwisów.
- Usługi informatyczne i rozwiązania technologiczne: znaczenie materiałów redakcyjnych i serwisów z recenzjami.
- Usługi komunikacyjne: duża rola społeczności oraz niezależnych mediów.
Do UGC (User-Generated Content / treści tworzone przez użytkowników) prelegentka zaliczała także opinie publikowane w serwisach recenzenckich.
Poszczególne silniki korzystały z różnych zestawów źródeł.
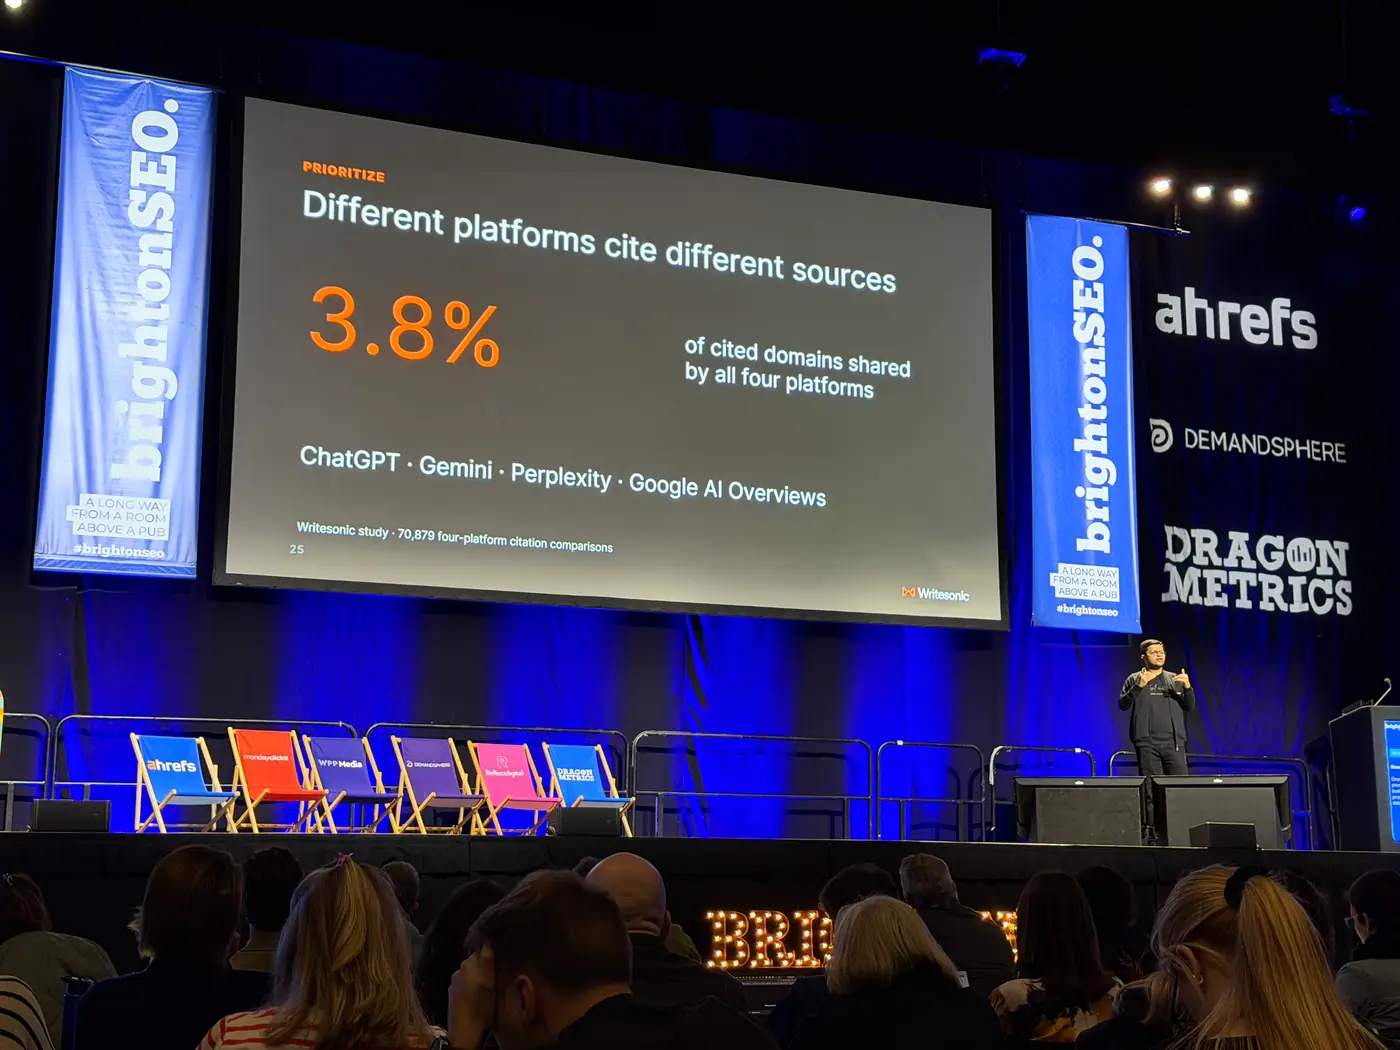
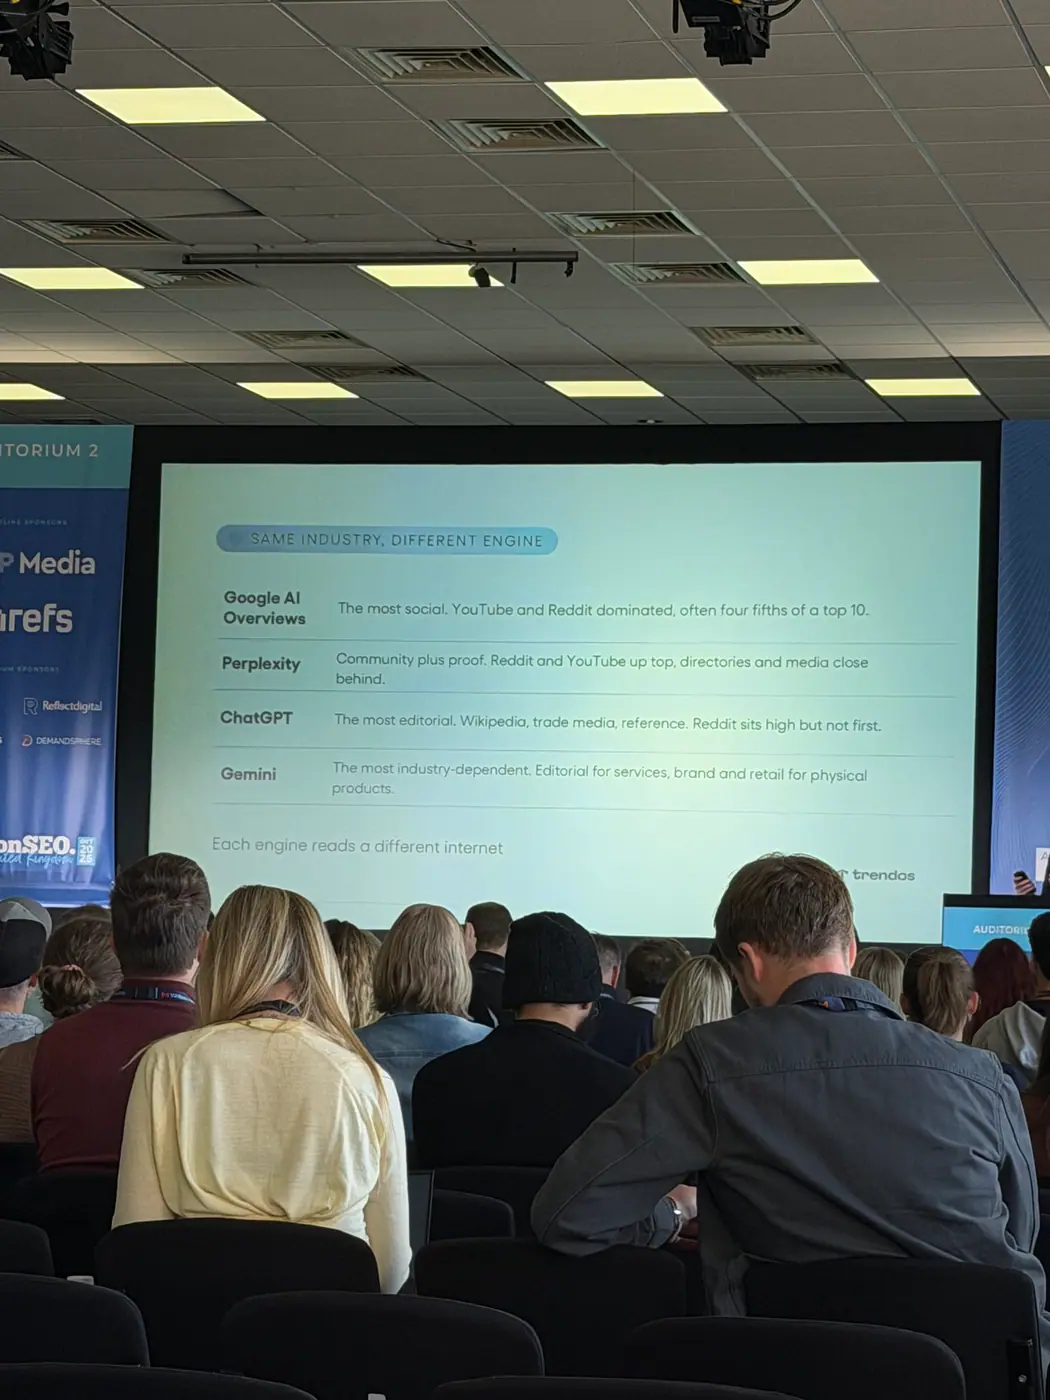
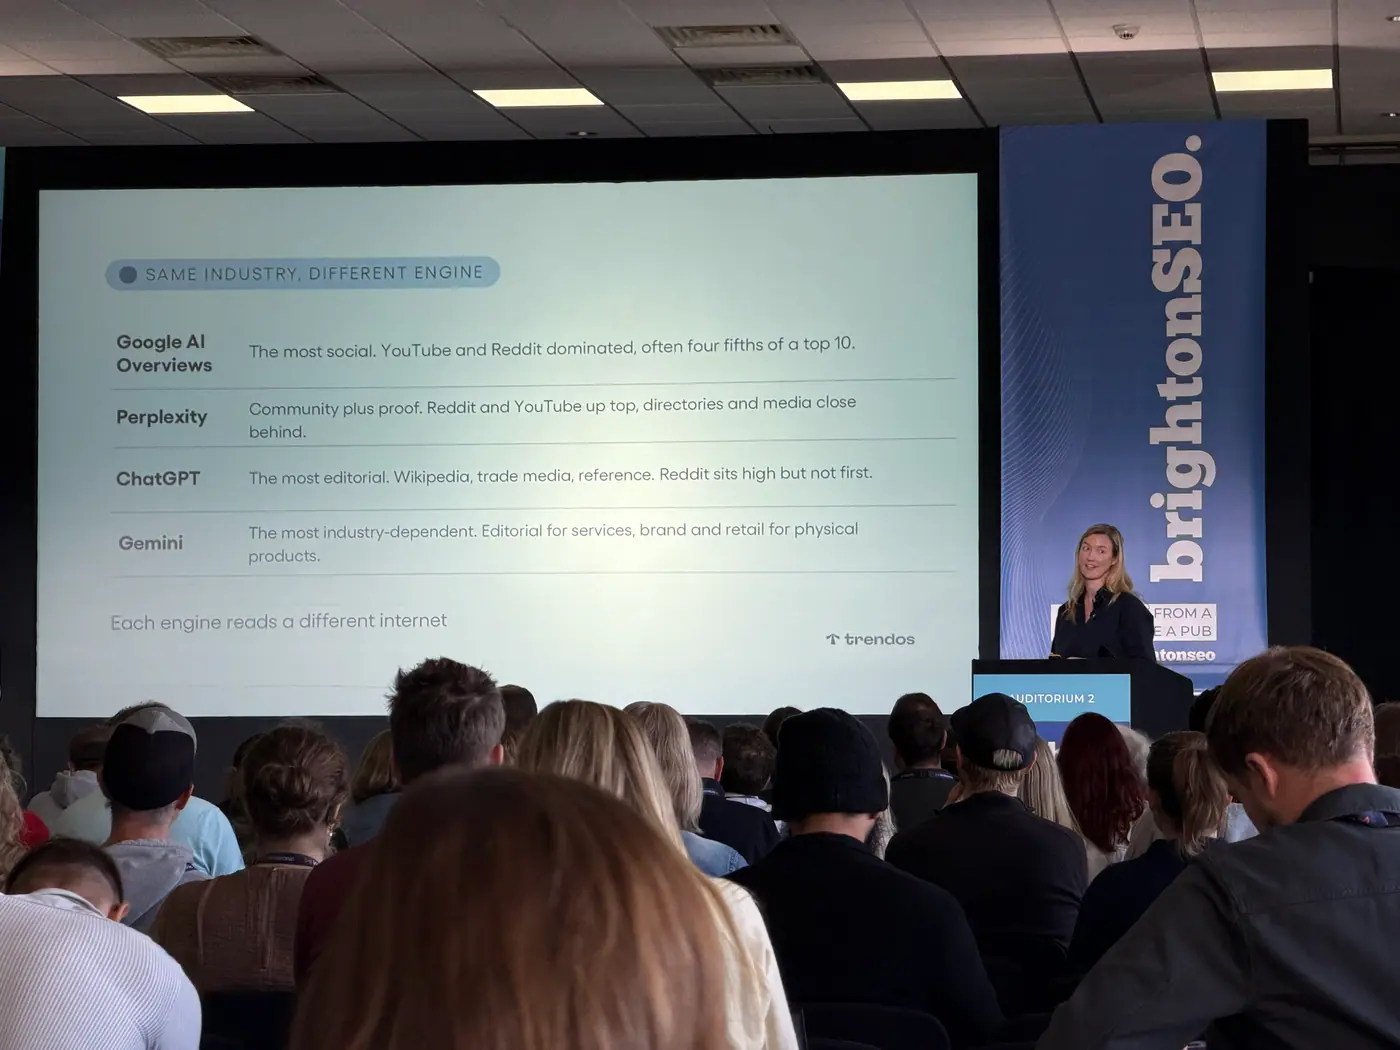
W przedstawionej analizie Google AI Overviews najrzadziej sięgało do witryn marek, a mocno korzystało z platform społecznościowych. ChatGPT częściej opierał się na źródłach redakcyjnych i referencyjnych. Perplexity łączyło treści społecznościowe z materiałami potwierdzającymi informacje. W Gemini szczególnie duże znaczenie miała branża.Zmiany źródeł i konkurentów nie były jednakowe dla całego rynku.
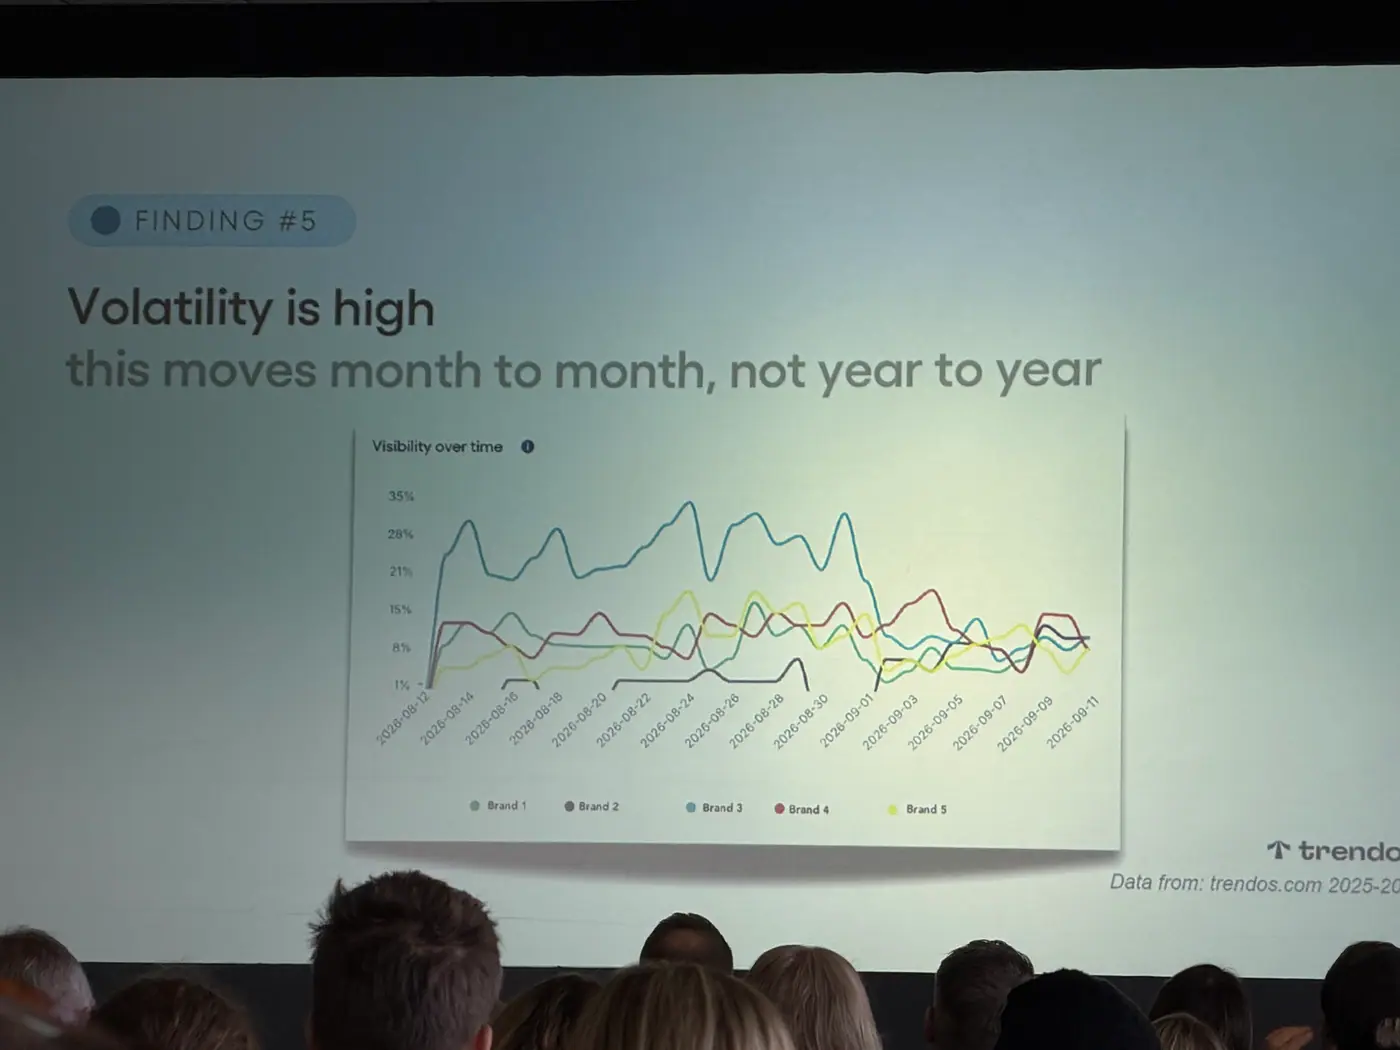
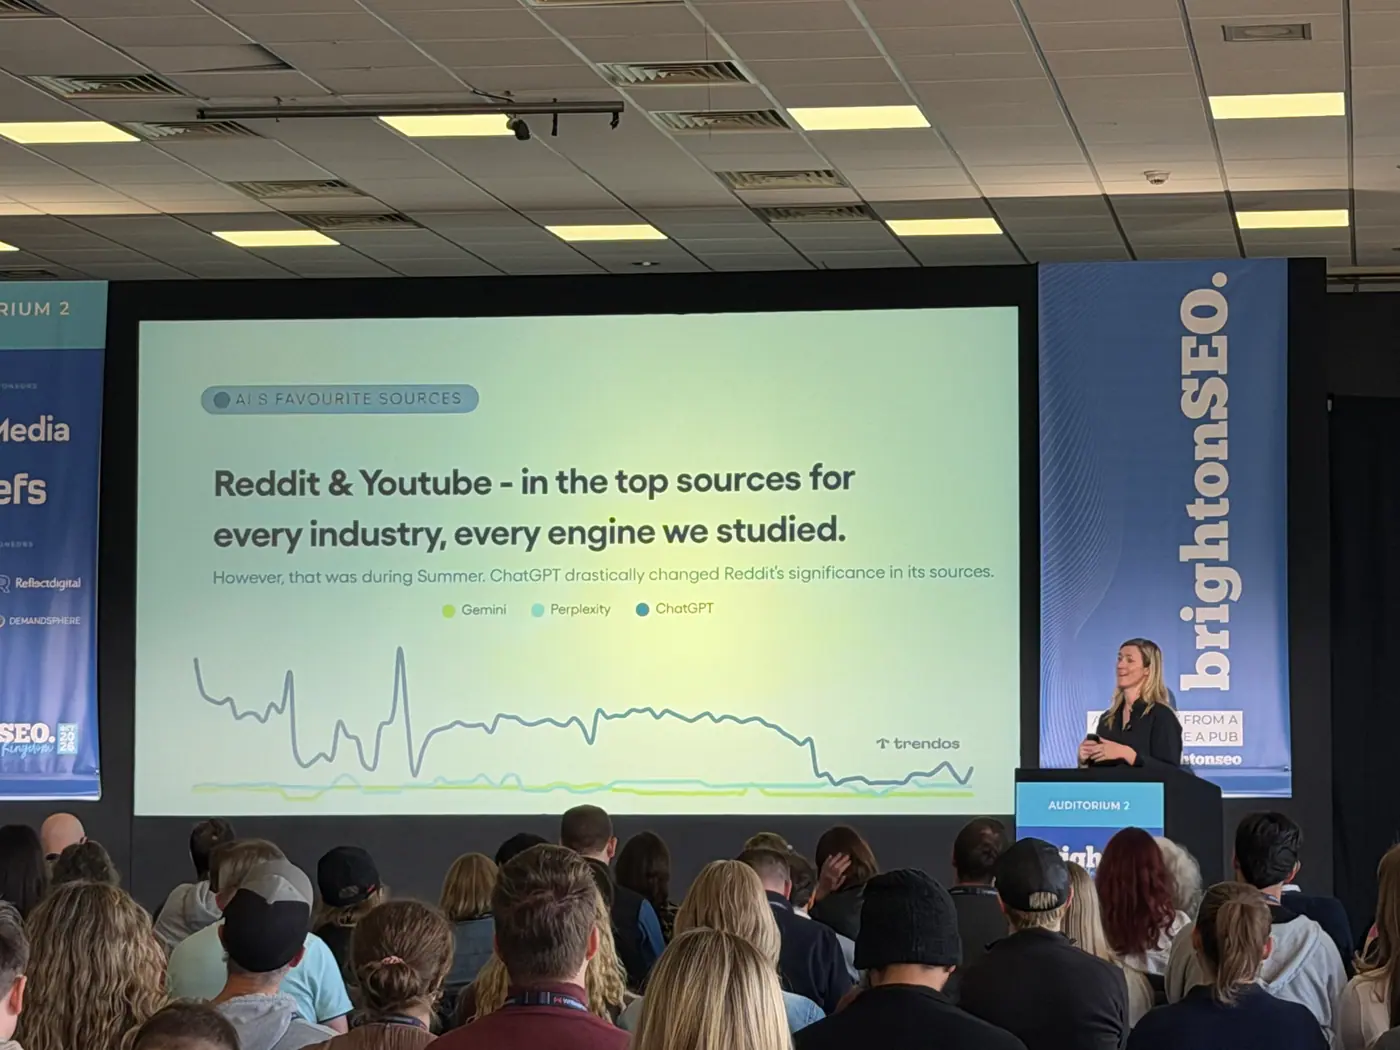
Spadek znaczenia Reddita dotyczył ChatGPT, ale nie każdej branży. Prelegentka nie zaobserwowała analogicznego spadku w Gemini i Perplexity. Zwróciła też uwagę, że większa zmienność widoczności dotyczyła nisz niż kategorii z wyraźnymi liderami.
Interpretacje i postulaty prelegentki
- Popularność treści społecznościowych tłumaczyła ich organicznym charakterem. Było to jej wyjaśnienie obserwowanego wzorca cytowań.
- Znaczenie witryn marek i sprzedawców w handlu wiązała z uporządkowaną strukturą informacji.
- Obecność firm z sąsiednich kategorii traktowała jako możliwą wskazówkę do rozwoju oferty, a nie wyłącznie zagrożenie konkurencyjne.
Dane liczbowe i przykłady
Poniższe wartości odnoszą się do badania i przykładów przedstawionych podczas prelekcji.
| Wartość | Znaczenie |
|---|---|
| Ponad 90 mln odpowiedzi | Skala analizowanego materiału. |
| 10 miesięcy, 7 silników | Okres analizy i liczba silników uwzględnionych w prezentacji. |
| Około 20% badanych marek | Zerowa widoczność we wszystkich siedmiu silnikach. |
| Około 20% badanych marek | Zerowa widoczność w części silników, przy obecności w innych. |
| 1 na 10 marek | Wysoka widoczność połączona z niekorzystnym wydźwiękiem odpowiedzi. |
| 0,1% | Udział własnej witryny w cytowanych źródłach w jednym pokazanym przykładzie klienta. |
| 2500 monitorowanych branż | Zakres monitoringu deklarowany przez prelegentkę; szczegółowo omówiła trzy branże. |
| 10–20 pytań | Rekomendowany punkt wyjścia do ręcznego audytu cytowań. |
| Około 3–13 źródeł na odpowiedź | Orientacyjna liczba źródeł wskazana przez prelegentkę, zależna od silnika. |
Praktyczne rady
Mierz obecność i wydźwięk razem.
Sprawdzaj nie tylko, czy marka występuje w odpowiedzi, ale też w jakim kontekście: ceny, jakości, wartości oferty czy dopasowania do potrzeb.Buduj mapę źródeł dla konkretnej branży, silnika i rynku.
Nie przenoś automatycznie zaleceń między kategoriami. W handlu prelegentka szczególnie podkreśliła znaczenie lokalnych wersji serwisów i aktualności informacji produktowych.Oddziel własną domenę od własnych treści.
Materiał opublikowany poza firmową stroną nadal może przedstawiać perspektywę marki. Rimolaitytė relacjonowała testy, w których publikacje na LinkedIn pojawiały się w Google AI Overviews już następnego dnia. Wskazała także znaczenie transkrypcji materiałów z YouTube.Analizuj firmy pojawiające się obok Twojej marki.
Mogą to być nie tylko bezpośredni konkurenci, ale także dostawcy rozwiązań odpowiadających na sąsiednią potrzebę klienta.Regularnie wracaj do tych samych pytań.
Prelegentka opisywała zmiany źródeł zachodzące z miesiąca na miesiąc, a czasem z dnia na dzień. Jednorazowy audyt nie wystarczy do oceny trwałej obecności.
Knowledge bombs
1. Claude zachowuje się zupełnie inaczej niż reszta silników – w B2B sprawdzaj go osobno.
Wysoka widoczność w ChatGPT nie gwarantuje widoczności w Claude. Prelegentka łączy Claude głównie z B2B. W B2C można go pominąć, w B2B trzeba go mierzyć osobno.
„So if you are scoring high visibility on chatGPT, for example, be mindful of Cloud, especially if you are running in B2B business, because Cloud is usually directly linked to B2B, right?”
2. Google AI Overviews ze wszystkich silników najmniej korzysta ze strony marki.
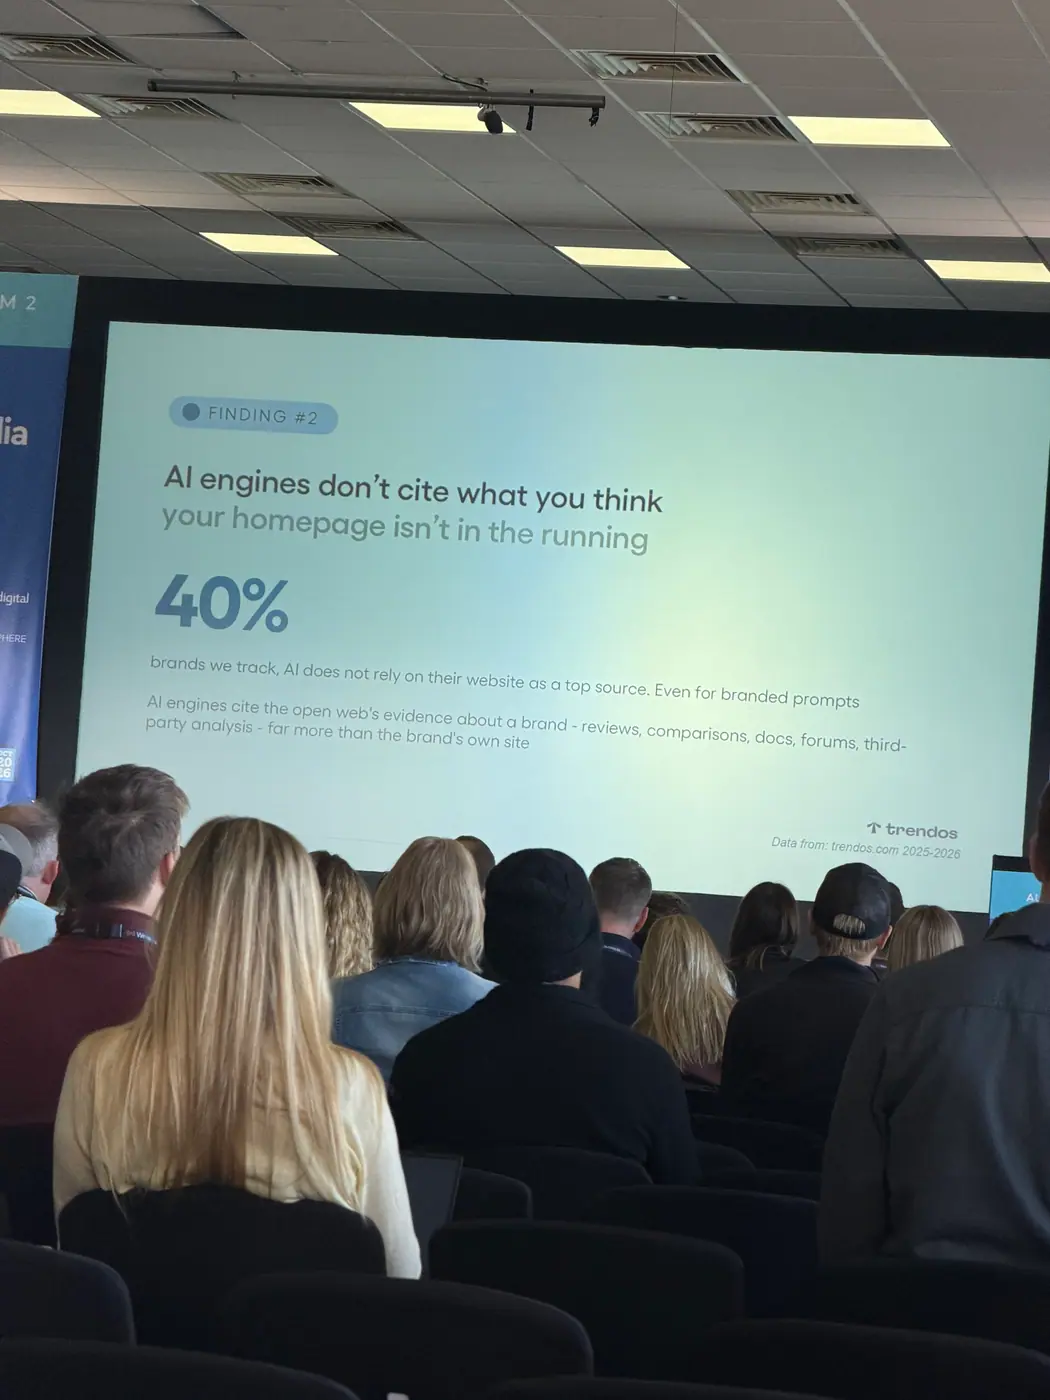
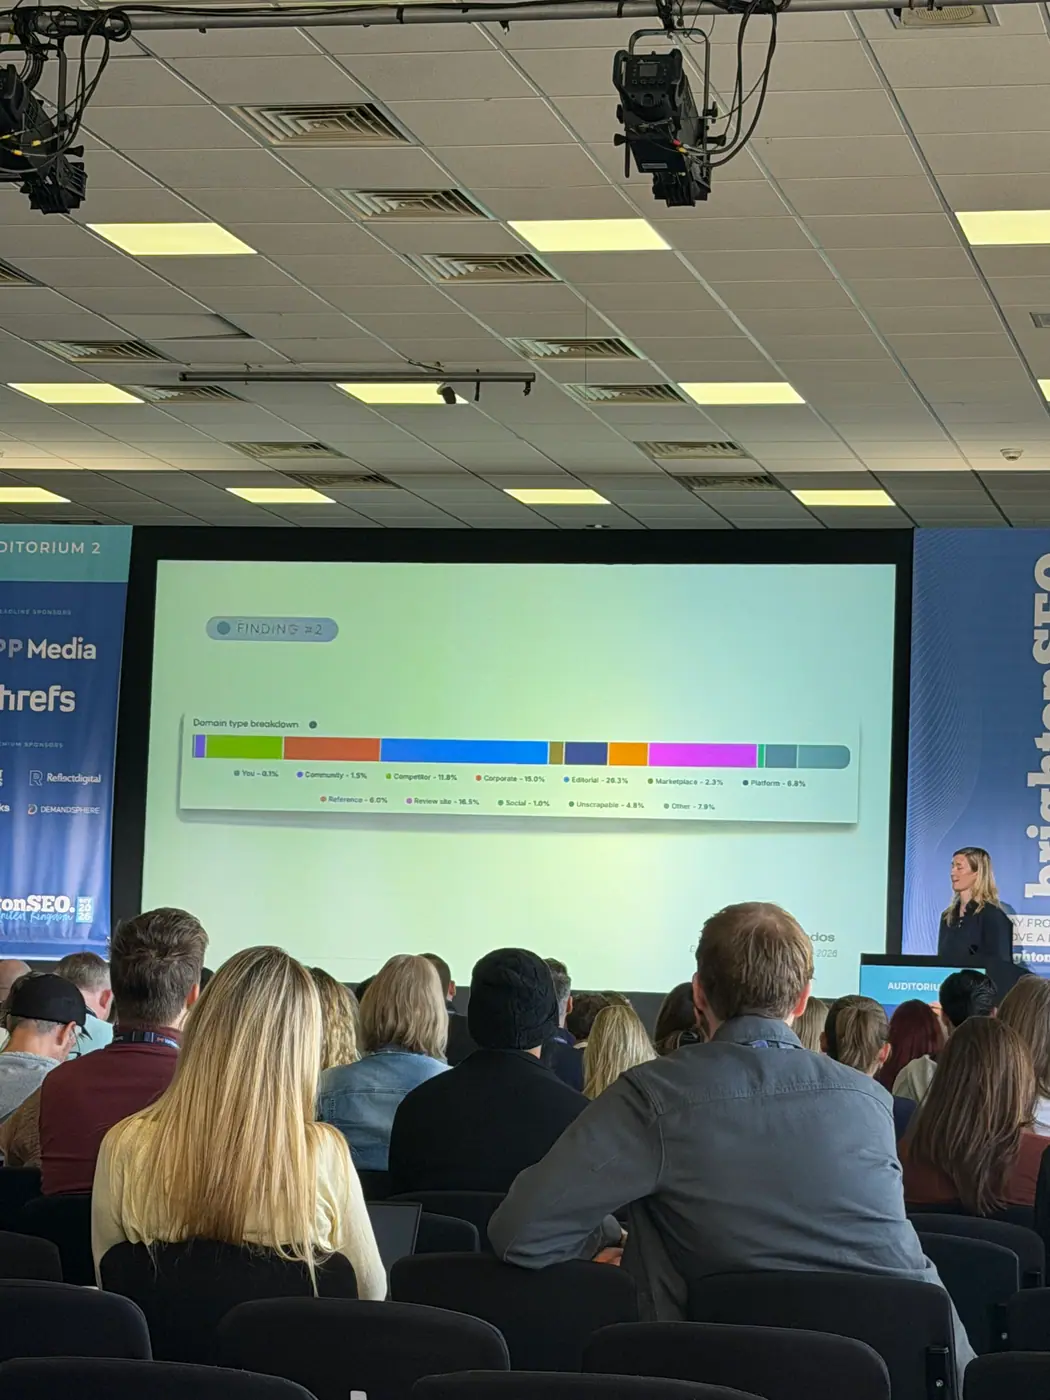
Według badania dla około 40% marek AI nie korzysta ze strony marki jako głównego źródła (w nagraniu najpierw pada „about 40 brands”, potem „40% is not 100%”), nawet przy promptach brandowych. AI Overviews „wychodzi” najdalej poza stronę marki: do recenzji, porównań, dokumentacji, forów i YouTube’a. U jednego z klientów strona własna stanowiła zaledwie 0,1% cytowanych źródeł. Prelegentka zastrzega przy tym, że strona wciąż jest jednym ze źródeł i musi być aktualna.
„Google AI overview is the one that looks the least into the website of your brand.”
3. LinkedIn trafia do AI Overviews następnego dnia – z profilu firmy i z prywatnego.
Z ich testów wynika, że AI Overviews bardzo szybko indeksuje LinkedIn i mu ufa. Nie ma znaczenia, czy publikuje strona firmowa, czy osoba prywatna, ani czy to post, czy artykuł. Skoro AIO najmniej ufa stronie marki, własne treści można dystrybuować przez LinkedIn. YouTube dominuje we wszystkich silnikach, które korzystają z transkrypcji filmów.
„We’ve done a lot of tests with Google AI overviews with LinkedIn. If you publish today, tomorrow it will be there.”
4. Każdy silnik ma swój „charakter” źródeł: Perplexity lubi Facebooka, ChatGPT jest najbardziej redakcyjny, Gemini zależy od branży.
Perplexity to „społeczność plus dowód” i często cytuje Facebooka (zależnie od branży). ChatGPT najchętniej sięga po Wikipedię, media branżowe i serwisy referencyjne. Gemini najsilniej zależy od branży, więc nie ma dla niego uniwersalnego źródła. AI Overviews jest najbardziej „społecznościowy”.
„Perplexity is community plus proof. Perplexity likes Facebook a lot.”
5. Reddit spadł jako źródło tylko w ChatGPT – w Gemini i Perplexity nie.
Reddit wypadł z top 5 źródeł ChatGPT, ale w Gemini i Perplexity nie stracił. Zależy to też od branży: u jednego z największych banków na Litwie (klient prelegentki) Reddit nadal jest jednym z głównych źródeł. Wniosek: nie skreślać Reddita bez sprawdzenia danych dla własnej branży.
„It dropped a bit, quite a bit on ChatGPT as a source. It used to be at one of the top five sources.”
6. W retailu i produktach konsumenckich AI opiera się mocno na stronie marki, a źródła są silnie lokalne (np. Amazon.fr).
To odwrotność trendu ogólnego. W kategorii consumer products & retail dużą rolę gra strona własna, bo jest dobrze ustrukturyzowana. Dla tej branży PR i media niezależne nie muszą być priorytetem nr 1. Za to trzeba pilnować treści o produktach na lokalnych wersjach marketplace’ów. W IT i usługach dominują serwisy redakcyjne i recenzje.
„And I would also be quite mindful of the localization part, because especially in this industry, from what we noticed, it tends to become very local, like Amazon and other pages.”
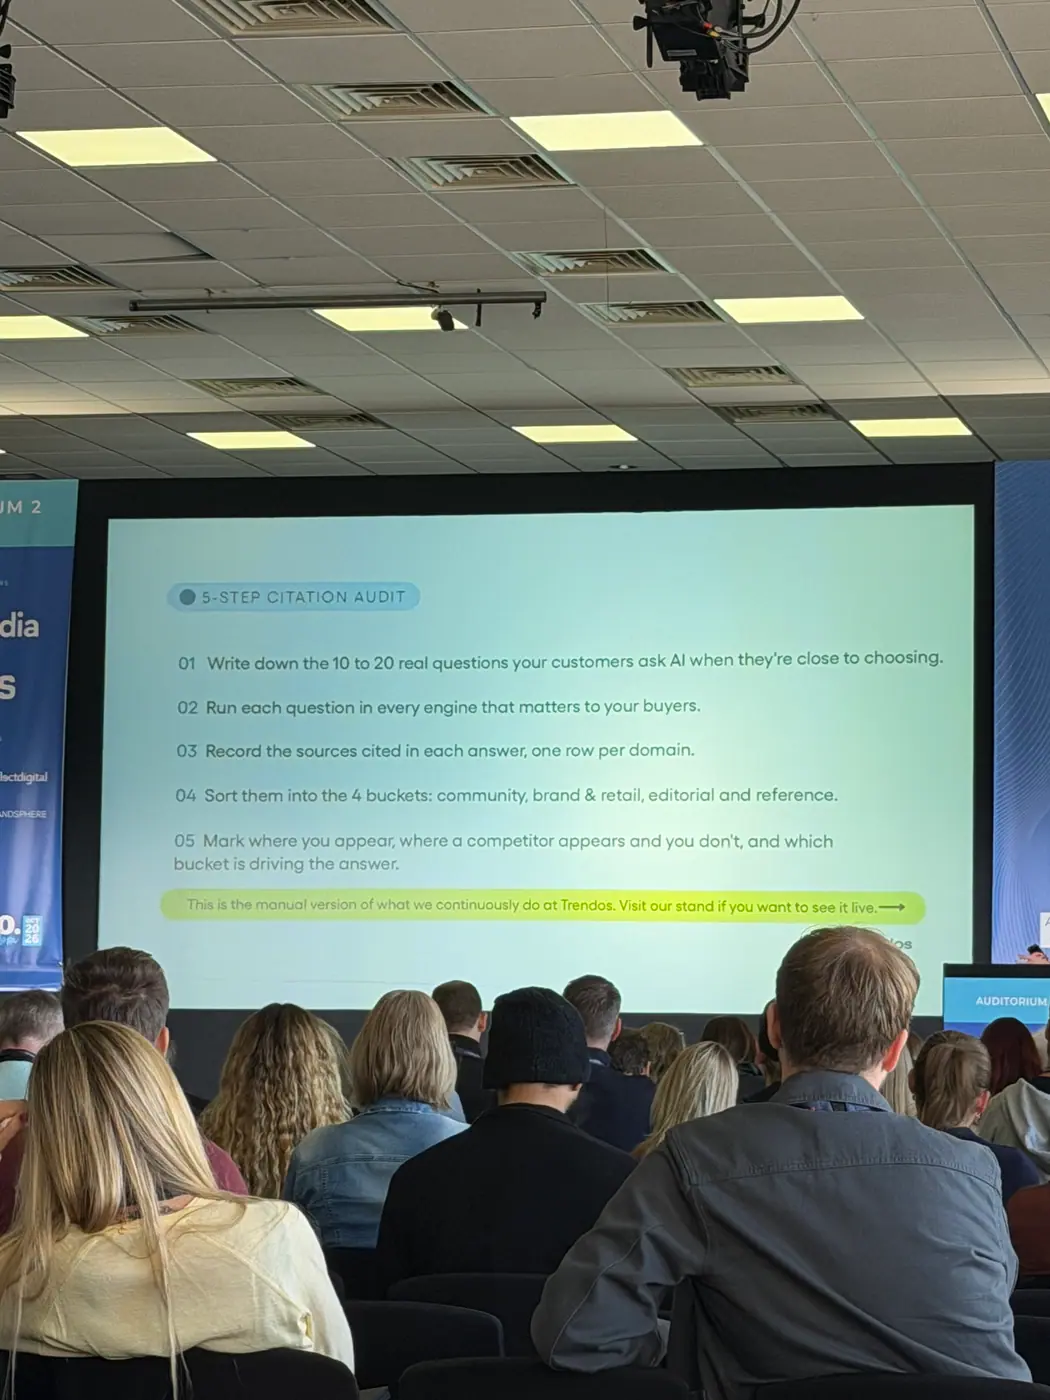
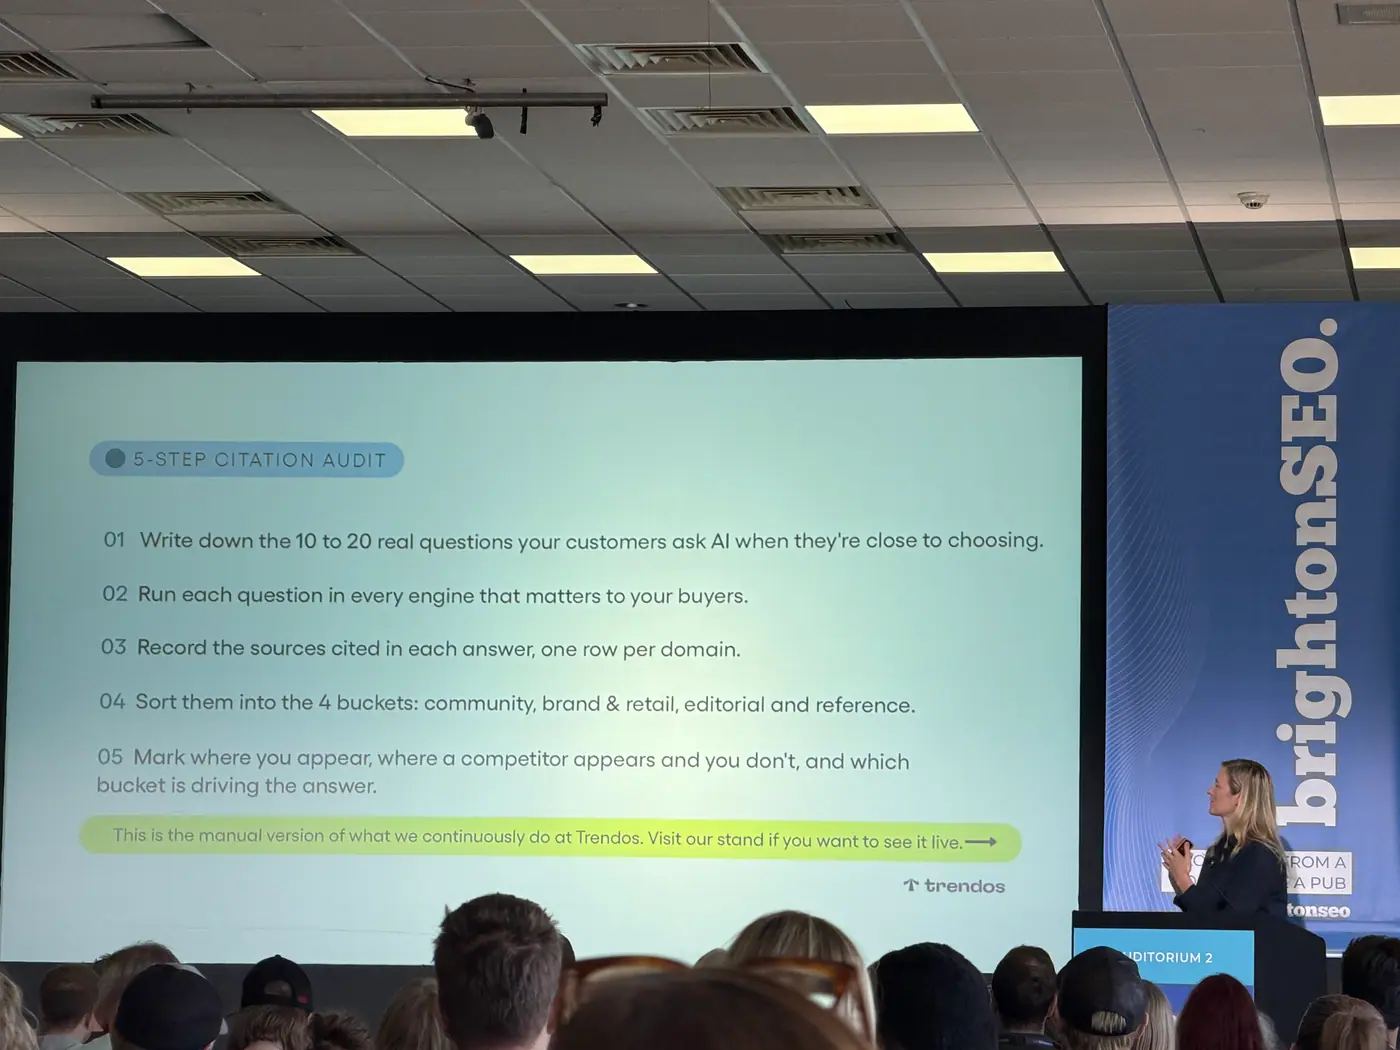
7. Ręczny audyt cytowań: 10–20 pytań, 3–13 źródeł na odpowiedź, 4 kategorie źródeł.
Kroki: wybrać 10–20 realnych pytań (np. frazy o największym wolumenie z Ahrefs przerobione na prompty przez ChatGPT/Claude), uruchomić je w silnikach istotnych dla firmy, zebrać cytowane źródła i podzielić je na kategorie: community, brand & retail, editorial, reference. Następnie oznaczyć, gdzie jest konkurent, a nie ma Ciebie. Jeśli to nie jest strona konkurenta, można tam wejść (thought leadership, płatnie, social media).
„Usually it’s about, I think, 3 to 13 depending on the engine that you get of the sources.”
Zdjęcia: Gintarė Rimolaitytė
25 kadrów · Fot. Robert Nowaczyk
Christian Goodrich: How Claude Code Helped Me Transform Reporting and Delivery for AI Search and SEO
11:20 · Syndicate 3&4 (MeasureFest)
Streszczenie
Christian Goodrich pokazał na brightonSEO, jak z pomocą Claude Code zbudował wewnętrzny portal wspierający SEO (Search Engine Optimization / optymalizacja pod kątem wyszukiwarek) oraz analizę widoczności w AI (Artificial Intelligence / sztuczna inteligencja).
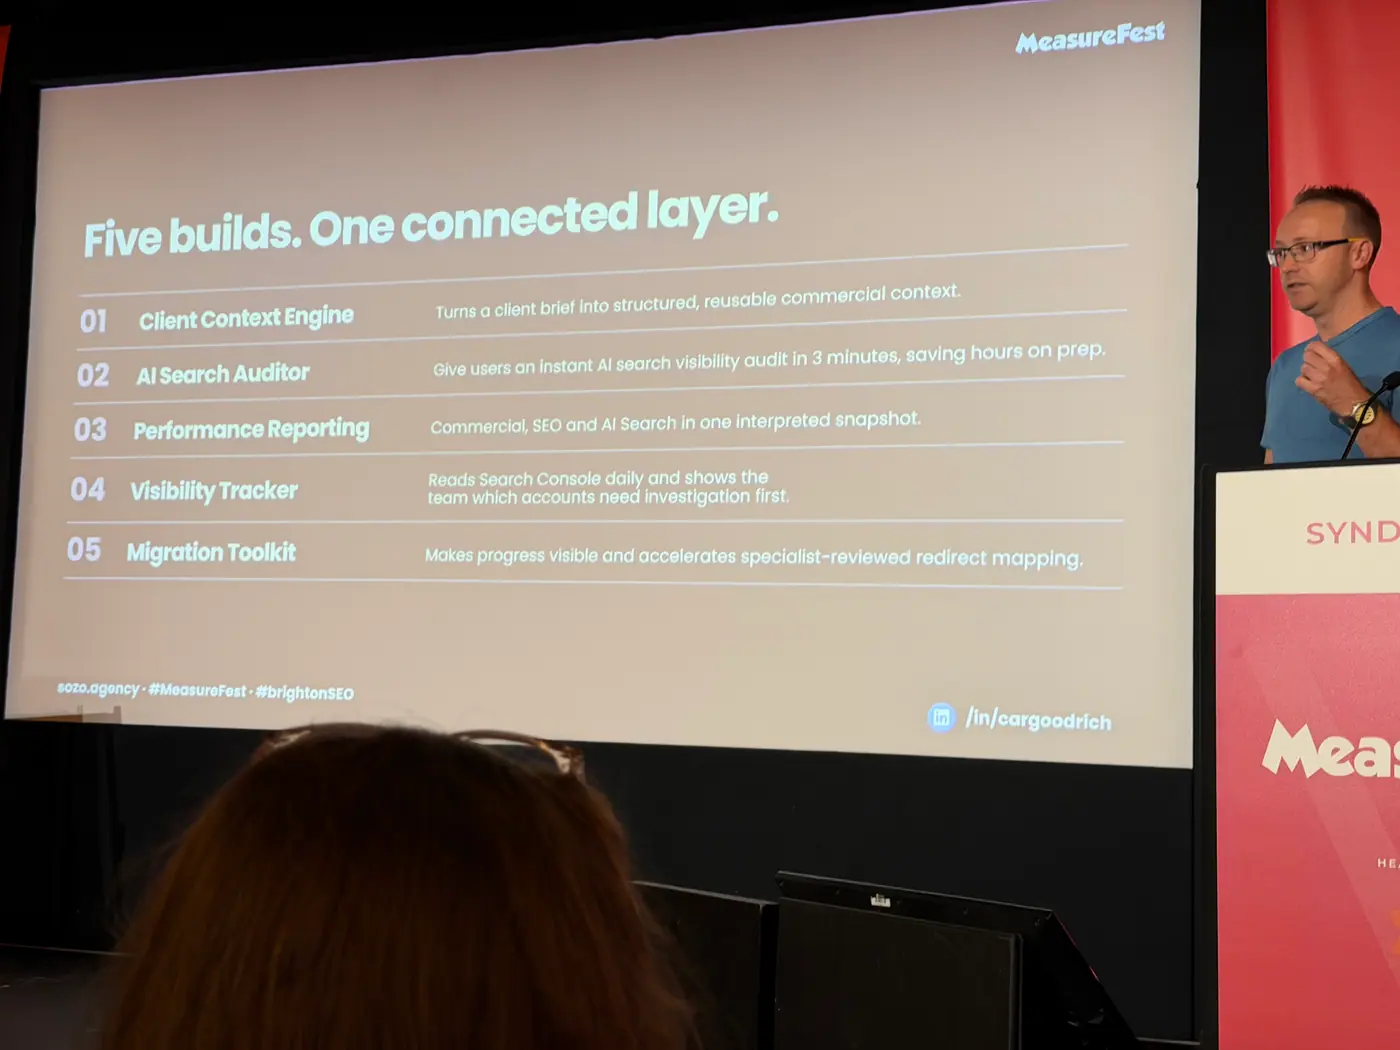
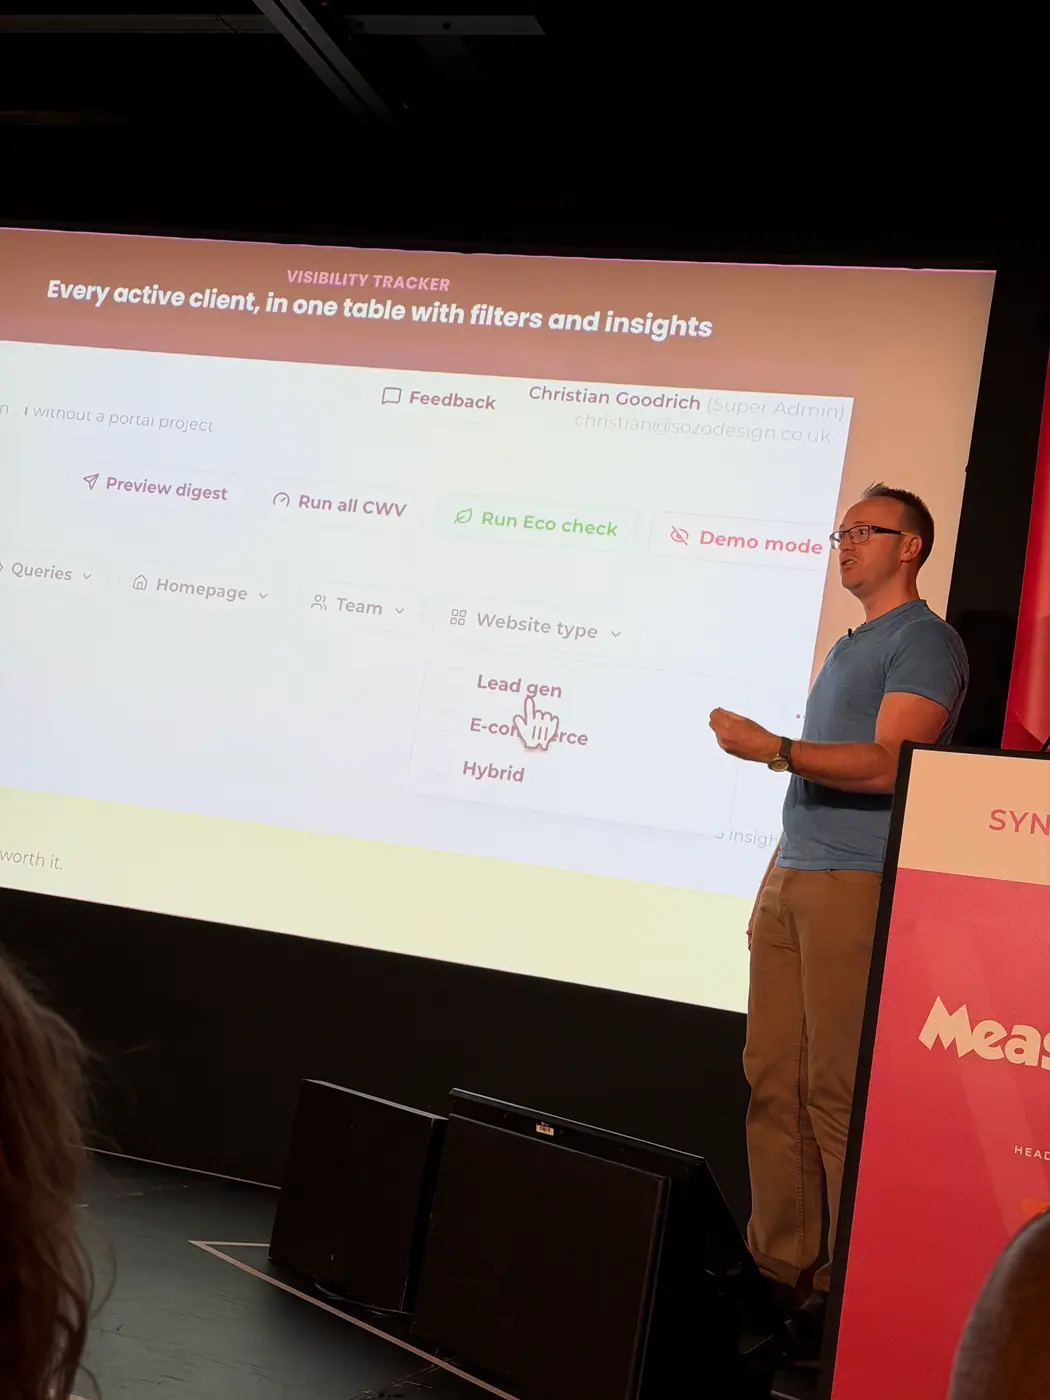
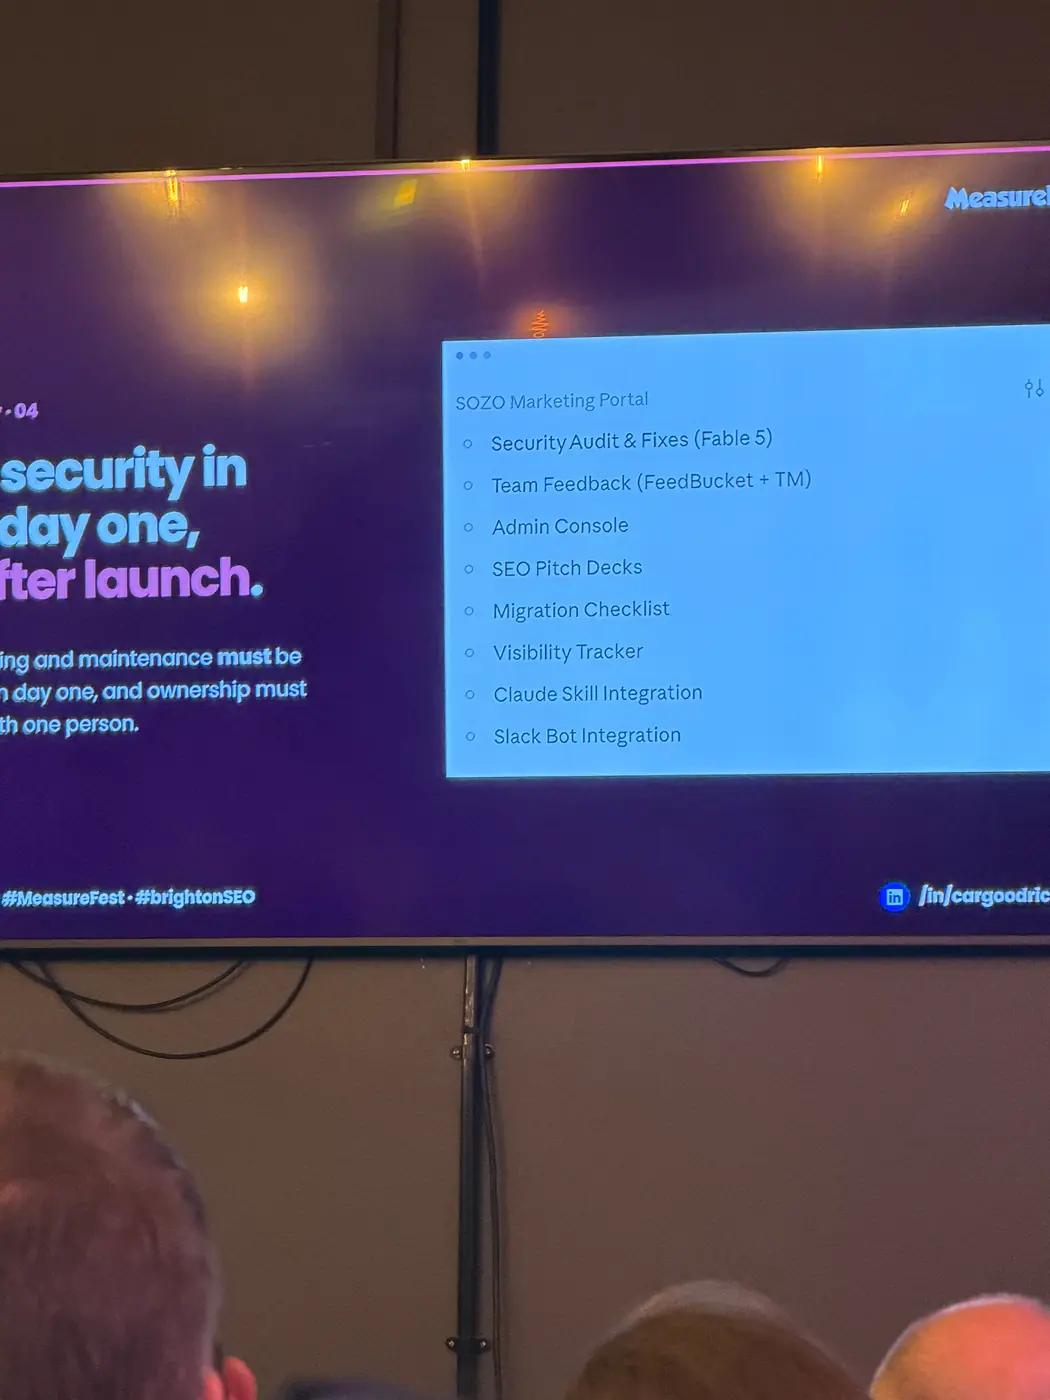
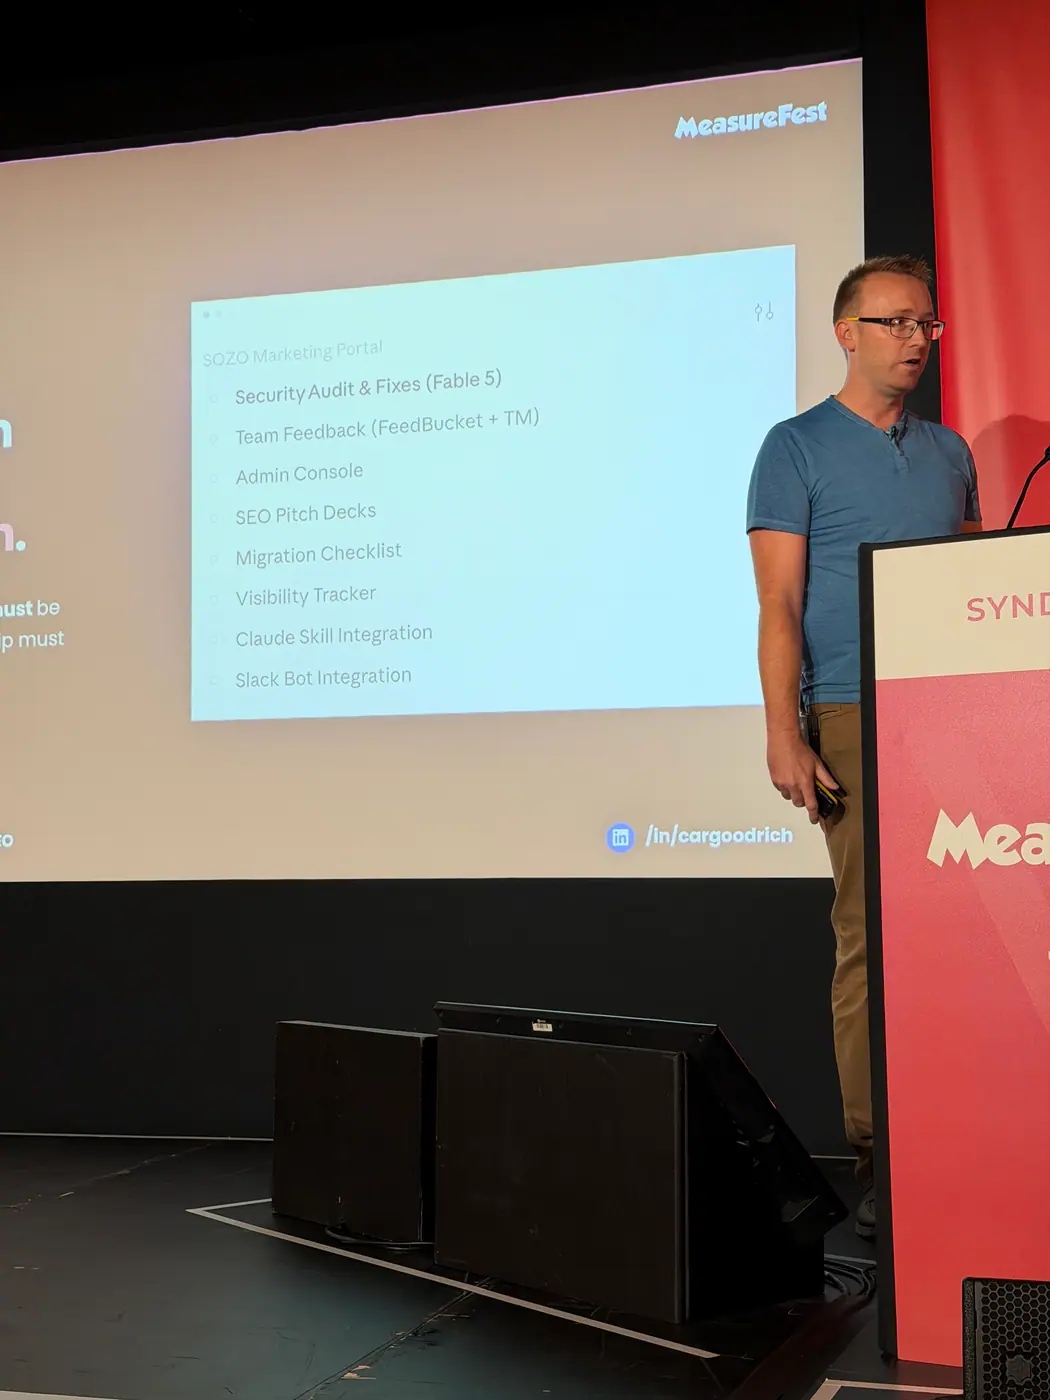
Przedstawił pięć modułów: bazę kontekstu biznesowego klienta, automatyczny audyt widoczności, raportowanie wyników, monitoring oraz narzędzie do zarządzania migracjami.
Głównym celem było ograniczenie ręcznego zbierania danych i przygotowywania materiałów. Zaoszczędzony czas miał służyć interpretacji, konsultacjom i podejmowaniu decyzji, za które nadal odpowiadał specjalista.
Najważniejsze wnioski
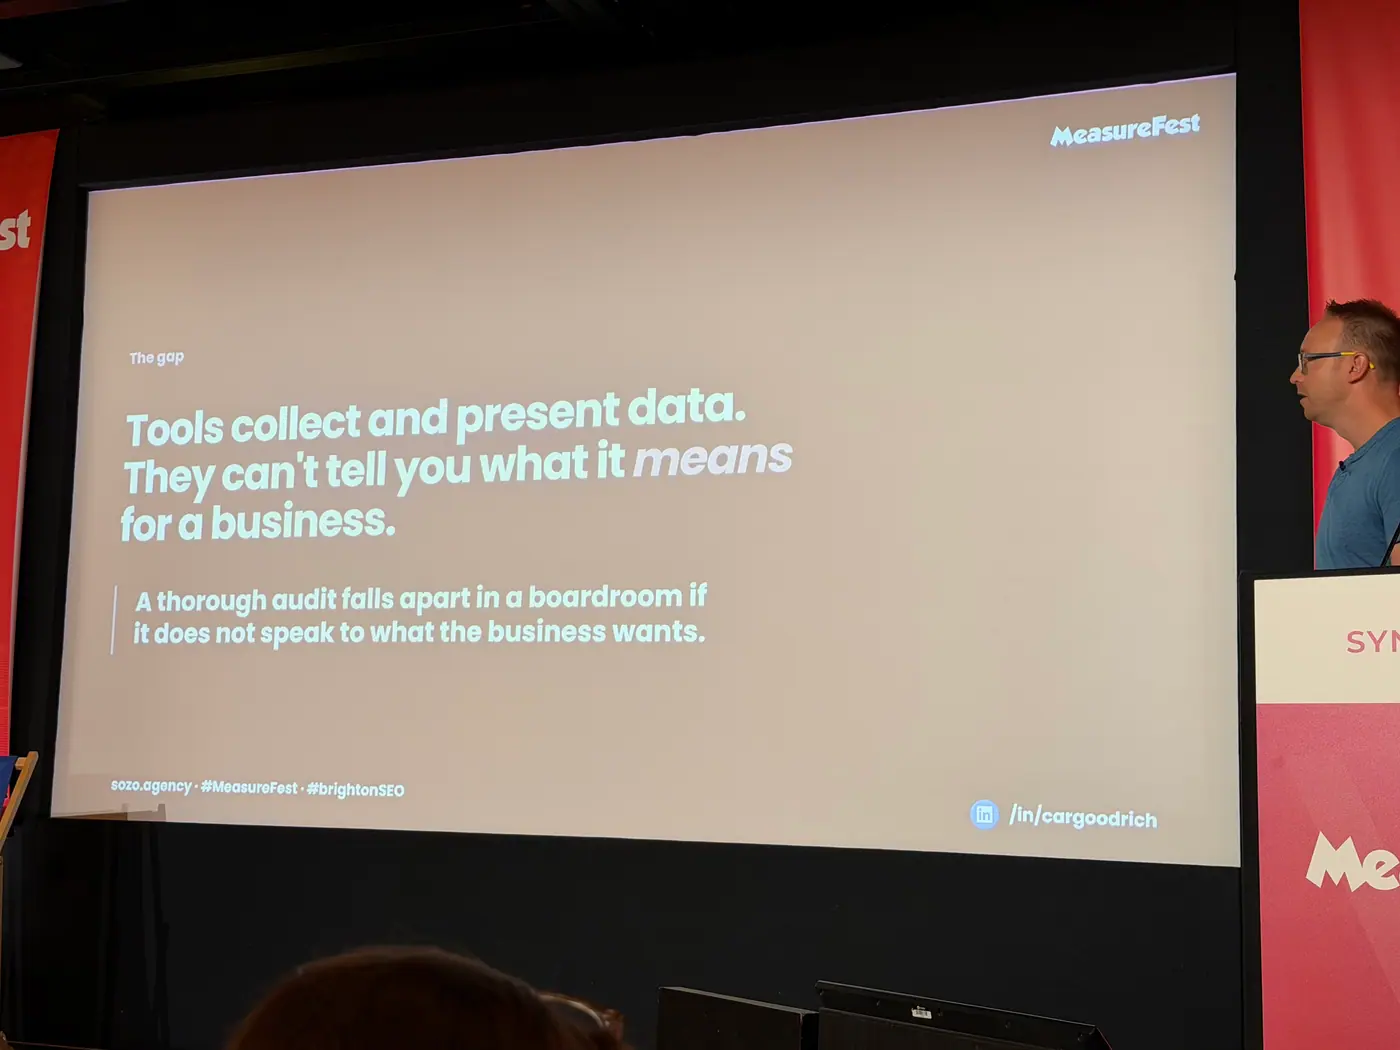
Raport potrzebuje kontekstu biznesowego. W opisanym wdrożeniu portal przechowywał briefy, cele komercyjne, wyróżniki oferty, usługi i wyzwania klienta. Moduł raportowania zestawiał wyniki z tym kontekstem, zamiast prezentować same pozycje i wskaźniki.
Model nie powinien być źródłem danych o widoczności. Audyt korzystał z informacji o stronie oraz zewnętrznych zbiorów danych. Prelegent ostrzegał przed poleganiem na deklaracjach modelu, że potrafi samodzielnie podać pozycje lub przeprowadzić analizę słów kluczowych.
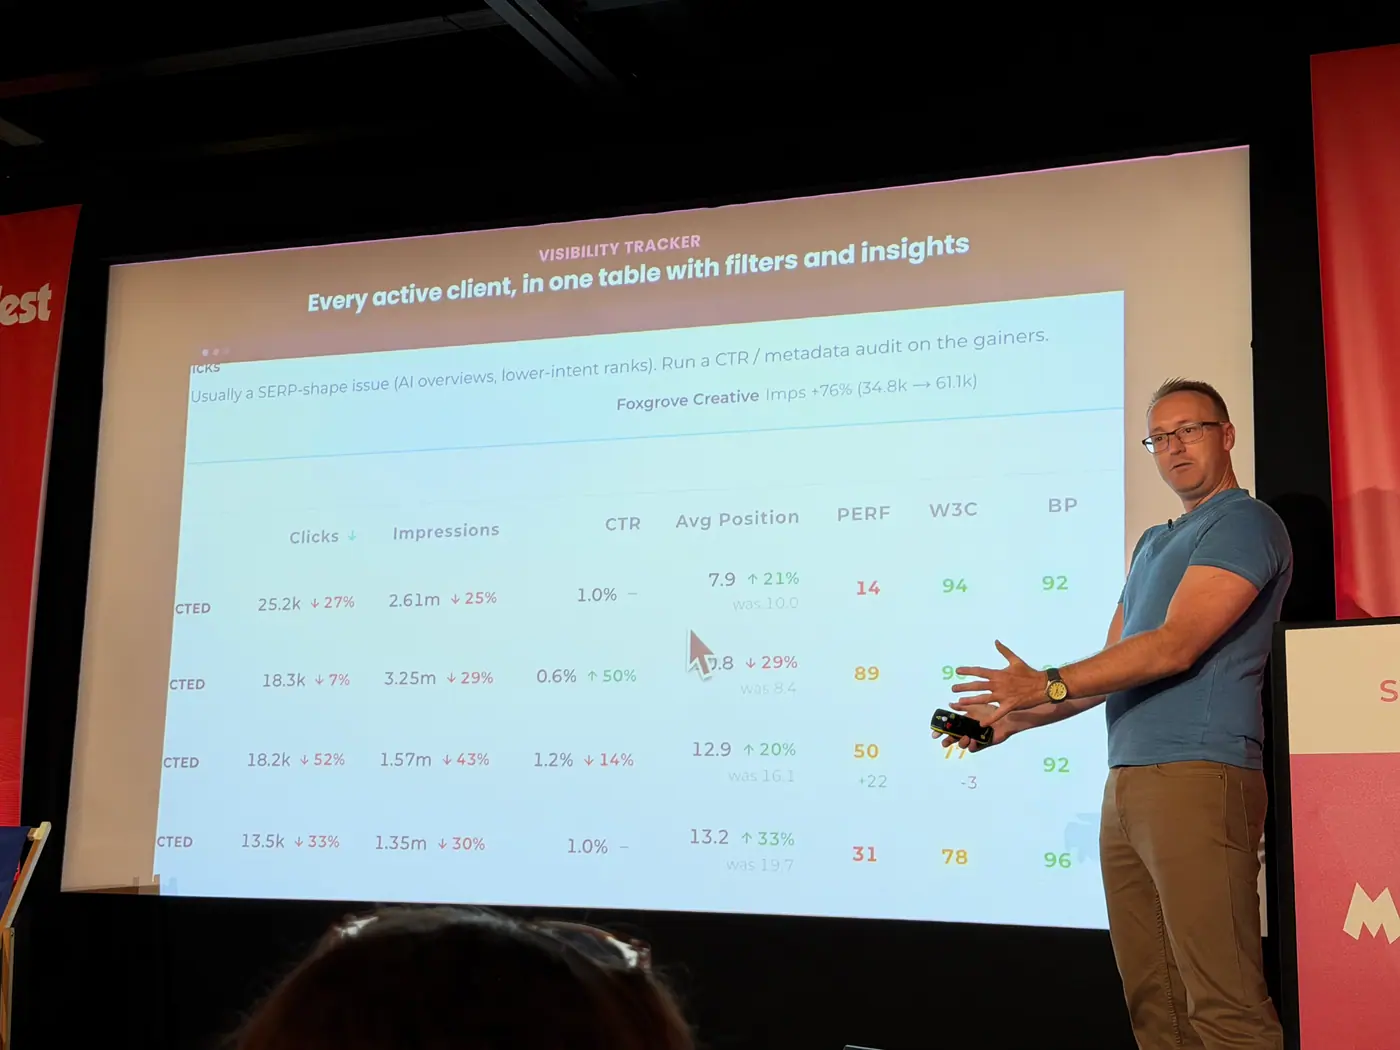
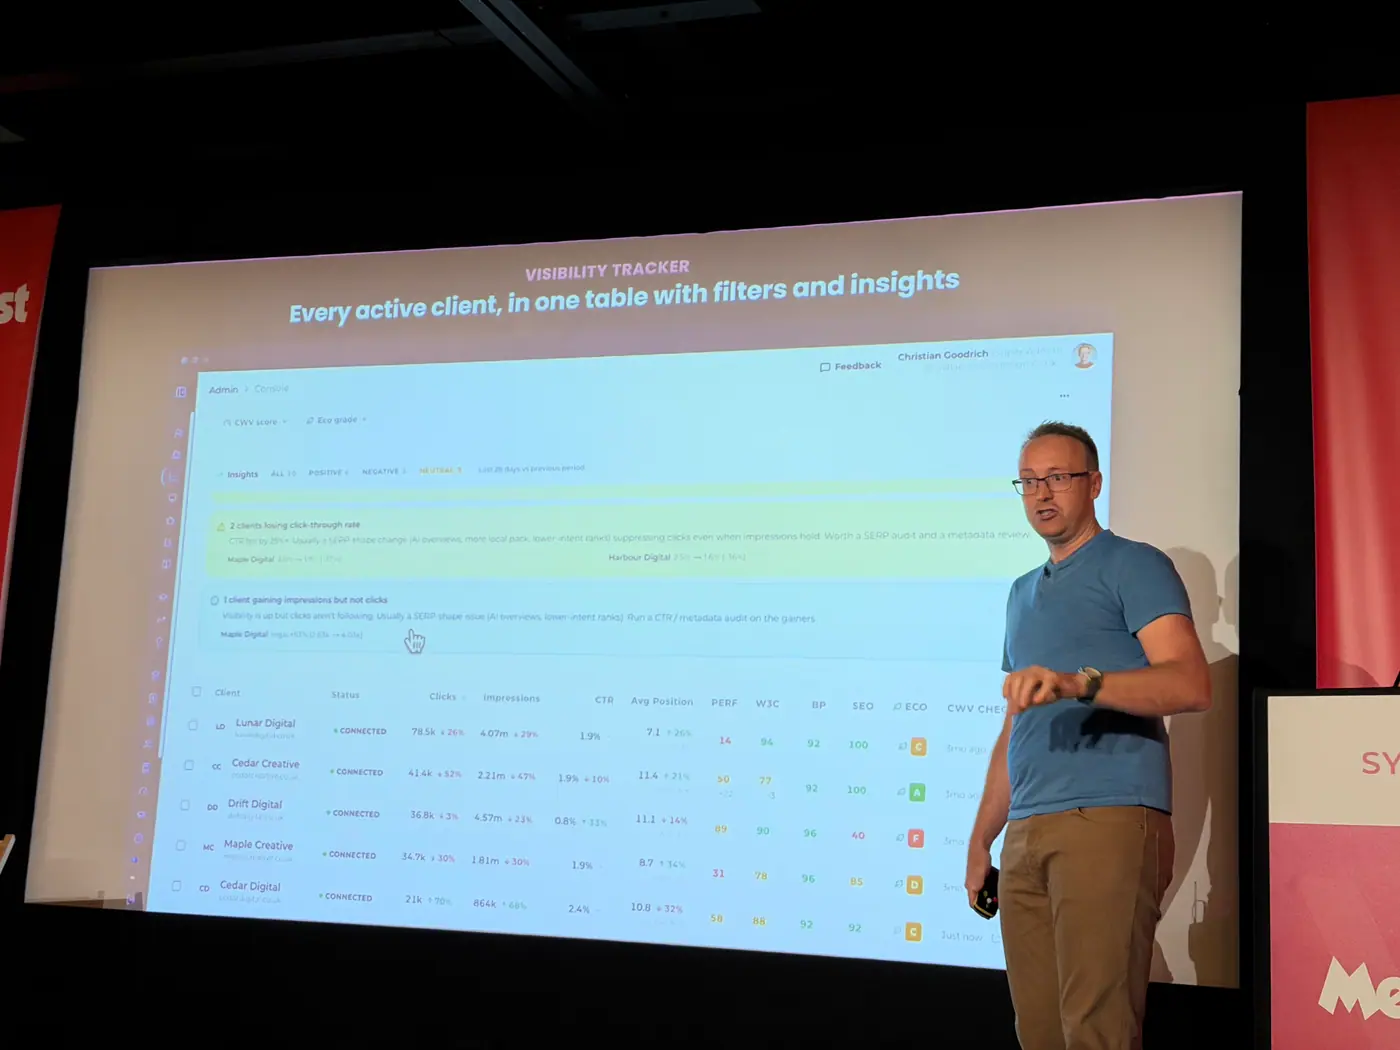
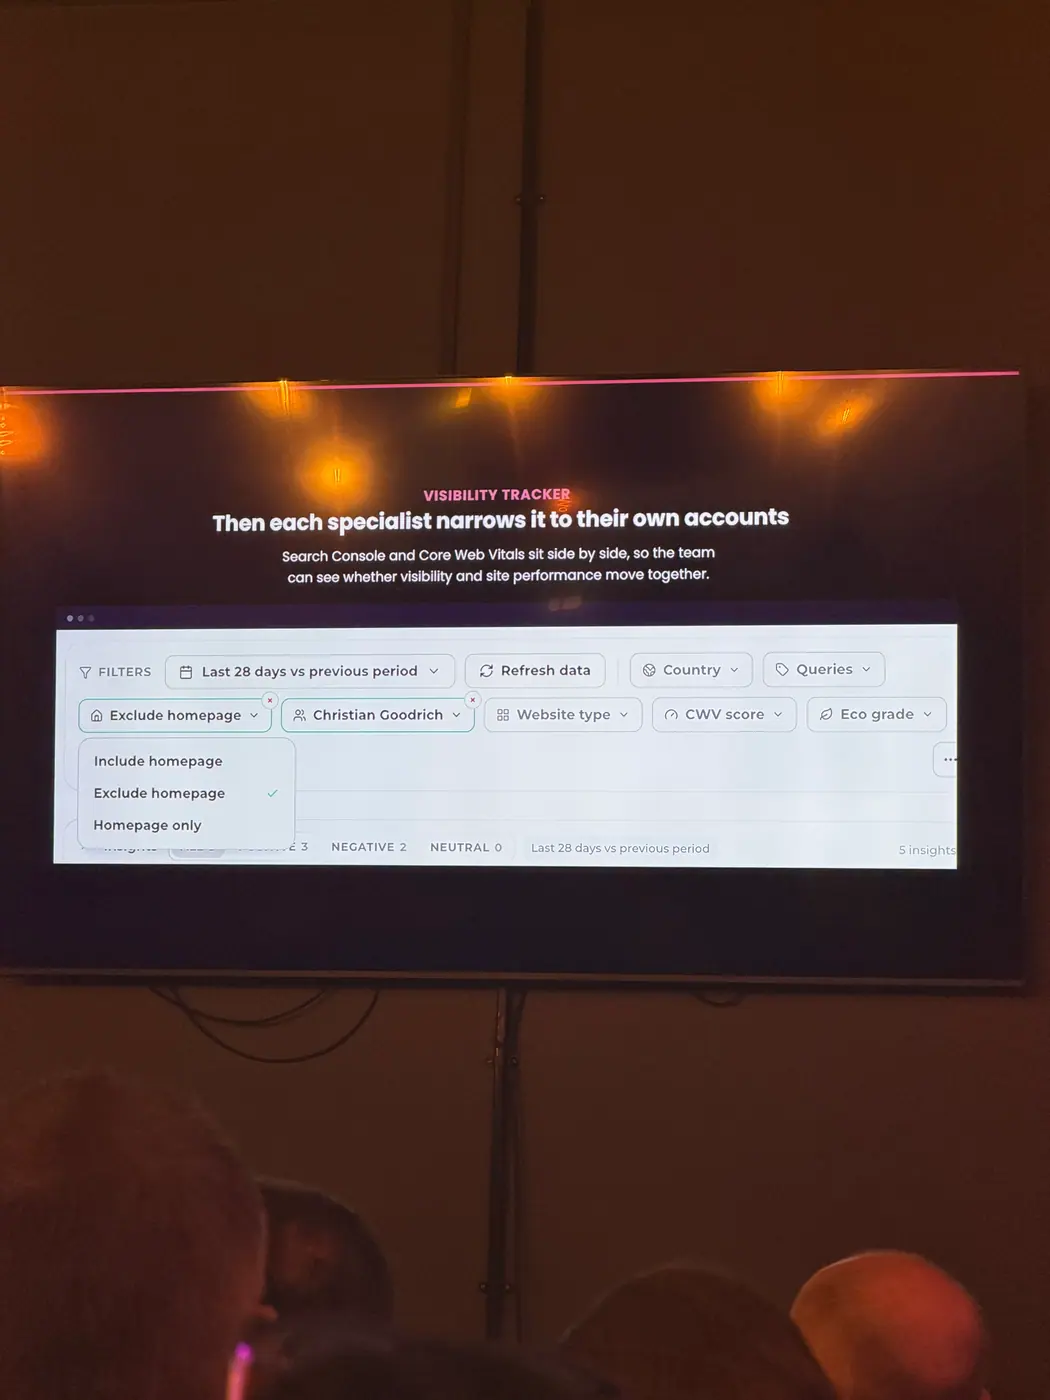
Monitoring miał wskazywać, gdzie zajrzeć najpierw. Goodrich połączył dane Google Search Console z PageSpeed Insights oraz komentarzami generowanymi przez model. Zespół mógł filtrować klientów według typu biznesu, zapytań związanych z marką i przypisanych opiekunów.
Migracja była również procesem komunikacji i odpowiedzialności. Wspólna lista kontrolna obejmowała etapy, priorytety i specjalizacje. Klient otrzymywał link do widoku postępu prac, co miało ograniczać niepewność dotyczącą przygotowań.
Kontekst ważniejszy od dopracowanego promptu to teza prelegenta. Goodrich przekonywał, że znajomość celów klienta zwiększa użyteczność interpretacji. Podkreślił też, że automatyzacja nie zwalnia specjalisty z odpowiedzialności za decyzje.
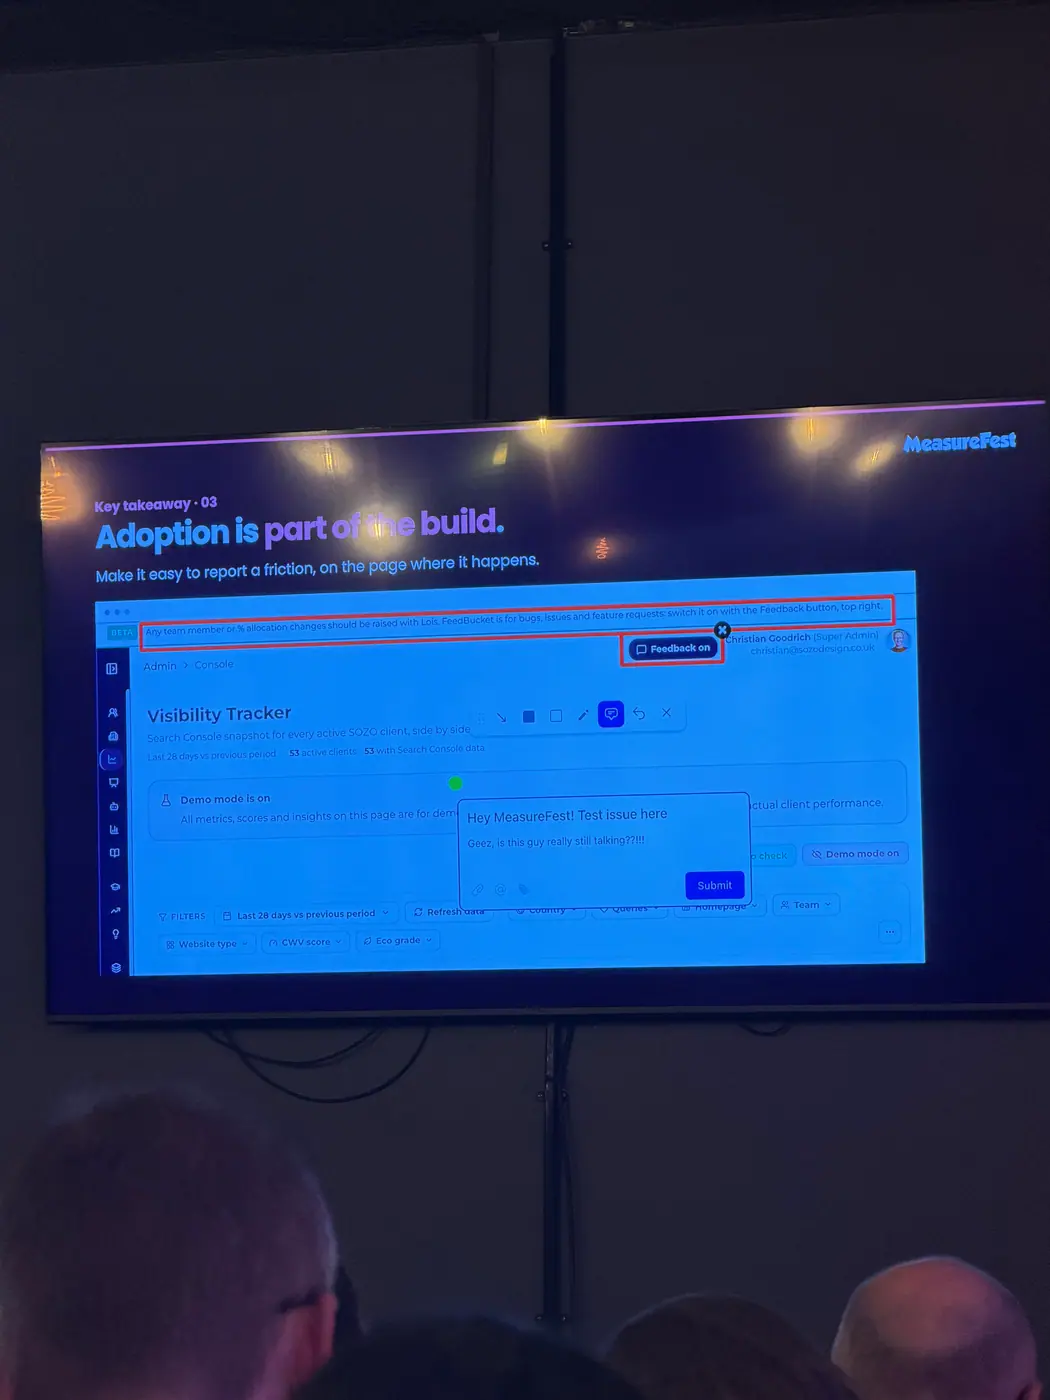
Działająca funkcja nie oznacza zakończonego wdrożenia. Prelegent zalecał uwzględnienie informacji zwrotnej od użytkowników, bezpieczeństwa i kontroli kosztów. Dotyczyło to zarówno narzędzi publicznych, jak i wewnętrznych.
Dane liczbowe i przykłady
| Liczba | Znaczenie w prezentacji |
|---|---|
| Około 9 miesięcy | Okres intensywnej, codziennej pracy z Claude Code, o którym opowiedział Goodrich. |
| 5 modułów | Liczba przedstawionych elementów wewnętrznego portalu. |
| Około 3 minut | Typowy czas utworzenia interaktywnej strony z audytem widoczności, według prelegenta. |
| 3 etapy migracji | Przygotowanie przed uruchomieniem, uruchomienie i działania po uruchomieniu. |
| 59% oraz 32% | Przykładowe statusy prac: wykonanie etapu przed uruchomieniem oraz całości przygotowań migracyjnych. |
Praktyczne rady
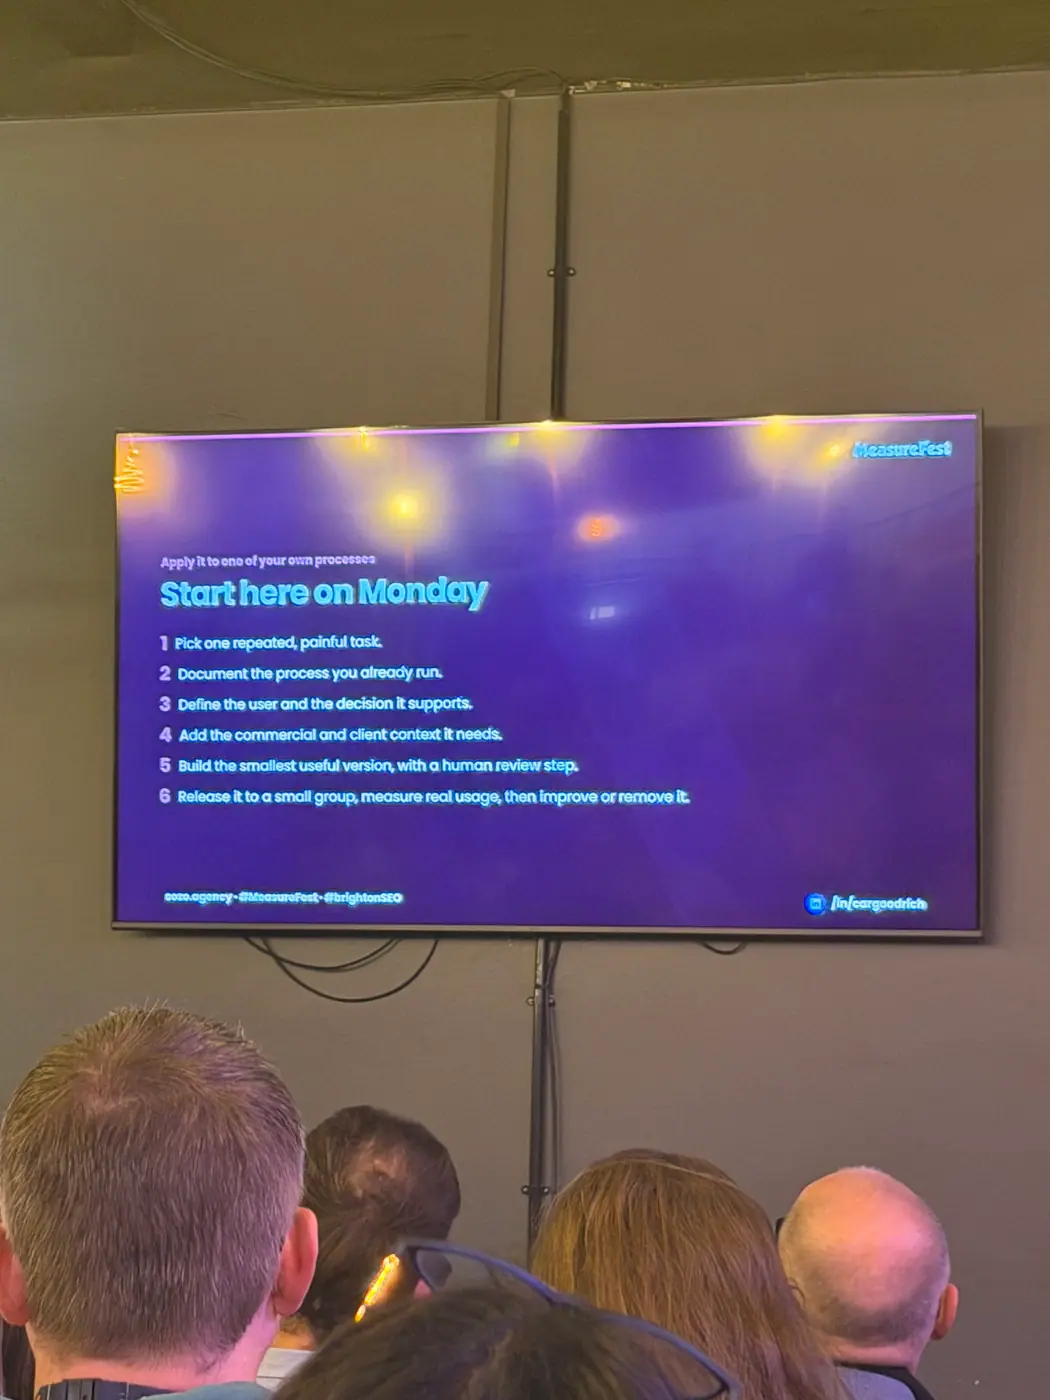
- Zacznij od opóźnionej decyzji, nie od pomysłu na aplikację. Wskaż zadanie, przez które zespół lub klient zbyt długo dochodzi do wniosku, co zrobić dalej.
- Zbierz kontekst klienta przed automatyzacją interpretacji. Brief, cele komercyjne, oferta i wyzwania powinny być dostępne dla systemu raportowego.
- Oddziel dane od komentarza modelu. Informacje o wynikach pobieraj z narzędzi. Model wykorzystuj do ich interpretacji, a decyzję pozostaw specjaliście.
- Projektuj pod rzeczywistą pracę zespołu. Uwzględnij przypisanie klientów, przydatne filtry oraz możliwość zgłaszania błędów i sugestii.
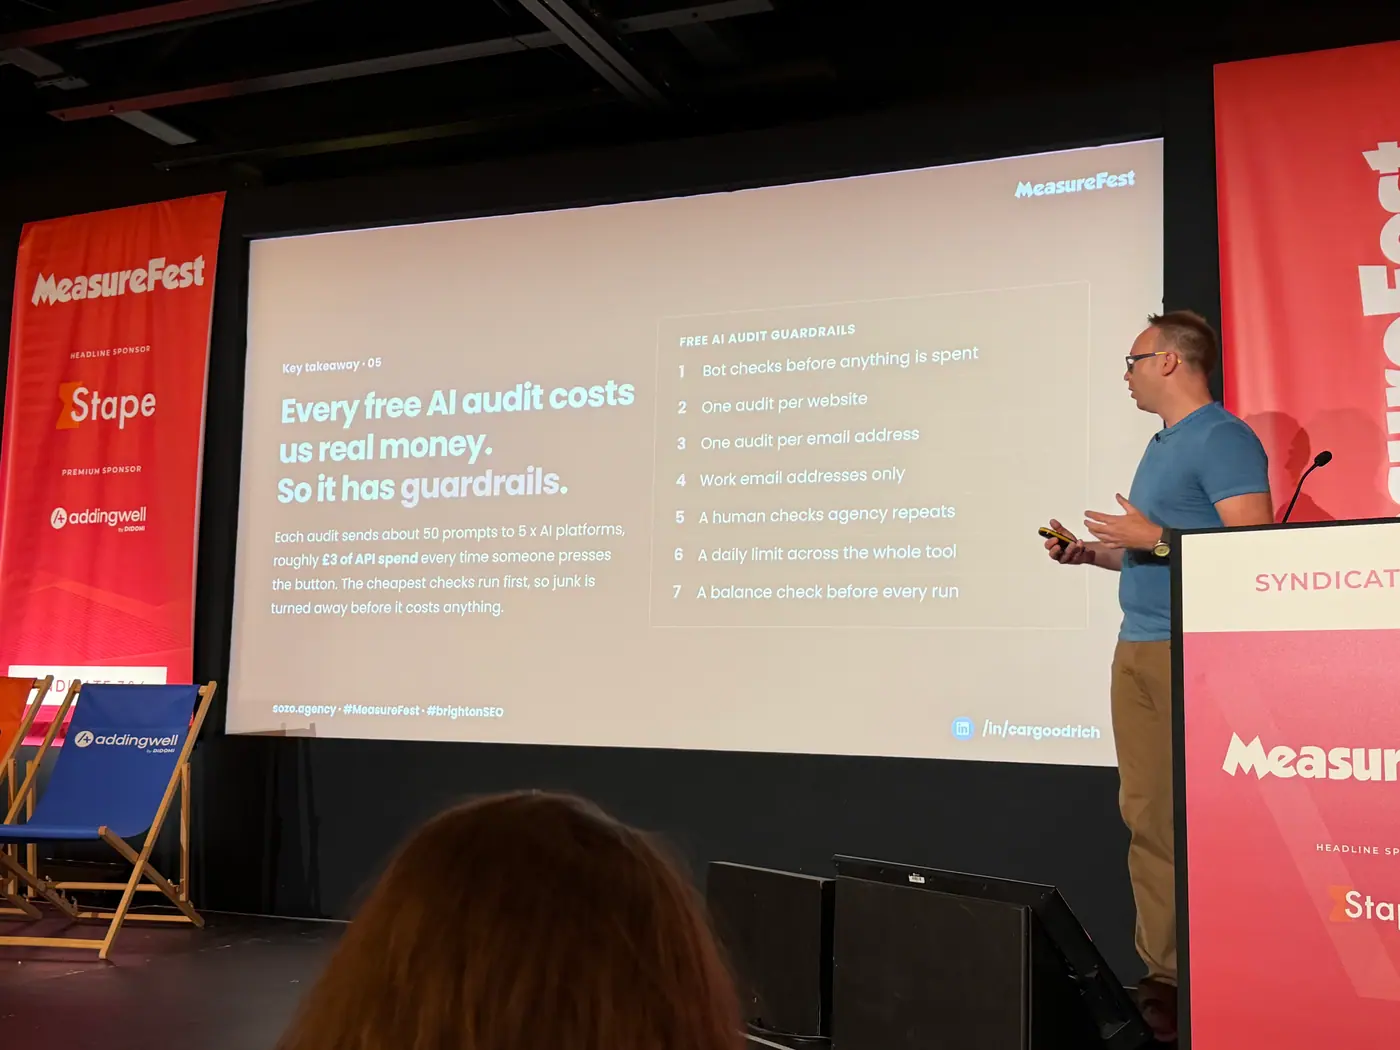
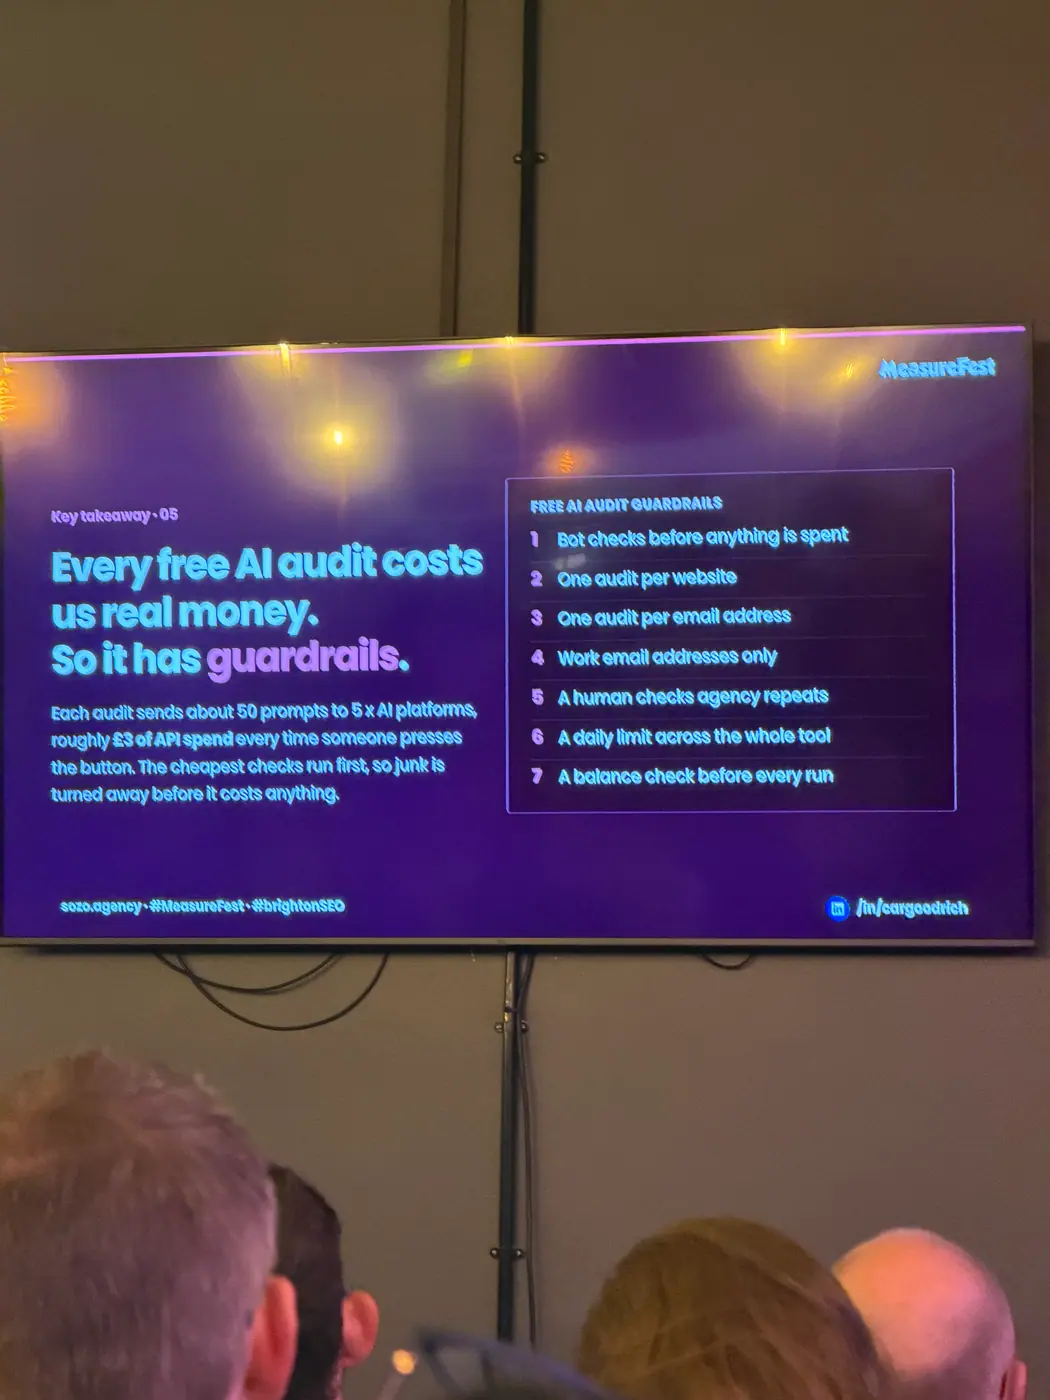
- Przed udostępnieniem narzędzia zaplanuj zabezpieczenia i koszty. Goodrich wskazał m.in. ochronę przed botami oraz limity audytów na dzień lub domenę.
Knowledge bombs
1. Najpierw „silnik kontekstu klienta”, dopiero potem narzędzia AI – kontekst bije sprytne prompty.
Fundamentem portalu jest moduł, do którego wrzuca się brief klienta, instrukcje projektów AI, cele biznesowe, USP i wyzwania; wszystkie pozostałe moduły (raporty, audyty, insighty) się do niego odwołują. Bez tego AI zgaduje i „mówi to, co chcesz usłyszeć”.
„Context matters more than clever prompting. So you can be a real architect with all of your promptings, but if you don’t have the relevant context and the relevant insight from your client, you’re at risk of hallucinations.”
2. LLM najchętniej halucynuje dokładnie tam, gdzie SEO-wcy najchętniej go używają: keyword research i pozycje.
Goodrich zwraca uwagę, że AI „twierdzi”, że zrobi research fraz i poda pozycje na prompty – i to jest strefa największego ryzyka. Dlatego ich audytor nie pyta modelu o dane, tylko podpina prawdziwe źródła (Writesonic, SE Ranking, Search Console, GA) i dopiero na nich buduje wnioski.
„If you query AI, it will claim that it can do keyword research for you. It will claim that it can give you keyword rankings or positions on prompts. But that is where hallucinations are most likely to occur.”
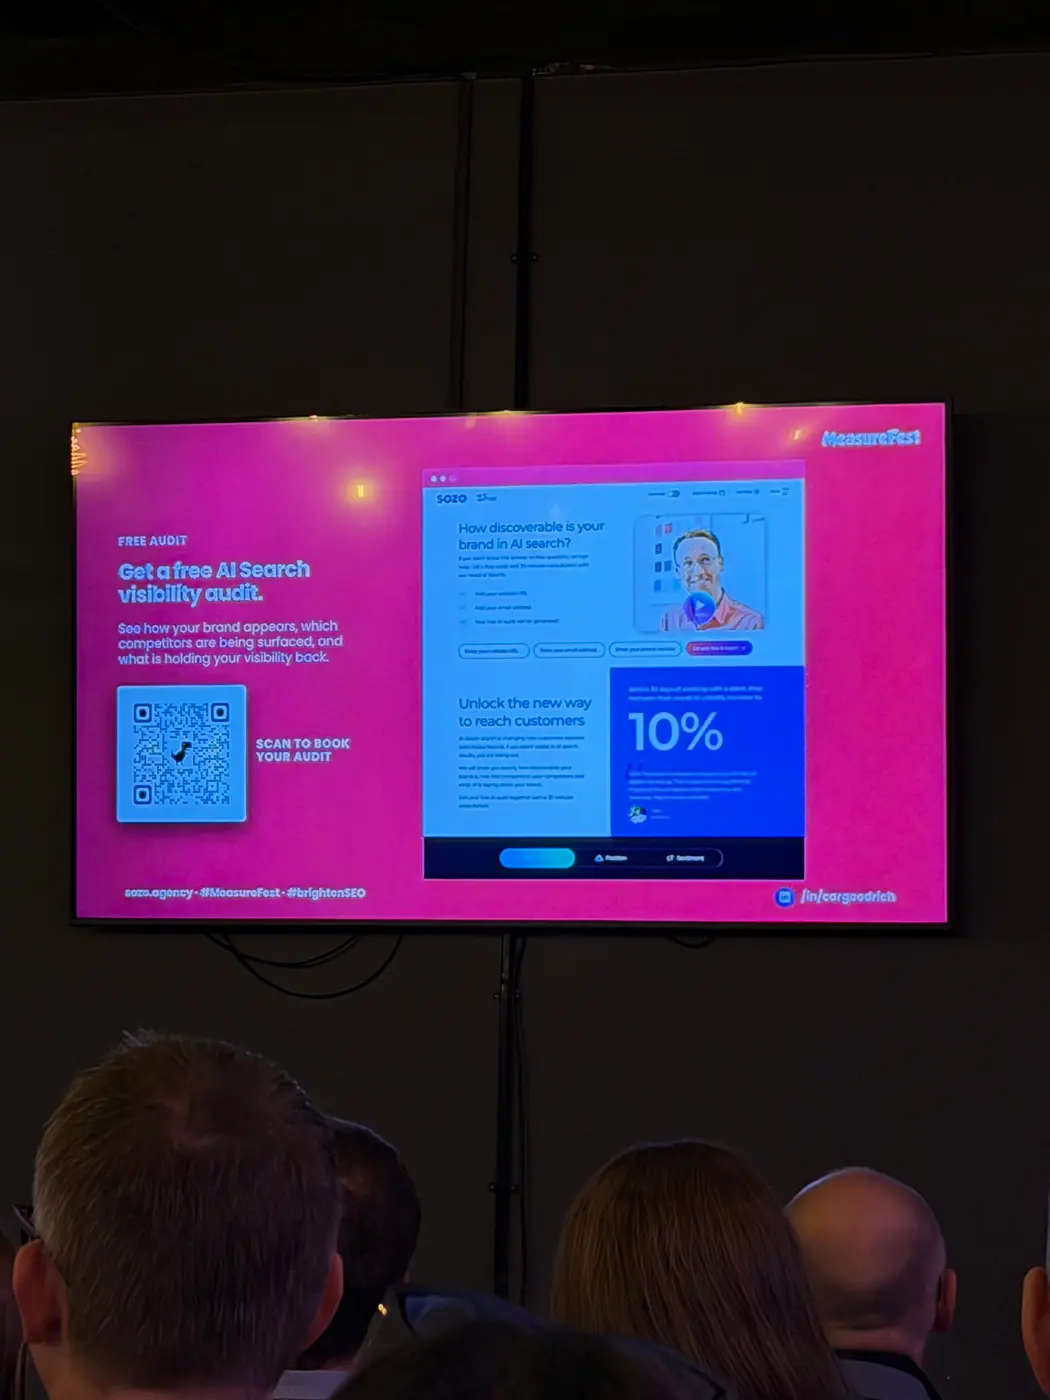
3. Darmowy audyt widoczności w AI jako lead magnet – strona wynikowa generowana w ~3 minuty.
Prospekt wypełnia formularz z URL-em, system analizuje markę i stronę, robi lookupy na odpowiednich promptach w podpiętych zbiorach danych i generuje interaktywny landing z wynikami – bez ręcznego składania decków.
„Through Cloud Code, we’re able to build this interactive landing page for a client that typically just gets built within three minutes, purely off the back of all of that different stuff and data sets.”
4. Publiczne narzędzie AI to realny koszt – wbuduj limity, zanim boty zjedzą budżet.
Każdy darmowy audyt kosztuje agencję pieniądze (tokeny, API). Ich zabezpieczenia: limit audytów dziennie lub na domenę oraz blokada zgłoszeń z adresów Gmail/Hotmail, gdy narzędzie ma służyć pozyskiwaniu firmowych leadów.
„Do we put a limit on the amount of audits per day or per website? Or do we exclude Gmail or Hotmail accounts from requesting it if this is for potential prospects?”
5. Tracker na API Search Console + PageSpeed z insightami z Gemini Flash 2.5, filtrowany po typie klienta i opiekunie.
Dane z GSC (anonimizowane) łączone z PageSpeed Insights, filtry: e-commerce vs lead gen, brand vs non-brand, z/bez strony głównej, a także po osobie przypisanej do klienta. Model komentuje dane na bieżąco i wyłapuje np. klientów z rosnącymi wyświetleniami bez wzrostu kliknięć albo spadkiem CTR na brandzie przez reklamy.
„Has their click-through rate changed because there’s more PPCs showing up for branded search?”
6. Do security i audytu kodu – najmocniejszy model, nawet jeśli spala więcej tokenów.
Goodrich przełącza się między Opusem a Fable; Fable zużywa więcej tokenów, ale używa go do wszystkiego, co dotyczy bezpieczeństwa, audytu i poprawek przed wystawieniem narzędzia publicznie. Osobne sesje Claude Code na poszczególne funkcje portalu.
„For me, I use Fable for anything that is security, audit, fix related. I’m not going to trust something as important as security for shipping something live on an inferior model.”
7. Checklista migracji z linkiem dla klienta – postęp w procentach zamiast maili „jak idzie migracja?”.
Trzy etapy (pre-launch, launch, post-launch), priorytety, podział na specjalizacje (SEO, PPC itd.) i link do udostępnienia klientowi, w którym widzi np. „59% pre-launchu za nami”. Przy okazji: włącz do narzędzia mechanizm zbierania feedbacku od zespołu, bo adopcja jest częścią budowy.
„We also built a shared version here with a share link that then you can give to the client, improves transparency and accountability.”
Zdjęcia: Christian Goodrich
24 kadrów · Fot. Robert Nowaczyk
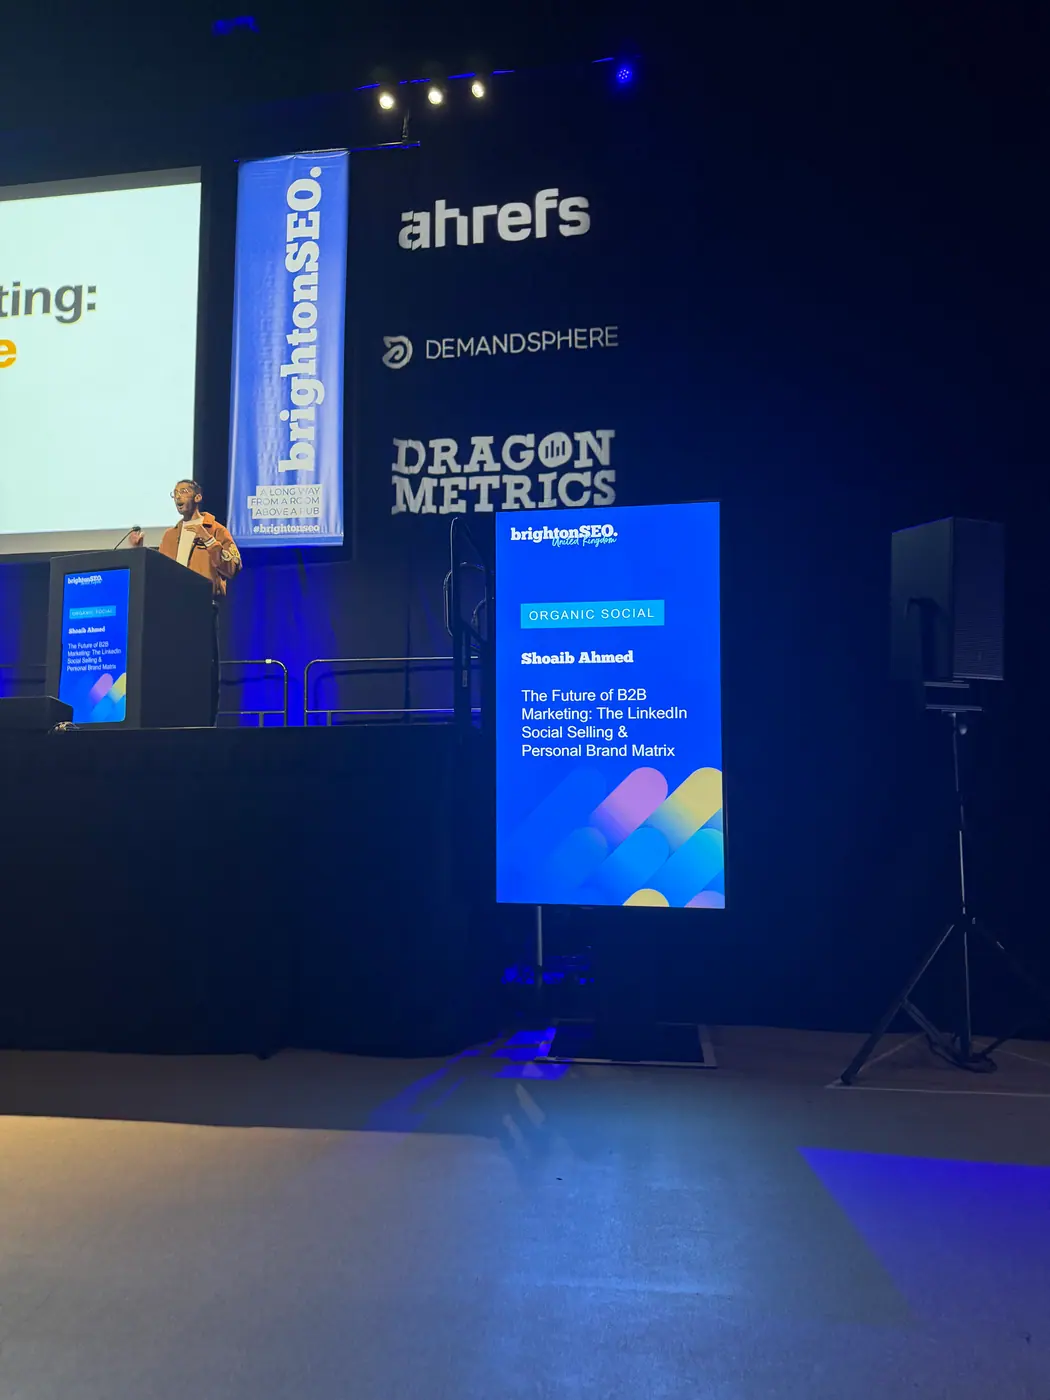
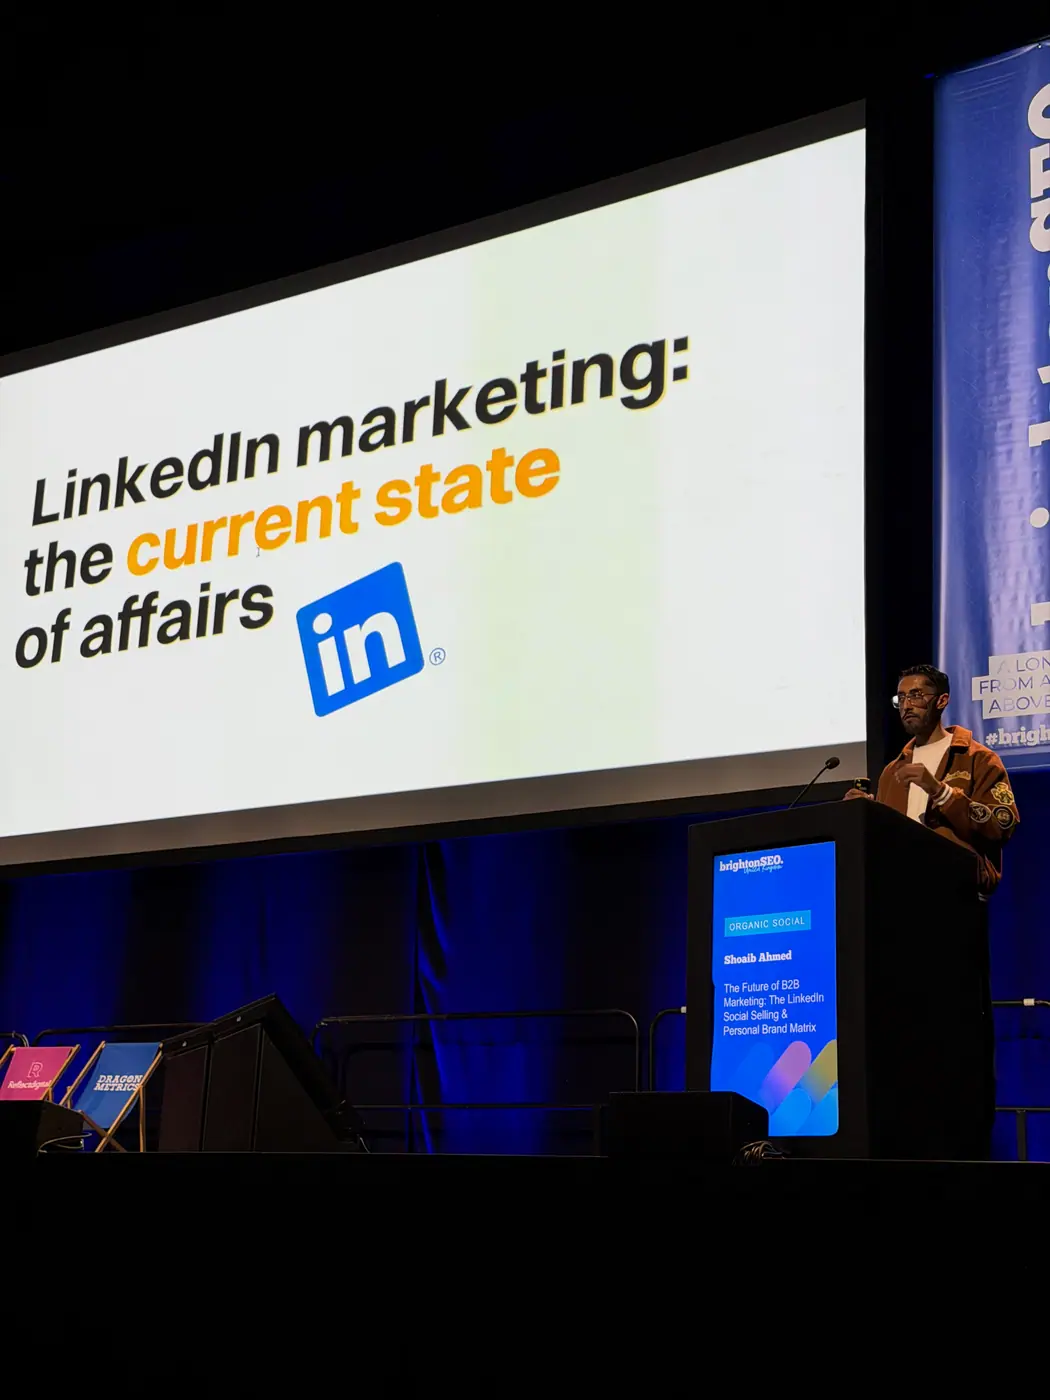
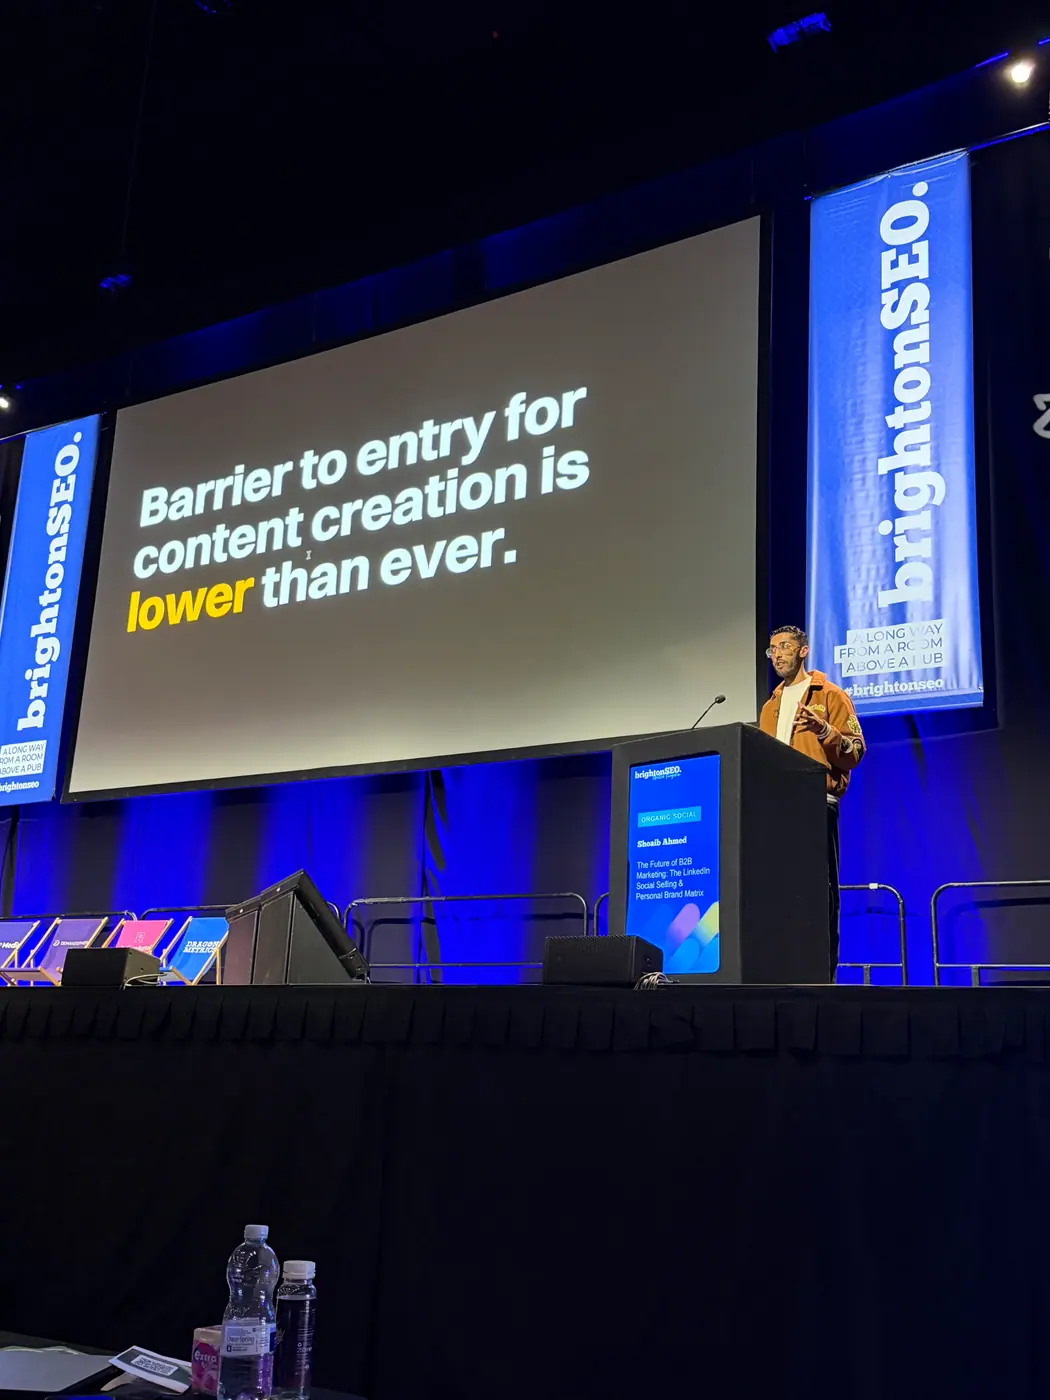
Shoaib Ahmed: The Future of B2B Marketing: The LinkedIn Social Selling & Personal Brand Matrix
11:40 · Auditorium 1
Streszczenie
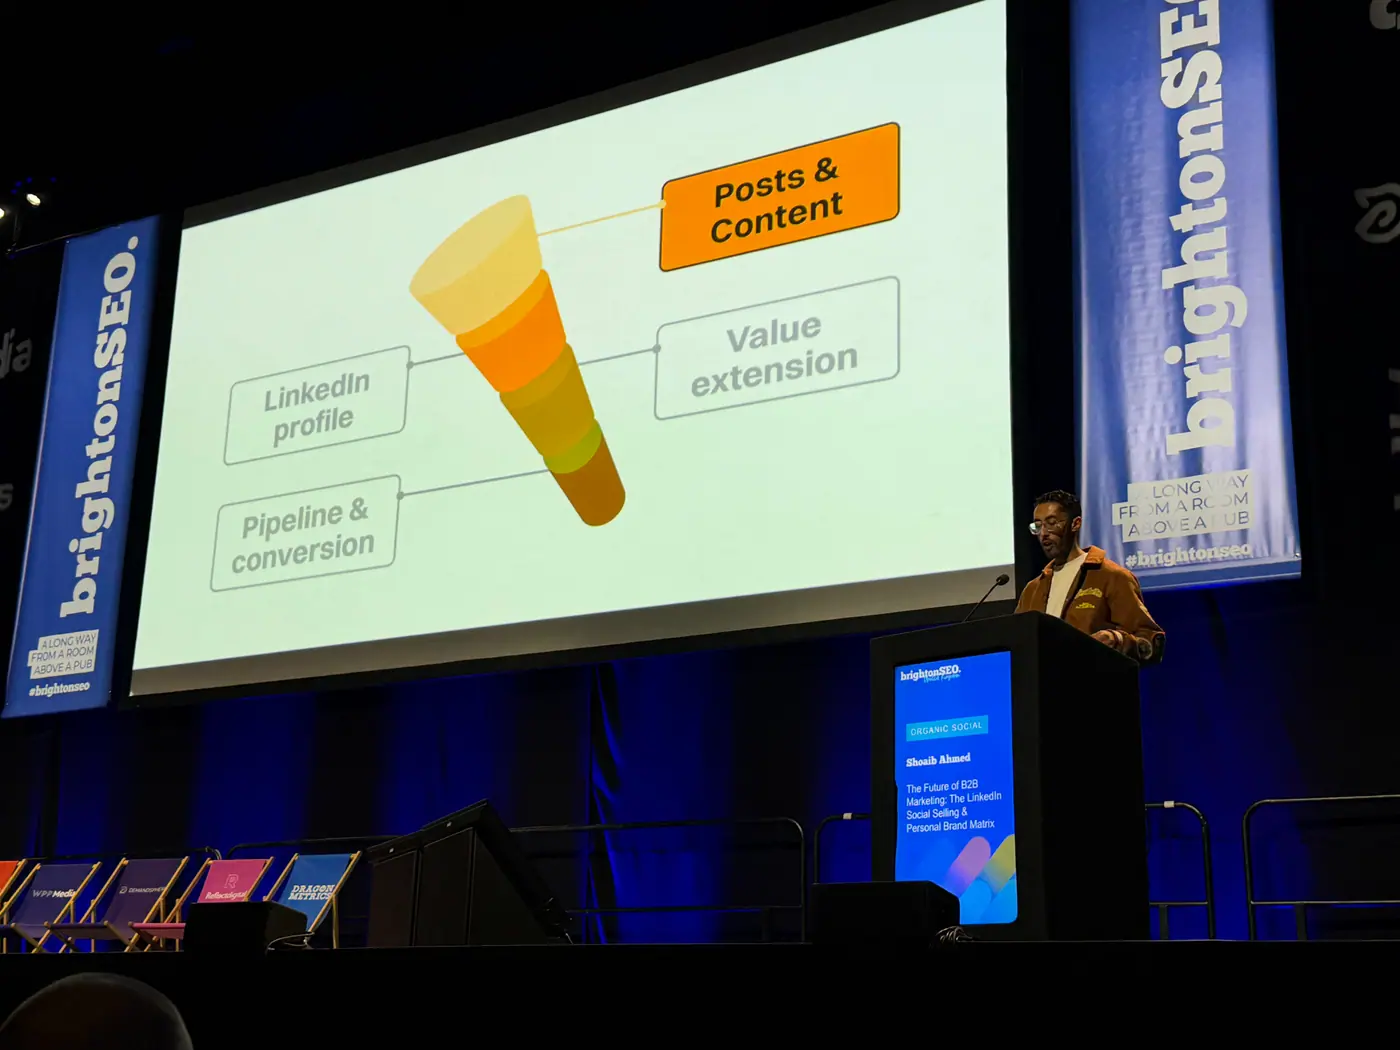
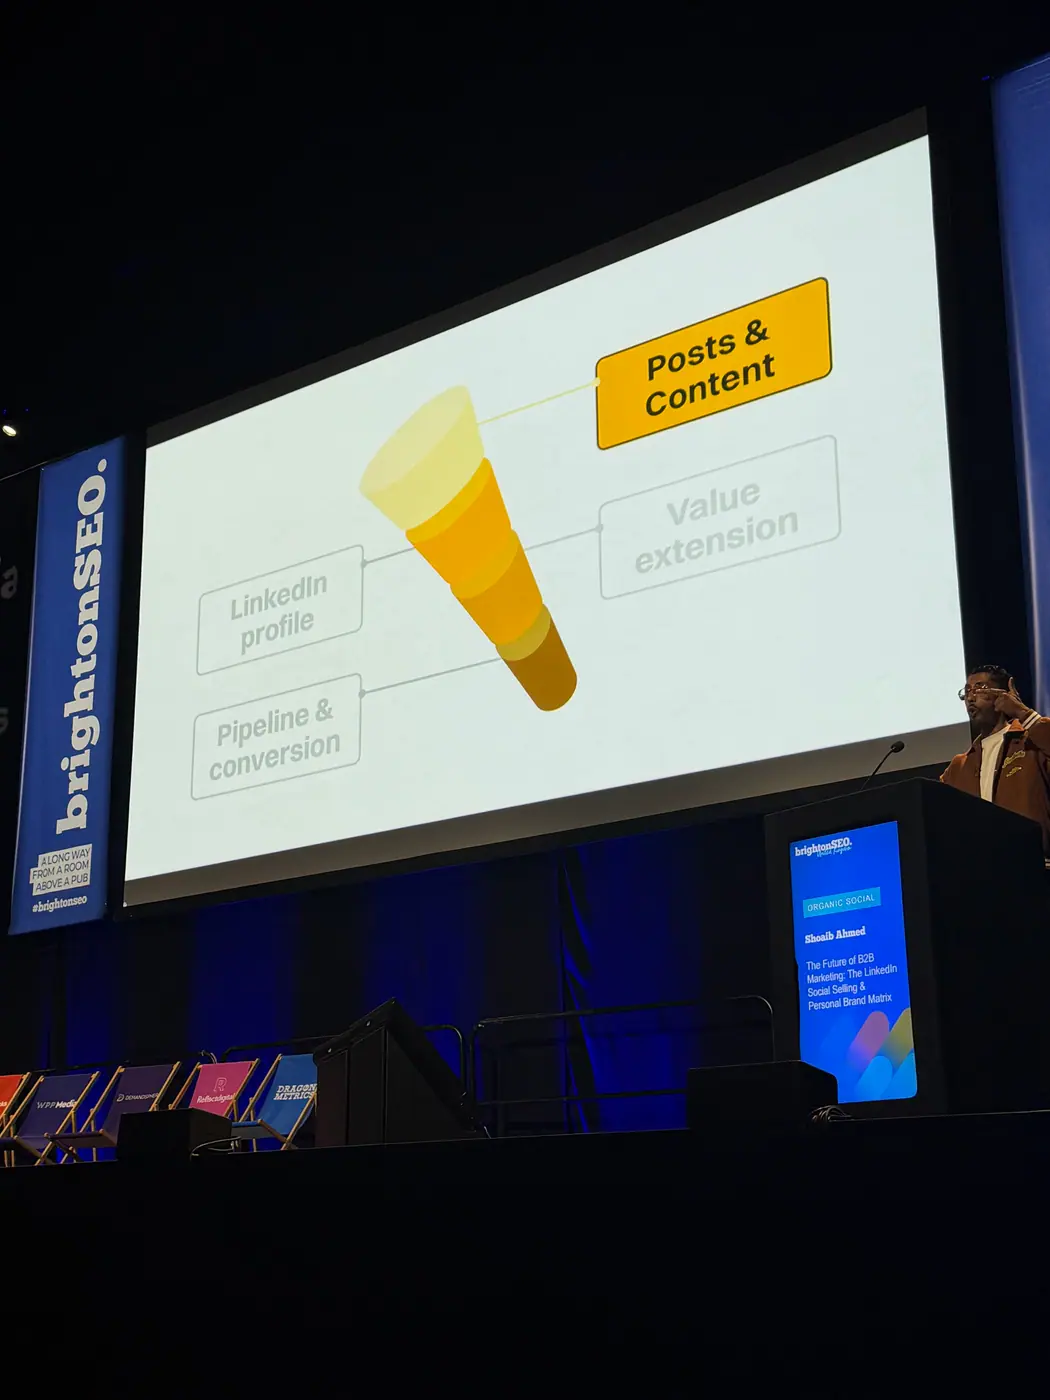
Podczas brightonSEO Shoaib Ahmed przedstawił model wykorzystania LinkedIn w marketingu B2B (Business-to-Business / relacje między firmami): treści → profil → rozwijanie relacji poza platformą → rozmowy sprzedażowe.
Przekonywał, że samo publikowanie nie wystarcza. Treści powinny budować rozpoznawalność, profil wyjaśniać ofertę i potwierdzać kompetencje, a aktywność odbiorców pomagać w rozpoczynaniu rozmów. Pokazał również, jak osobiste historie, dokumentowanie pracy i komentarze branżowe mogą wyróżniać eksperta na tle generycznych publikacji.
Najważniejsze wnioski
- Model zaproponowany przez prelegenta: post był początkiem ścieżki, a nie jej końcem. Profil, materiały do pobrania, lista mailingowa i kontakt z zainteresowanymi odbiorcami miały łączyć widoczność z szansami sprzedażowymi.
- Rekomendacja dotycząca profilu: powinien odpowiadać na trzy pytania: co robisz, komu pomagasz i dlaczego warto Ci zaufać. Ważne były rezultaty, proces współpracy oraz dowody kompetencji, nie samo stanowisko.
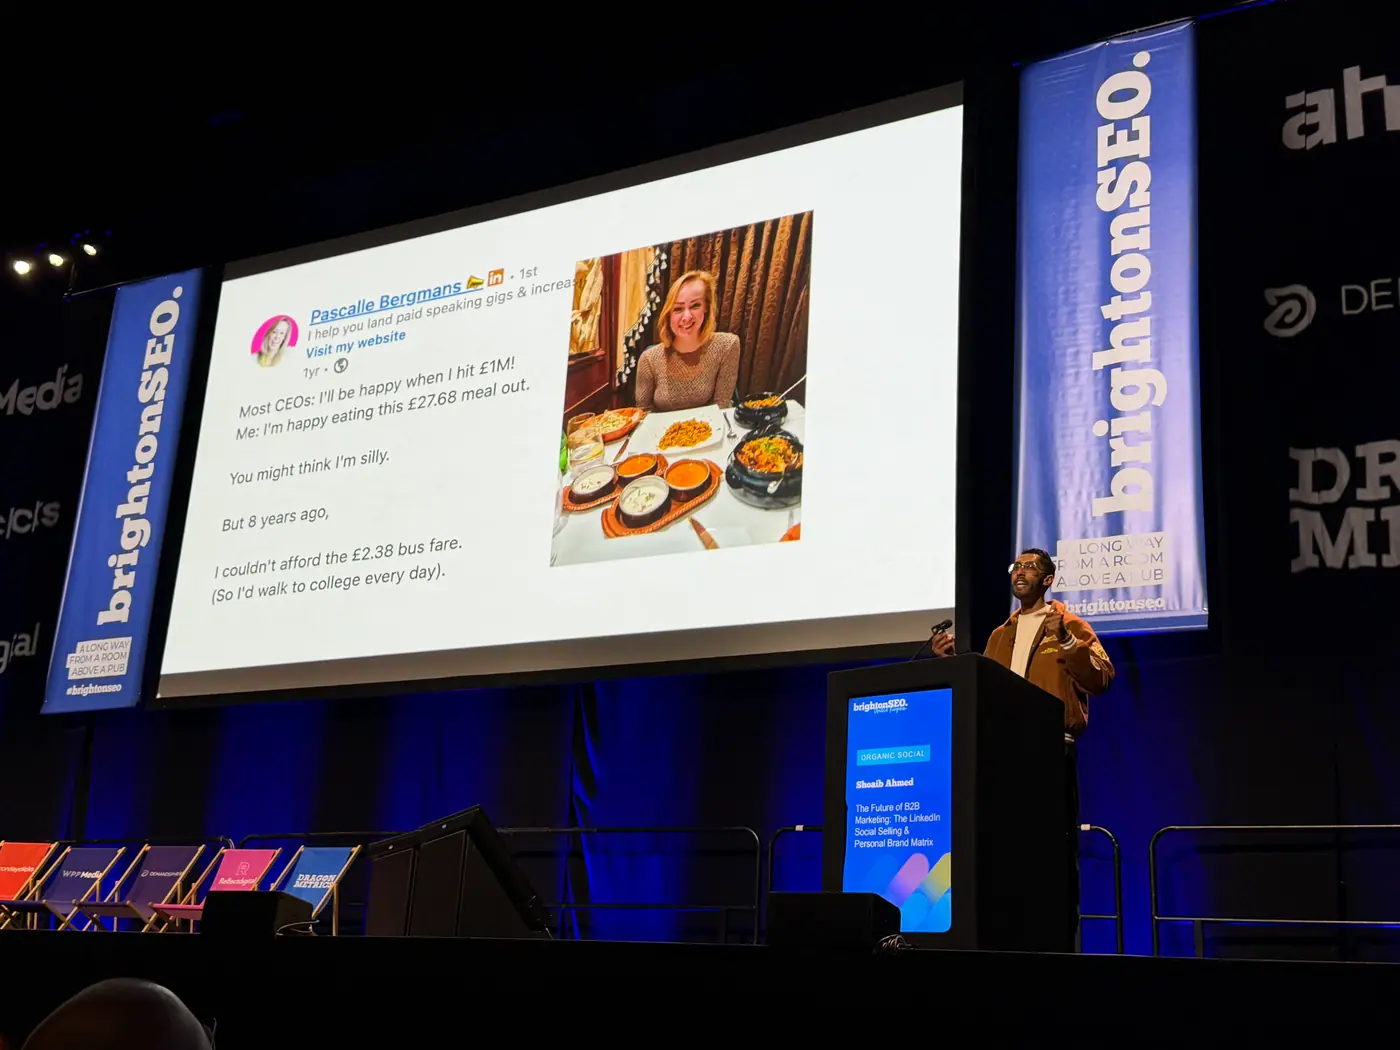
- Rekomendacja dotycząca treści: warto łączyć osobiste historie i punkt widzenia, publiczne dokumentowanie pracy oraz komentarze branżowe. Każdy z tych formatów pełnił inną funkcję w budowaniu marki.
- Opinia Ahmeda: upowszechnienie treści generowanych przez sztuczną inteligencję zwiększyło znaczenie własnych doświadczeń i charakterystycznego sposobu myślenia. Przedstawione oceny poziomu zaufania czy zmęczenia reklamą były jego diagnozą rynku.
- Prognoza prelegenta: marki osobiste, treści organiczne i sprzedaż oparta na relacjach miały zyskiwać na znaczeniu w B2B. Ahmed przewidywał także wzrost znaczenia wideo jako formatu budującego zaufanie.
Dane liczbowe i przykłady
Poniższe wyniki pochodziły z przykładów i doświadczeń przytoczonych przez prelegenta.
| Liczba | Kontekst |
|---|---|
| Około 500 wyświetleń posta | Średni wynik pierwszego opisanego przedsiębiorcy przed rozwinięciem marki, mimo codziennego publikowania. |
| 32 mln organicznych wyświetleń | Wynik postów tego przedsiębiorcy po rozpoczęciu opisanych działań. |
| 37 zaproszeń do podcastów | Dodatkowy rezultat budowania jego rozpoznawalności. |
| 8% rocznego przychodu powtarzalnego | Udział, który Ahmed przypisał LinkedInowi w przypadku startupu tego przedsiębiorcy. |
| 10 mln organicznych wyświetleń w sześć miesięcy | Wynik drugiego przedstawionego przypadku rozwijania marki osobistej. |
| 50% własnych występów w podcastach | Według deklaracji Ahmeda zaczęło się od jego prywatnej wiadomości do prowadzącego. |
| 60–90 sekund | Rekomendowana przez prelegenta długość pionowych materiałów wideo na LinkedIn. |
Praktyczne rady
- Zaprojektuj przejście od posta do działania. W sekcji „Polecane” pokaż konkretne ścieżki: ofertę, rezerwację rozmowy, zapis na newsletter lub materiał do pobrania.
- Opisz zmianę, którą zapewniasz klientowi. W sekcji „O mnie” połącz jego obecną sytuację, oczekiwany rezultat i sposób współpracy. Dodaj krótkie przykłady wyników.
- Zbieraj materiał z codziennej pracy. Decyzje, przeszkody, sukcesy i niepowodzenia mogą pokazywać kompetencje lepiej niż kolejna oderwana od praktyki lista porad.
- Pozyskuj odbiorców także poza LinkedIn. Przygotuj materiał rozwiązujący konkretny problem i udostępnij go w zamian za zapis na listę mailingową.
- Reaguj na sygnały zainteresowania. Pobranie materiału, udział w wydarzeniu, komentarz czy wizyta na profilu mogą być początkiem kontekstowej rozmowy zamiast pretekstem do seryjnej wiadomości ofertowej.
Knowledge bombs
1. Zalew „AI slopu” to szansa: przewagę daje to, czego AI nie napisze – osobiste historie zza kulis.
Skoro każdy z abonamentem ChatGPT produkuje poprawne treści edukacyjne, wyróżnia się storytelling: kulisy firmy, „building in public” (dzielenie się wygranymi i porażkami na bieżąco). Dotyczy to także eksperckich profili SEO-wców i agencji.
„AI won’t share this stuff. AI will share average educational style content. Personal storytelling is a way to stand out from the noise.”
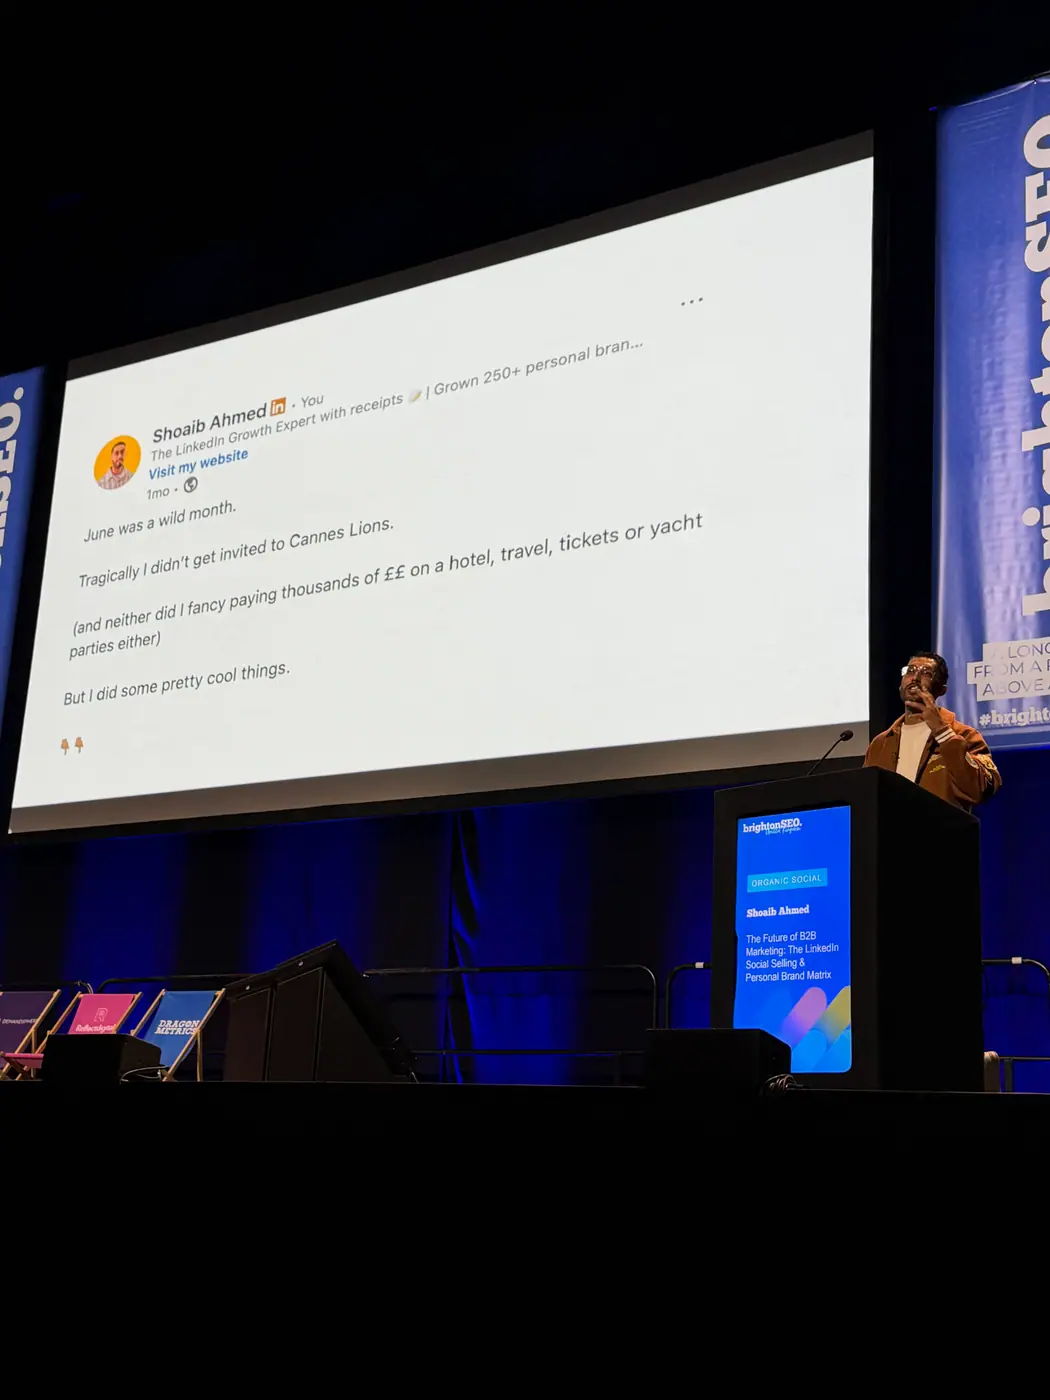
2. Najlepiej działają comiesięczne podsumowania „co się wydarzyło” w firmie i karierze.
Prosty, powtarzalny format, który według prelegenta generuje u niego największe zasięgi – ludzie są ciekawi, co dzieje się za zamkniętymi drzwiami firm.
„Every month I do a round up of things that happen in business, in my life, in my career. These posts get the most traction.”
3. Profil na LinkedInie to landing page – optymalizuj go jak stronę konwersyjną.
Posty mają tylko ściągać ruch na profil; profil ma odpowiadać: co robisz, dla kogo i dlaczego lepiej niż inni. Konkretnie: sekcja Featured z jasnymi usługami i miniaturami pod mobile, logotypy klientów w banerze, transformacja A→B w „About”, mini case studies. Nagłówek „Founder at [firma]” nic nie mówi – ani klientowi, ani organizatorowi konferencji.
„Is your headline memorable, or is it just founder at insert company? That tells me nothing.”
4. Połowa występów w podcastach zaczęła się od jednego pytania w DM-ie.
Gotowy skrypt outreachu do podcastów i konferencji: „What would it take…?”. Jeśli nie pasujesz, host zwykle powie dlaczego – dostajesz instrukcję, co poprawić.
„50% of the podcasts that I have been on started with a DM to the podcast host, and all I said, write this one down, what would it take? What would it take to appear on your podcast?”
5. Wideo „gadająca głowa”: 60–90 sekund, pionowo.
W morzu tekstów generowanych przez AI wideo buduje zaufanie i przebija się przez szum. Prelegent podaje konkretny optymalny format.
„60 to 90 seconds on LinkedIn portrait mode is the optimal.”
6. Atrybucja LinkedIna jest możliwa – punkt startu rozmowy da się przypisać do posta, DM-a, wejścia na profil lub lead magnetu.
W case study „Davida” agencja przypisywała podpisane kontrakty enterprise do konkretnych punktów styku na LinkedInie. Ostatni etap lejka to reagowanie na sygnały: kto oglądał profil, pobrał materiał, przyszedł na event, wszedł w interakcję.
„We can directly source back the start of the conversation or the point of interest to a LinkedIn post, to a LinkedIn DM, to a profile view, or to download a lead magnet that was promoted on LinkedIn.”
Zdjęcia: Shoaib Ahmed
16 kadrów · Fot. Robert Nowaczyk
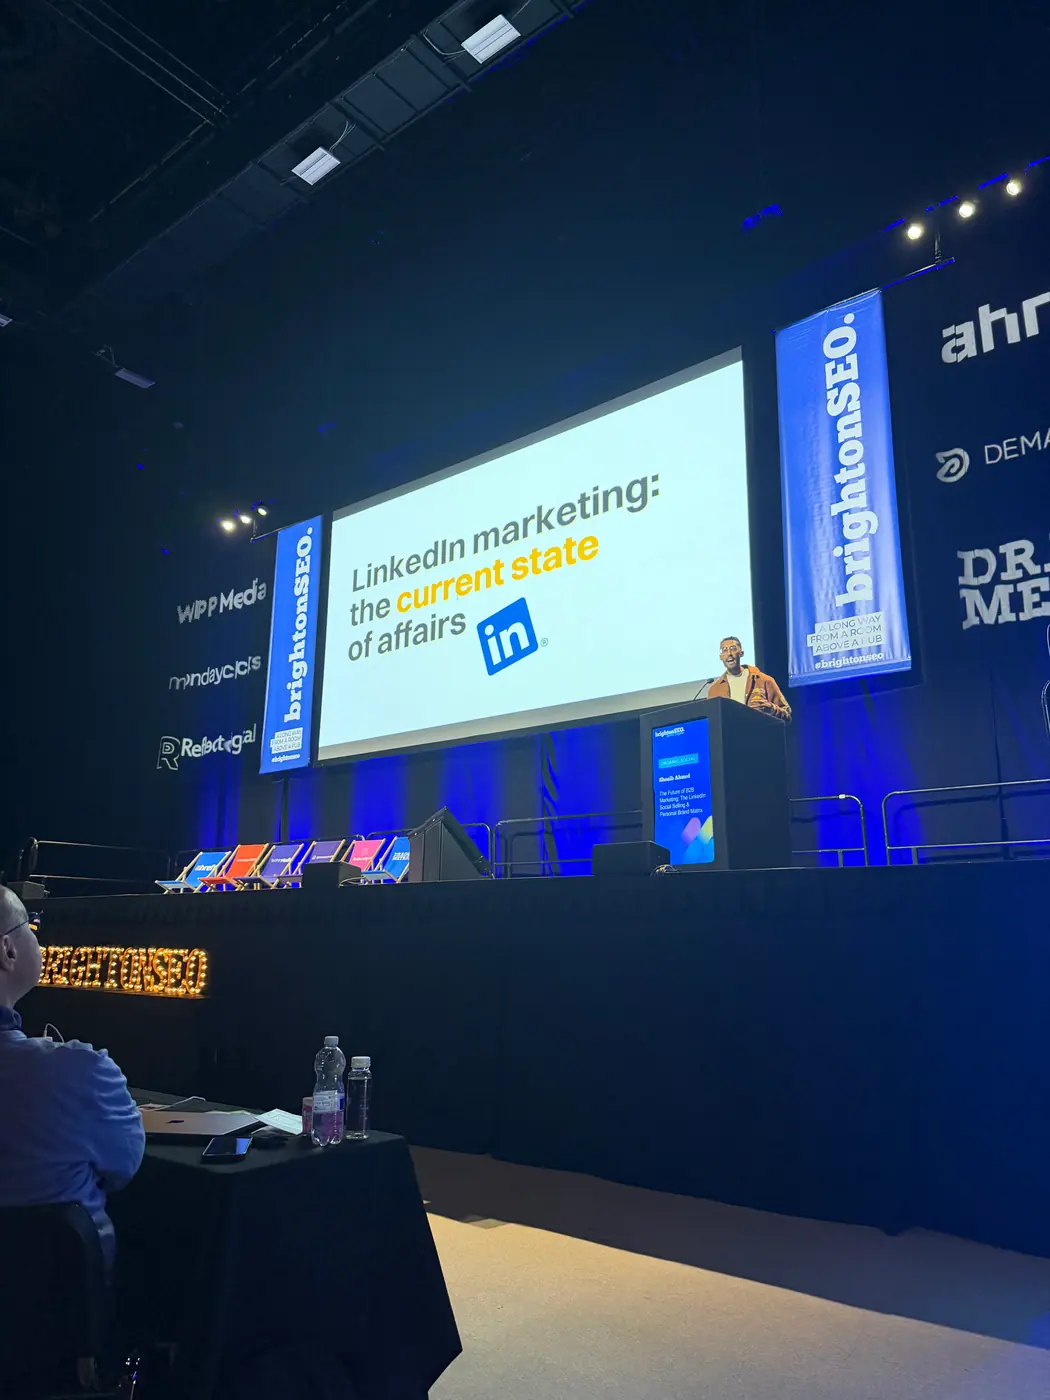
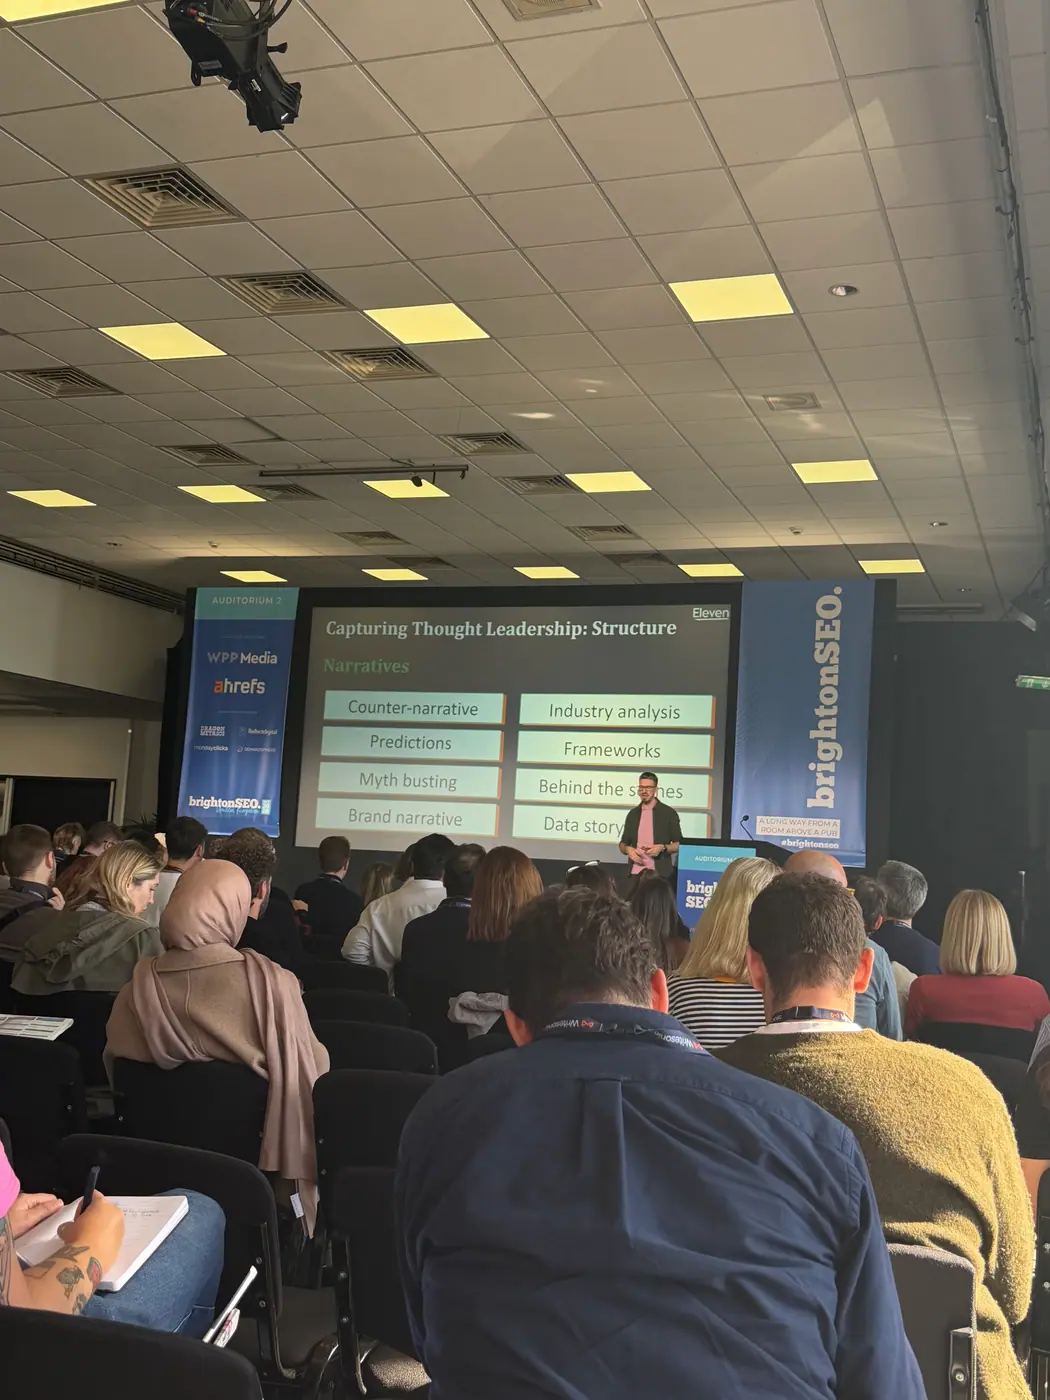
Christian Rigg: Best of Both Worlds: AI Content Systems with True Human EEAT
12:00 · Auditorium 2
Streszczenie
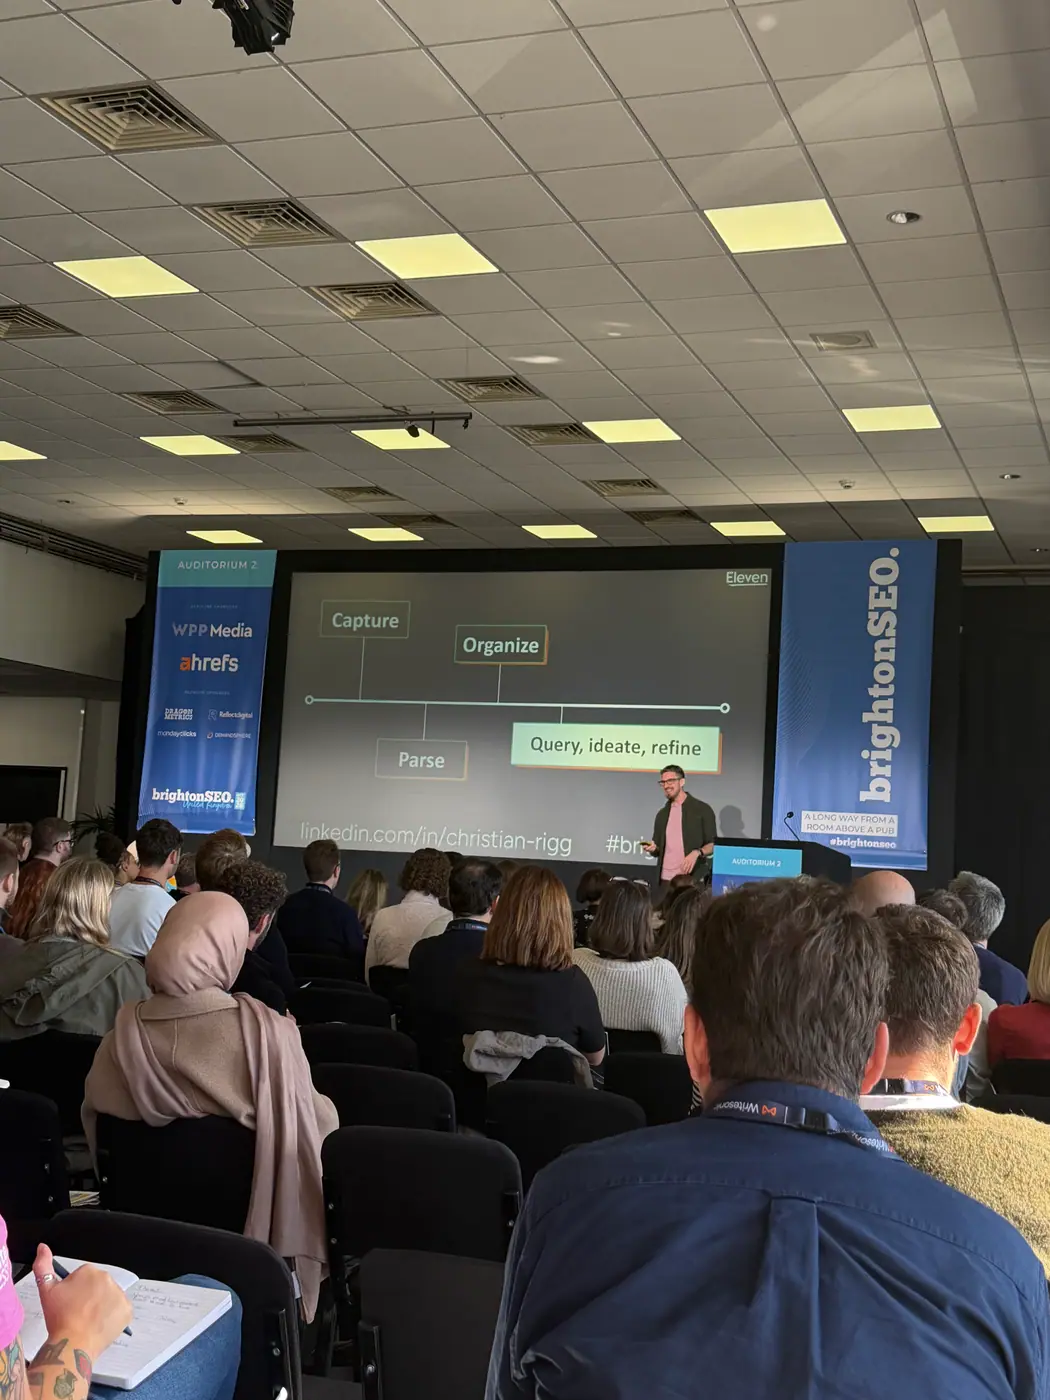
Christian Rigg przedstawił sposób wykorzystania firmowej bazy wiedzy do tworzenia treści z pomocą AI (Artificial Intelligence / sztuczna inteligencja). Źródłem były rozmowy zespołu, dokumentacja, podcasty i wywiady. Baza pozwalała odnajdywać konkretne wypowiedzi, śledzić zmianę stanowiska firmy, aktualizować publikacje oraz przygotowywać briefy i studia przypadków.
Najważniejszy wątek: model językowy pomagał wydobywać i porządkować wiedzę ekspertów, zamiast zastępować ją ogólnymi odpowiedziami.
Najważniejsze wnioski
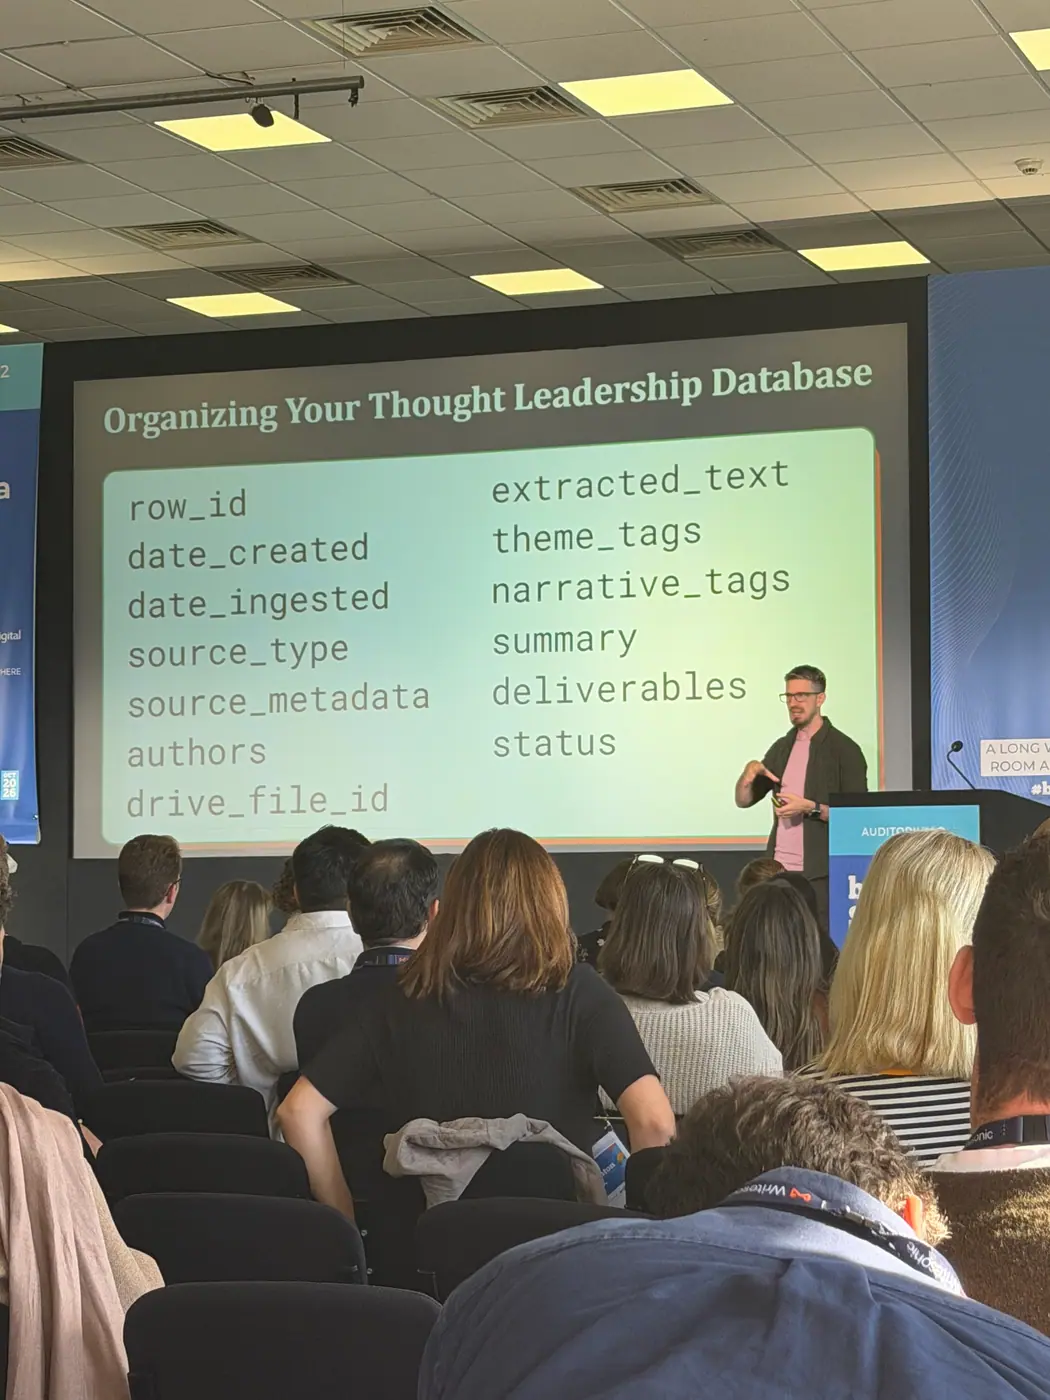
- Źródło i kontekst były częścią systemu. Każdy materiał miał identyfikator, autorów, datę powstania, datę dodania do bazy oraz informacje pozwalające wrócić do oryginału.
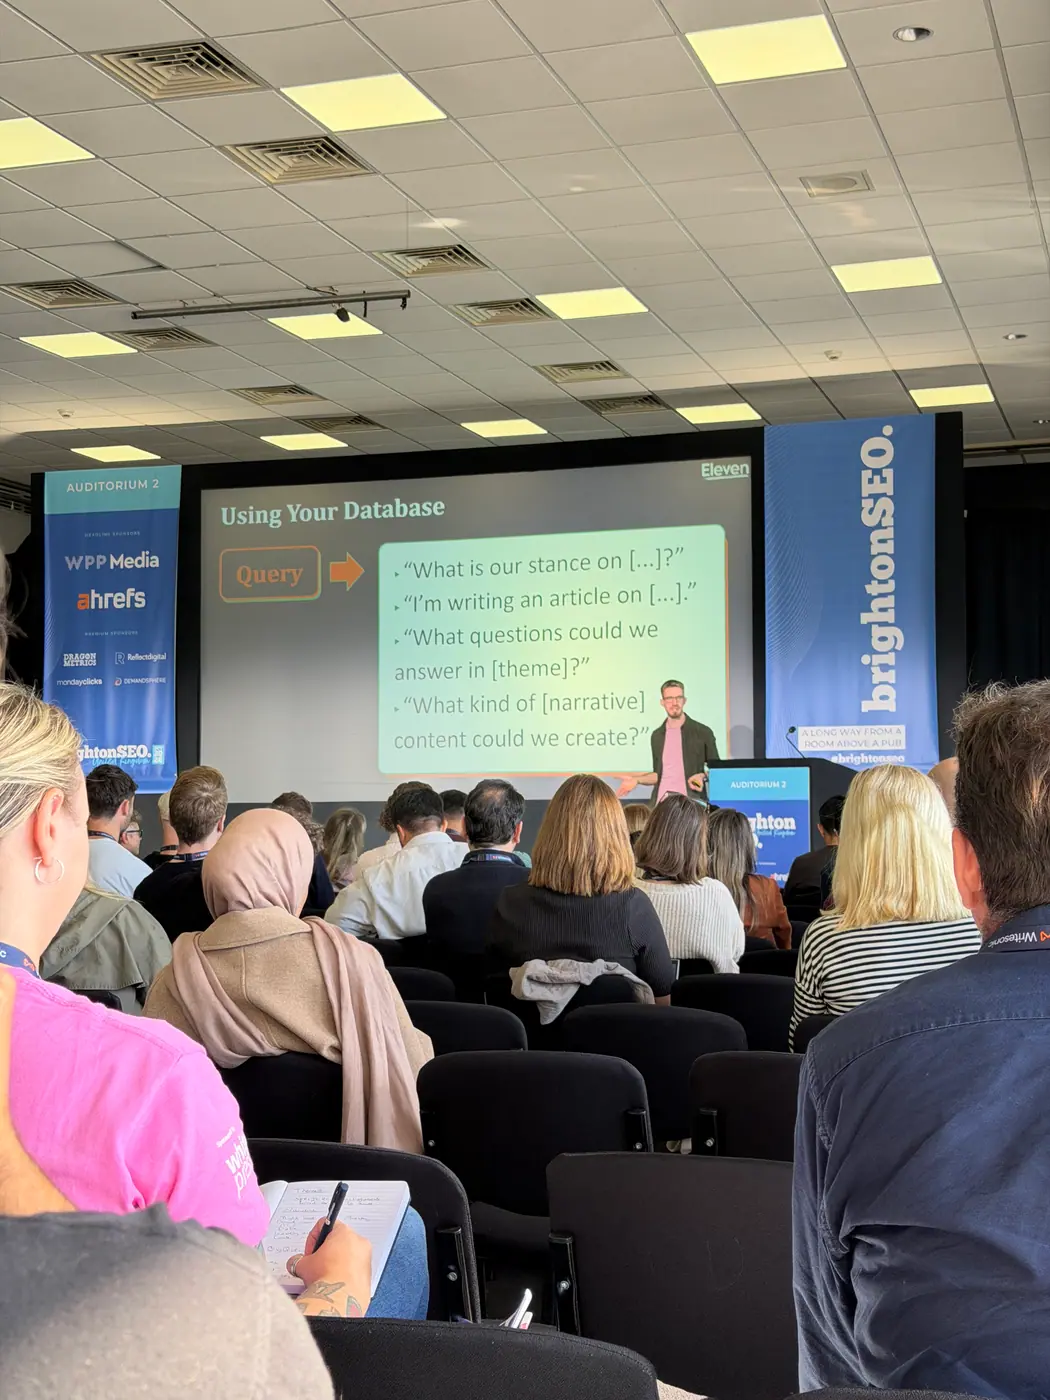
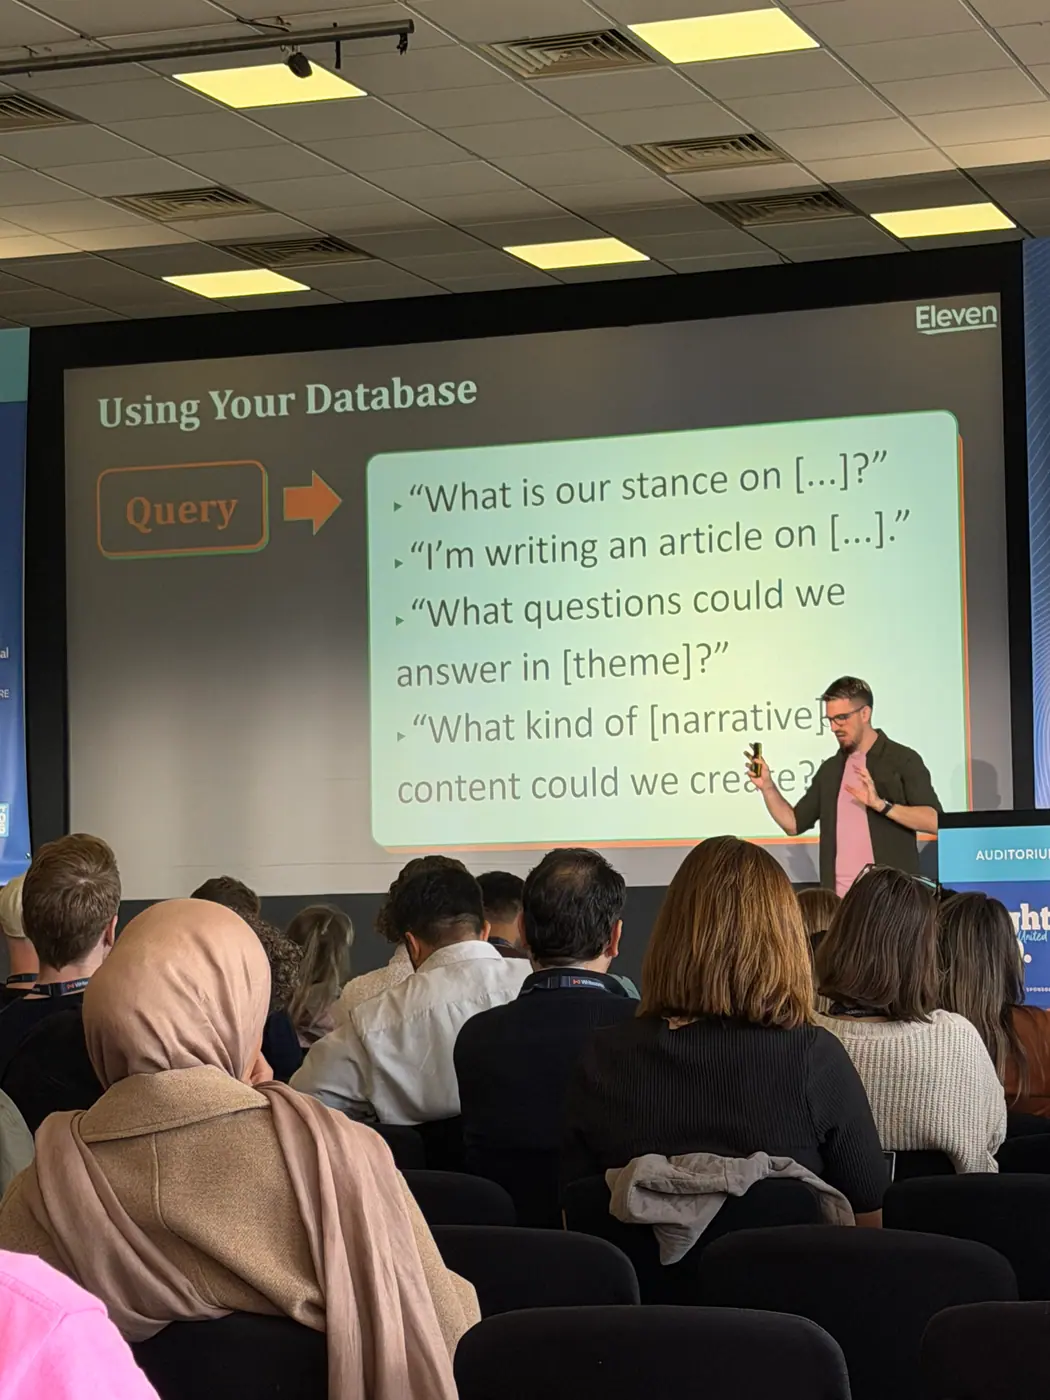
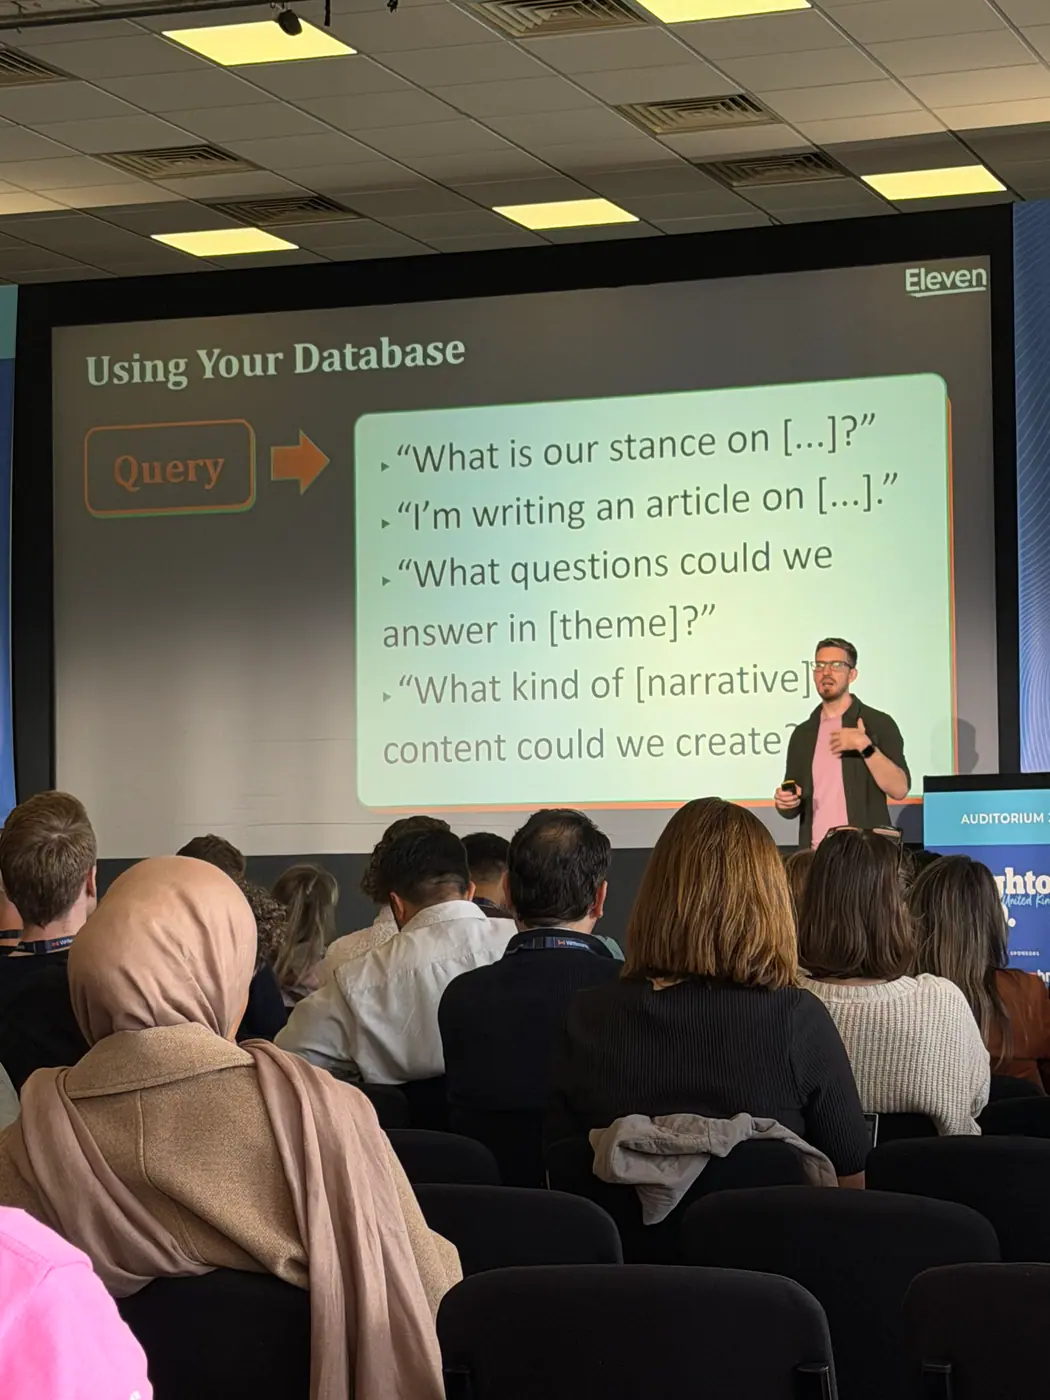
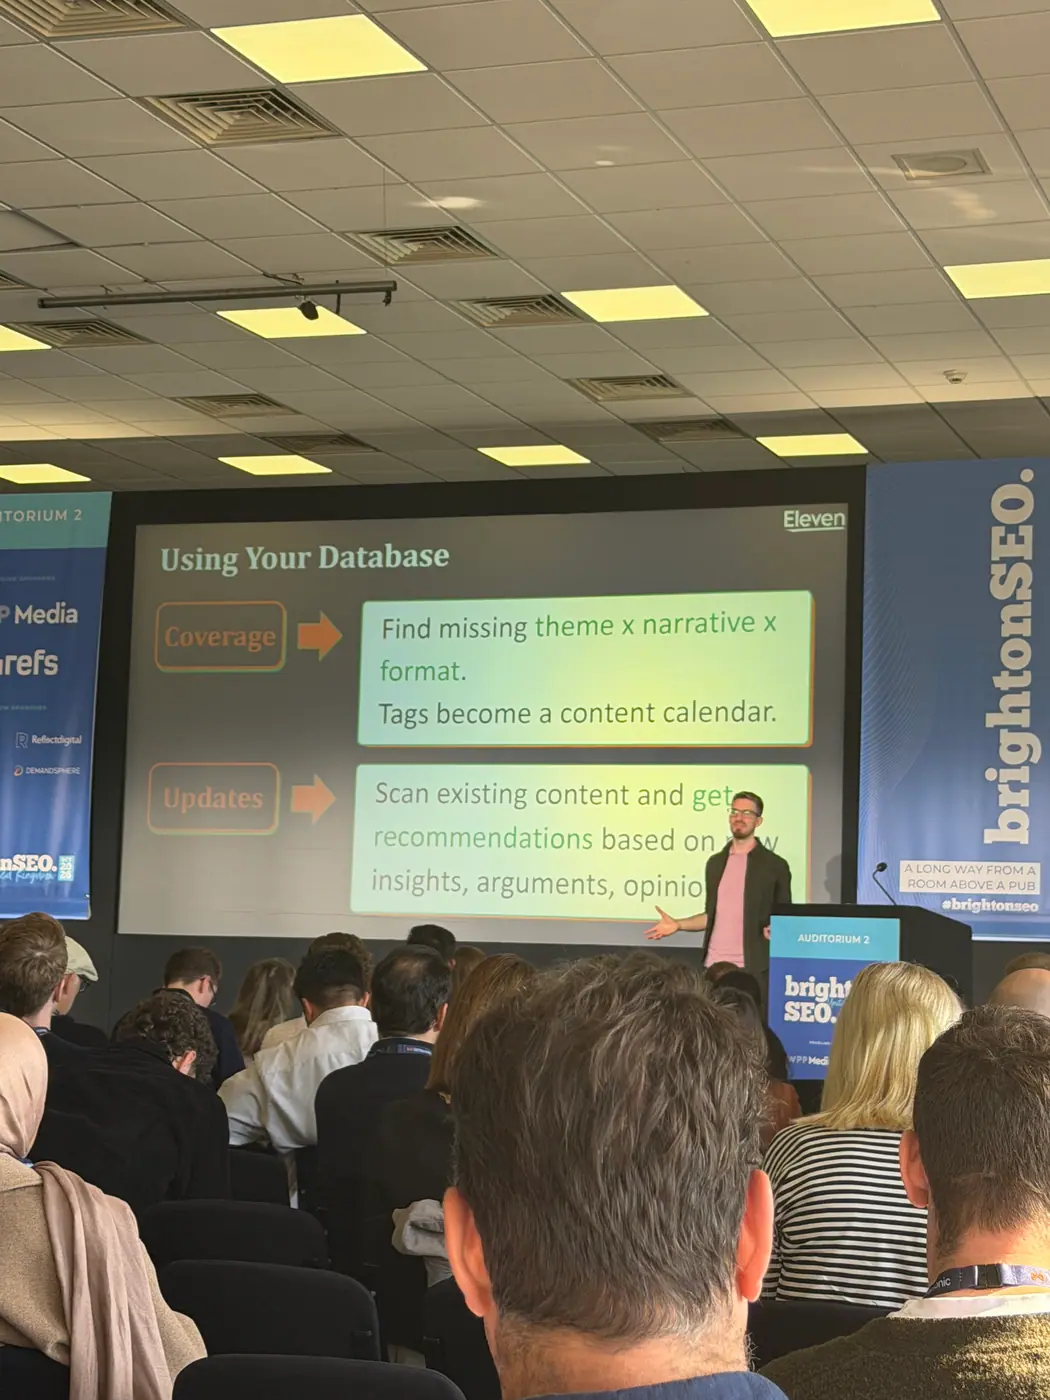
- Baza służyła nie tylko do pisania. Rigg pokazał jej zastosowanie w szukaniu luk tematycznych, analizowaniu powracających zagadnień i odtwarzaniu stanowiska firmy.
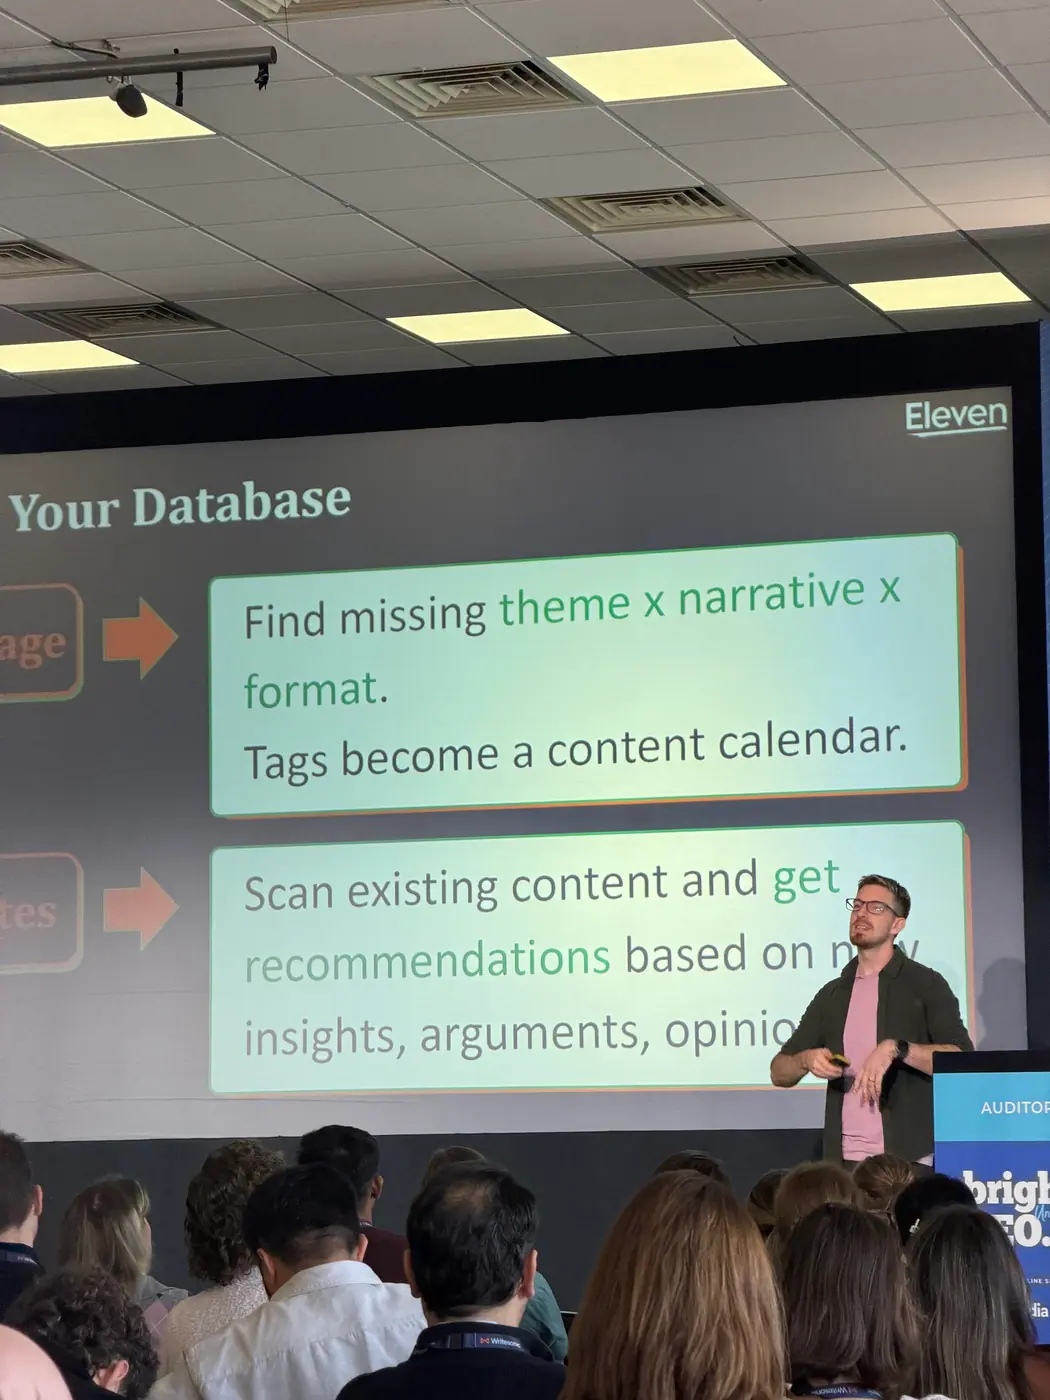
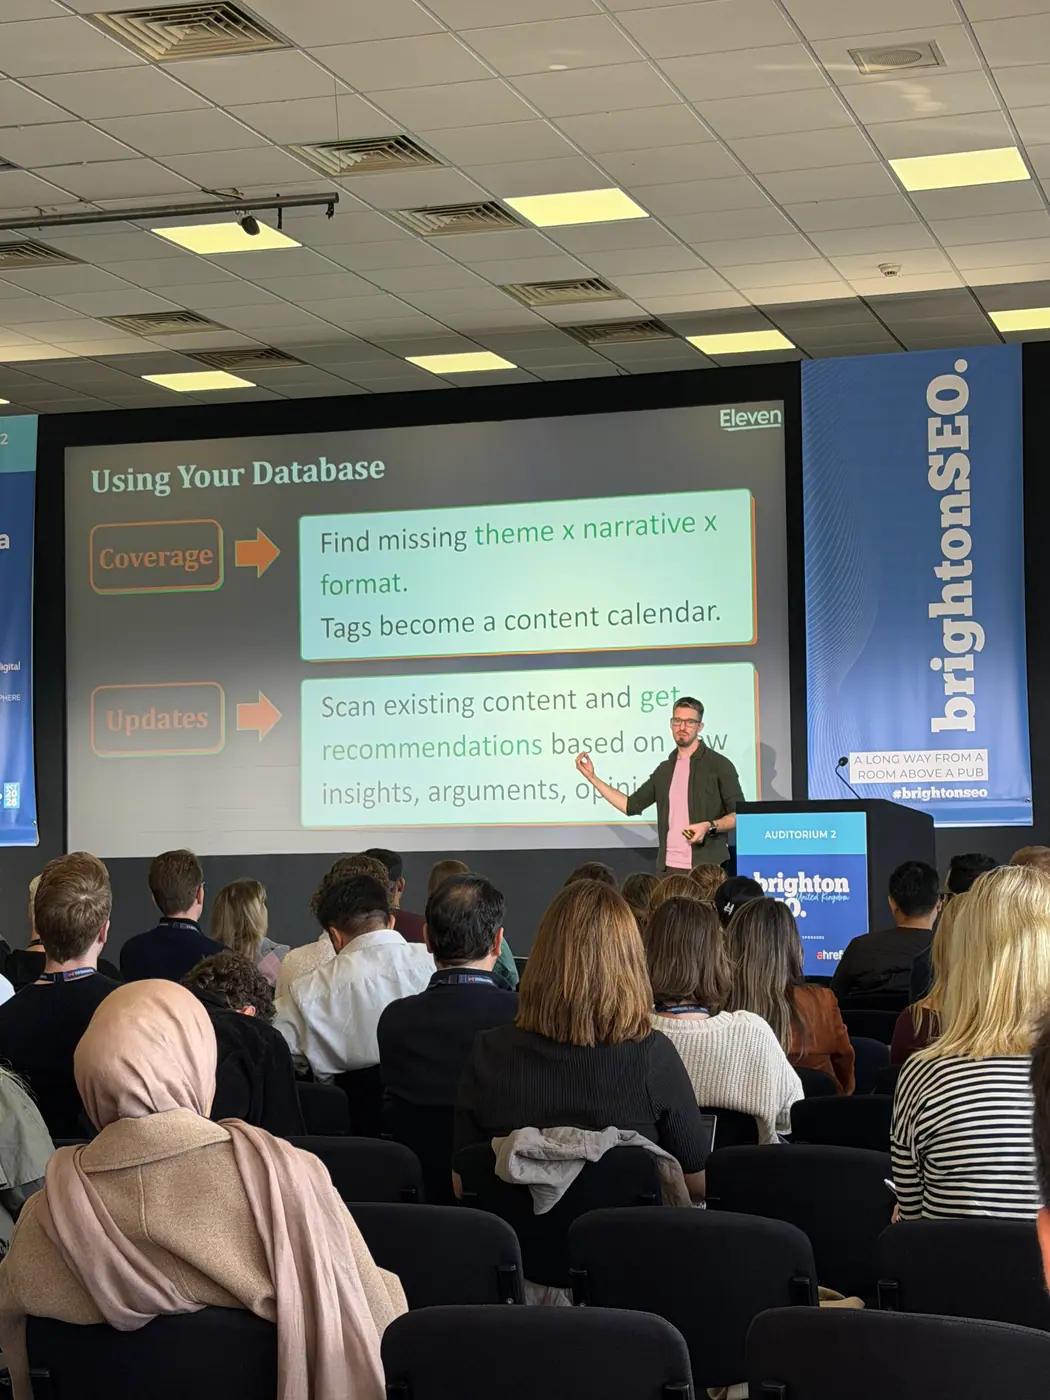
- Aktualizacja miała wynikać ze zmiany wiedzy. Prelegent podkreślił, że sama podmiana daty nie wystarcza. Proponował porównywanie opublikowanych treści z późniejszymi rozmowami zespołu.
- Rozbieżności między ekspertami były materiałem redakcyjnym. Rigg uznał debaty, trafne przewidywania i zmiany zdania za wartościowe sposoby pokazywania E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness / doświadczenie, wiedza ekspercka, autorytet i wiarygodność).
- Znaczenie świeżości dla wyszukiwania generatywnego było oceną prelegenta. Sugerował, że aktualność może być tam jeszcze ważniejsza niż w SEO (Search Engine Optimization / optymalizacja pod wyszukiwarki).
Dane liczbowe i przykłady
Liczby w materiale opisywały organizację pracy i przykładowe zastosowania, nie wyniki wdrożeń.
- 3 elementy planowania treści: temat, narracja i format.
- 2–3 miesiące: przykładowy okres, z którego można analizować rozmowy podczas aktualizacji artykułu.
- 4 miesiące: przykładowy zakres wyszukiwania cytatów oraz pokazania wcześniejszych przewidywań zespołu.
- Styczeń i marzec 2026: przykład porównania wcześniejszego stanowiska z późniejszą wypowiedzią współpracownika, którą zaakceptował zespół.
Praktyczne rady
- Zapisuj osobno datę powstania materiału i datę dodania go do bazy. Zachowuj autorów oraz odnośnik do źródła.
- Ujednolicaj tekst do czytelnego formatu, np. Markdown. Oddzielaj oznaczenia tematu od oznaczeń narracji.
- Rejestruj, w których publikacjach wykorzystano już dany materiał.
- Przed aktualizacją sprawdzaj, co zmieniło się w wiedzy zespołu od czasu publikacji.
- Buduj briefy z przypisanymi do sekcji cytatami, źródłami i dostępnymi danymi, a nie wyłącznie z listą zagadnień.
Knowledge bombs
1. Wszystko, co firma „mówi”, trafia do bazy jako znormalizowany Markdown z metadanymi.
Każdy wpis ma m.in. unikalne ID, datę powstania i datę zaimportowania, typ źródła (kanał Slack, podcast, wywiad) z metadanymi, autorów, ID pliku na Dysku Google, tagi tematów i narracji, streszczenie, listę materiałów, w których już go użyto, oraz status wykorzystania. Tekst wyciąga LLM i zapisuje w jednym formacie – czytelnym i dla człowieka, i dla modelu.
„The extracted text, we just get an LLM to basically take whatever the text is, extract it, and write it down in Markdown. So, it’s all kind of a standardized format. It’s very easy for a human to read. It’s also very easy for an LLM to read.”
2. Siatka „temat × narracja × format” do szukania luk w pokryciu tematów.
Bazę można pytać wprost: „o czym jeszcze nie mówiliśmy?”, „jakie stanowisko mamy w sprawie X?”, „wyciągnij wszystkie cytaty z ostatnich 4 miesięcy”. Rigg układa pomysły w siatkę 3×3: tematy, narracje (np. kontrnarracja, kulisy) i formaty.
„And I like to use the theme by narrative by format. So, it’s kind of this three-by-three grid.”
3. Merytoryczna aktualizacja treści = porównanie, co zmieniło się w wewnętrznych rozmowach od publikacji.
Zamiast podbijać datę, system skanuje istniejący artykuł i zestawia go z tym, co zespół mówił później – np. „w styczniu powiedziałeś X, w marcu kolega powiedział Y i wszyscy się zgodzili”. To gotowa lista realnych zmian do wprowadzenia.
„Being able to just scan our existing content and say, what has changed in our conversations? What has changed in the way that we think about these things in the last two or three months or whenever since it was written?”
4. Wewnętrzne spory zespołu to surowiec na thought leadership.
Baza pozwala wyłapać punkty sporne i debaty z rozmów w zespole – gotowy materiał na treści z wyraźnym, eksperckim stanowiskiem.
„Identifying debates and points of contention that happen within your teams.”
5. Brief, w którym każda sekcja ma już przypisane cytaty konkretnych ludzi, dane i wykresy.
Po miesiącach zasilania bazy brief do artykułu powstaje z gotowymi cytatami, źródłami i danymi rozpisanymi na sekcje – autor nie musi „wymyślać” ekspertyzy.
„You’ve got directly in it the quotes, the citations, the data, the graphs, everything that over months and months you put all of this stuff into your beautiful thought leadership database,”
Zdjęcia: Christian Rigg
12 kadrów · Fot. Robert Nowaczyk
Tom Capper: How not to measure AI
12:20 · Syndicate 3&4 (MeasureFest)
Streszczenie
Tom Capper podczas brightonSEO, 8 października 2026, przekonywał, że brak kliknięcia nie oznacza automatycznie braku wpływu na zakup. Jego zdaniem SEO (Search Engine Optimization / optymalizacja pod kątem wyszukiwarek) trzeba coraz częściej oceniać także jako kanał budowania marki.
W wyszukiwaniu opartym na AI (Artificial Intelligence / sztuczna inteligencja) rekomendacja może powstać bez wizyty użytkownika na stronie firmy, a zakup nastąpić później przez inny kanał. Capper zaproponował więc mierzenie obecności marki, treści rekomendacji i widoczności. Cytowania potraktował jako pomoc w diagnozowaniu działań, nie jako samodzielny miernik sukcesu.
Najważniejsze wnioski
Główna interpretacja prelegenta: zero-click to przede wszystkim problem atrybucji.
Użytkownik może zobaczyć rekomendację, a następnie kupić u preferowanego sprzedawcy lub po kolejnym wyszukiwaniu. Analityka rejestruje końcowy kontakt, ale niekoniecznie wcześniejszy wpływ marketingu.Obserwacje z prezentowanych danych: ekspozycja i ruch coraz wyraźniej się rozchodzą.
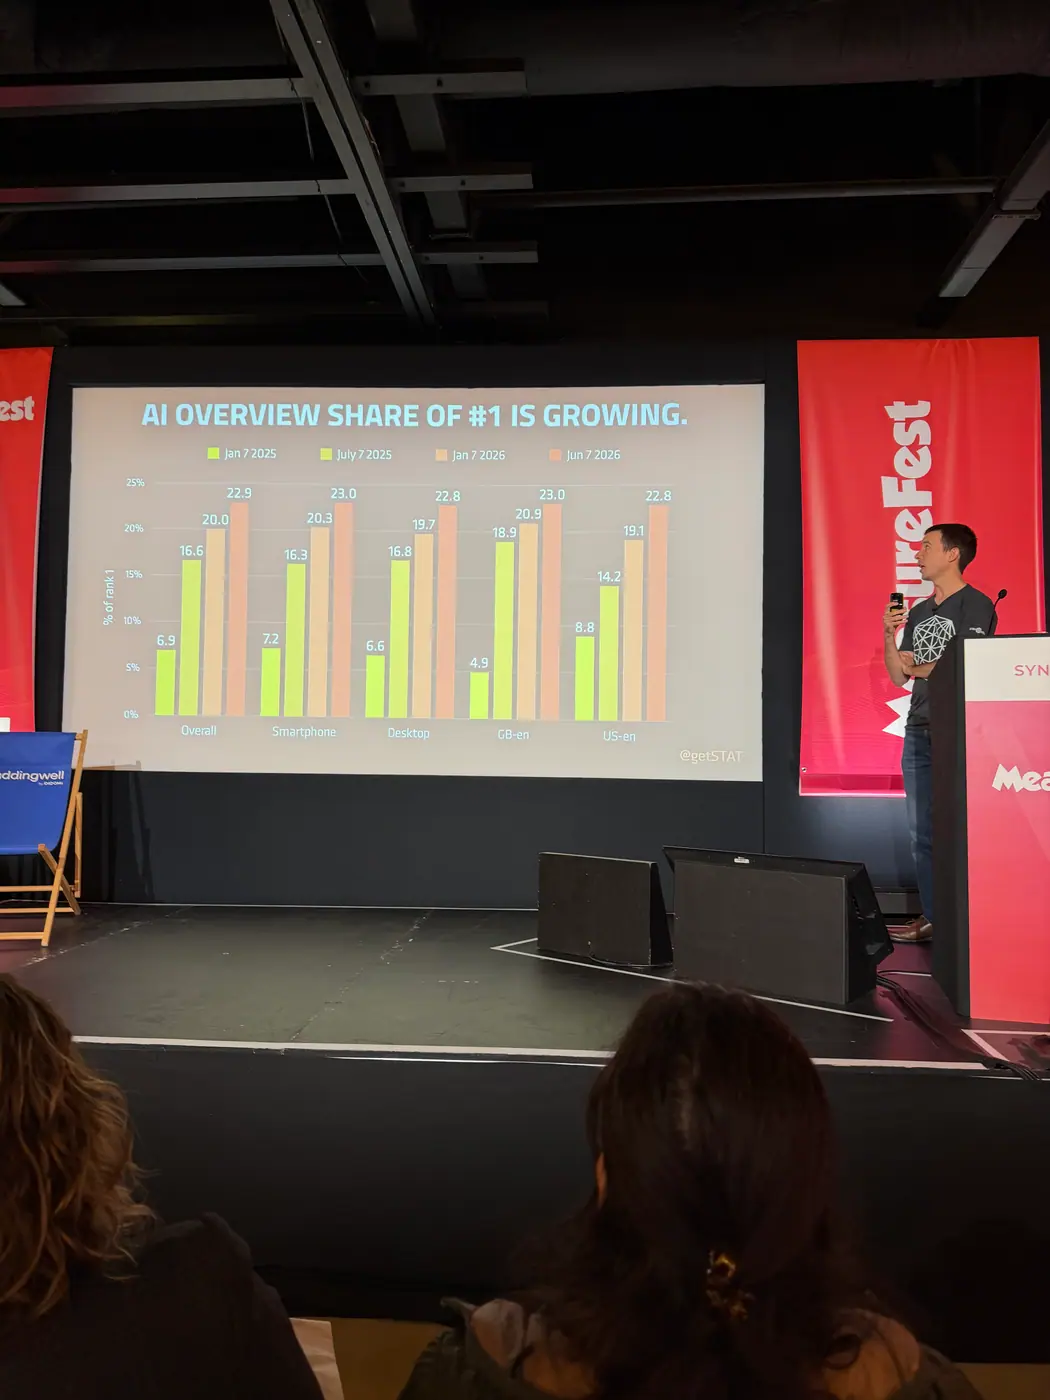
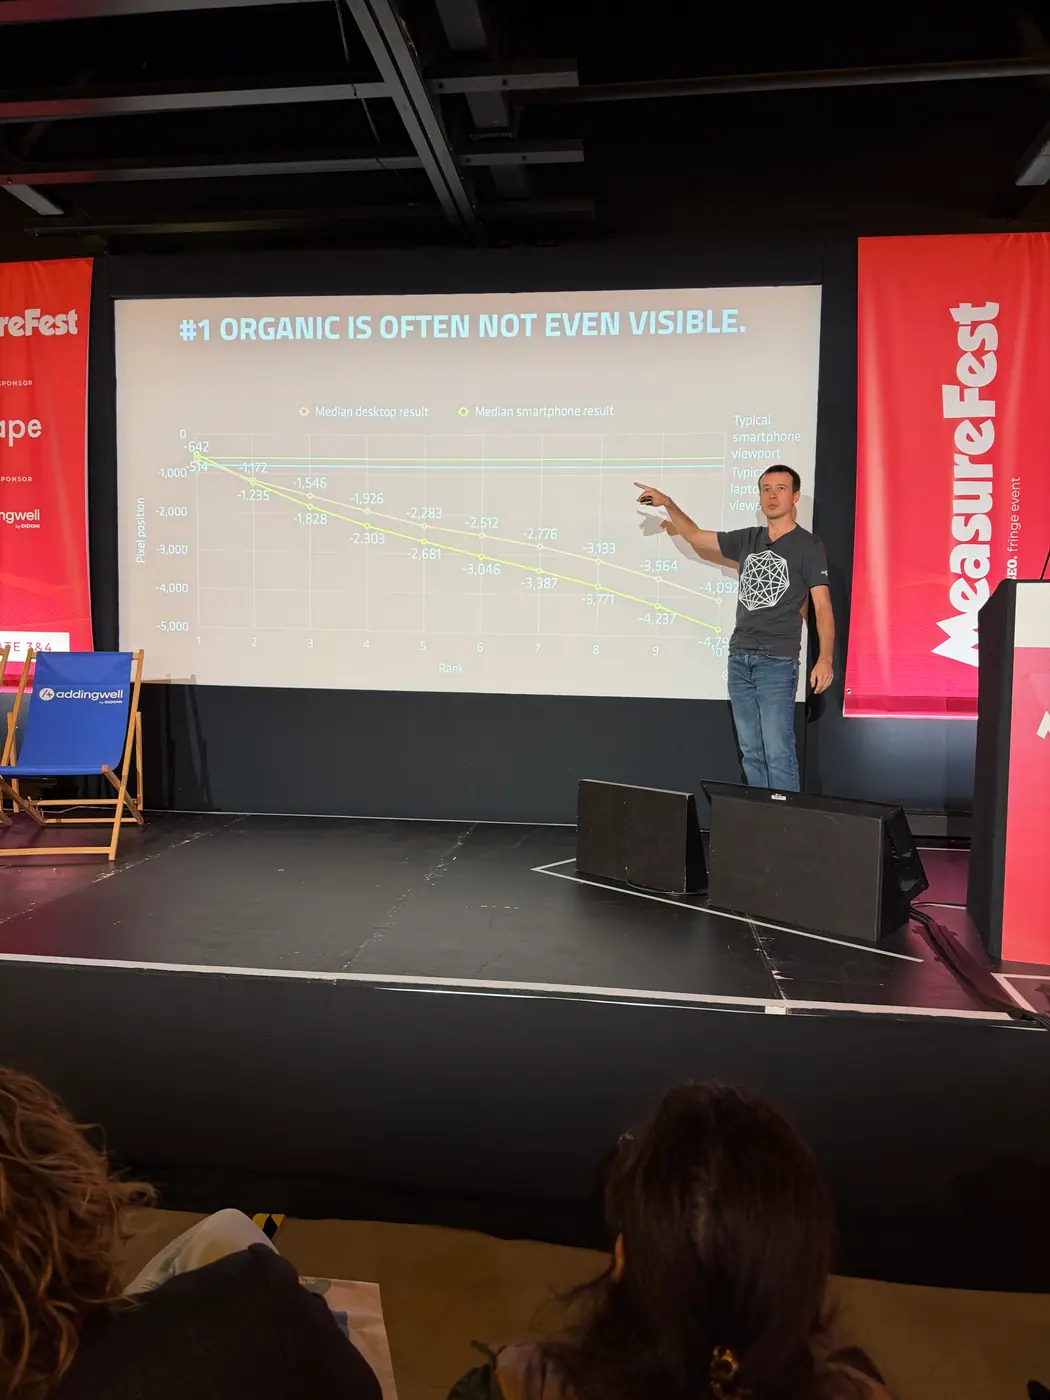
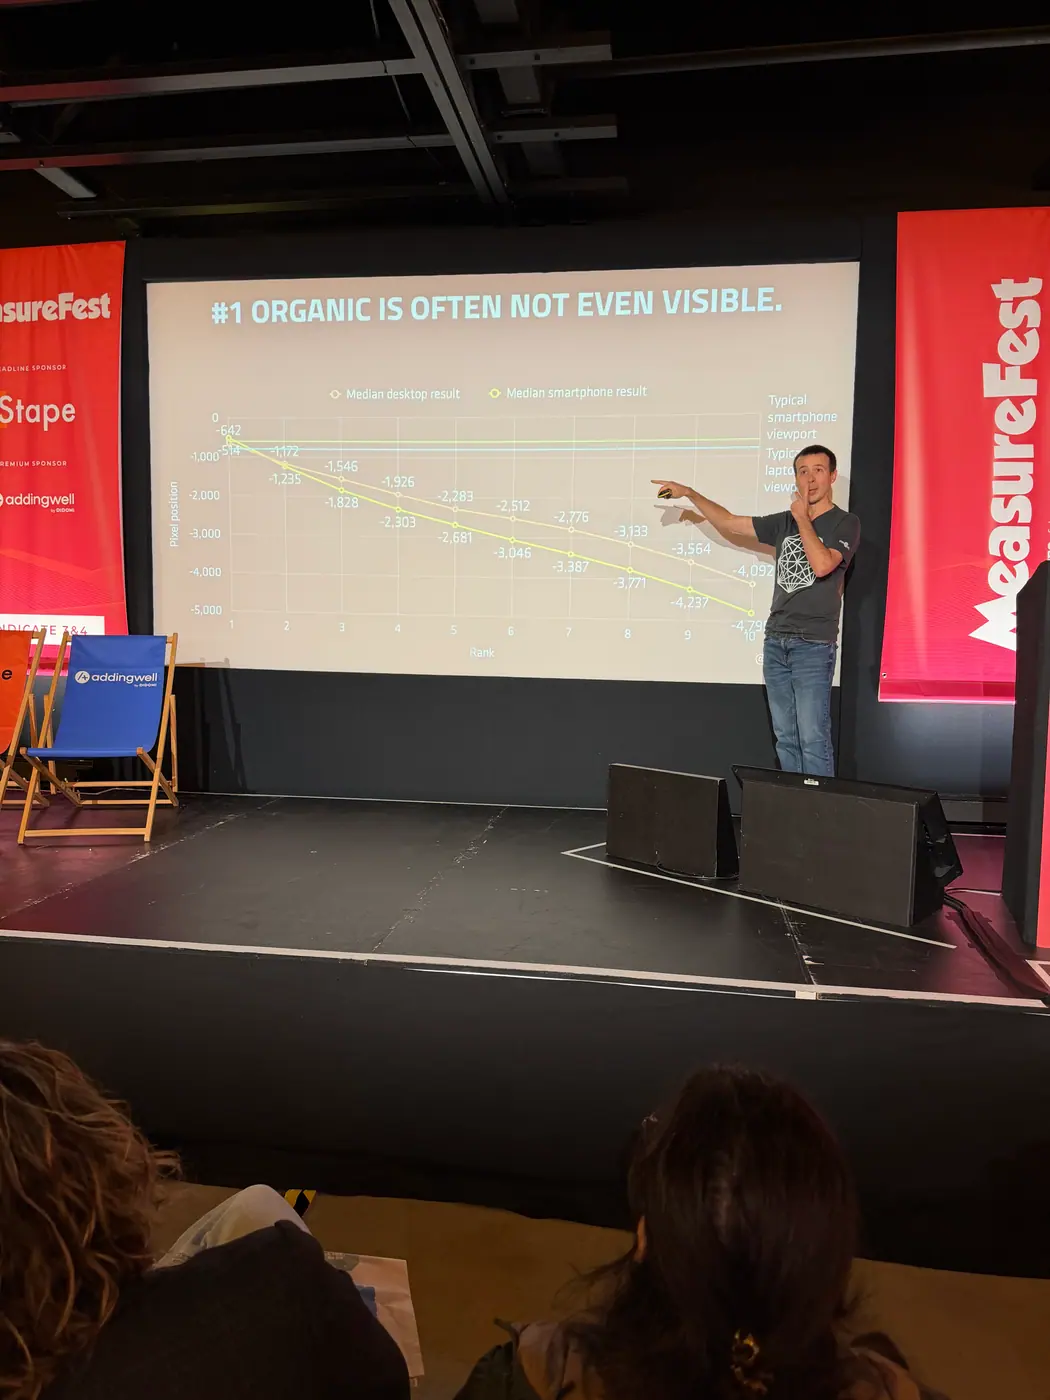
Pierwszy wynik organiczny przesuwał się niżej na ekranie. Jednocześnie przywołane zestawienia pokazywały, że ruch z kanałów AI nie zastępował utraconego ruchu organicznego. Najsilniej dotyczyło to początku ścieżki zakupowej.Wzmianka o marce i cytowanie źródła to dwa różne wyniki.
Odpowiedź może polecać produkty firmy, cytując wyłącznie zewnętrzne strony. Raport ograniczony do linków do własnej domeny nie pokaże wtedy uzyskanej rekomendacji.Cytowania mają wartość diagnostyczną.
Capper dostrzegł możliwość lepszego powiązania działań dotyczących konkretnej strony z jej późniejszym wykorzystaniem jako źródła. Istotne było jednak również to, czy zmieniła się rekomendacja marki.Rekomendowany kierunek: pomiar bliższy marketingowi marki.
Prelegent wskazał obecność, jakościową ocenę wypowiedzi o marce i porównanie z konkurencją. Nie postulował całkowitego porzucenia pomiaru konwersji, lecz uwzględnienie wartości kontaktów, które nie generują kliknięć.
Dane liczbowe i przykłady
- Nieco ponad 2/3 wyszukiwań w Google nie kończyło się żadnym kliknięciem. Ta informacja dotyczyła wyszukiwań ogółem, nie wyłącznie odpowiedzi generowanych przez AI.
- Około 693 piksele od góry strony wyników wynosiło w marcu średnie położenie pierwszego wyniku organicznego w pokazanych danych.
- Około 300 pikseli niżej przesunął się pierwszy wynik organiczny w połowie roku. Nadal był pierwszy w rankingu organicznym, ale zajmował gorsze miejsce na ekranie.
- 2/3 kanału efektywnościowego i 1/3 kanału budowania marki to autorska charakterystyka SEO sprzed około dekady, którą przywołał Capper. Była to jego ocena roli kanału, nie zmierzony podział przychodów.
Praktyczne rady
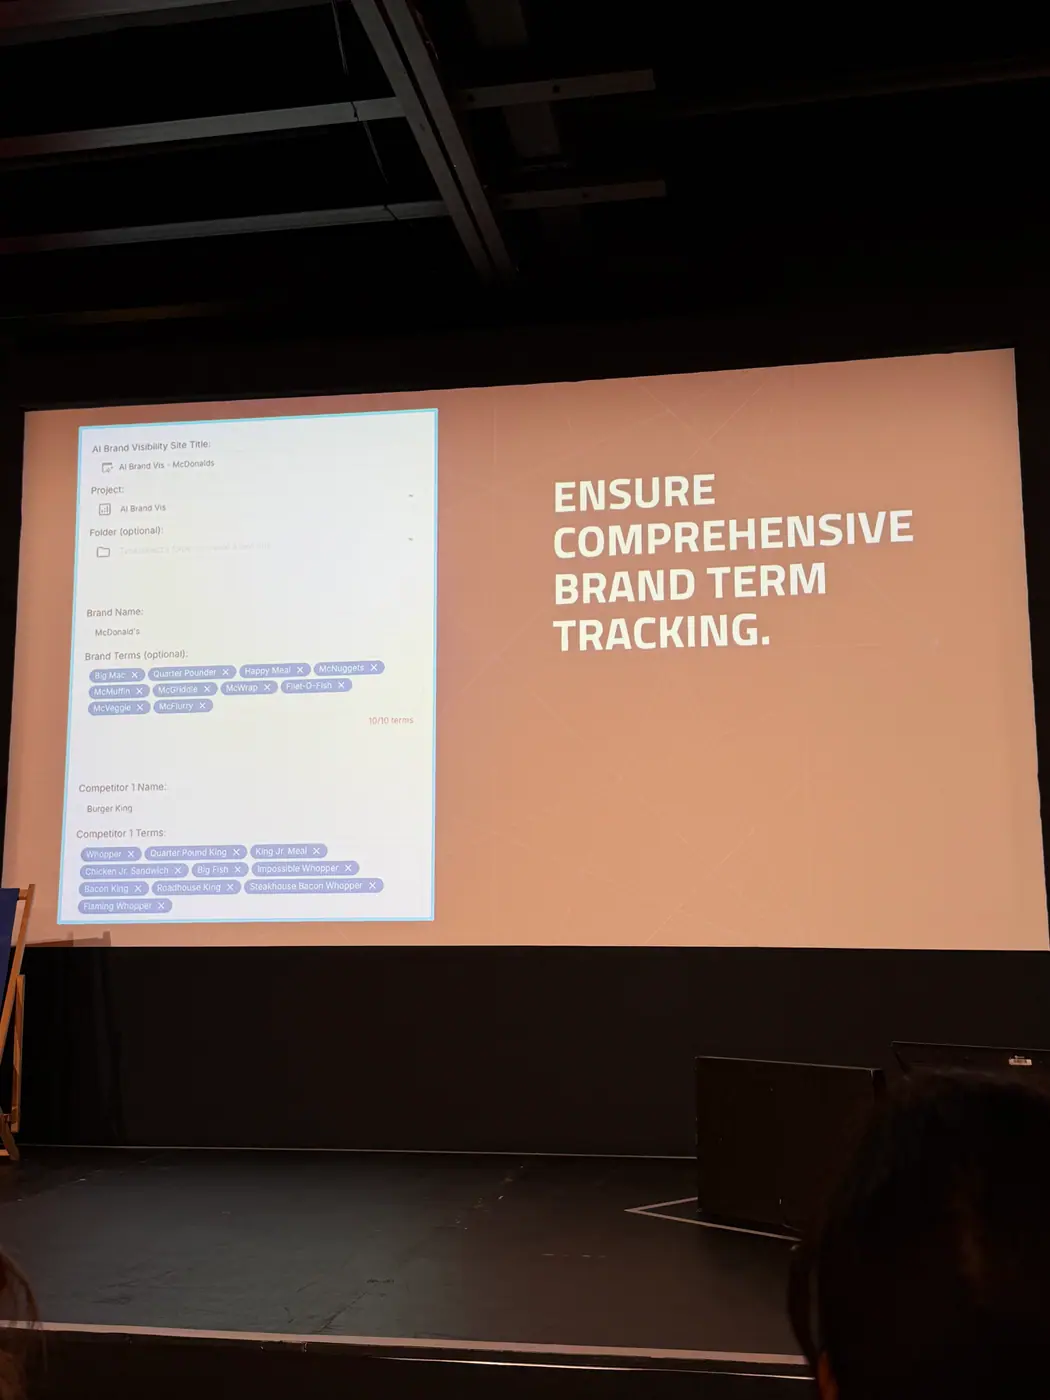
Przygotuj listę nazw marki, submarek i ich wariantów. Zrób to również dla konkurentów. Monitorowanie samej domeny nie obejmie wszystkich istotnych wzmianek.
Monitoruj reprezentatywny zestaw pytań, nie pojedyncze odpowiedzi. Capper porównał zmienność AI do znanego wcześniej problemu personalizacji i lokalizacji wyników wyszukiwania. Większa próba pomaga ograniczać szum.
Rozdziel obecność, rekomendację i cytowanie. Sprawdzaj, czy marka występuje w odpowiedzi, w jakim kontekście jest polecana i jakie źródła zostały wykorzystane. Oceniaj treść wypowiedzi, zamiast poprzestawać na etykietach „pozytywna”, „neutralna”, „negatywna”.
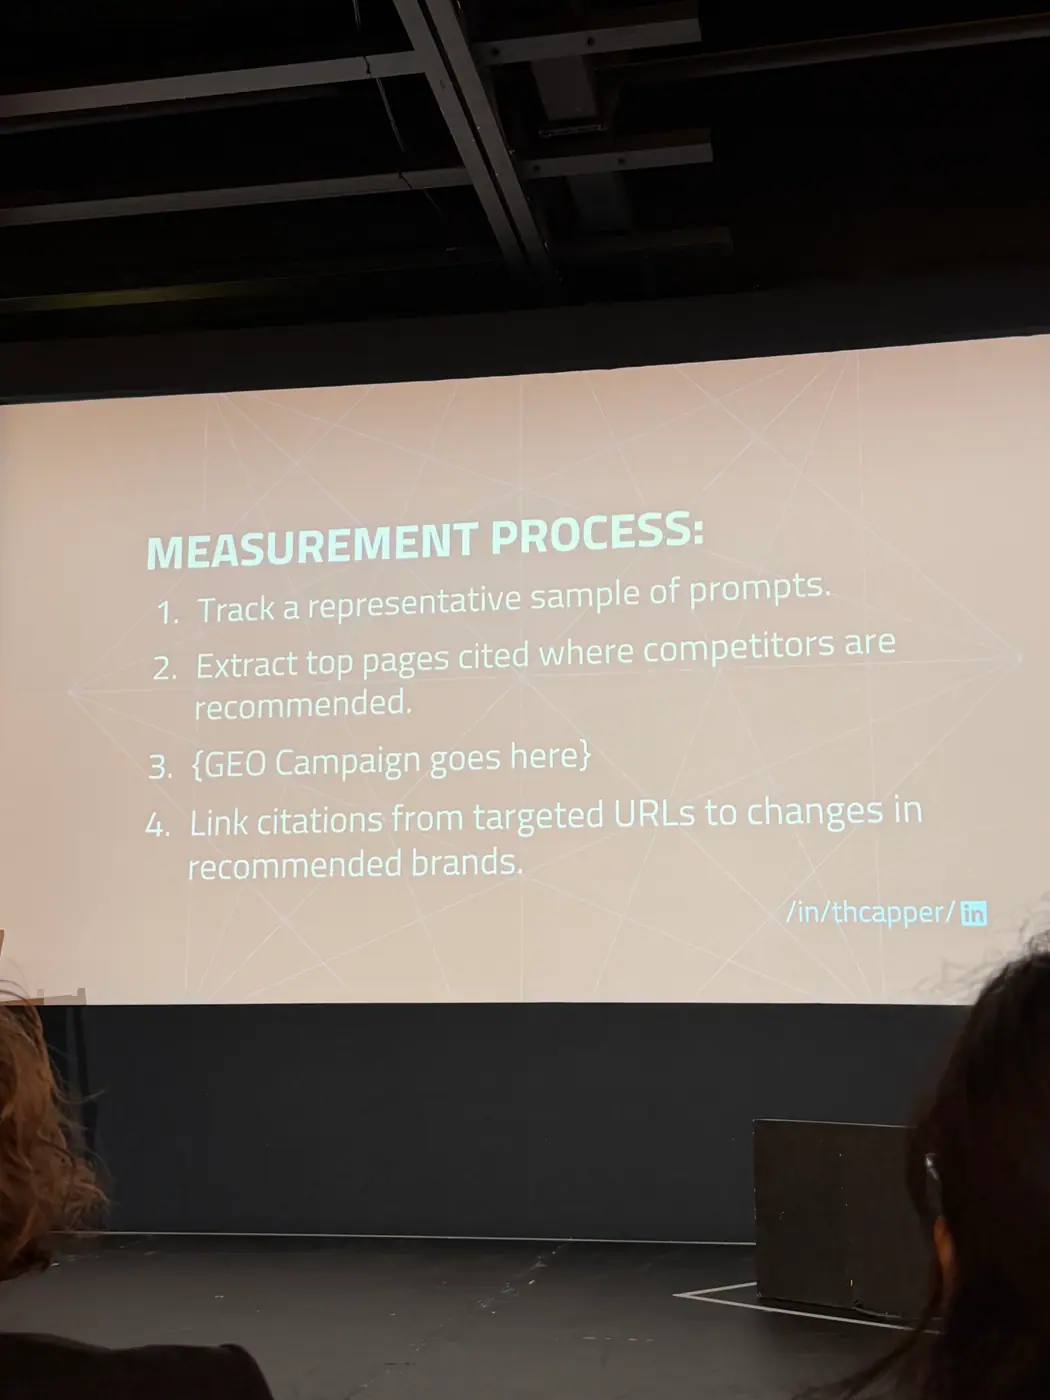
Powiąż działania z konkretnymi źródłami. W GEO (Generative Engine Optimization / optymalizacja widoczności w wyszukiwarkach generatywnych) identyfikuj strony cytowane przy rekomendacjach konkurencji. Po działaniach dotyczących tych stron sprawdzaj zarówno cytowania, jak i zmianę obecności własnej marki.
Uzupełnij raportowanie o widoczność i wskaźniki marki. W klasycznym wyszukiwaniu uwzględniaj ekspozycję na pierwszym ekranie. Zestawiaj różne sygnały, zamiast traktować pojedynczą metrykę jako pełny obraz wpływu marketingu.
Knowledge bombs
1. Zero-click to problem analityki, nie SEO – zakupy dalej się dzieją, tylko nie widać ścieżki.
Ta sama liczba ludzi kupuje tyle samo przez te same kanały; znika jedynie punkt styku, który dało się zmierzyć (brak kliknięcia = brak cookie = brak sygnału). Capper winą za niechęć klientów do inwestowania obarcza „bagno atrybucji”.
„What I want to try and suggest to you today is that this is not actually an SEO problem. Because, like I said, the same number of people are still making the same number of purchases. It’s an analytics problem.”
2. Pozycja 1 organicznie zjechała średnio o kolejne 300 pikseli w ciągu kilku miesięcy.
Dane z narzędzia prelegenta: w marcu pierwszy wynik organiczny był średnio ok. 693 px od góry (okolice dolnej krawędzi typowego laptopa), a w połowie roku – 300 px niżej. Wniosek: nawet w klasycznym SEO trzeba mierzyć widoczną powierzchnię nad linią zgięcia, nie samą pozycję.
„In March, Organic Position 1 was about 693 pixels down, which, by the way, is near the bottom of a typical laptop screen on average. Did you know that it got 300 pixels lower in the middle of the year?”
3. Śledź marki (z sub-markami), nie URL-e – i koniecznie konkurencję.
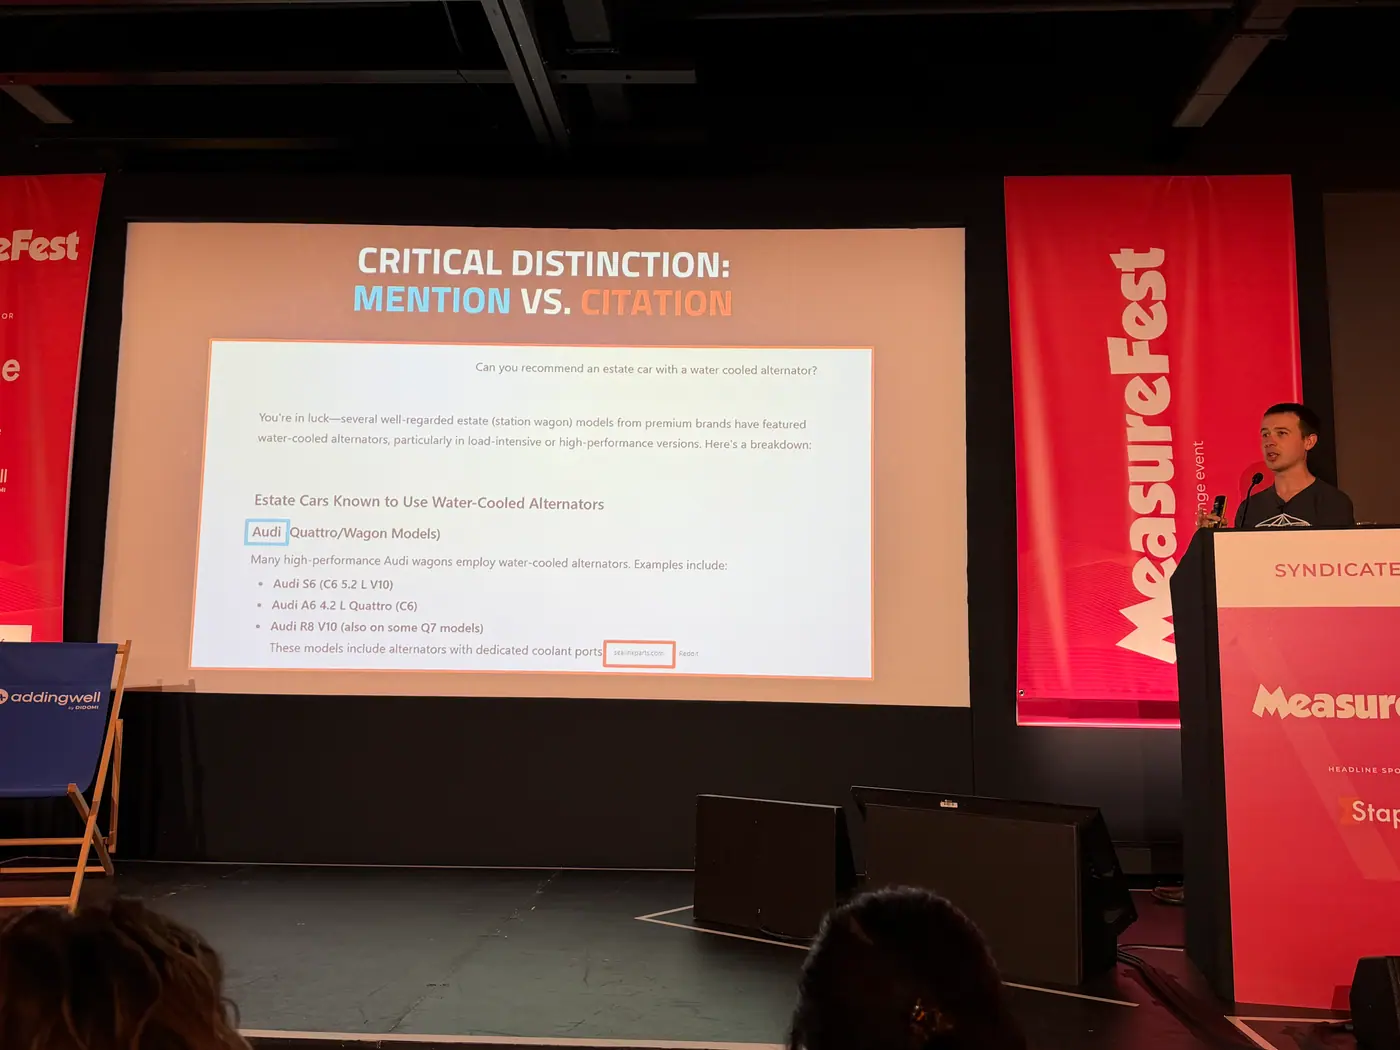
W odpowiedziach AI często nie ma nawet niepodlinkowanej domeny. Relacja marka–domena jest „wiele do wielu” (np. Quattro to też Audi), więc potrzebna jest pełna lista nazw marki i sub-marek – również dla konkurentów, bo jedynym benchmarkiem staje się wynik względem nich.
„We’re not interested in the URL. We’re interested in the brand.”
4. GEO po raz pierwszy daje SEO-wcom czytelną atrybucję taktyk.
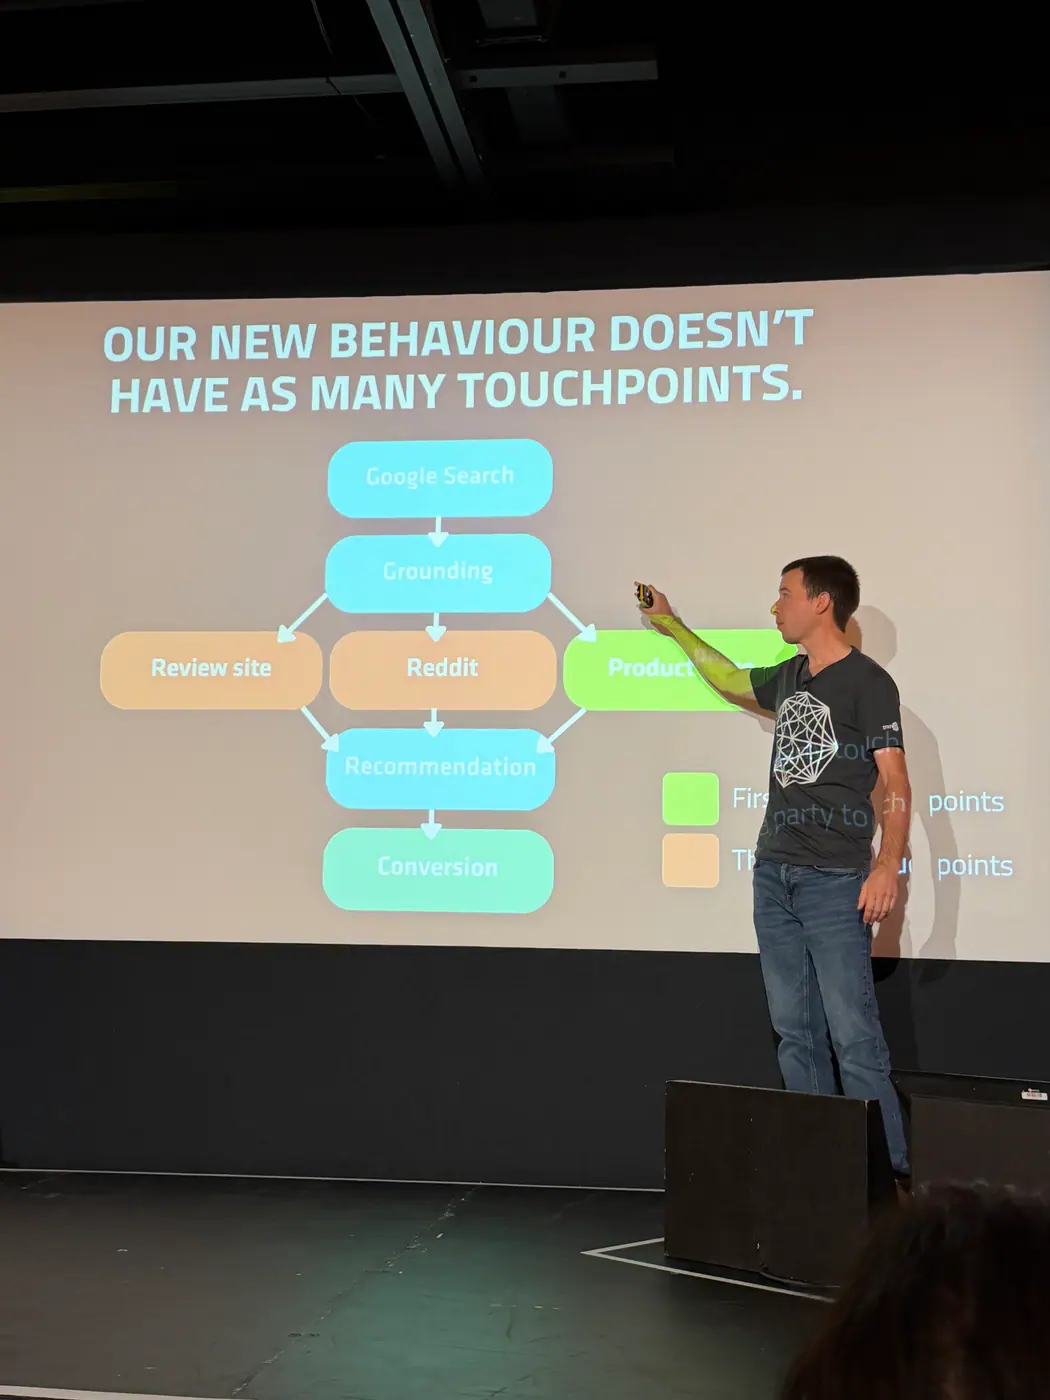
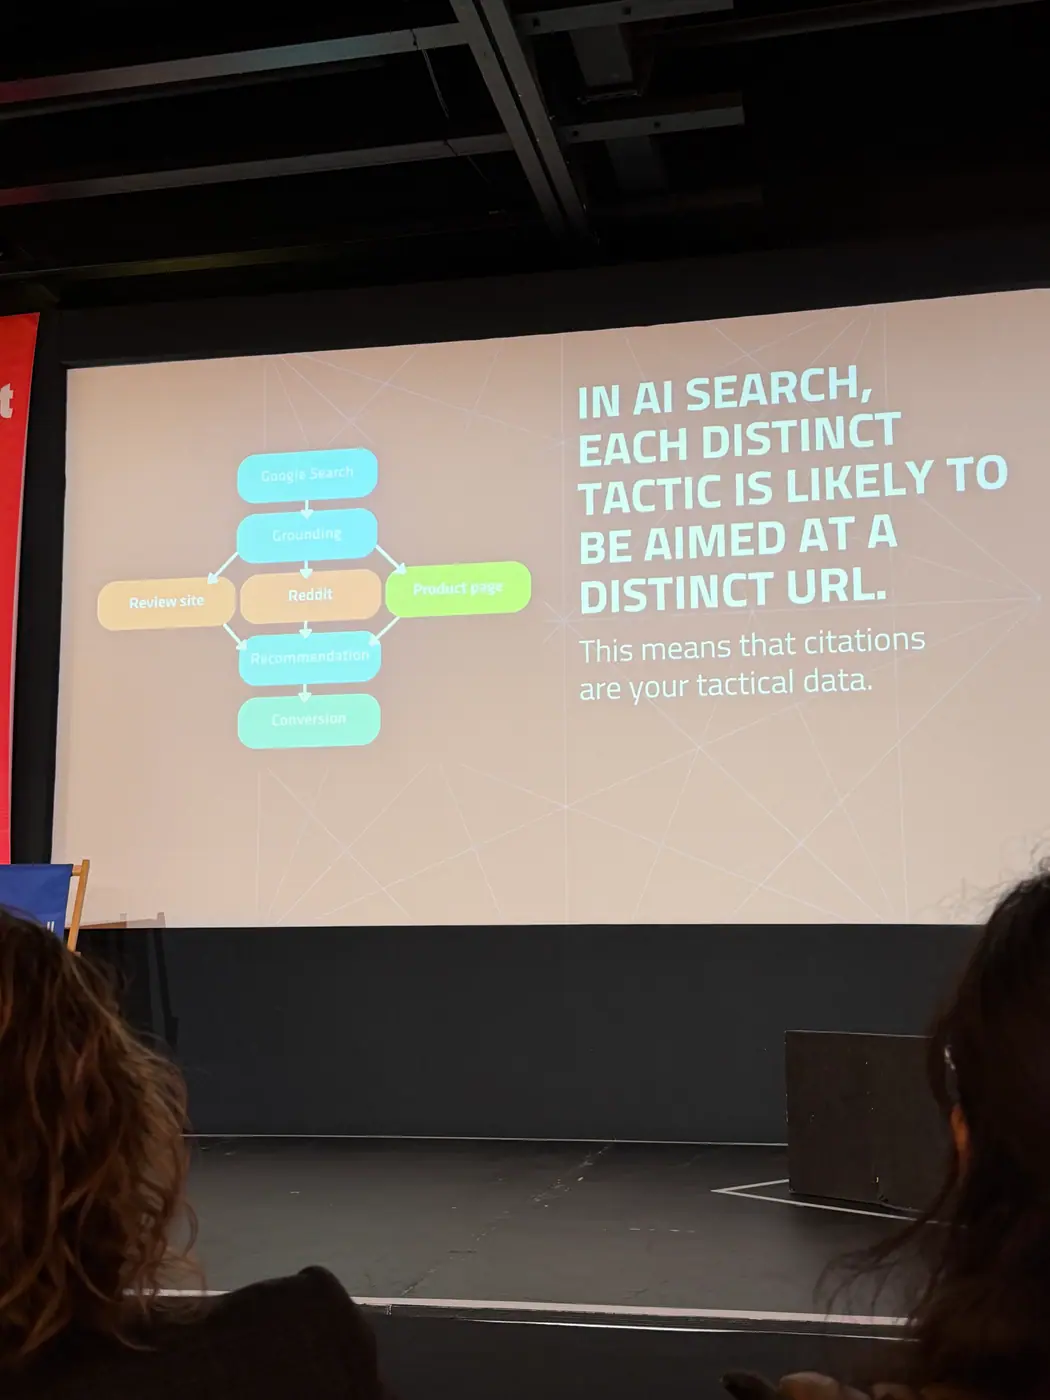
W klasycznym SEO link building, technika, on-page i linkowanie wewnętrzne wpływają na jedną stronę i nie wiadomo, co zadziałało. W GEO taktyka zwykle celuje w jeden konkretny URL (często nie na twojej domenie – np. recenzję w serwisie zewnętrznym), więc widać: ten URL zaczął być cytowany i zmienił rekomendowaną markę.
„That is actually a lot easier now, because what’s probably going to happen is that your geotactics are going to affect a single URL that is probably not on your site.”
5. Cytowania to wskaźnik wyprzedzający i narzędzie taktyczne, nie KPI.
Proces: reprezentatywna próbka promptów → wyciągnij najczęściej cytowane strony tam, gdzie rekomendowana jest konkurencja → celuj w nie kampanią GEO → sukcesem jest cytowanie z docelowego URL-a, które zmienia rekomendowaną markę w odpowiedzi.
„And then the citations from targeted URLs that change the recommended brand in the response, that’s your success. That’s your sort of leading indicator.”
6. „AI jest niedeterministyczne” to ta sama obiekcja, co przy personalizacji Google 10 lat temu.
Rozwiązanie też to samo: odpowiednio duża próbka, która uśrednia szum. Capper sugeruje, że podejście (i budżet) na śledzenie promptów powinno przypominać to przy śledzeniu fraz.
„And you deal with this essentially by having a sample size that gets around some of that noise. This is not really any different.”
7. Sentyment tylko jakościowo – skala „pozytywny/neutralny/negatywny” nic nie mówi.
Bazowym wskaźnikiem jest obecność (presence); sentyment warto dodać, ale jako opis jakościowy.
„I would say if you do sentiment, it needs to be qualitative, not like good, neutral, bad.”
8. SEO przesuwa się z kanału „2/3 performance, 1/3 brand” w stronę brandu.
Capper od lat (artykuł z 2019 r.) przekonuje, że SEO powinno liczyć wyświetlenia. Teraz branża jest zmuszona nadrobić koncepcje pomiaru brandowego.
„Historically, say 10 years ago, I’ve said that SEO was sort of two-thirds a performance channel, one-third a brand channel. That is shifting,”
Zdjęcia: Tom Capper
14 kadrów · Fot. Robert Nowaczyk
Jeremy McDonald: From Gut Checks to Guardrails: Deploying Trustworthy AI for Marketing QA
14:00 · Auditorium 2
Streszczenie
Jeremy McDonald przedstawił problem rosnącej dysproporcji między produkcją a kontrolą jakości: AI (Artificial Intelligence / sztuczna inteligencja) pozwala wykonywać więcej pracy, ale pobieżne przejrzenie wyników nie wystarcza do ich sprawdzenia.
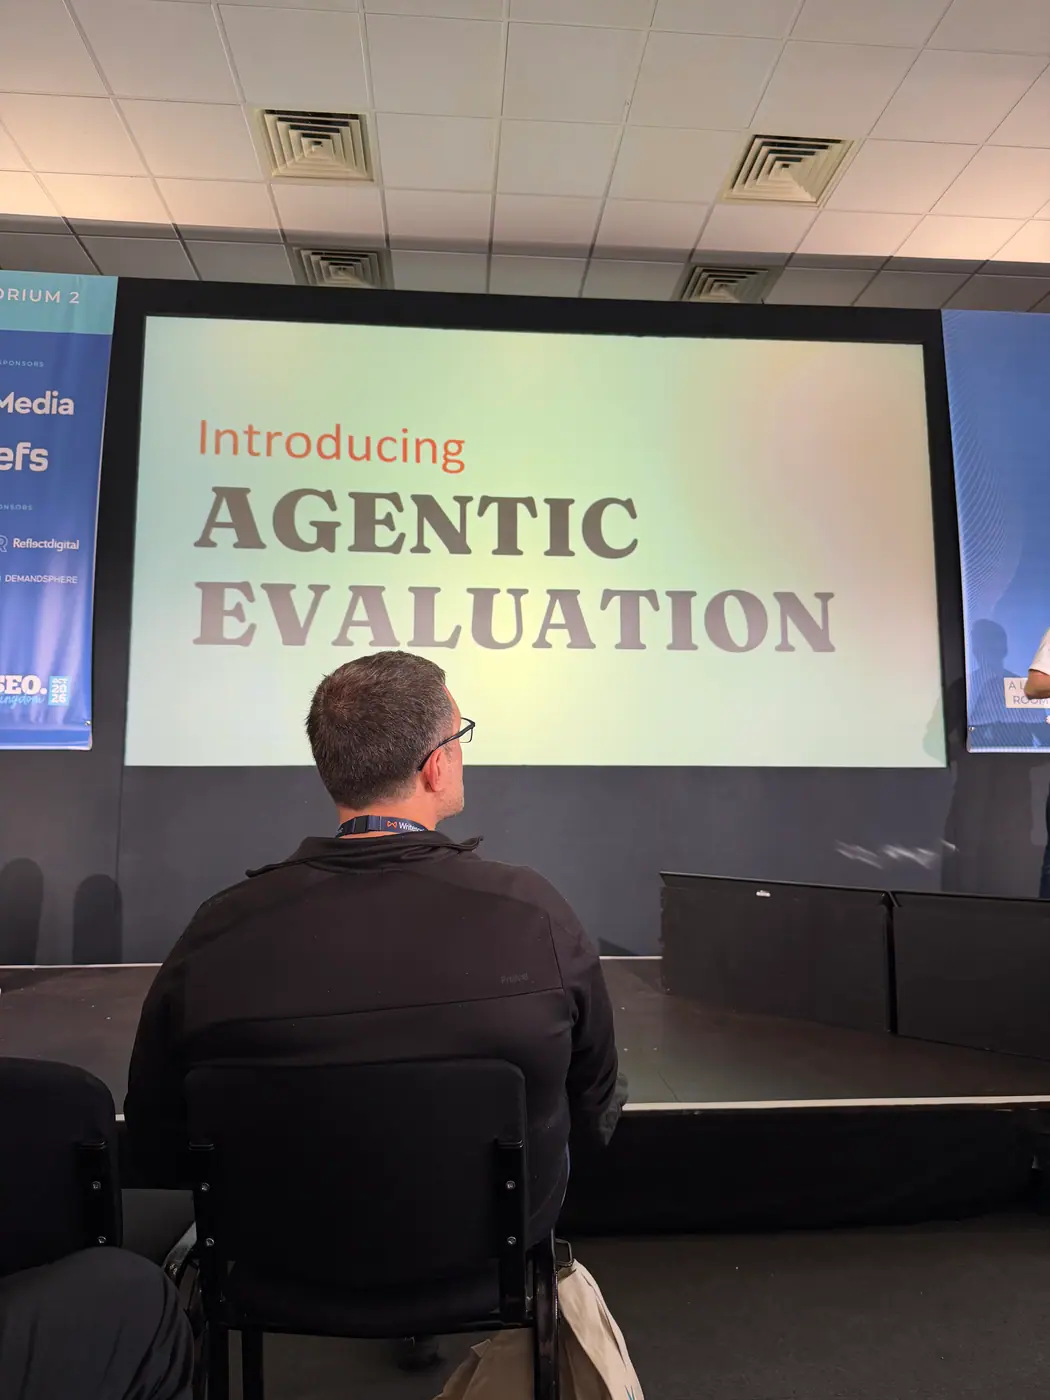
Zaproponował agentic evaluation, czyli ocenianie rezultatów pracy AI przez AI według zdefiniowanych kryteriów. Pokazał to na przykładzie analizy słów kluczowych w SEO (Search Engine Optimization / optymalizacja pod wyszukiwarki) oraz narzędzia do analizy sygnałów rynkowych. Jego główna teza: kontrolę jakości należy projektować razem z procesem, zamiast dokładać ją na końcu.
Najważniejsze wnioski
Szybsza produkcja nie oznacza łatwiejszej weryfikacji.
McDonald zauważył, że firmy często sprawdzają wyniki AI pobieżnie. Według niego zwiększanie skali pracy bez rozbudowy kontroli jakości tworzy nowe wąskie gardło.Ocena powinna odbywać się na kolejnych etapach procesu.
W przykładzie SEO osobno oceniano słowa kluczowe, dopasowanie do stron, pytania użytkowników oraz przygotowane odpowiedzi. Każdy etap miał własne kryteria.Warto automatyzować najlepszą wersję procesu, nie tylko jego obecną wersję.
Prelegent proponował najpierw zastanowić się, jak wyglądałaby analiza przy większym budżecie czasu i dostępie do dodatkowych źródeł. Dopiero później projektować automatyzację.Wyniki oceny mogą poprawiać instrukcje dla kolejnych iteracji.
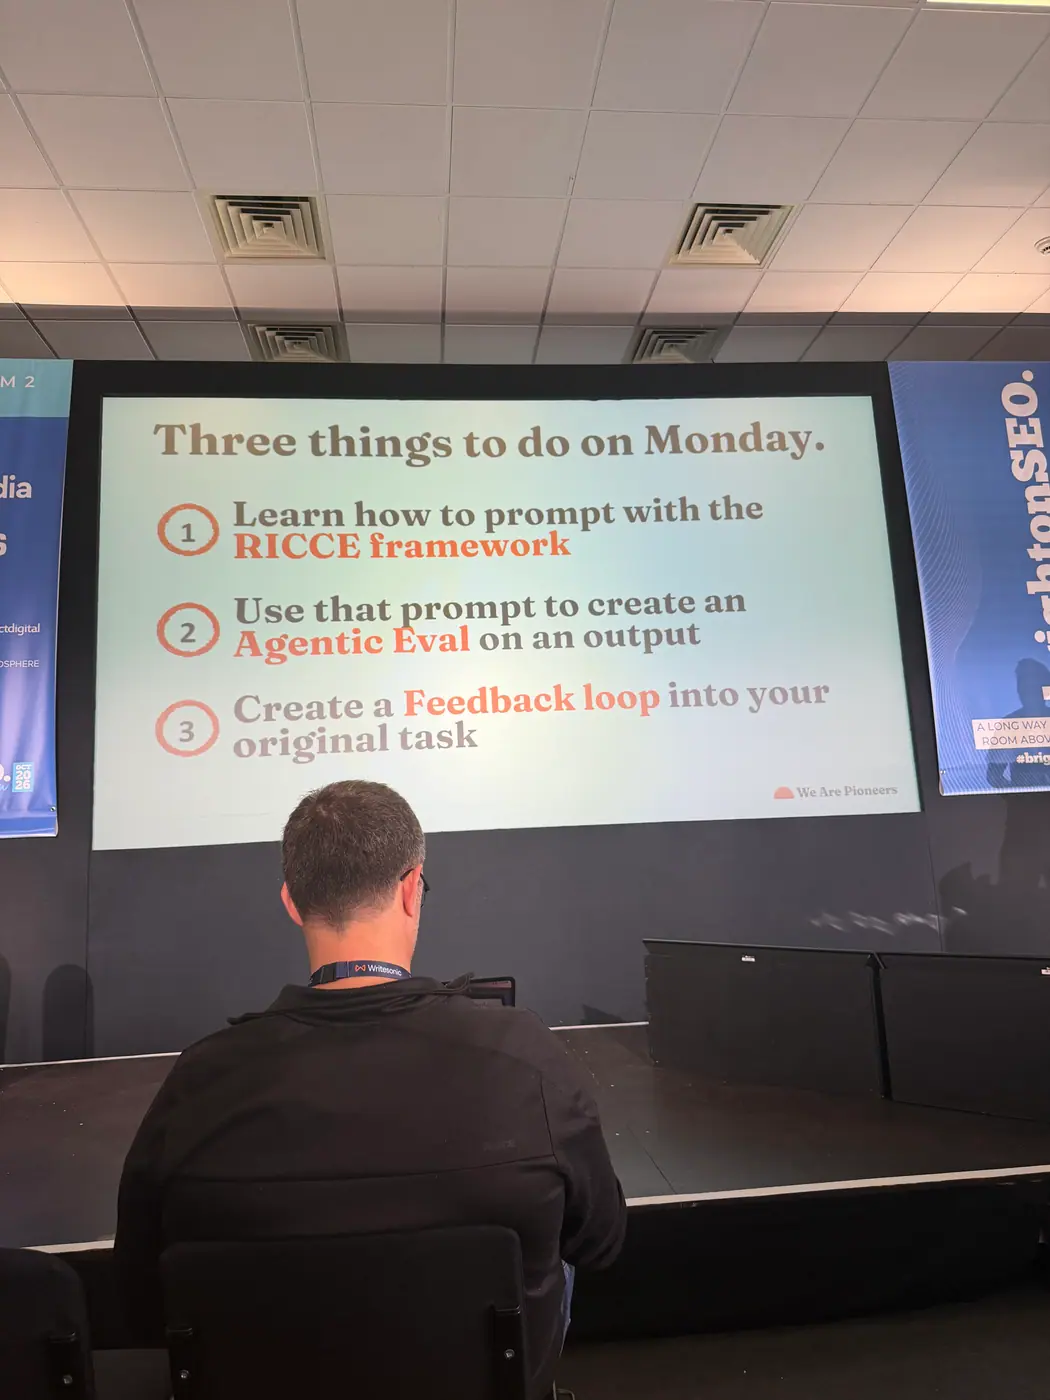
Pokazana pętla informacji zwrotnej wykorzystywała nisko ocenione rezultaty do aktualizacji briefu i promptu. Mechanizmem doskonalenia było więc przekazywanie wniosków do procesu, a nie samo ponowne generowanie odpowiedzi.Przesunięcie od wykonawcy do projektanta systemów było prognozą prelegenta.
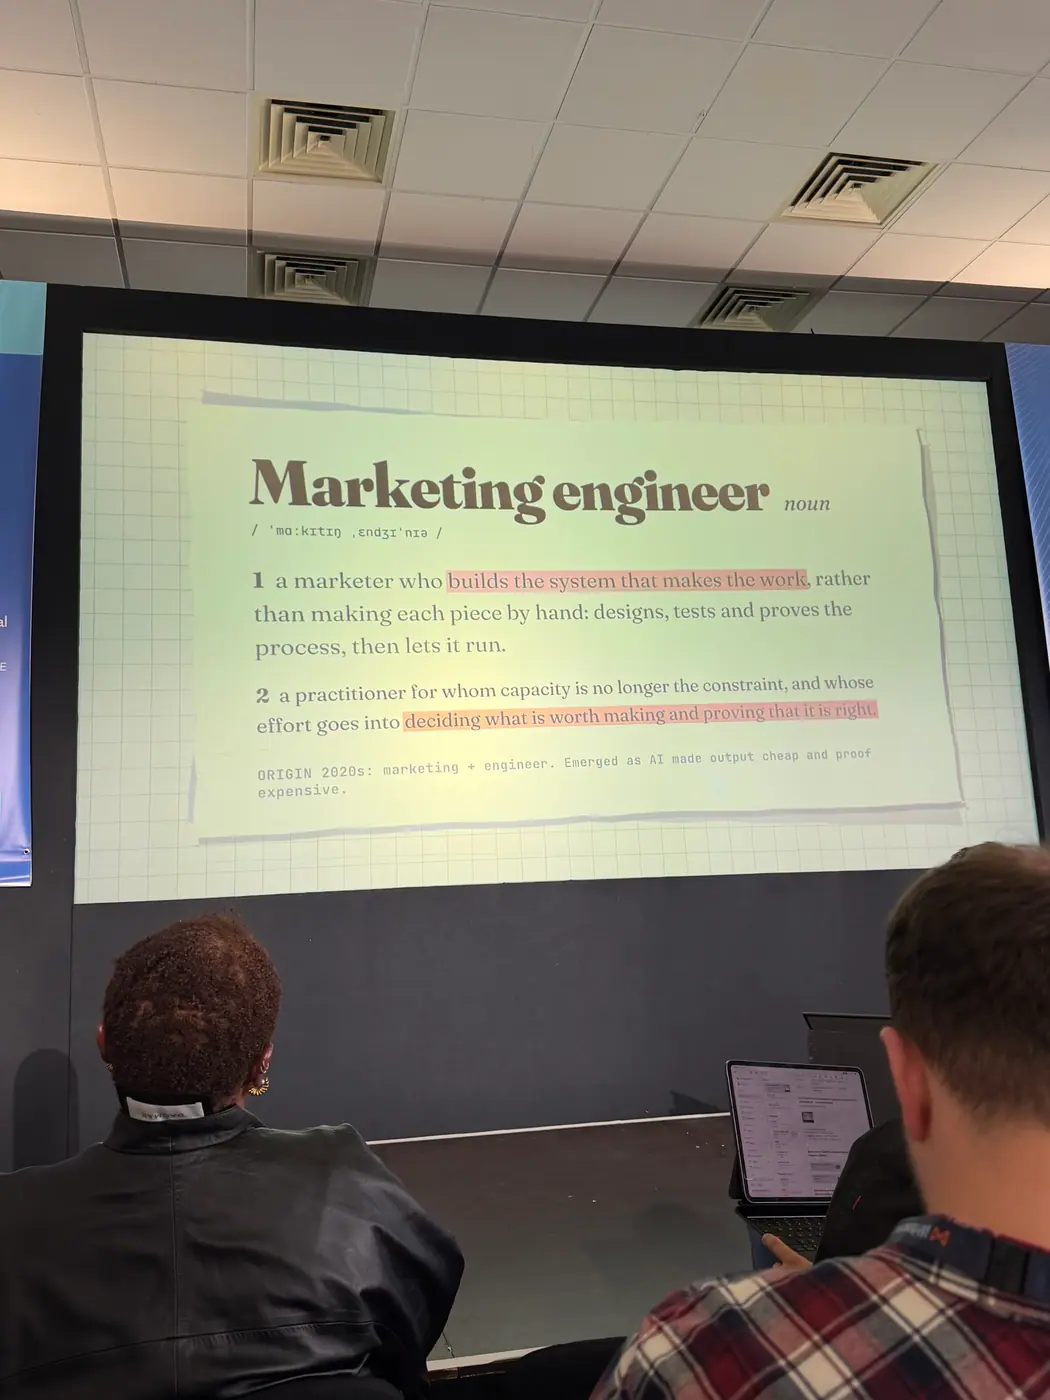
McDonald opisywał rozwój marketing engineering, czyli projektowania systemów realizujących pracę marketingową. Przekonywał, że większą wartością będzie organizowanie procesu, danych i kontroli niż samo przygotowywanie pojedynczych materiałów.
Dane liczbowe i przykłady
| Liczba | Kontekst |
|---|---|
| 5 → 1000 wyników pracy | Ilustracja wzrostu skali produkcji i związanego z nim problemu weryfikacji, nie raportowany wynik wdrożenia. |
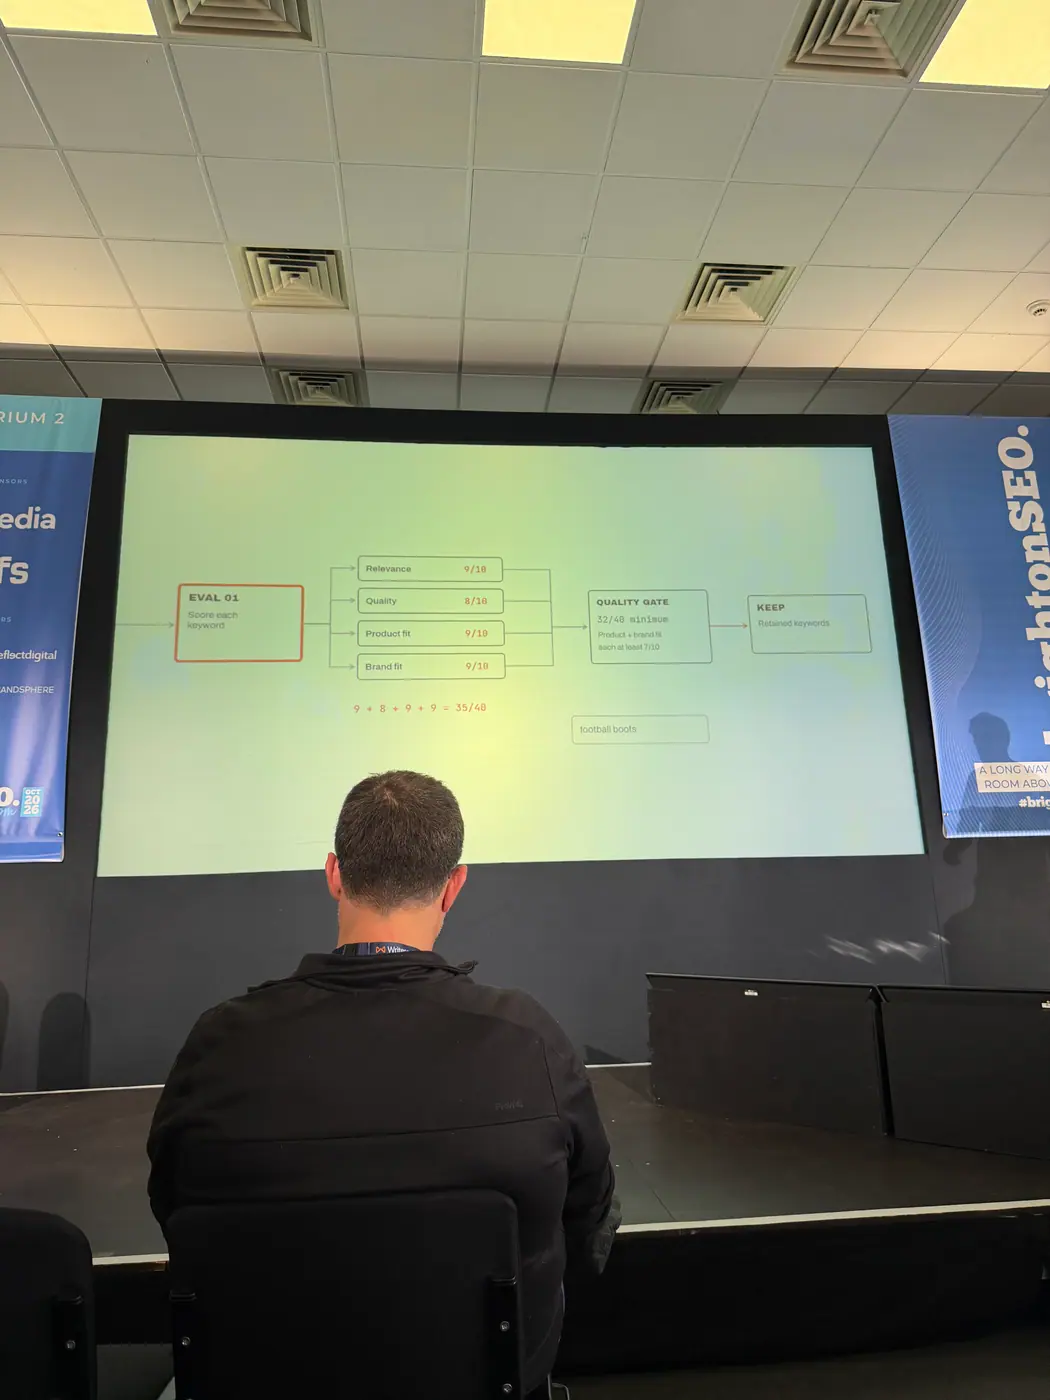
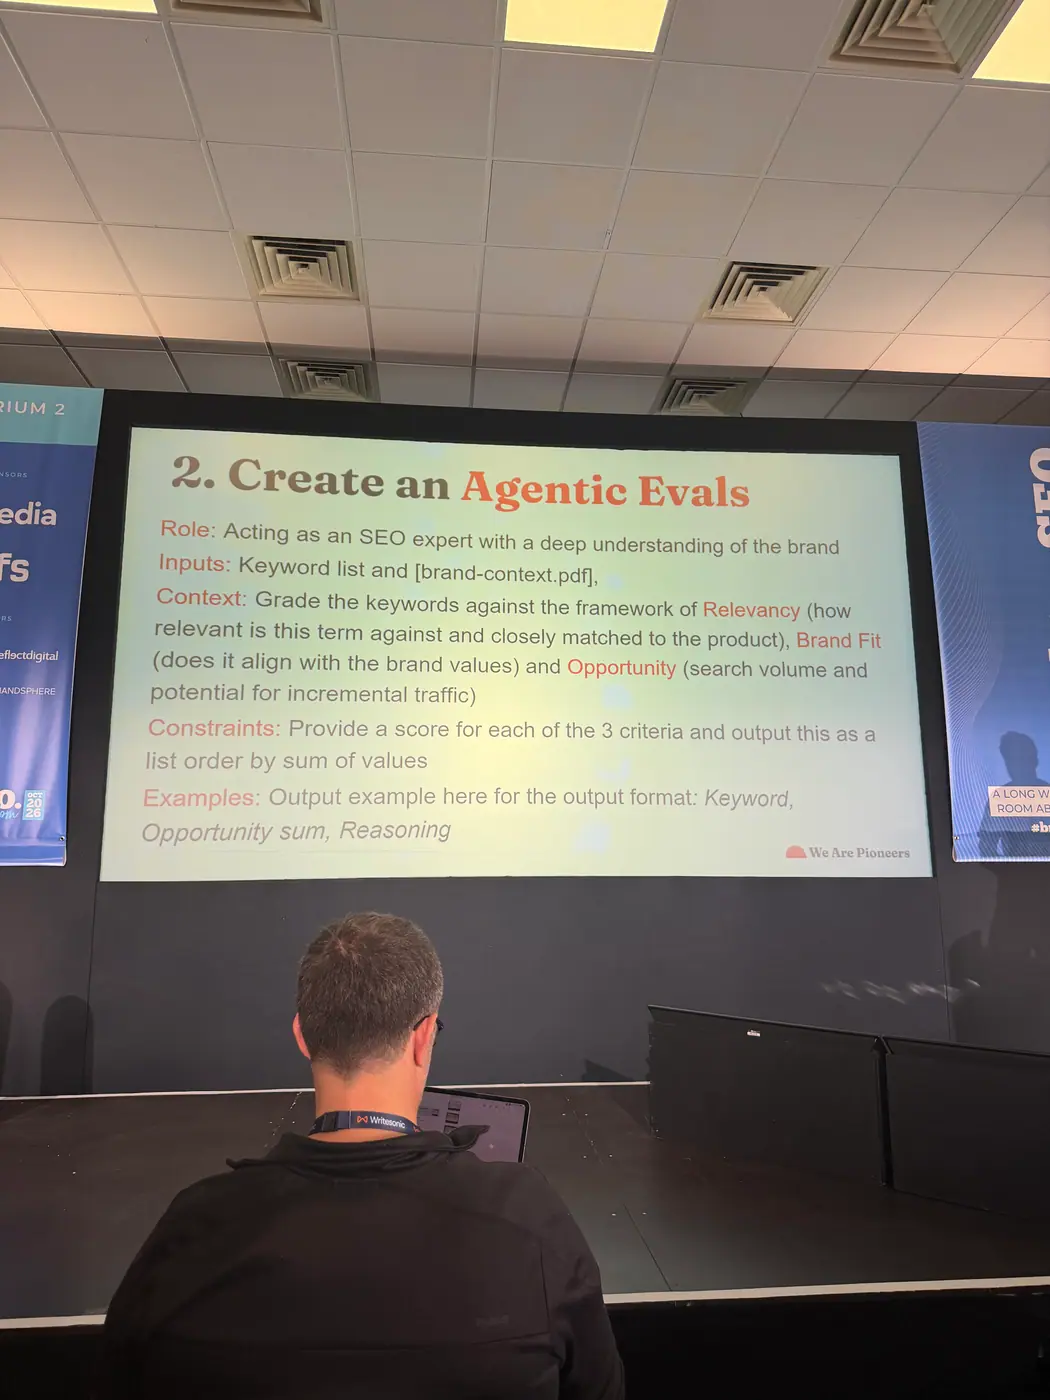
| 4 kryteria oceny słów kluczowych | Trafność, jakość, dopasowanie do produktu oraz dopasowanie do marki. |
| 61 000 sygnałów | Według prelegenta tyle analizowało opisane narzędzie badawcze. Źródła obejmowały artykuły prasowe, raporty eksperckie i wpisy społecznościowe. |
| 19 ewaluacji | Liczba ocen w całym procesie prowadzącym od briefu do koncepcji w pokazanym narzędziu. |
| Około 20 kontroli poszczególnych wyników | Tak McDonald opisał intensywność sprawdzania rezultatów w tym rozwiązaniu. |
| Tydzień pracy | Tyle wcześniej zajmował opisywany proces najlepszemu specjaliście klienta. |
Praktyczne rady
- Rozpisz proces przed wyborem narzędzia. Określ źródła danych, etapy analizy oraz warunki przejścia do kolejnego kroku.
- Dobieraj kryteria do zadania. Ocena słowa kluczowego wymaga innych pytań niż sprawdzenie, czy przypisano je do właściwej strony.
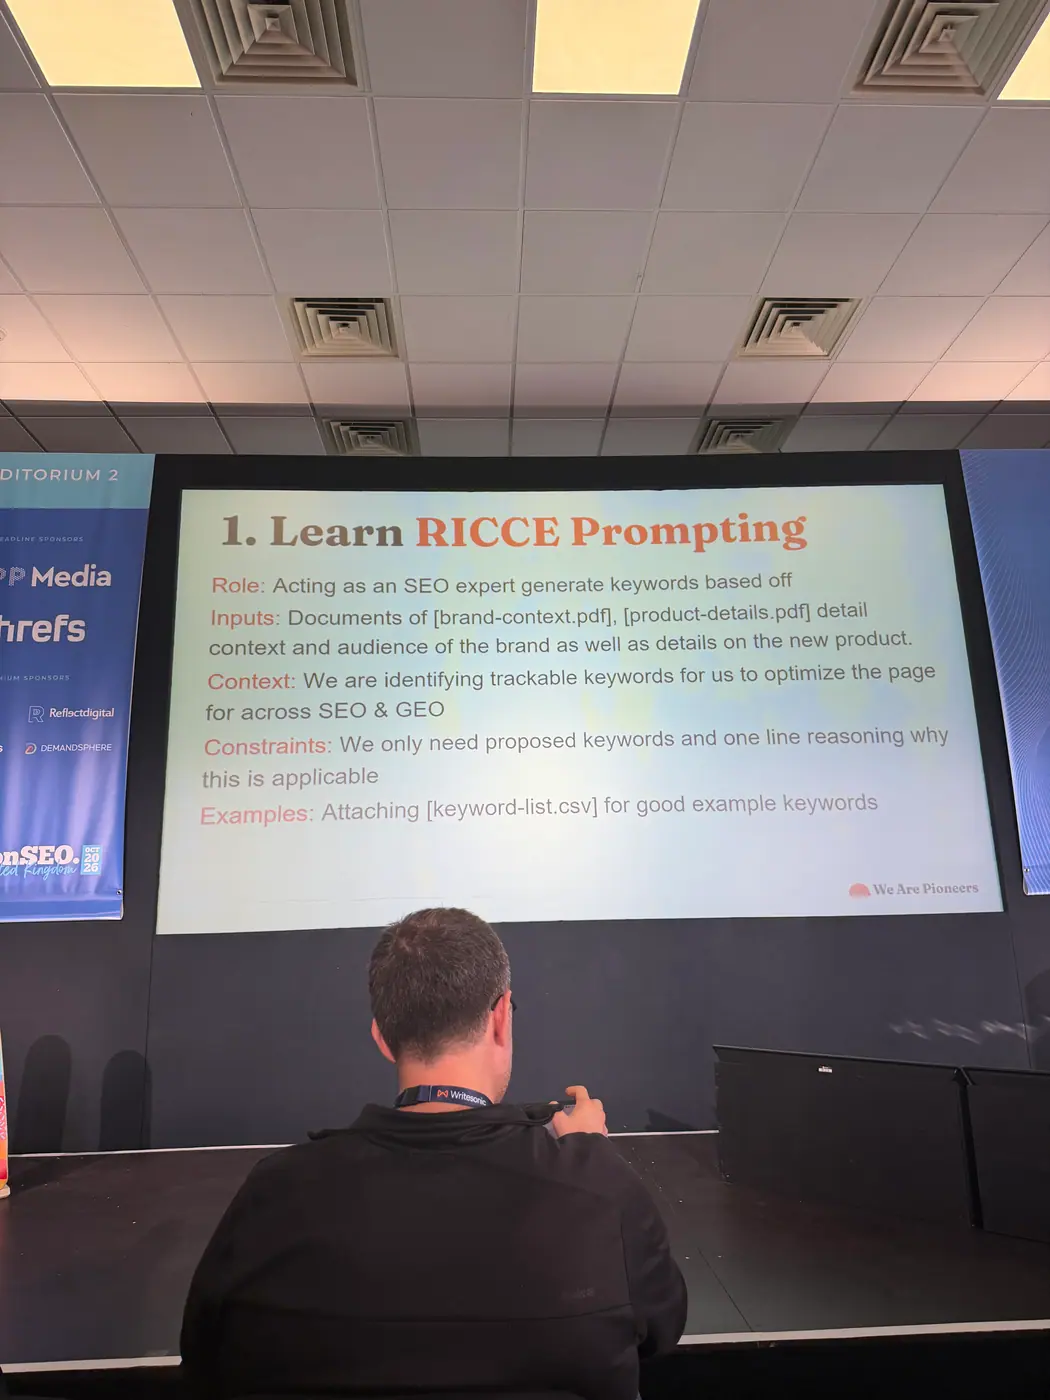
- Podawaj rolę, dane, kontekst, ograniczenia i przykłady. Schemat nazwany przez prelegenta RISE obejmował elementy: Role, Input, Context, Constraints, Examples, czyli właśnie te pięć składników instrukcji.
- Wykorzystuj słabe wyniki do poprawy briefu. Analizuj, dlaczego otrzymały niskie oceny, i przekazuj te wnioski do kolejnej iteracji.
- Zachowuj możliwość sprawdzenia źródeł. Pokazane narzędzie udostępniało odnośniki pozwalające samodzielnie przyjrzeć się materiałom. Ocena punktowa i dostęp do dowodów pełnią różne funkcje.
Knowledge bombs
1. AI przeniosło trudność z wytwarzania na testowanie – a „rzut oka” to nie jest kontrola jakości.
McDonald zauważa, że produkcja wyników stała się łatwa i szybka, ale weryfikacja robi się coraz trudniejsza, a firmy, z którymi pracuje, nie podchodzą do niej wystarczająco poważnie. Spojrzenie na output i „chyba OK” to według niego tylko glance, nie check.
„The volume of output and what you can do has got quicker and faster due to AI. But the testing part is fundamentally getting harder.”
2. Rozwiązanie: „agentic evaluation”, czyli AI ocenia AI według jawnych kryteriów.
Zamiast jednej osoby, jednego przeczytania i jednej opinii – kilkanaście–kilkadziesiąt automatycznych sprawdzeń (np. tone of voice marki, zgodność z regulacjami) na każdym kroku. Testowanie skaluje się razem z produkcją.
„The answer is a thing called agentic evaluation. What agentic evaluation means is you use AI to grade AI.”
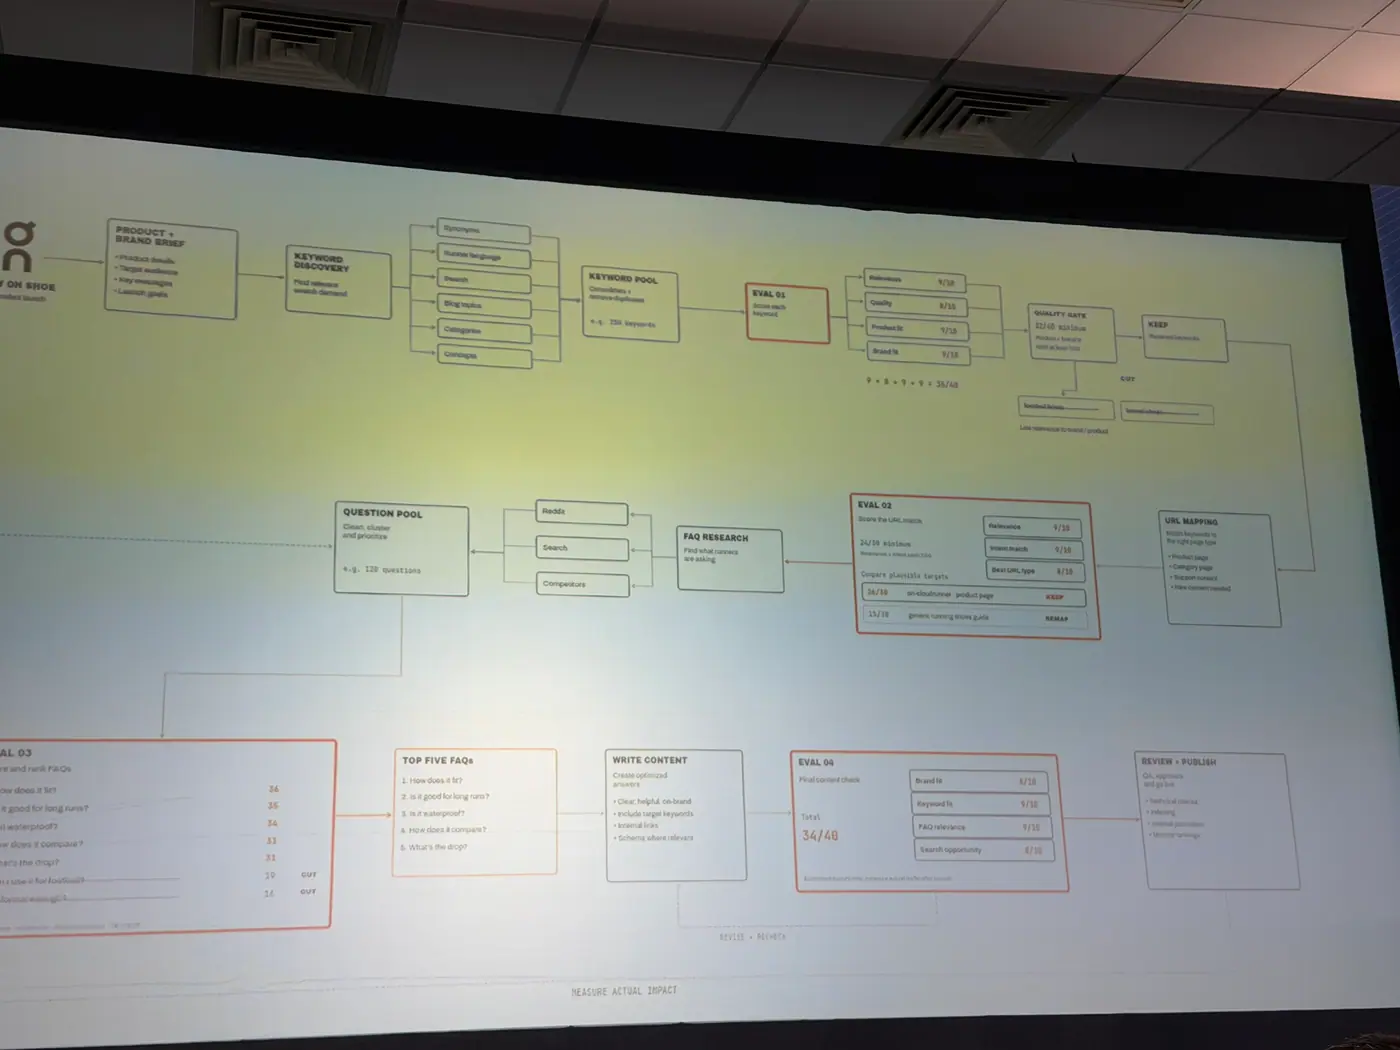
3. Keyword research jako pipeline z „quality gates” na każdym etapie.
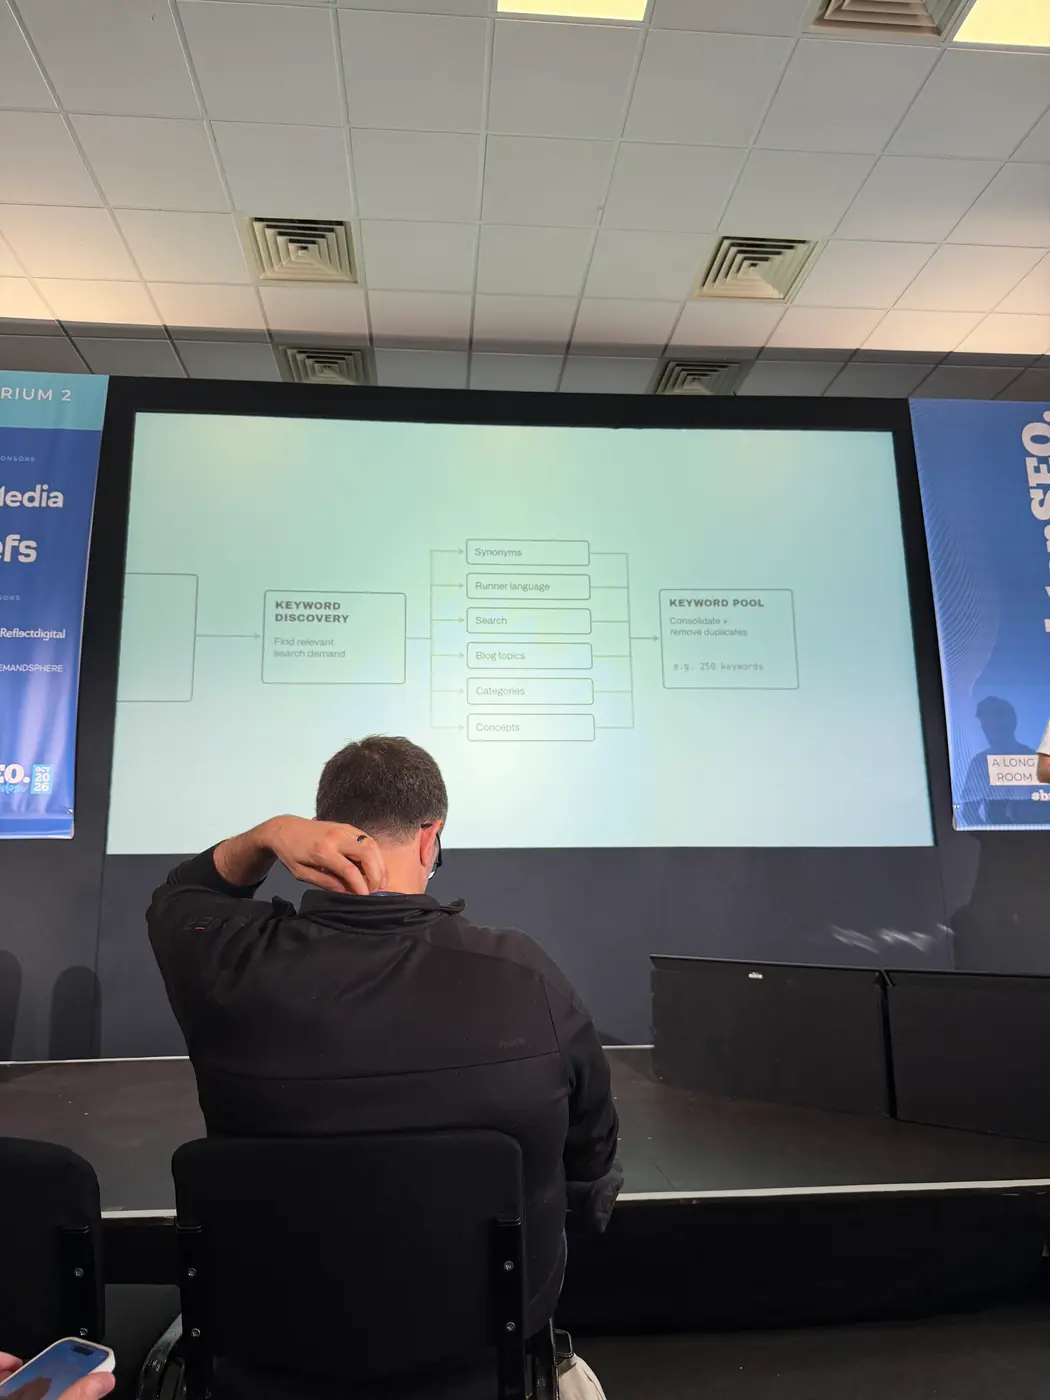
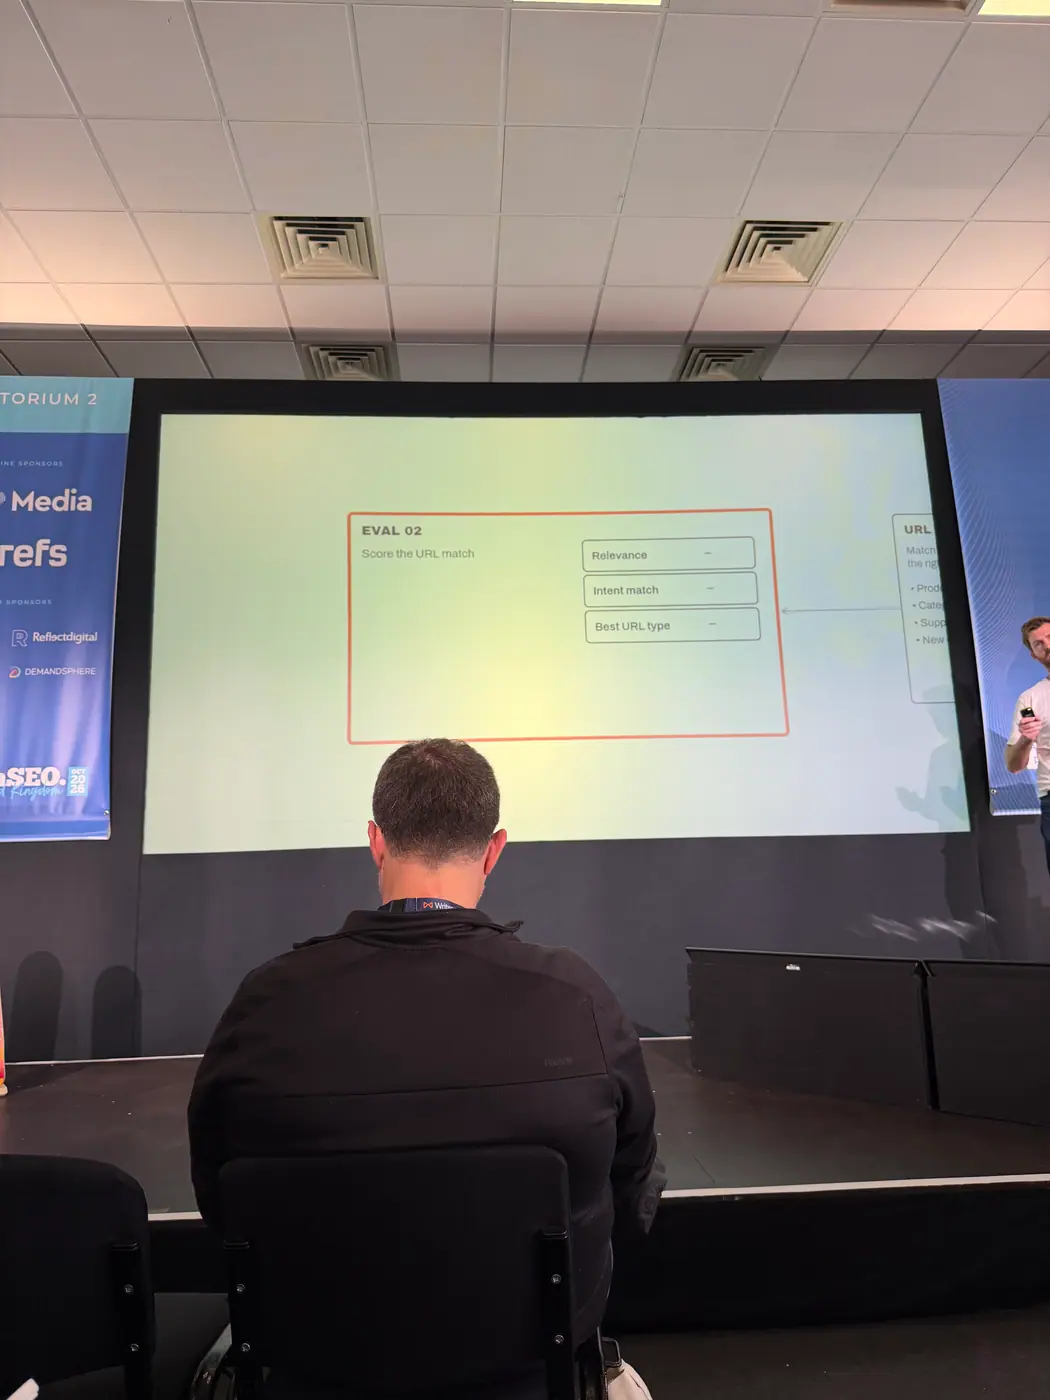
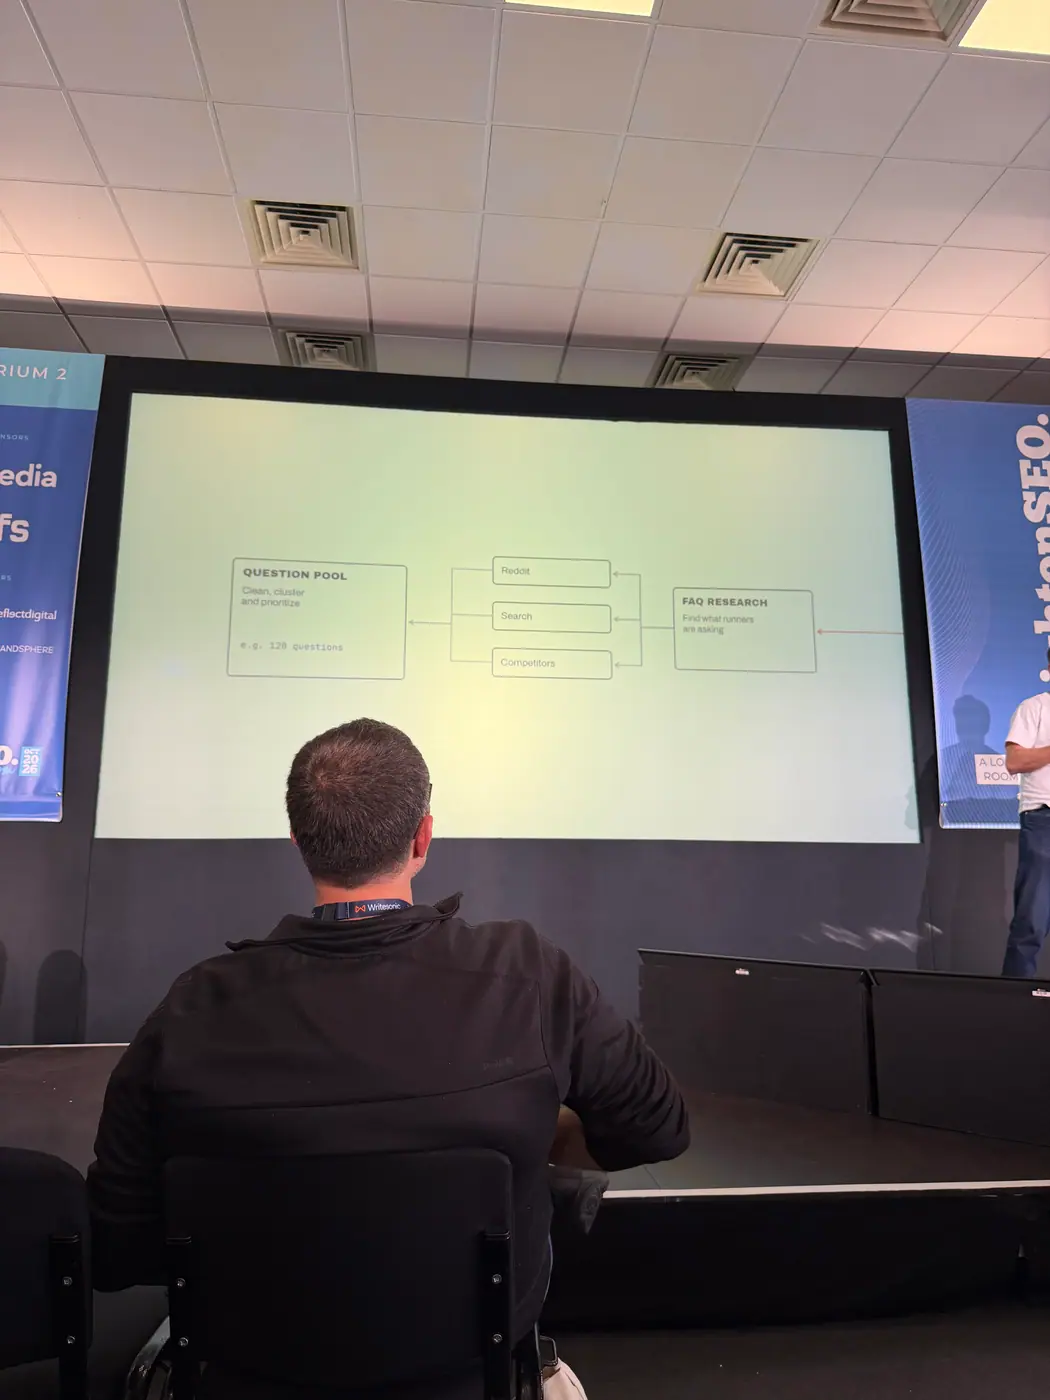
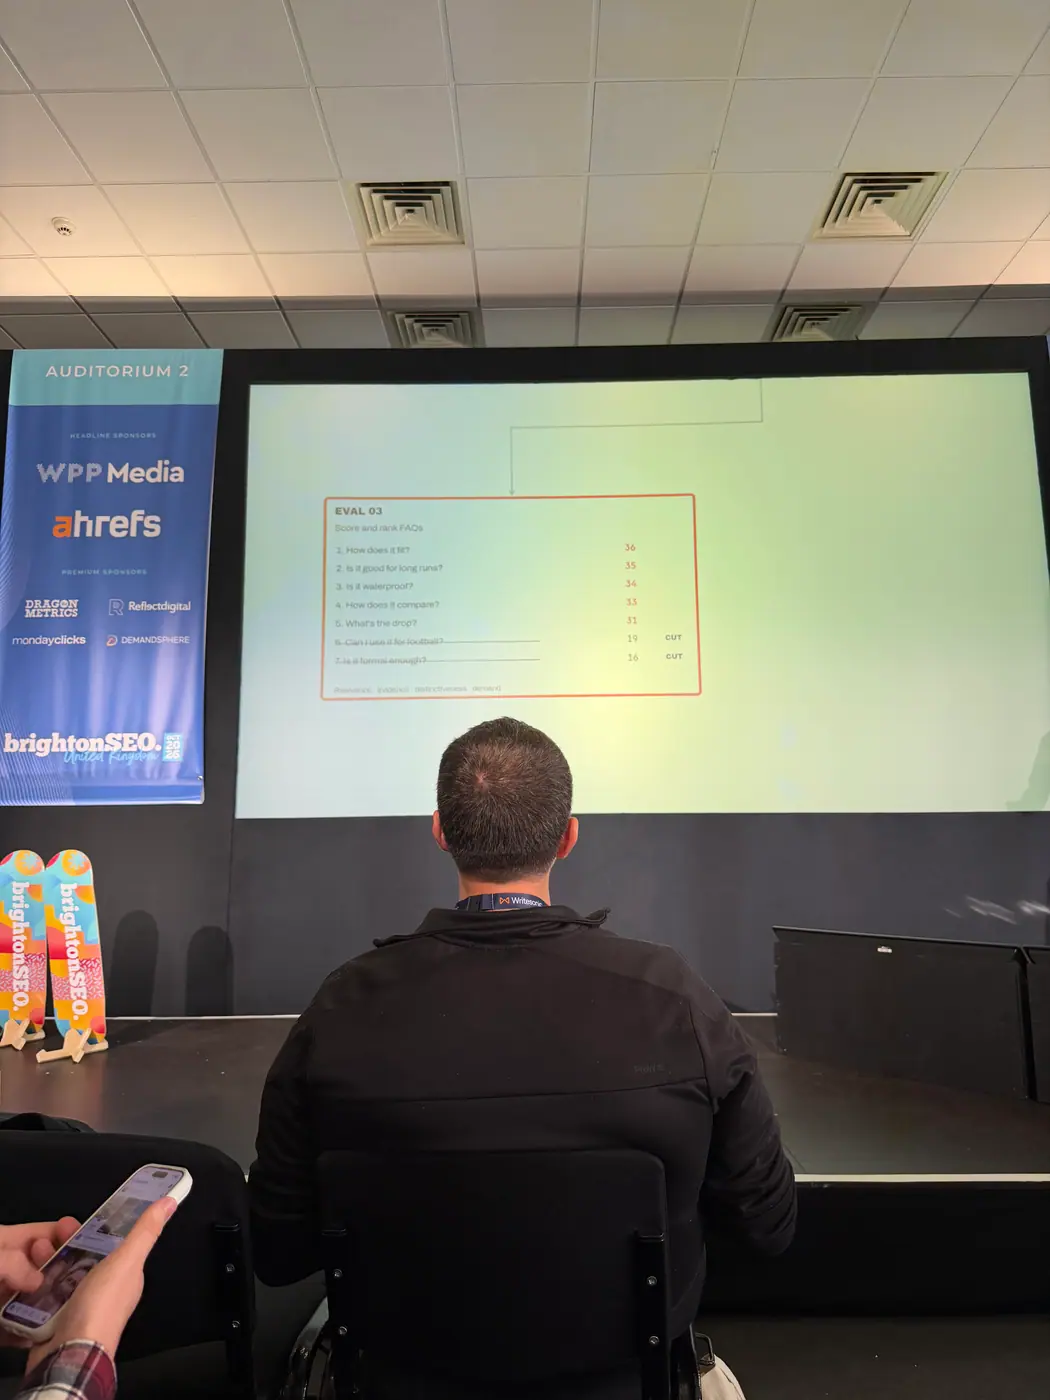
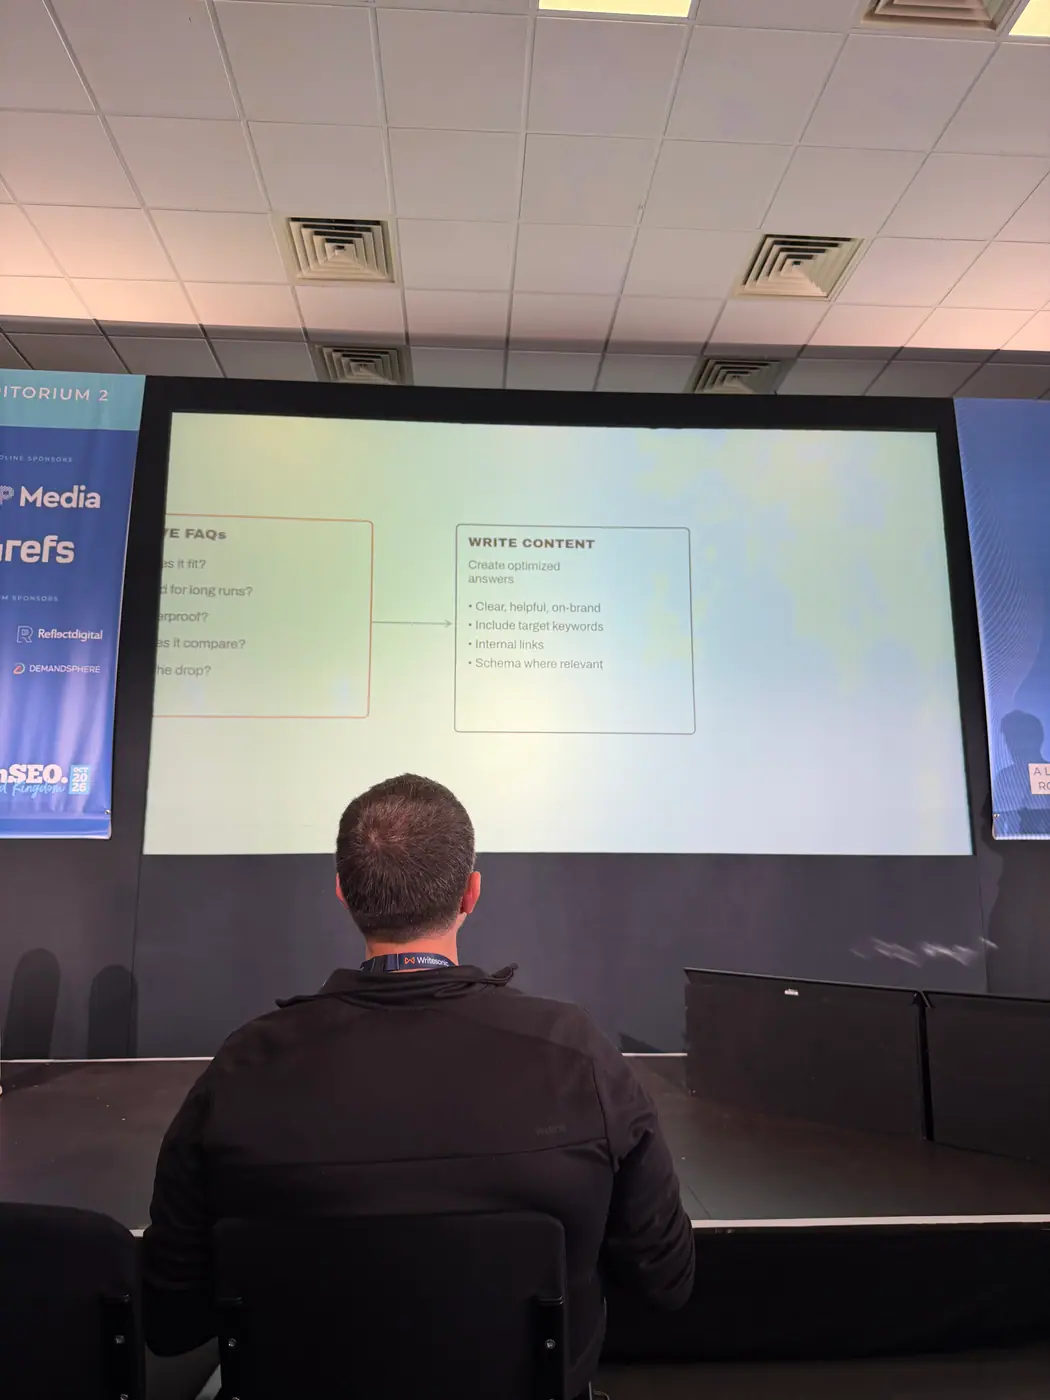
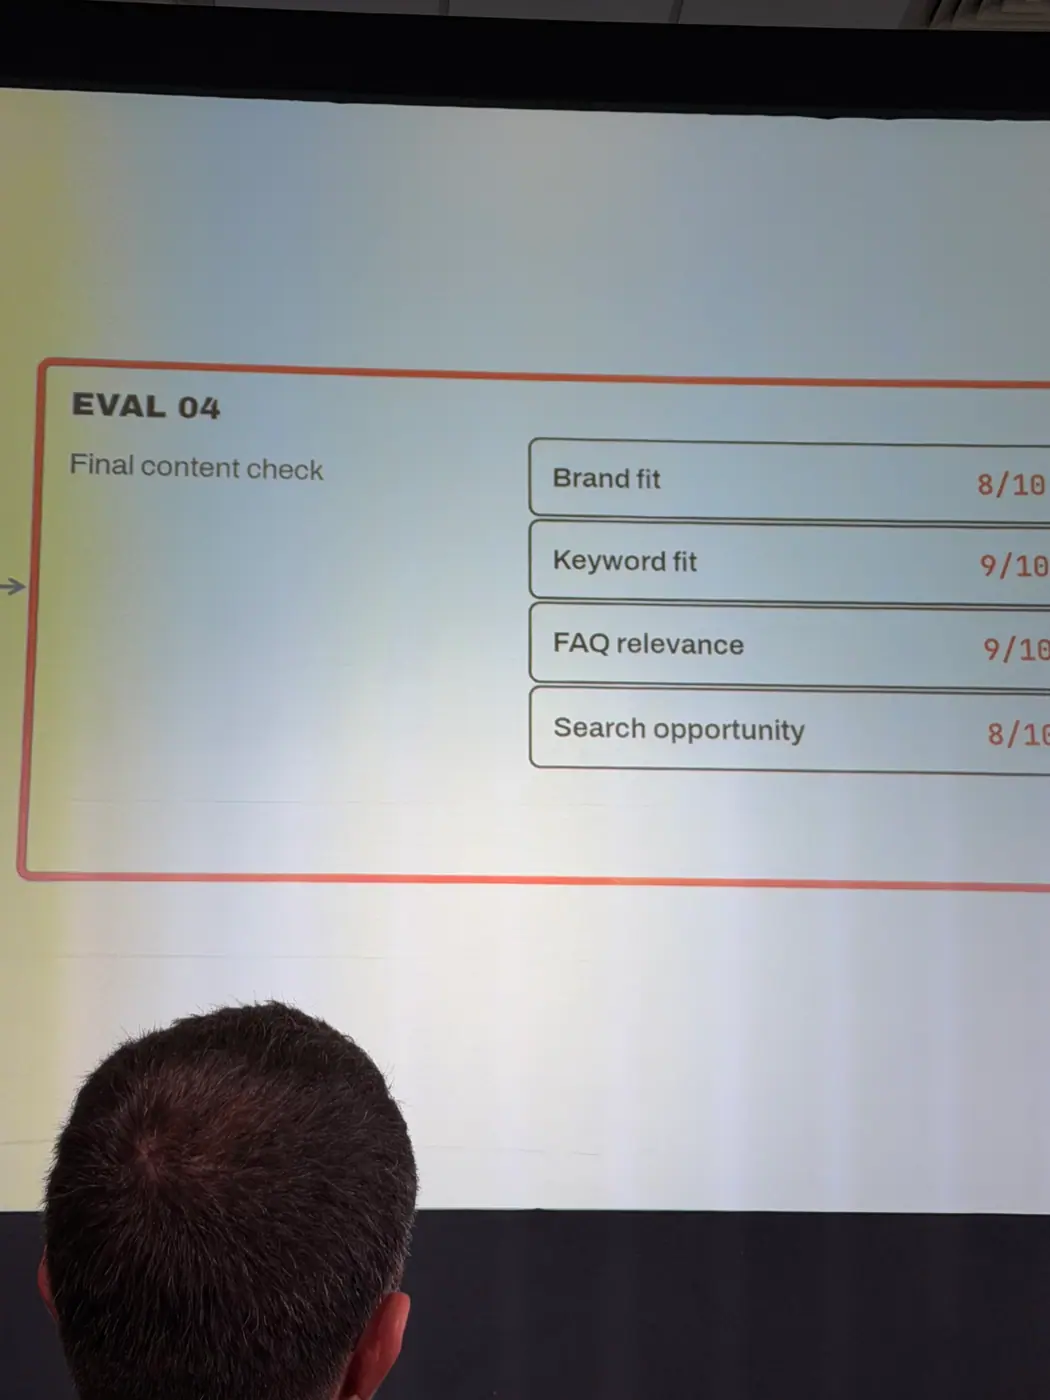
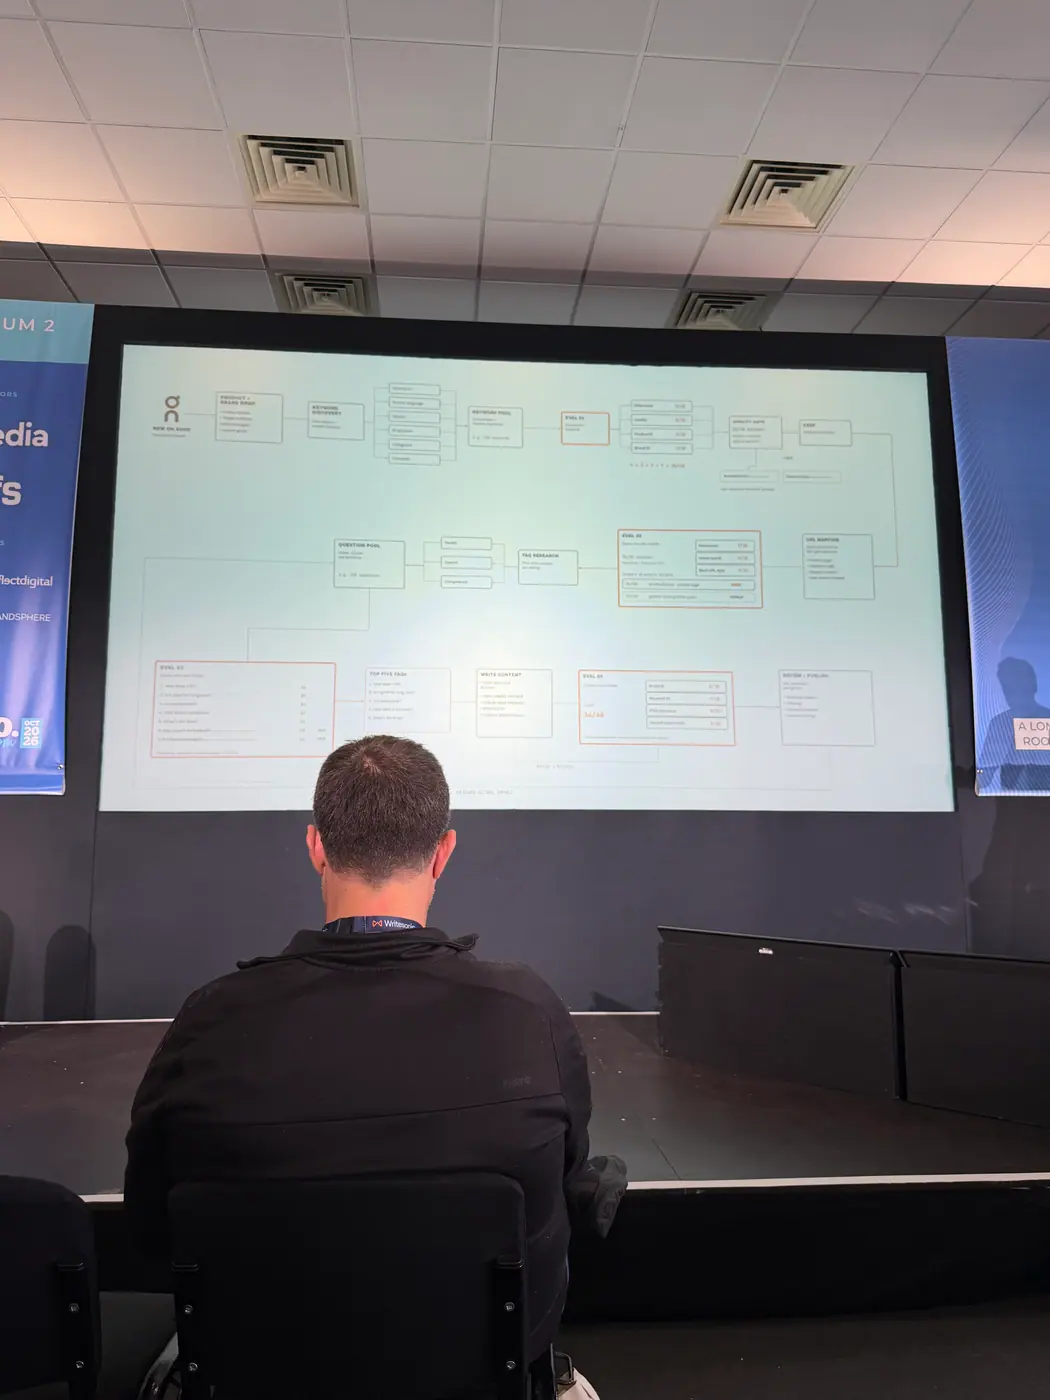
Jego przykład dla marki sportowej: pula słów → ocena w 4 kryteriach (trafność, jakość, dopasowanie do produktu, dopasowanie do marki) → odrzucenie słabych → mapowanie na URL-e (z osobną ewaluacją: trafność, zgodność intencji, czy to najlepszy URL) → pula pytań z Reddita i opinii klientów → FAQ, znów oceniane osobnym evalem. Każdy krok ma własną bramkę jakości, a nie tylko końcową kontrolę.
„It scores it based on four very detailed criteria. How relevant is it? What is the quality of it? What is the product fit? And what is the brand fit?”
4. Projektuj proces tak, jakbyś miał tydzień i nieograniczone źródła – nie tak, jak robisz go dziś.
Błąd większości: AI ma robić „ten sam audyt, tylko szybciej i taniej”. McDonald zaczyna od pytania, jak wyglądałby najlepszy możliwy proces bez ograniczeń czasu (sentyment z Reddita, dane produktowe, raporty branżowe), i dopiero to automatyzuje.
„But instead of me thinking about how I’ll do keyword research, I think if I had a week, how would I do keyword research?”
5. Pętla zwrotna: wyniki evali poprawiają prompt źródłowy, a skill „uczy się sam”.
Trzeci krok jego metody: osobny prompt („jako AI solution architect”) analizuje nisko ocenione pozycje i generuje wnioski, które wracają do pierwotnego briefu/promptu. Zbudowane jako skill – iteracyjnie się poprawia.
„Then, look at low scoring ones to create a feedback loop that I can feed into the original brief that provides learnings.”
6. Szablon promptu dla generatora i dla ewaluatora: Role, Input, Context, Constraints, Examples.
Ten sam framework (prelegent nazywa go „RISE”, choć wymienia pięć elementów) stosuje i do promptu generującego słowa kluczowe, i do promptu oceniającego je (trafność, brand fit, opportunity, punktacja wg trzech kryteriów). W „Context” wprost wpisuje, że słowa mają być pod AEO i SEO, a w „Examples” – historyczne listy słów z własnych projektów.
„It stands for Role, Input, Context, Constraints, and Examples.”
7. Case: 61 tys. sygnałów, 19 evali end-to-end, każdy output sprawdzany ok. 20 razy.
Narzędzie dla firmy insightowej (badanie, jak przyciągnąć młodsze pokolenia do sieci restauracji) analizuje ok. 61 tys. sygnałów (artykuły prasowe, white papers, posty), a proces, który zajmował najlepszej osobie tydzień, działa w skali niewykonalnej dla człowieka. Front-end wygląda jak zwykła strona – cała logika i walidacja dzieje się w tle.
„When you look back, there’s 19 evals that run to do that end-to-end.”
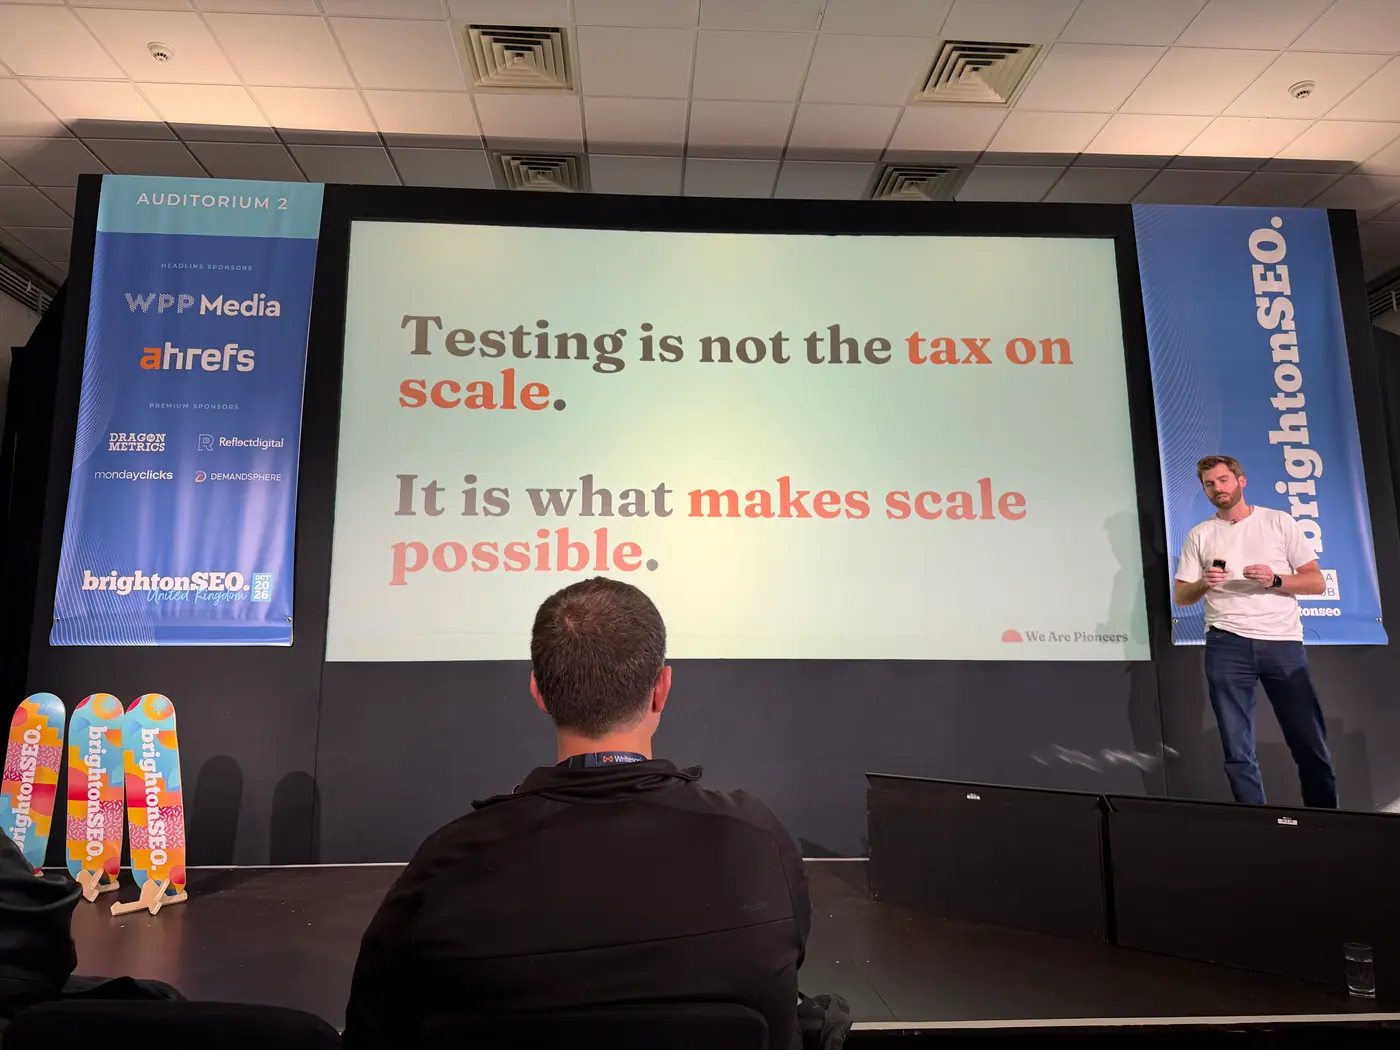
8. Testowanie to nie „podatek od skali”, tylko warunek skali.
Puenta całej prelekcji, z analogią do NASA (Artemis 1 bez załogi, 3000 czujników, osobny ośrodek weryfikacji z 275 pracownikami, którzy niczego nie produkują): znajdowanie błędów to sukces procesu.
„Fundamentally, testing is not the tax on scale. It’s what makes scale possible.”
Zdjęcia: Jeremy McDonald
38 kadrów · Fot. Robert Nowaczyk
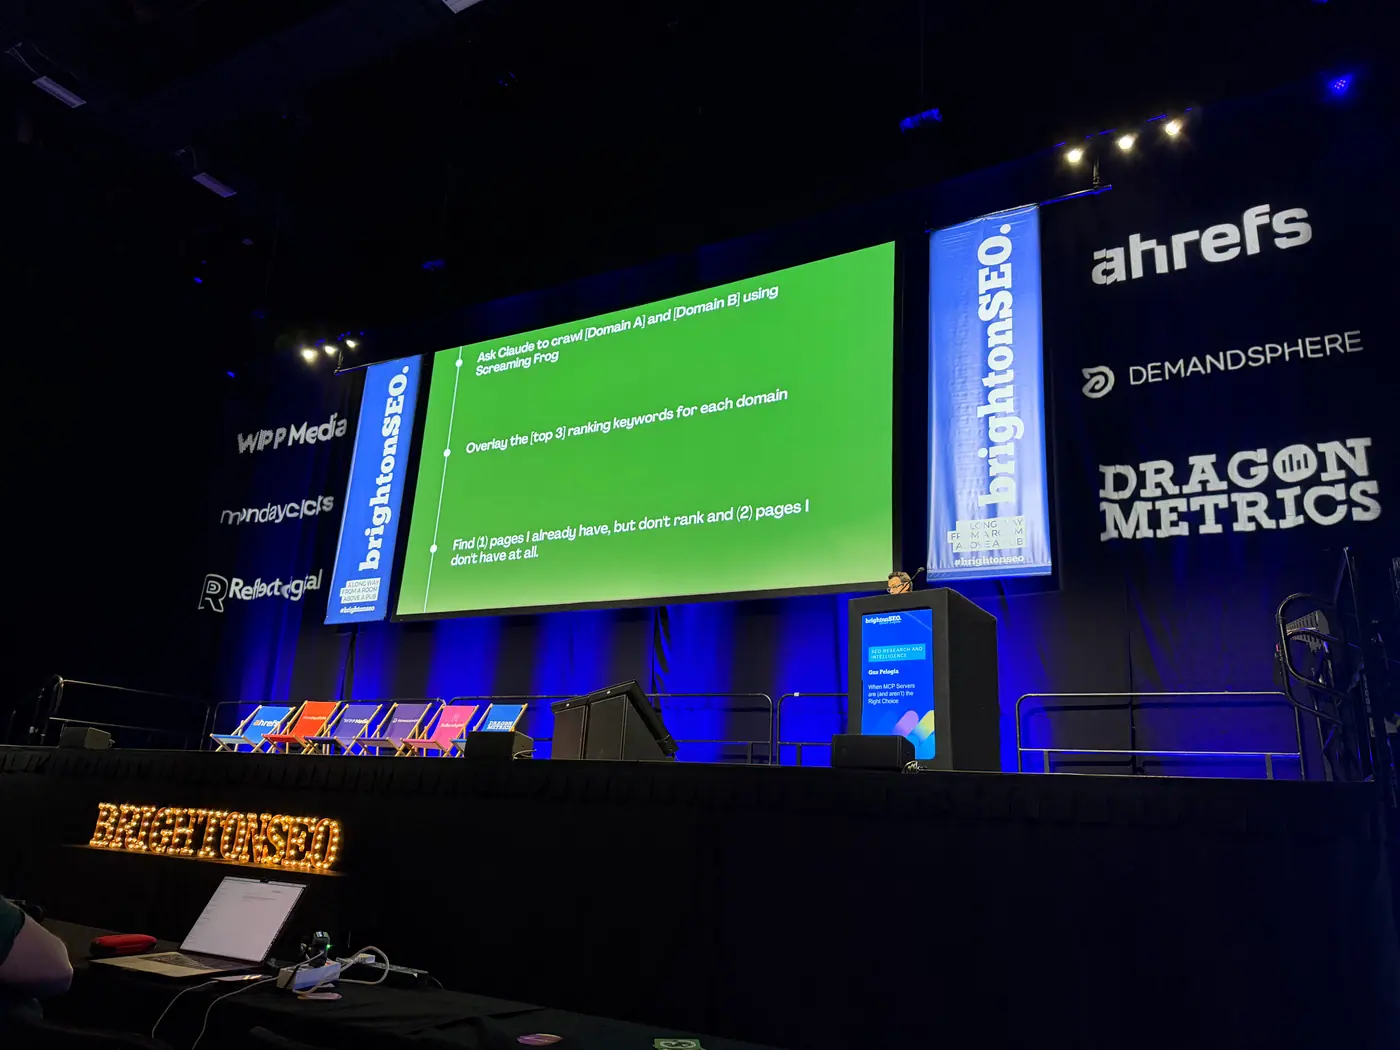
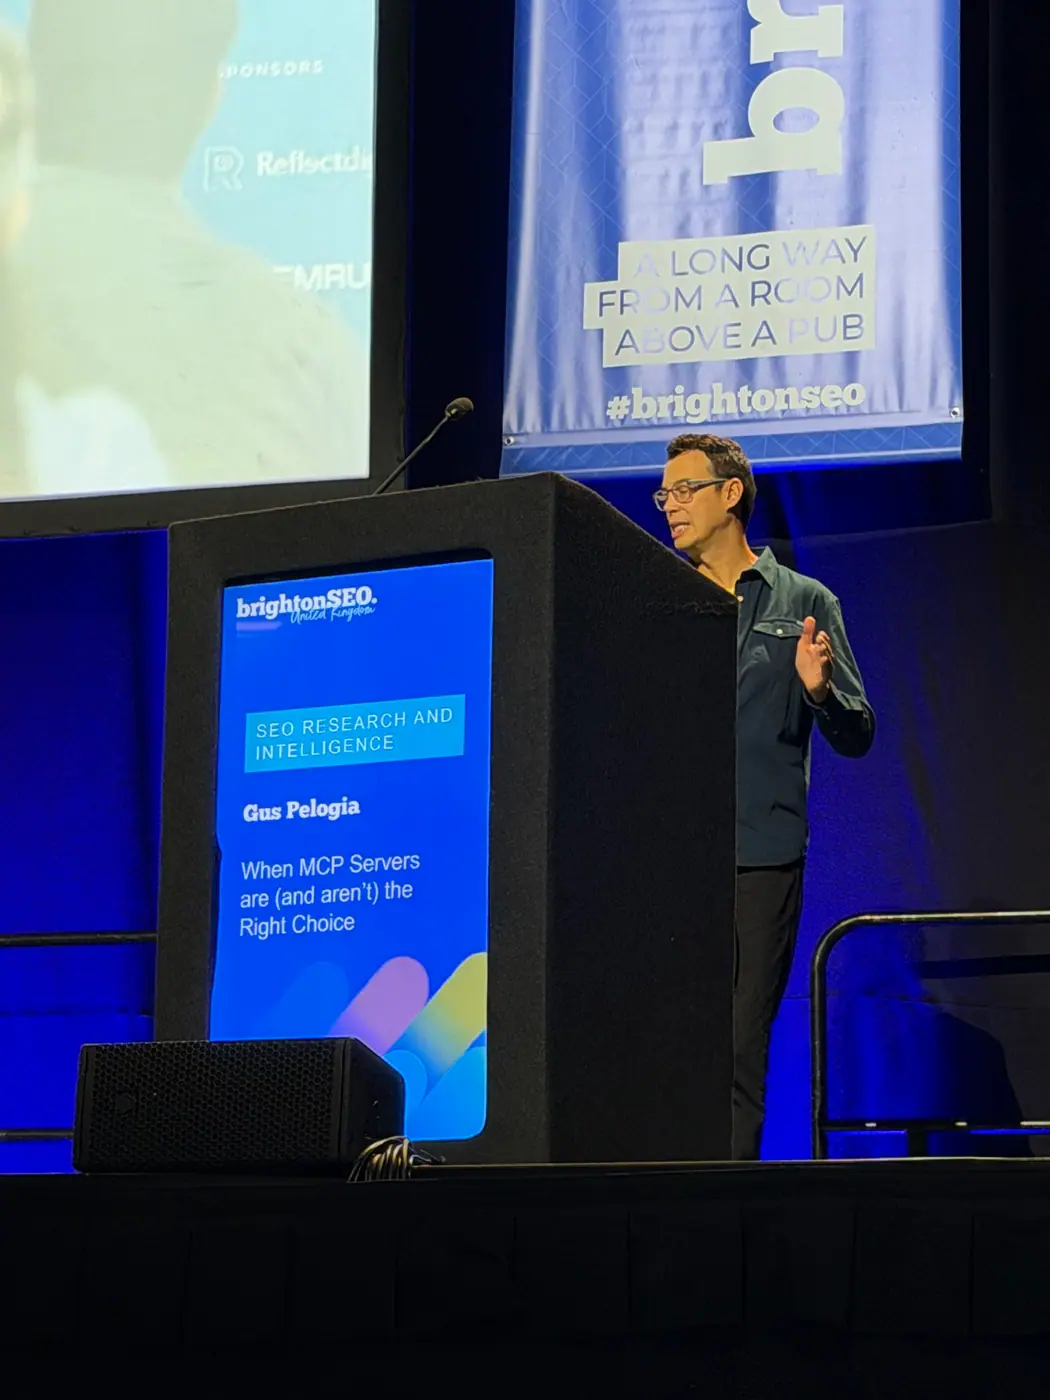
Gus Pelogia: When MCP Servers are (and aren’t) the Right Choice
14:20 · Auditorium 1
Nagranie zaczyna się w połowie prelekcji; podsumowanie obejmuje drugą część.
Streszczenie
Gus Pelogia przedstawił trzy zadania SEO (Search Engine Optimization / optymalizacja pod kątem wyszukiwarek), w których sprawdzał przydatność MCP (Model Context Protocol / protokół kontekstu modelu): priorytetyzację audytu, porównywanie treści z odpowiedziami AI (Artificial Intelligence / sztuczna inteligencja) oraz analizę luk w treściach.
Najważniejszy wniosek: możliwość wykonania zadania przez MCP nie oznacza, że jest to najlepszy sposób jego realizacji. W pokazanych przykładach znaczenie miały czas wykonania, możliwość połączenia różnych źródeł danych oraz zakres operacji udostępnionych przez serwer.
Najważniejsze wnioski
Priorytety audytu można wyznaczać na podstawie widoczności stron.
Prelegent połączył wyniki skanowania witryny z frazami zajmującymi pozycje 3–30. Następnie ograniczył raport do wskazówek dotyczących stron widocznych na te frazy. Była to selekcja zakresu pracy, nie usunięcie problemów.W analizie embeddingów MCP okazało się mniej praktyczne niż skrypt.
Embeddingi to wektorowe reprezentacje treści, które pozwalają porównywać ich podobieństwo. Pelogia ocenił, że w jego przykładzie realizacja zadania przez MCP trwała zbyt długo. Zaproponował wykorzystanie Screaming Frog do pozyskania embeddingów i Google Colab do ich porównania.Luka w rankingach nie musi oznaczać brakującej strony.
Prelegent połączył analizę widoczności dwóch domen z informacjami o opublikowanych stronach. Dzięki temu sprawdzał nie tylko, na jakie frazy witryna nie była widoczna, ale także, czy odpowiednie treści już istniały.Podobieństwo treści może wspierać diagnozę, ale nie jest receptą na ranking.
Pelogia zaproponował porównywanie własnych stron z wynikami organicznymi i AI Overviews, czyli przeglądami generowanymi przez AI. Widział w tym pomoc przy ocenie dopasowania strony do tematu, nie docelowy wynik, który gwarantowałby widoczność.Zakres automatyzacji zależy od konkretnego serwera.
W przedstawionym przykładzie Sitebulb udostępniał przez MCP wyłącznie odczyt danych. Skanowanie trzeba było uruchomić w interfejsie narzędzia, a dopiero później można było analizować wyniki przez rozmowę z asystentem.
Dane liczbowe i przykłady
- Pozycje 3–30: zakres fraz wybranych do priorytetyzacji audytu, z uwzględnieniem konkretnego kraju.
- 74 → 48 wskazówek: wynik filtrowania raportu. To o 26 mniej, czyli około 35%, ale nie redukcja liczby problemów w witrynie.
- Ponad 20 minut wobec około 2 minut: czas próby z MCP i wcześniejszego wykonania analizy skryptem. Przykład obejmował pobranie treści z 10 stron.
- Około pół godziny pracy: przygotowanie wstępnej analizy luk wraz z propozycjami hubów tematycznych, liczbą fraz i stron do utworzenia.
- 0,8–0,9: wartości przywołane jako przykłady wysokiego podobieństwa wektorowego, nie jako progi wymagane do uzyskania widoczności.
Praktyczne rady
- Łącz dane rankingowe z audytem, aby ustalać kolejność pracy nad stronami, zamiast traktować cały raport jednakowo.
- Przed wyborem MCP sprawdź zarówno dostępne operacje, jak i czas wykonania zadania w porównaniu ze skryptem.
- Zanim zlecisz nowy tekst na podstawie luki w widoczności, zweryfikuj opublikowane strony.
- Propozycje hubów i wyniki podobieństwa traktuj jako materiał do oceny specjalisty, nie gotową strategię ani cel optymalizacji.
Knowledge bombs
1. Połącz crawl z rankingami przez MCP i naprawiaj tylko błędy stron z frazami w „striking distance”.
Workflow: crawl w Sitebulb/Screaming Frog + narzędzie do rankingów → wyciągnij frazy na pozycjach 3–30 w danym kraju i strony, które na nie rankują → przefiltruj hinty crawlera tylko do tych URL-i. Na jego przykładowej stronie lista spadła z 74 do 48 hintów – od razu wiadomo, od czego zacząć.
„So, I went for this website from 74 hints, it’s a big list, to 48, so, you know, you cut maybe a third of the issues there, and maybe you still want to fix all, that’s fine, but you know where to start, where the pain is the biggest one,”
2. MCP Sitebulb jest tylko do odczytu – crawl trzeba odpalić w interfejsie.
Praktyczny detal: MCP jest we wszystkich planach Sitebulb i w płatnej licencji Screaming Frog, ale w Sitebulb serwer jest read-only, więc crawl startujesz ręcznie w narzędziu, a dopiero potem odpytujesz wyniki w rozmowie z Claude.
„And SiteBulb, this is the only, only case in all the stuff that you’re actually going to need to go to the tools UI, because they built their MCP server to be read-only.”
3. Nie wklejaj klucza API do Claude – trzymaj go poza modelem.
Przy pobieraniu embeddingów z Gemini Pelogia trzyma klucz API w osobnym pliku konfiguracyjnym (nazwy nie da się pewnie odczytać z nagrania), dzięki czemu Claude używa go tylko na czas zapytania i nie „widzi” samego klucza. Chroni to przed wyciekiem klucza i cudzymi rachunkami.
„so here you’re not giving cloud your API key directly, but it’s stored somewhere else, they can only access for the talk, for the request, but they don’t have the actual key.”
4. Cosine similarity jako argument w sporze z klientem o „tę stronę produktową na tę frazę”.
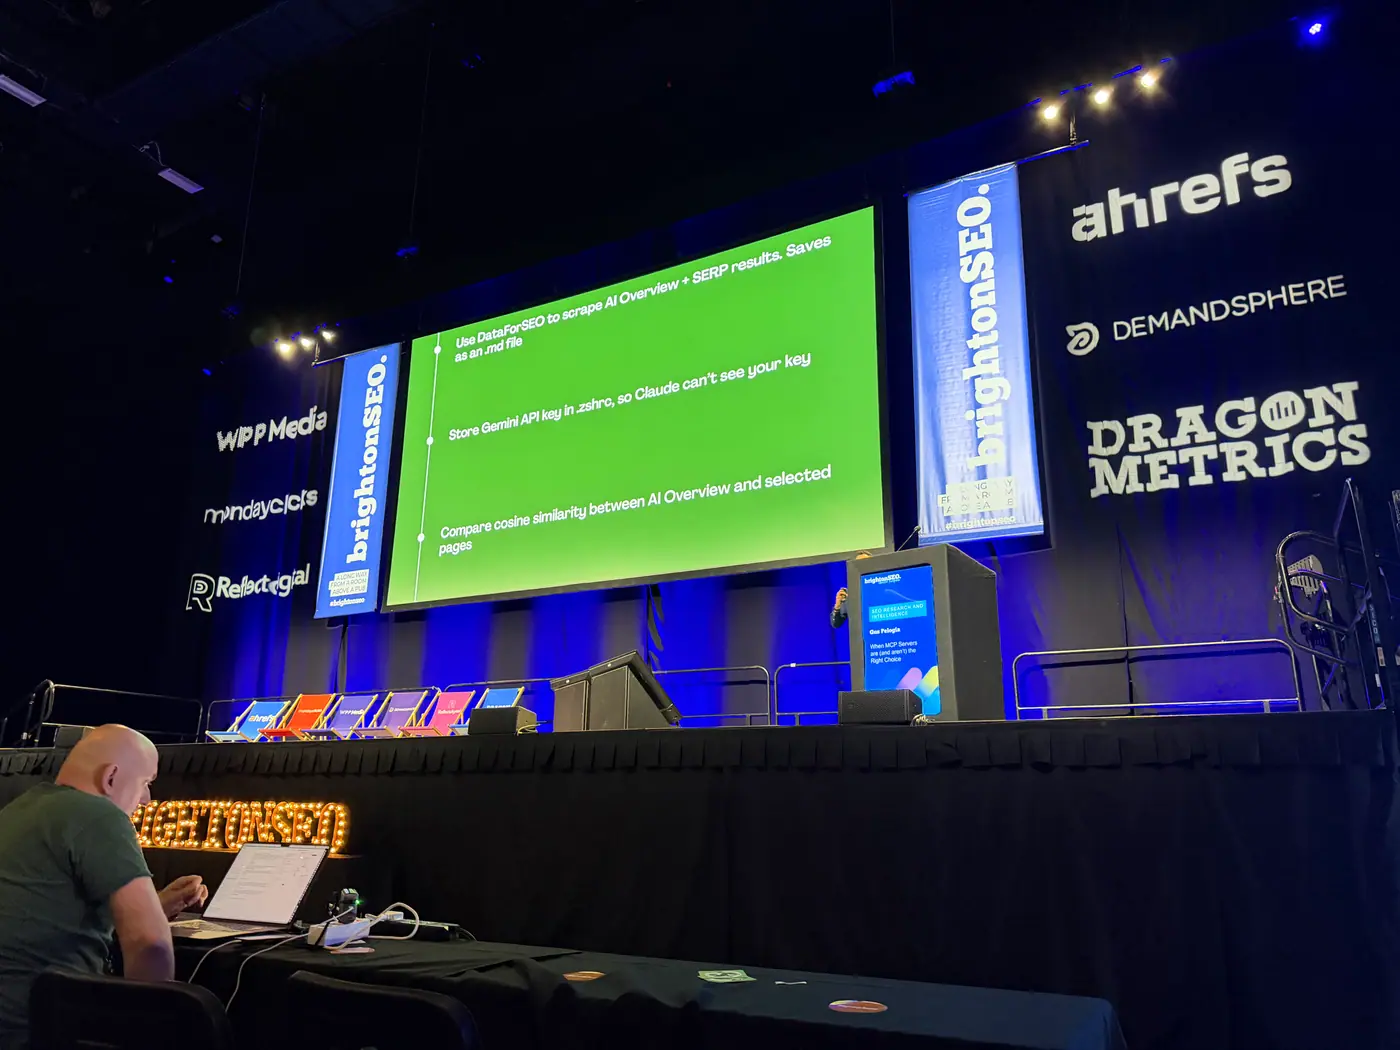
Pelogia pobiera (DataForSEO) treść AI Overview i stron z top 10, liczy embeddingi i podobieństwo kosinusowe, a potem porównuje je z własnymi stronami. Sam zastrzega, że nie ma „docelowej” wartości podobieństwa, ale to dobry proxy: jeśli strona produktowa jest daleko od tematu, pokazujesz klientowi liczby zamiast opinii.
„but I think it’s a good proxy in cases where you have a client saying, oh, I need this product page to rank for this keyword, and you can say, hey, product pages are not the topic here, like they’re very far off, and you give them the numbers.”
5. MCP to zły wybór do embeddingów: ponad 20 minut zamiast 2 minut skryptem.
Ten sam proces (10 stron do zeskrapowania) przez MCP/skill w Claude działał ponad 20 minut, skryptem – dwie minuty. Jego rekomendacja: embeddingi z crawla Screaming Frog + porównanie w Google Colab – szybciej i elastyczniej.
„this was on for more than 20 minutes, and I’ve done this with a script before, just took two minutes, so I was like, okay, it’s taking too long, this is probably not the right tool for this.”
6. Content gap „drugiego kroku”: rankingi konkurencji + crawl własnej strony = gotowe huby w pół godziny.
Klasyczny keyword gap kończy się na „stwórz stronę”. Pelogia łączy rankingi konkurenta z crawlem opublikowanych URL-i, dzięki czemu wychodzą brakujące strony pogrupowane w huby, z liczbą fraz i liczbą stron do stworzenia – do weryfikacji, ale jako punkt startu strategii.
„It created the hubs, showed the number of keywords, and the number of pages I should create to start competing in all the space. And this was maybe half an hour of work.”
Zdjęcia: Gus Pelogia
7 kadrów · Fot. Robert Nowaczyk
Sam Page: Win at Local AEO: The Wild West of AI Search
14:20 · Auditorium 2
Streszczenie
Sam Page przedstawił lokalne AEO (Answer Engine Optimization / optymalizację pod silniki odpowiedzi) jako rozszerzenie dotychczasowego SEO (Search Engine Optimization / optymalizacji pod wyszukiwarki), a nie jego zamiennik.
Na przykładach lokalnych wyszukiwań pokazał, że odpowiedzi AI (Artificial Intelligence / sztucznej inteligencji) mogą wskazywać inne firmy niż tradycyjne wyniki mapowe. Zwrócił uwagę na bliskość usługodawcy, oceny klientów, historię budowania zaufania oraz rekomendacje pochodzące z lokalnych społeczności. Jednocześnie wskazał, że bardziej szczegółowe zapytania nie zawsze prowadziły do bardziej wiarygodnych odpowiedzi.
Najważniejsze wnioski
Podstawy lokalnego SEO nadal mają znaczenie.
Page podkreślił rolę spójności nazwy, adresu i telefonu, zgodności informacji między stroną a zewnętrznymi źródłami oraz poprawnego przygotowania wizytówek. Nie przedstawił AEO jako powodu do porzucenia tych działań.Liczba opinii i wysokość oceny to dwa różne sygnały.
W jego obserwacjach wolumen opinii pozostawał ważny dla Google, natomiast ChatGPT potrafił wyróżnić firmę z wysoką oceną zamiast firmy z bardzo dużą liczbą recenzji. To obserwacja z przedstawionych przykładów, nie uniwersalna reguła rankingu.Bliskość i zaufanie mogą działać jednocześnie.
Prelegent wskazał na znaczenie odległości od użytkownika. Przekonywał również, że rozpoznawalne firmy i franczyzy korzystały z wcześniej zbudowanej wiarygodności, co mogło utrudniać wejście nowym podmiotom.Źródła lokalnych rekomendacji są rozproszone.
Page opisał widok mapowy ChatGPT jako wykorzystujący Mapbox i łączący wizytówki z Google Places oraz Yelp. Wskazał również grupy na Facebooku i lokalne dyskusje na Reddicie jako źródła pojawiające się przy lokalnych odpowiedziach.Lepsze dopasowanie do intencji nie oznacza automatycznie lepszej odpowiedzi.
Bardziej szczegółowe pytania pozwalały lepiej określić potrzebę użytkownika, ale przy bardzo długich zapytaniach Page obserwował także przypadkowe wyniki. Część z nich oceniał jako zmanipulowane. Zwrócił też uwagę na niejasności dotyczące rozpoznawania lokalizacji.
Dane liczbowe i przykłady
- Ocena 4,8 i 1000 opinii: w przywołanym porównaniu ChatGPT wskazał firmę z oceną 4,8, podczas gdy Google wyróżnił firmę mającą 1000 opinii. Przykład pokazywał różnicę między rekomendacjami obu narzędzi.
- 5 gwiazdek wobec 50 lub 100 opinii czterogwiazdkowych: Page użył takiego zestawienia, argumentując, że w obserwowanych odpowiedziach AI wysokość oceny mogła mieć większe znaczenie niż sam wolumen recenzji.
- 6–12 miesięcy: taki wiek wątków na Reddicie prelegent wskazał jako często spotykany w swoich obserwacjach. Jego wyjaśnienie, że starsze dyskusje miały czas przejść moderację i budzić większe zaufanie, było hipotezą.
- Około 15 słów: na przykładzie bardzo długiego zapytania lokalnego omówił niestabilność wyników.
- „Plumber near me”, czyli hydraulik w pobliżu: to zapytanie posłużyło do porównania lokalnych wyników Google i ChatGPT.
Praktyczne rady
- Nie zaniedbywać podstaw: utrzymywać spójne dane firmy, ofertę i informacje lokalizacyjne na stronie oraz w zewnętrznych wizytówkach.
- Sprawdzać widoczność osobno w różnych narzędziach: dobra pozycja w wynikach mapowych nie daje pełnego obrazu obecności w odpowiedziach AI.
- Analizować opinie szerzej niż przez ich liczbę: uwzględniać średnią ocenę, treść recenzji i to, jakie doświadczenia klientów opisują.
- Monitorować lokalne rozmowy o firmie: sprawdzać publiczne rekomendacje w społecznościach, a nie ograniczać analizy reputacji do wizytówki.
- Testować zapytania o różnej szczegółowości: oceniać nie tylko obecność firmy, ale także dopasowanie usługi i poprawność lokalizacji.
Knowledge bombs
1. W lokalnych odpowiedziach AI odległość ma ogromną wagę.
Page obserwuje, że im bliżej użytkownika jest usługa/produkt, tym mocniej jest faworyzowana – a ChatGPT zapytany „dlaczego pokazałeś te wyniki?” sam wskazuje bliskość i historię opinii jako powód wyboru. Warto ten trik (pytanie modelu o uzasadnienie) stosować do diagnozy lokalnych wyników.
„And the interesting thing, too, I noticed here is there’s proximity, like a huge value on proximity. So the closer the service is to you or the product, the more it’s favored in the result.”
2. ChatGPT nagradza wysoką ocenę bardziej niż liczbę opinii – odwrotnie niż Google.
W Google wolumen recenzji nadal bardzo się liczy; w ChatGPT firma z oceną 4,8 potrafi wygrać z konkurentem, który ma 1000 opinii. Sam prelegent zauważa, że to stoi w pewnej sprzeczności z faworyzowaniem dużych, „zaufanych” marek.
„But with AI search like ChatGPT, you’ll find that the actual review, like the actual rating, so it’s like a five-star rating, gets more reward than like 50 or 100 four-star reviews.”
3. Mapa w ChatGPT miesza wpisy z Yelp i Google, nie oznaczając źródła.
Przy zapytaniu „plumber near me” ChatGPT pokazuje widok mapy łączący listingi Yelp i Google Places – skąd pochodzi dany wpis, widać dopiero po kliknięciu. Wniosek: profil na Yelp (i innych katalogach) przestaje być drugorzędny, bo zasila lokalne odpowiedzi AI.
„It’s a combination of, like, Yelp listings and Google Places listings, and it doesn’t, it’s funny because it doesn’t actually tell you which one is which until you click on it, so it’s a little bit sneaky.”
4. Wątki na Reddicie mają „sweet spot” wieku 6–12 miesięcy.
Duże wątki lokalne z wieloma komentarzami są cenne, ale według obserwacji Page’a AI nie ufa świeżym wątkom – jego hipoteza: wyszukiwarki AI wiedzą, że Reddit jest masowo manipulowany, więc czekają, aż moderacja zrobi swoje. Grupy na Facebooku to drugie silne źródło dla lokalnych odpowiedzi.
„And also this, like, sweet spot of age there seems to be between 6 and 12 months.”
5. Bardzo długi ogon w lokalnym AI daje dziwne, zmanipulowane wyniki.
Zapytania rzędu 15 słów zwracają według niego przypadkowe i podatne na manipulację odpowiedzi – sygnał, że to obszar „dzikiego zachodu” (zarówno ryzyko, jak i okazja), a monitoring nie powinien opierać się wyłącznie na krótkich frazach typu „near me”.
„So if you’re searching for something like this, like 15 words, super long tail, you’re going to get some really weird, random, manipulated results.”
Zdjęcia: Sam Page
37 kadrów · Fot. Robert Nowaczyk
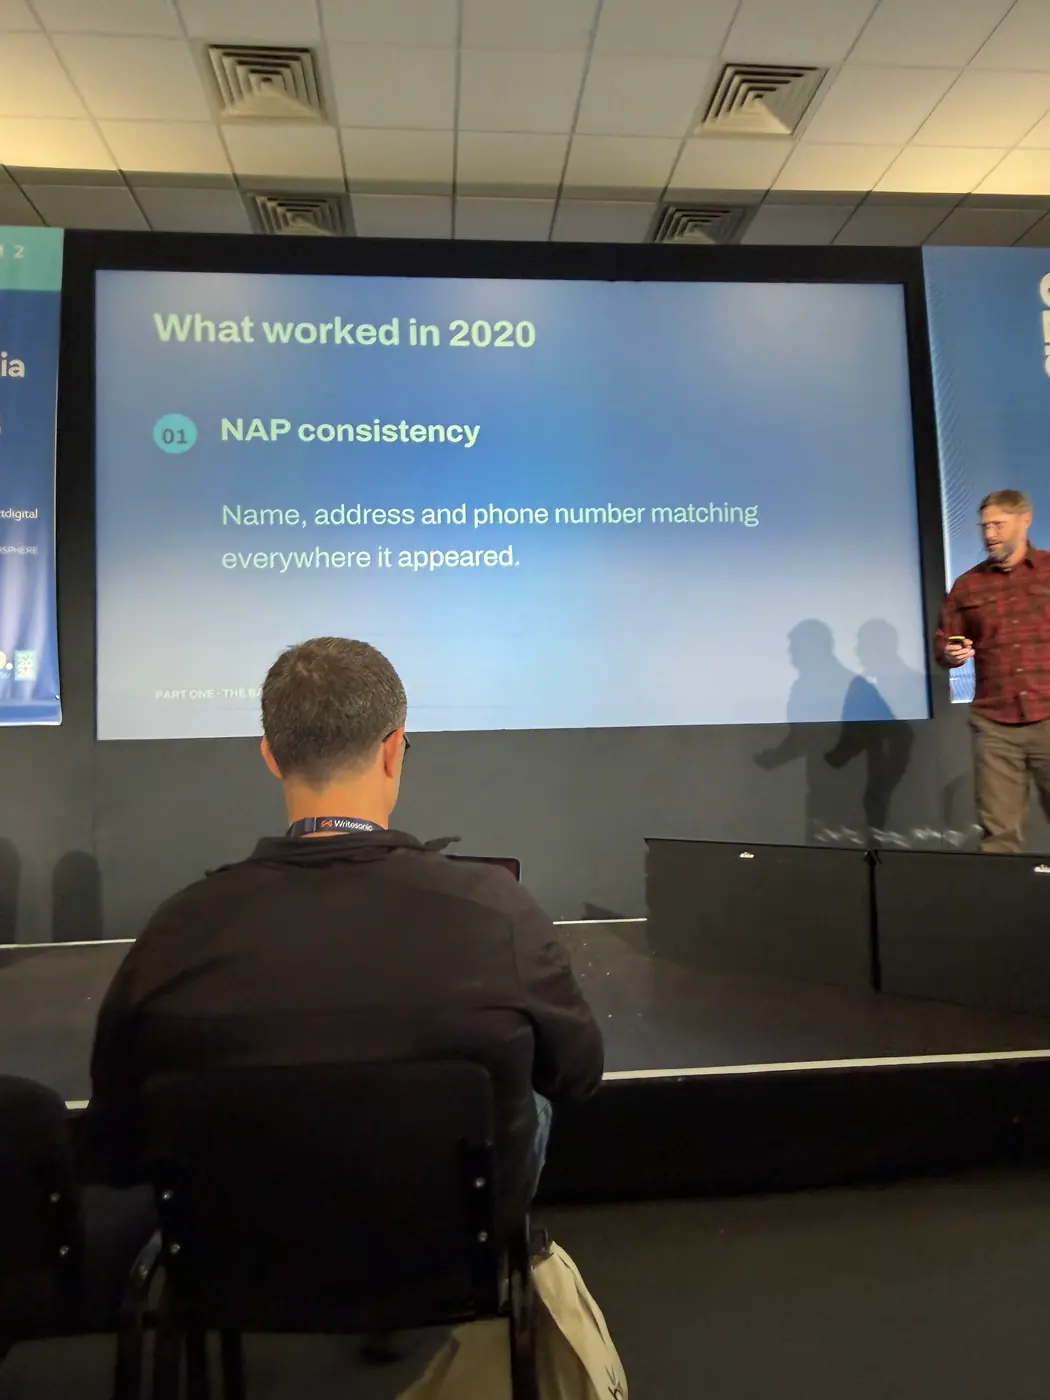
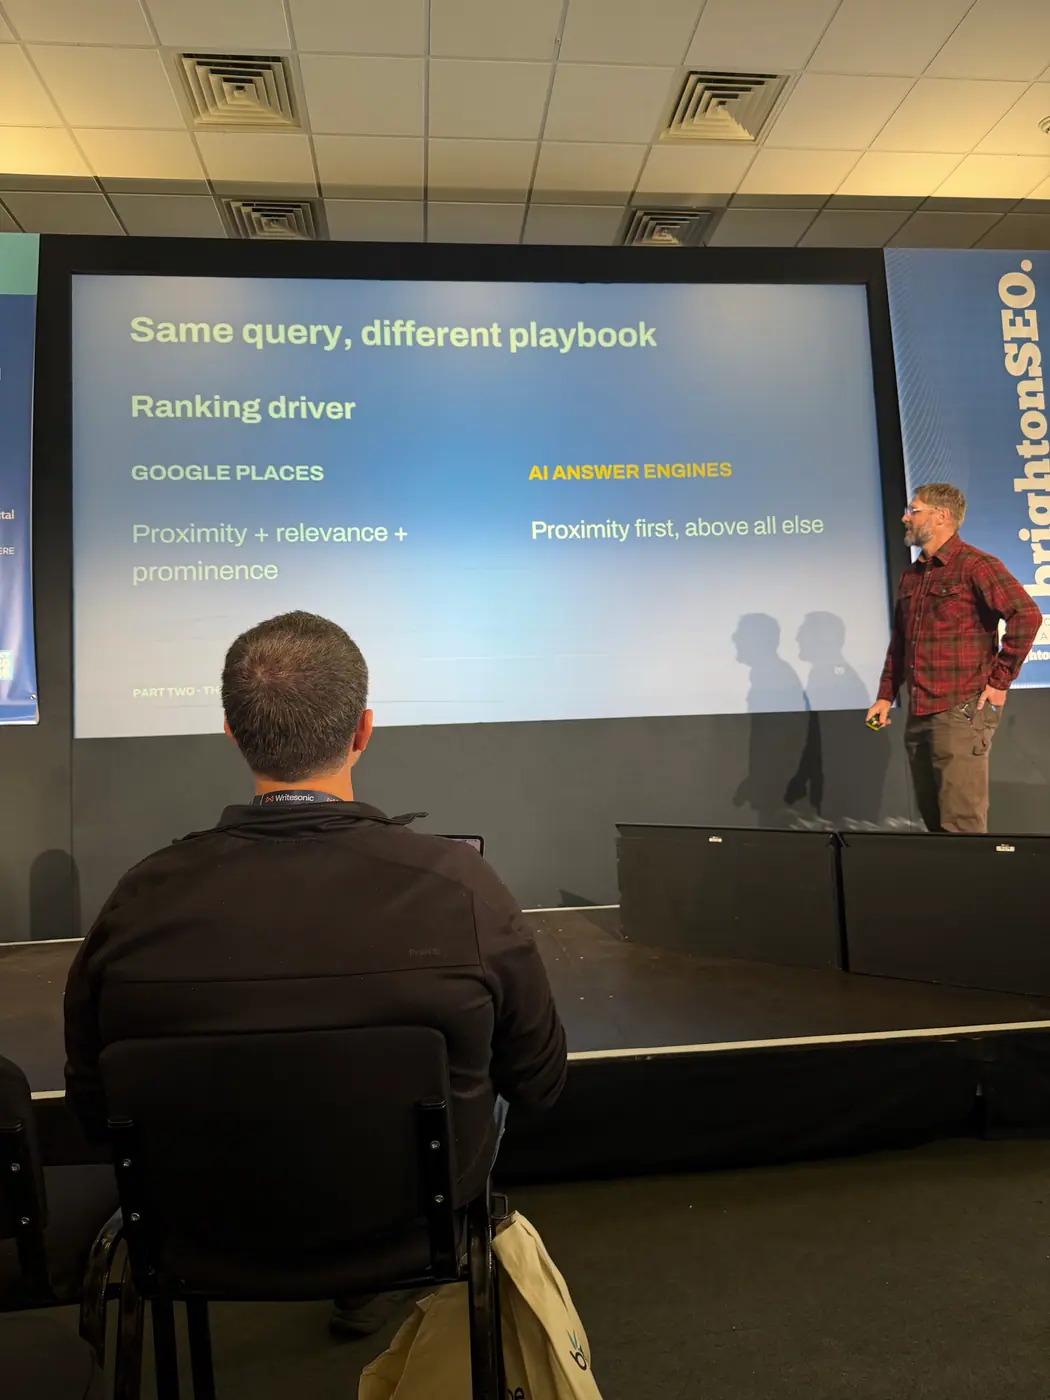
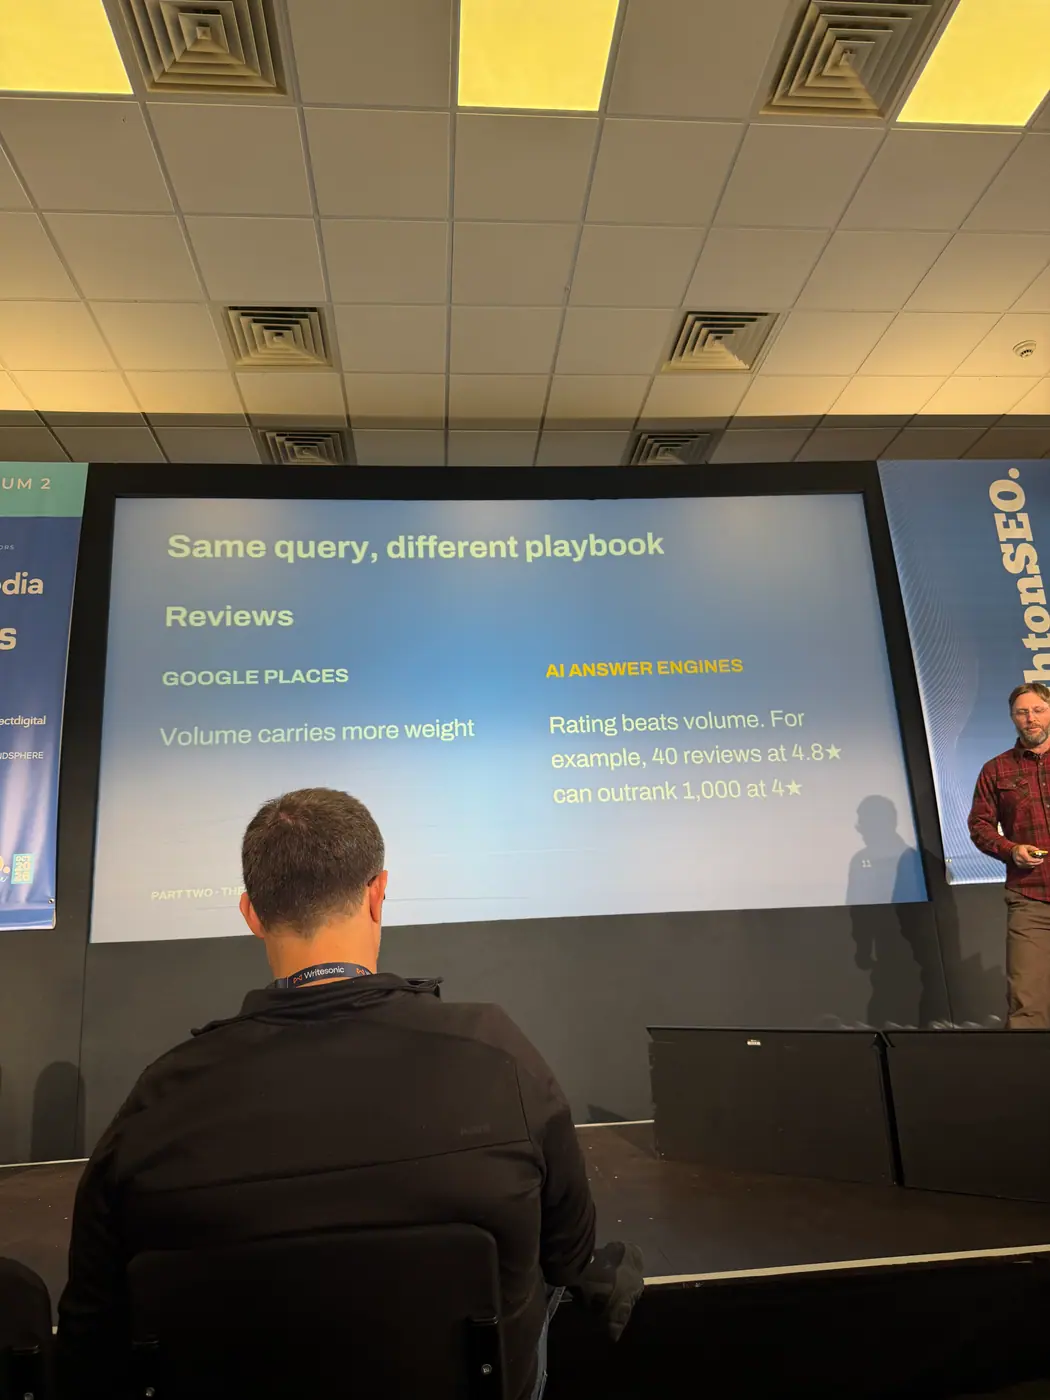
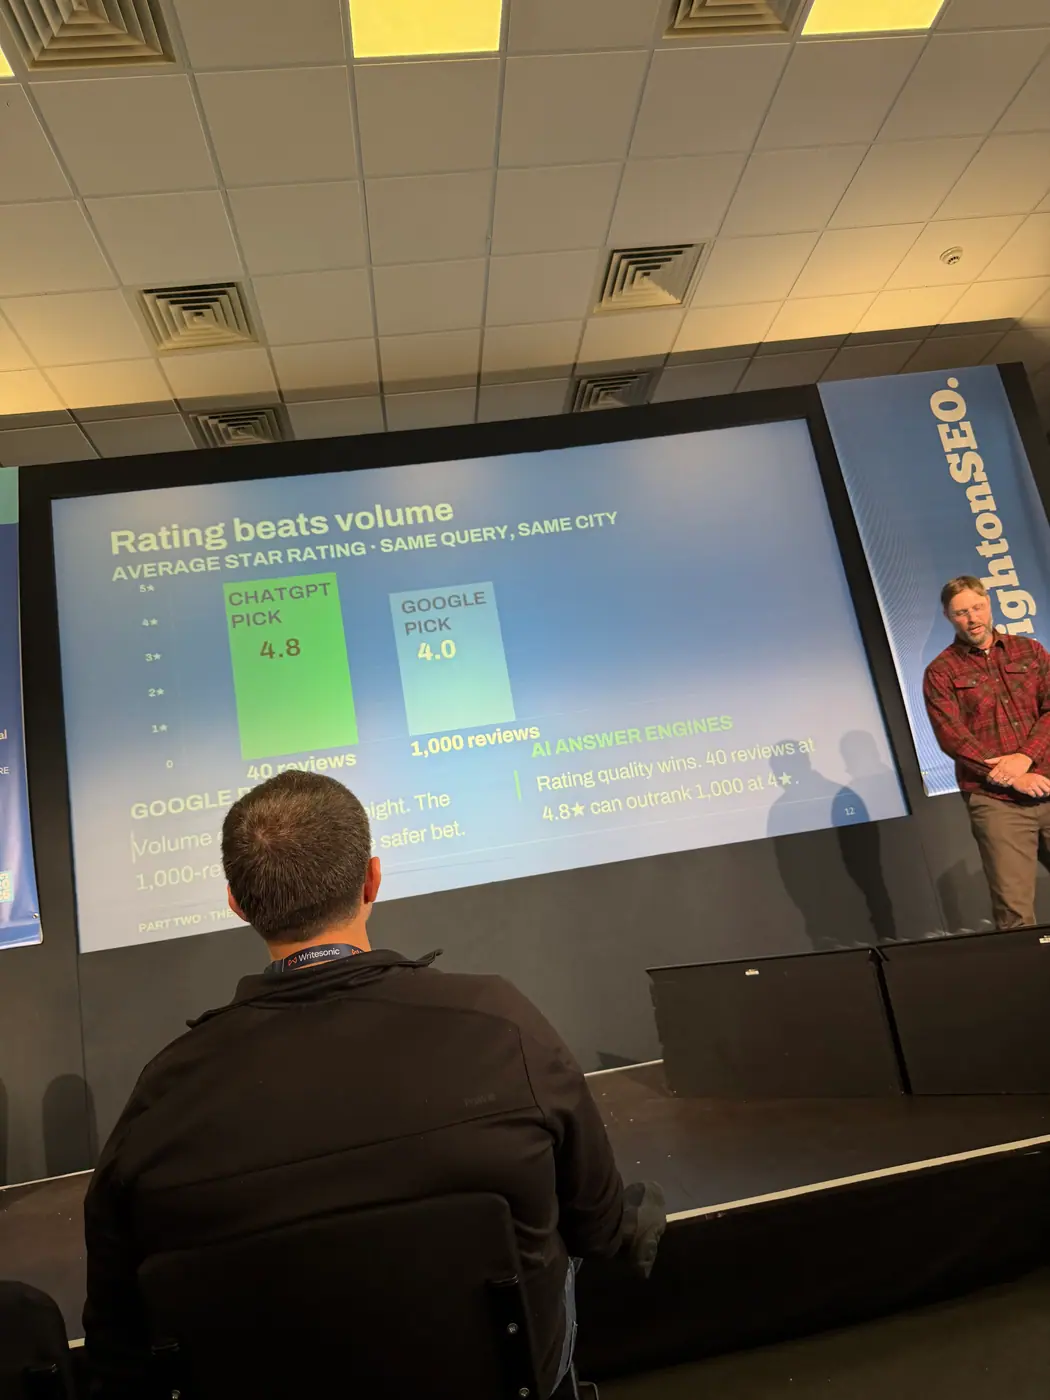
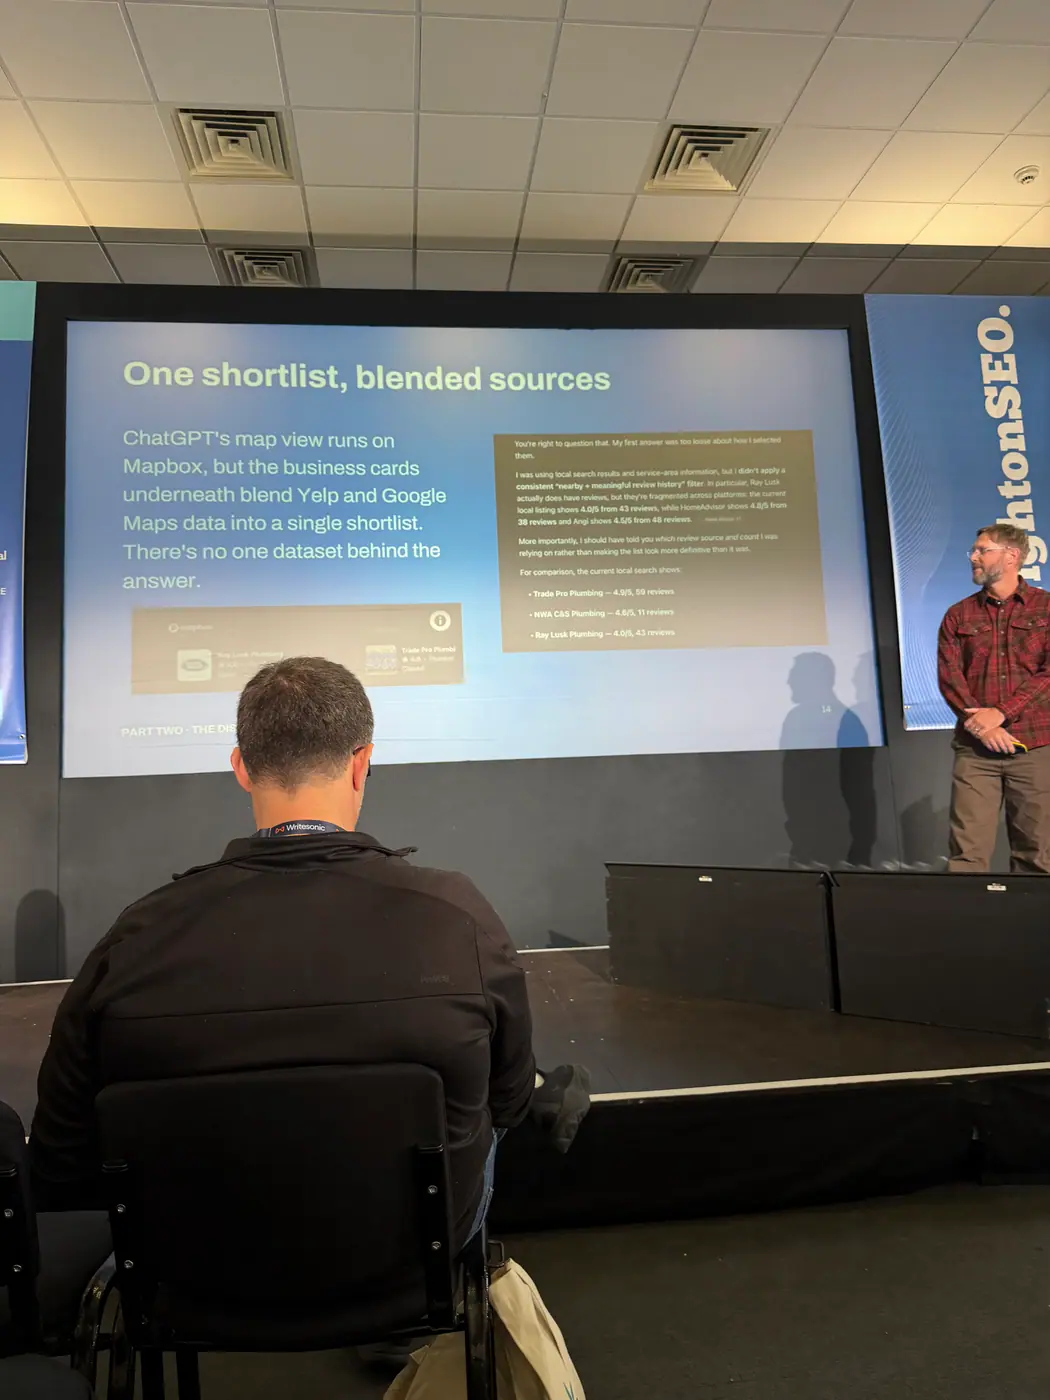
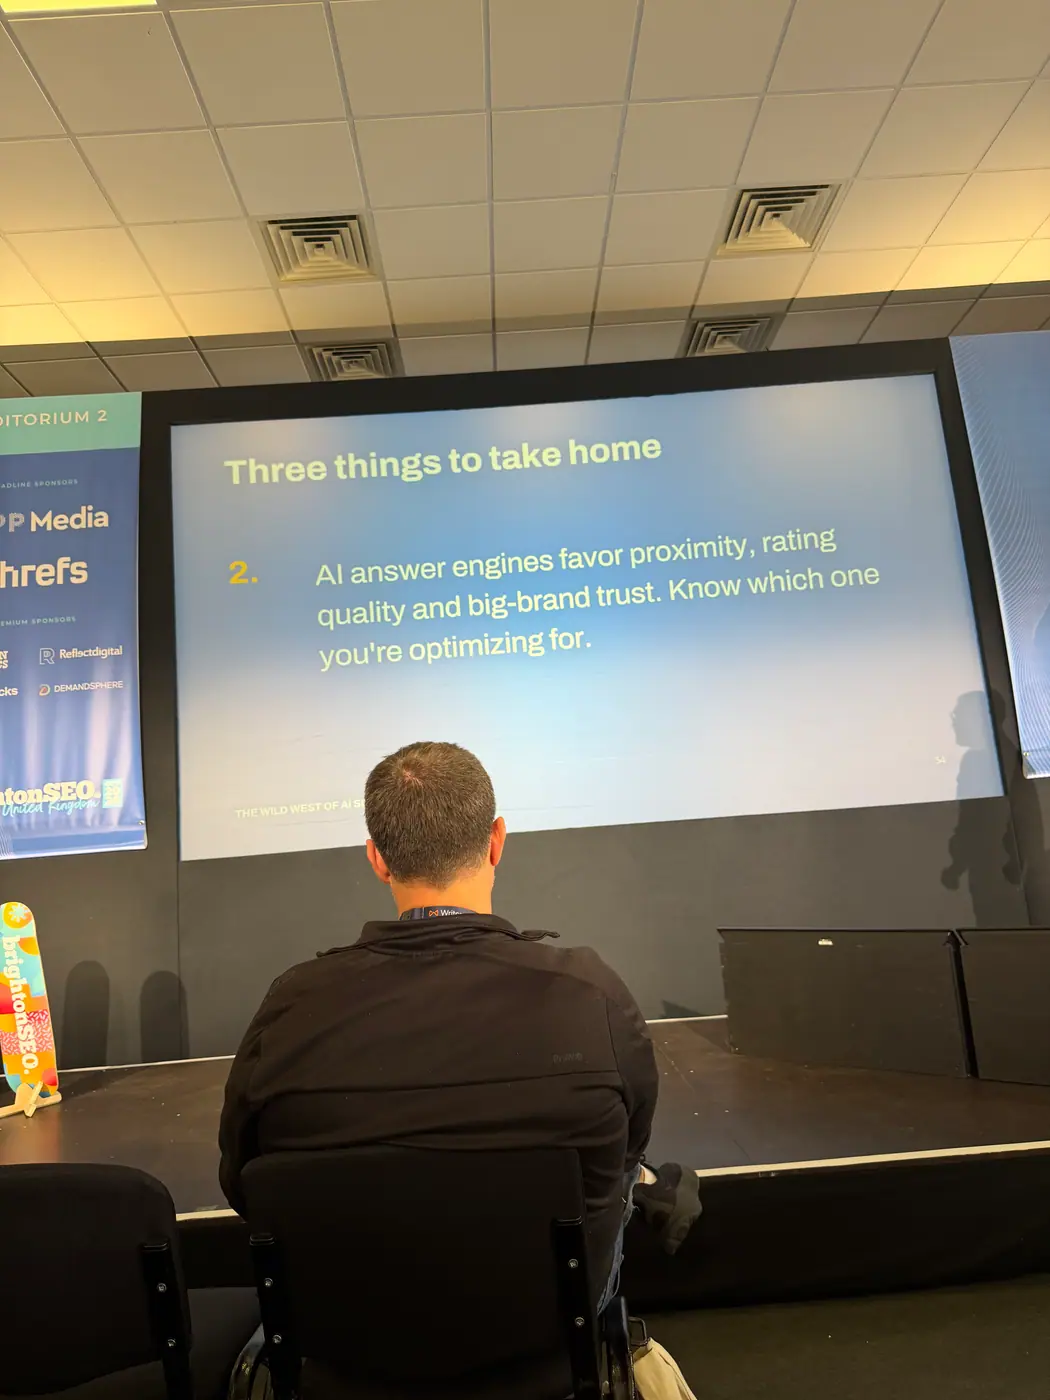
Abbie Dando: From Query to Sale: Engineering Search Journeys That Convert
14:40 · Auditorium 1
Streszczenie
Abbie Dando przedstawiła na brightonSEO strategię SEO (Search Engine Optimization / optymalizacja pod wyszukiwarki), w której punktem wyjścia były przychody i zapytania sprzedażowe, a nie sama widoczność.
Zaproponowała połączenie stałej pracy nad stroną z 1–3 priorytetowymi kampaniami wieloplatformowymi rocznie. Wybór tych kampanii powinien wynikać z prognozy potencjału biznesowego. Ważną częścią prezentacji była również organizacja współpracy między zespołami oraz odpowiedzialność za konwersję pozyskanego ruchu.
Najważniejsze wnioski
Fundamenty i kampanie wzrostowe miały pełnić różne funkcje.
Dando przedstawiła model 4C (Capture, Convince, Commercial, Convert / dotarcie, przekonanie, działania komercyjne, konwersja):- Capture: umożliwienie znalezienia oferty, m.in. dzięki strukturze stron, treściom i optymalizacji technicznej.
- Convince: dostarczenie informacji potrzebnych do rozważenia zakupu.
- Commercial: skoncentrowane kampanie wieloplatformowe dla wybranych ścieżek zakupowych.
- Convert: usuwanie przeszkód utrudniających konwersję.
Obecność na wielu platformach nie oznaczała promowania całego asortymentu wszędzie.
Prelegentka zalecała szerokie pokrycie potrzeb użytkowników na własnej stronie. Intensywne działania wieloplatformowe proponowała natomiast ograniczyć do wybranych priorytetów. To istotne rozróżnienie między budowaniem fundamentów a rozpraszaniem zasobów.Najpierw prognoza, później wybór kategorii.
Dando przywołała doświadczenie z pracy z klientem: początkowo zespół skłaniał się ku kategorii, z której firma była znana. Analiza innych obszarów ujawniła jednak kategorię z wysokim popytem, słabszą widocznością i większym potencjałem przychodowym.Współpraca między zespołami wymagała wspólnego celu biznesowego.
Prelegentka opisała problemy wynikające z odrębnych budżetów, priorytetów i niejasnej odpowiedzialności. Jej rekomendacją była jedna kampania, wspólne mierniki i uzgodniony budżet, zamiast osobnych inicjatyw poszczególnych kanałów.Odpowiedzialność zespołu SEO nie powinna kończyć się na pozyskaniu ruchu.
Dando przekonywała, że specjaliści powinni rozumieć współczynniki konwersji i czynniki, które na nie wpływają. Nie postulowała zastępowania ekspertów CRO (Conversion Rate Optimization / optymalizacja współczynnika konwersji) ani UX (User Experience / doświadczenie użytkownika), lecz współpracę z nimi lub podstawową diagnostykę, gdy takich zespołów brakuje.
Dane liczbowe i przykłady
4 filary i 3 warstwy pracy: fundamenty obejmowały Capture i Convince, wzrost odpowiadał Commercial, a optymalizacja konwersji odpowiadała Convert. Był to model organizacji działań zaproponowany przez prelegentkę.
1–3 kampanie komercyjne rocznie: rekomendowany zakres koncentracji działań wieloplatformowych. Ograniczenie dotyczyło kampanii priorytetowych, nie całej bieżącej pracy SEO.
Około 700 funtów wobec ponad 1000 funtów: takimi wartościami zamówienia Dando posłużyła się w ilustracyjnym porównaniu trampolin i ogrodowych konstrukcji do wspinania. Wyższa wartość drugiej kategorii była jednym z argumentów za zbadaniem jej potencjału.
Około 30% udziału w widoczności oraz „60K” potencjalnego przychodu: liczby pojawiły się w hipotetycznym scenariuszu dla rynku brytyjskiego. Nie były rezultatami przeprowadzonej kampanii.
Porównania miesiąc do miesiąca i rok do roku: prelegentka zalecała taki sposób monitorowania współczynników konwersji, również na poziomie kategorii wybranej do kampanii.
Praktyczne rady
- Porównaj potencjał kategorii przed podziałem budżetu. Uwzględnij popyt, obecną widoczność, wartość zamówienia i współczynnik konwersji.
- Rozdziel działania stałe od kampanii priorytetowych. Nie ograniczaj fundamentów SEO do kategorii, które aktualnie promujesz.
- Buduj strony odpowiadające konkretnym sytuacjom zakupowym. W przykładzie były to konstrukcje do wspinania dla starszych dzieci, młodszych dzieci i małych ogrodów.
- Uzgodnij wspólny cel, mierniki i budżet z pozostałymi zespołami. Kampanię warto opracować razem lub przedstawić wstępny plan do wspólnego dopracowania.
- Sprawdź konwersję przed zwiększeniem skali pozyskiwania ruchu. Wykorzystaj mapy cieplne, analizę lejka zakupowego i wyniki konkretnej kategorii.
Knowledge bombs
1. Skupienie na GEO przesłania szerszy obraz: to era wyszukiwania wieloplatformowego, a LLM-y są tylko jej częścią.
Dando nie neguje GEO (mówi wręcz, że kanał przynosi już realny przychód), ale ostrzega przed traktowaniem go jako całej strategii – wyszukiwanie dzieje się też w YouTube, TikToku, na forach.
„And one thing that does bug me a little bit is we’re all so focused on our GEO strategies that we’re kind of forgetting the bigger picture. We are in the multi-platform search era, and LLMs are just part of that.”
2. Priorytetyzuj kategorie po wartości koszyka i udziale w widoczności, nie po tym, z czego marka jest znana.
W przykładzie marka ma ruch na trampoliny (średnie zamówienie ok. 700 GBP), ale słabą widoczność na drabinki/zestawy wspinaczkowe (ok. 1000+ GBP) przy istniejącym popycie i niskim share of voice w Google i LLM-ach. Prognoza przy realistycznym celu ok. 30% share of voice – ok. 60 tys. tylko na rynku UK.
„The average order value of a trampoline is about £700. But the average order value of a monkey bar or a climbing frame is £1,000-plus.”
3. Najpierw prognoza, potem priorytet – intuicja zespołu prowadzi do „oczywistej” kategorii.
Z realnego projektu: wszyscy odruchowo wybrali kategorię, z której firma jest znana, a dopiero prognoza pokazała rosnącą kategorię z niską widocznością i wyższym popytem – i to ona przekonała ludzi.
„One thing I would say is, please, before you do this, forecast before you prioritize.”
4. Maksymalnie 1–3 wieloplatformowe kampanie „search-led” rocznie, każda na jedną ścieżkę zakupową.
Zamiast robić wszystko naraz (TikTok, PR, YouTube) i nigdzie się nie wyróżniać – wybierz jedną ścieżkę (np. drabinki dla nastolatków) i zrób dla niej PR, social, influencerów, UGC, niszowe landingi, Reddit/fora, a nawet własną grupę na Facebooku, z jednym zestawem KPI i budżetem uzgodnionym z marketingiem.
„And this is about really focusing on one, two, maximum three priority search journeys that you can launch multi-platform campaigns for and really go after some real good revenue or leads figures.”
5. Innych działów nie przekonasz wolumenem wyszukiwań – tylko liczbami przychodu lub leadów.
Kampanie wieloplatformowe wymagają brandu, PR i social; te zespoły „wsiądą” tylko, gdy SEO przyjdzie z prognozą pieniędzy. Taktyka: jeśli nie są chętni, przygotuj szkic kampanii sam i przynieś go do wspólnego dopracowania.
„If you are going to get other people within your business on board with your campaigns who want to come along on the ride with you, you can’t just tax them about search volume. You do have to put some revenue or leads figures on the table to be going after.”
6. Treść „convince” musi odpowiadać na to, co klient porównuje – samo ściągnięcie ruchu już nie działa.
Kiedyś wystarczyło wpuścić użytkownika na bloga czy landing i dać mu „samemu zdecydować”. Teraz trzeba wiedzieć, jakie marki, rozmiary i jakość porównuje, i dać mu te informacje – także w formie wideo. Do tego bardzo niszowe landingi (np. drabinki dla starszych dzieci, dla małych ogrodów) zamiast ogólnych kategorii.
„It just doesn’t happen like that anymore. You’re going to have to give them more. You’re going to have to know what are they comparing, what brands are they comparing, what sizes are they comparing, what quality are they comparing.”
7. Przy niskiej konwersji najpierw napraw CR, potem odpalaj kampanię.
Minimum bez zespołu CRO: heatmapy, konwersja m/m i r/r, lejki w GA4 i znajomość CR dla konkretnej kategorii przed kampanią. Inaczej generujesz ruch, który nie konwertuje.
„Because if your conversion rates are quite low, then obviously I would highly recommend you sort the conversion rate out first before you invest in launching a commercial campaign”
Zdjęcia: Abbie Dando
8 kadrów · Fot. Robert Nowaczyk
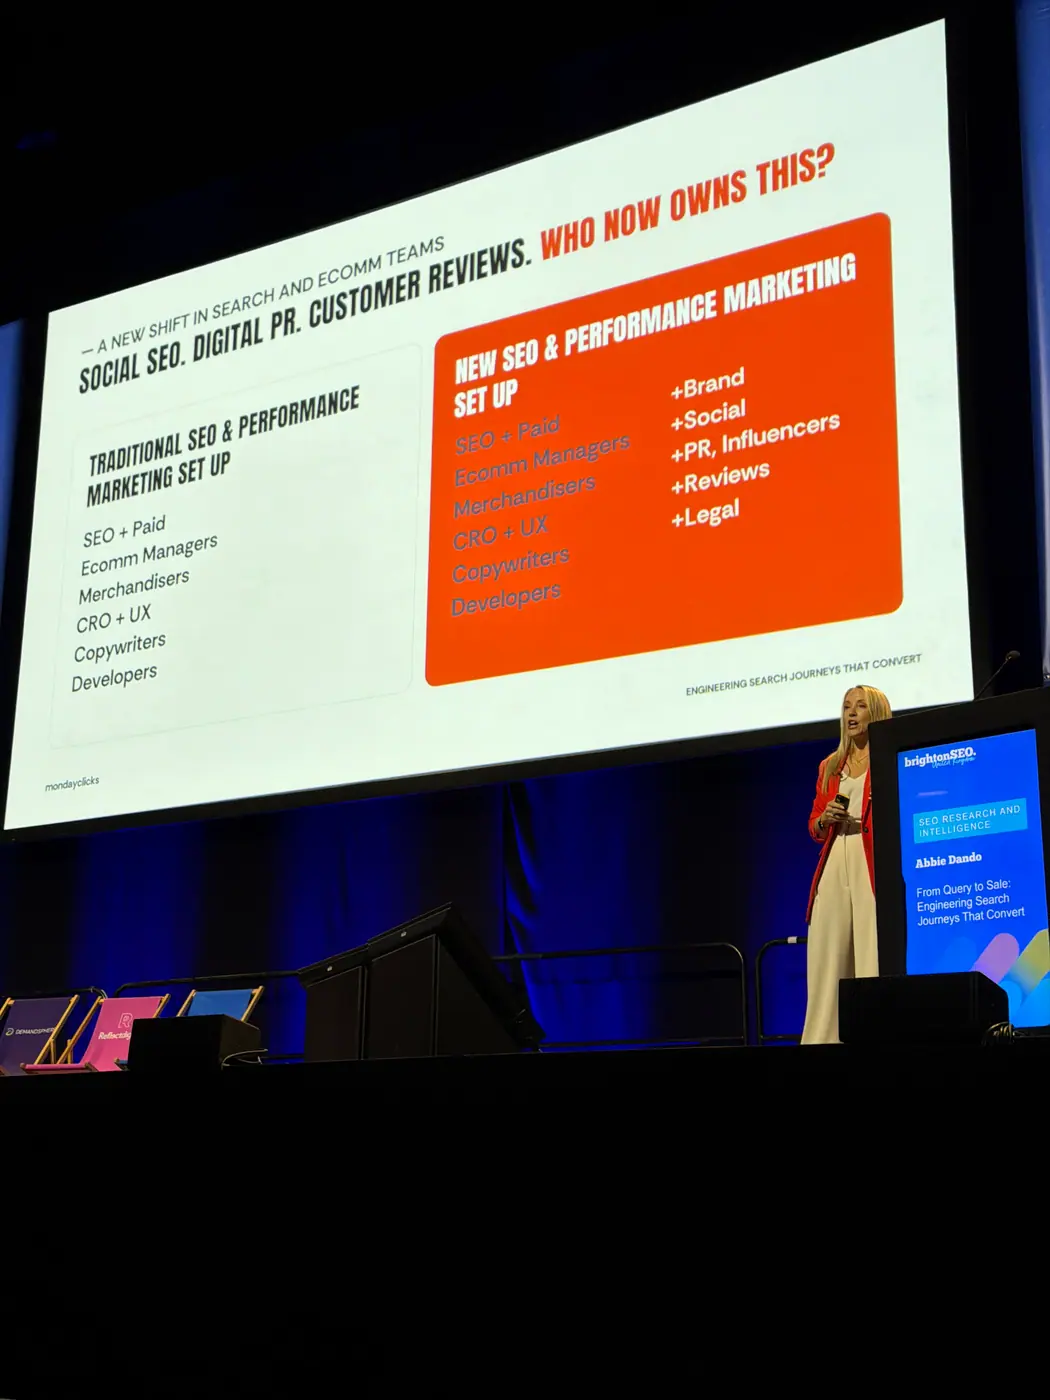
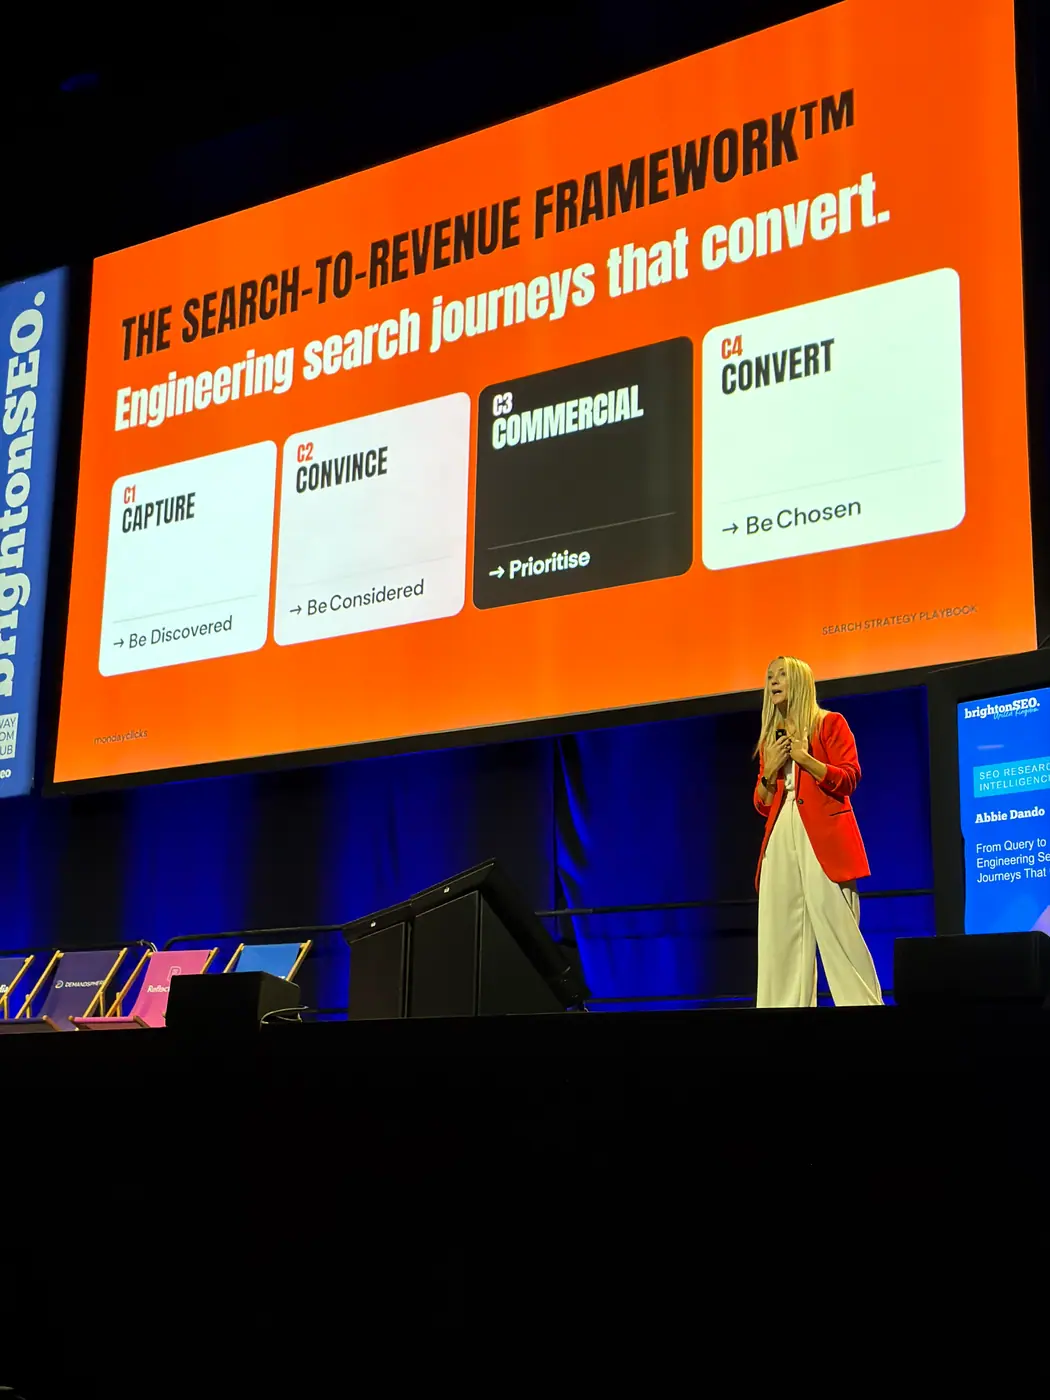
Christian Hustle: AEO/GEO Myths Busters: 5 things you can really do to drive your conversion & more traffic to your store
15:30 · Syndicate 1&2 (Local SEO)
Streszczenie
Christian Hustle zakwestionował pięć popularnych przekonań o widoczności marek w AI (Artificial Intelligence / sztucznej inteligencji). Przedstawił AEO (Answer Engine Optimization / optymalizację pod silniki odpowiedzi) i GEO (Generative Engine Optimization / optymalizację pod wyszukiwarki generatywne) jako uzupełnienie SEO (Search Engine Optimization / optymalizacji pod wyszukiwarki), a nie jego zamiennik.
Rekomendował przede wszystkim audyt dostępności treści, poprawę istniejących stron, pracę nad zewnętrznymi źródłami informacji i aktualnością danych lokalnych. W pomiarze skuteczności proponował wyjście poza samą obecność marki w odpowiedziach: w stronę konwersji i działań klientów, również tych niewymagających odwiedzenia witryny.
Najważniejsze wnioski
Podstawy techniczne pozostały istotne.
Prelegent opisał audyty dużych firm, w których roboty systemów AI były blokowane przez konfigurację CDN (Content Delivery Network / sieci dostarczania treści). Zalecał sprawdzenie dostępności witryny, jej kondycji technicznej i linkowania wewnętrznego. Były to obserwacje z audytów oraz rekomendacje, nie argument za porzuceniem dotychczasowego SEO.Większa liczba publikacji nie gwarantowała większej liczby cytowań.
Hustle rekomendował rozpoczęcie od stron, które już konwertowały lub były cytowane. Proponował analizę ich skuteczności, poprawę struktury i rozwijanie przydatnych informacji zamiast automatycznego zwiększania produkcji treści.Własna witryna była tylko jednym ze źródeł informacji o marce.
W opisanym eksperymencie cytowania pojawiały się przy materiałach wideo i publikacjach zewnętrznych, mimo że ta sama treść znajdowała się na stronie firmy. Wykorzystanie transkrypcji filmów przez systemy AI było hipotezą prelegenta, a nie wykazanym mechanizmem.GEO wymagało pracy na poziomie pojedynczych placówek.
Prelegent pokazał przypadek rozbieżności adresu po przeprowadzce sklepu. Wskazał też na znaczenie lokalnych informacji na stronach placówek oraz monitorowania odpowiedzi z uwzględnieniem lokalizacji użytkownika.Widoczność nie była równoznaczna z wynikiem biznesowym.
Hustle postulował analizowanie ruchu odsyłającego i konwersji, ale zaznaczył, że część klientów mogła zadzwonić lub odwiedzić sklep bez wejścia na stronę. Był to kierunek obserwacji z prowadzonych eksperymentów; dane potwierdzające skalę tego zjawiska dopiero zapowiedział.
Dane liczbowe i przykłady
| Liczba lub przykład | Co wynikało z materiału |
|---|---|
| Wzrost z 0% do 30% udziału marki w odpowiedziach | Wynik zadeklarowany przez prelegenta dla monitorowanego zestawu zapytań po rozpoczęciu publikacji materiałów wideo. Równolegle treści pojawiały się u innych wydawców. Nie był to wynik dotyczący ruchu ani sprzedaży. |
| Ocena 4,2 zamiast 4,8 | Przykład możliwej rekomendacji firmy z niższą średnią ocen. Hustle wiązał takie sytuacje z regularnością opinii, widocznymi trendami i odpowiedziami marki na problemy. Była to interpretacja w ramach prowadzonych eksperymentów. |
| Od 30 do 500 zapytań na lokalizację | Przykładowy zakres monitoringu zależny od produktów, usług i etapów decyzji zakupowej. Nie uniwersalna liczba zapytań, którą każda firma powinna śledzić. |
| Zmiana lokalizacji dzień przed audytem | W opisanym przypadku adres podawany przez AI nie zgadzał się z witryną. Przykład pokazał problem niespójnych danych po przeprowadzce placówki. |
| 2 000 istniejących treści i 500 nowych publikacji miesięcznie | Liczby użyte retorycznie do zilustrowania nadprodukcji treści, a nie wyniki badania ani zalecana skala publikacji. |
Praktyczne rady
- Zacznij od dostępności: sprawdź blokady robotów, konfigurację infrastruktury i linkowanie między stronami usług, produktów oraz treściami poradnikowymi.
- Przeanalizuj istniejące strony: wybierz te, które konwertują i są cytowane. Ustal, co warto poprawić lub rozwinąć przed zamówieniem kolejnych publikacji.
- Uporządkuj strony lokalne: dodaj rzeczywiste informacje o placówce oraz sekcje pytań i odpowiedzi odpowiadające na potrzeby klientów.
- Zmapuj zewnętrzne źródła: sprawdź, jakie serwisy, katalogi, platformy wideo i miejsca z opiniami pojawiają się w odpowiedziach dotyczących Twojej kategorii.
- Aktualizuj dane poza własną witryną: po zmianie adresu nie kończ pracy na stronie sklepu i jego profilu firmowym.
- Mierz kilka etapów: dobieraj zapytania do intencji i lokalizacji, wyodrębnij ruch z AI oraz analizuj konwersje. Nie utożsamiaj braku sesji na stronie z brakiem wpływu rekomendacji.
Knowledge bombs
1. Pierwsza rzecz do sprawdzenia w audycie GEO dużej marki: czy CDN domyślnie nie blokuje botów LLM.
Prelegent mówi, że u klientów enterprise regularnie trafia na domyślne ustawienie u jednego z dużych dostawców CDN, które blokuje crawlery LLM. Marka pyta, czemu nie jest polecana, a AI po prostu nie może przeczytać jej strony. Dodaje, że zdziwilibyśmy się, gdybyśmy usłyszeli nazwy tych firm.
„There’s so many times I’ve seen, specifically for enterprise customers, they have by default this setting with one of the middle CDN providers, where LLMs are blocked by default.”
2. Eksperyment z YouTube: share of voice od 0 do 30%, ale cytowane były cudze kopie treści, a nie strona marki.
Prelegent założył, że AI „czyta” transkrypcje filmów z YouTube, więc zaczął publikować wideo i mierzyć share of voice marki. Wzrósł z zera do 30% w różnych promptach. Potem AI zaczęło cytować tę samą treść z innych wydawców i serwisów z podcastami, a nie z jego strony, choć treść była identyczna. Liczy się więc format i źródło, nie tylko sama treść.
„We started really going from zero shareable voice to 30% shareable voice across a variety of prompts.”
„And it was the exact same content that’s on our website, but our website was not being cited whatsoever.”
3. Hipoteza: dla AI średnia ocena może liczyć się mniej niż regularność opinii i reakcje marki.
Zespół prelegenta testuje tezę, że AI może polecić firmę z oceną 4,2 zamiast tej z 4,8, jeśli ta pierwsza dostaje opinie co tydzień. AI widzi trendy i to, czy marka odpowiada na problemy. Wcześniej celem i KPI było podniesienie oceny z 4,3 do 4,5, a teraz zespół zastanawia się, czy to ma jeszcze sens. Uwaga: to obserwacja z trwających eksperymentów, nie twarde dane.
„Start rating is not a thing anymore in AI because AI can be recommending a company that has a 4.2 over a 4.8 because the 4.2 has consistent reviews every single week.”
4. Ile promptów śledzić? Od 30 do 500 na lokalizację.
Liczba zależy od liczby produktów, usług i lokalizacji. Przy marce luksusowej z wieloma etapami ścieżki klienta (porównywanie marek, szukanie prezentu, szukanie najbliższego sklepu) jeden ogólny prompt typu „handbags near me” nic nie daje. Liczba promptów szybko się mnoży, więc warto to wycenić z góry.
„It depends on how many products, how many services do you have, how many locations do you have, because it can be all the way from 30 per location to 500 per location.”
5. Lokalne prompty trzeba śledzić z poziomu lokalizacji, a nie przez dopisanie miasta do zapytania.
Dopisanie miasta do promptu to za mało. Odpowiedź dla tego samego zapytania o Houston będzie inna dla kogoś w Austin, a inna dla kogoś w Brighton, bo AI zna lokalizację pytającego. Dopiero śledzenie z poziomu lokalizacji pokazuje to, co widzą turyści, którzy już są w mieście.
„But when you’re able to track it at the local level, I think that’s really where you start seeing more accuracy.”
6. Zamiast publikować więcej, rozbuduj strony, które AI już cytuje.
Na pytanie „czy publikować więcej treści?” prelegent odpowiada: jeszcze nie. Najpierw trzeba przebudować strony o wysokiej intencji, które najlepiej konwertują, i rozwinąć te, które AI już cytuje, bo „coś w nich lubi”.
„If we’re seeing those pages being cited in AI, there’s something about those pages that AI just loves, and we just need to continue to do more of that, right?”
7. Źródła cytowane przez AI są inne w każdej branży, więc trzeba zmapować własną kategorię.
U kancelarii prawnych AI cytuje inne katalogi niż przy sklepach. W branży prelegenta (software) na samej górze są G2, serwisy z recenzjami oprogramowania i YouTube. Najpierw zmapuj źródła w swojej kategorii, potem zdobywaj w nich obecność.
„Because I can tell you for attorneys and law offices are going to be completely different directories compared to a retail store.”
8. FAQ na stronach lokalizacji to gotowe odpowiedzi, które AI może przejąć.
Prelegent jest fanem FAQ na stronach lokalnych. Większość sali też podniosła ręce. Według niego to konwersacyjne odpowiedzi, które AI bierze i podaje klientom.
„I’m a big fan of FAQs on local pages.”
Zdjęcia: Christian Hustle
14 kadrów · Fot. Robert Nowaczyk
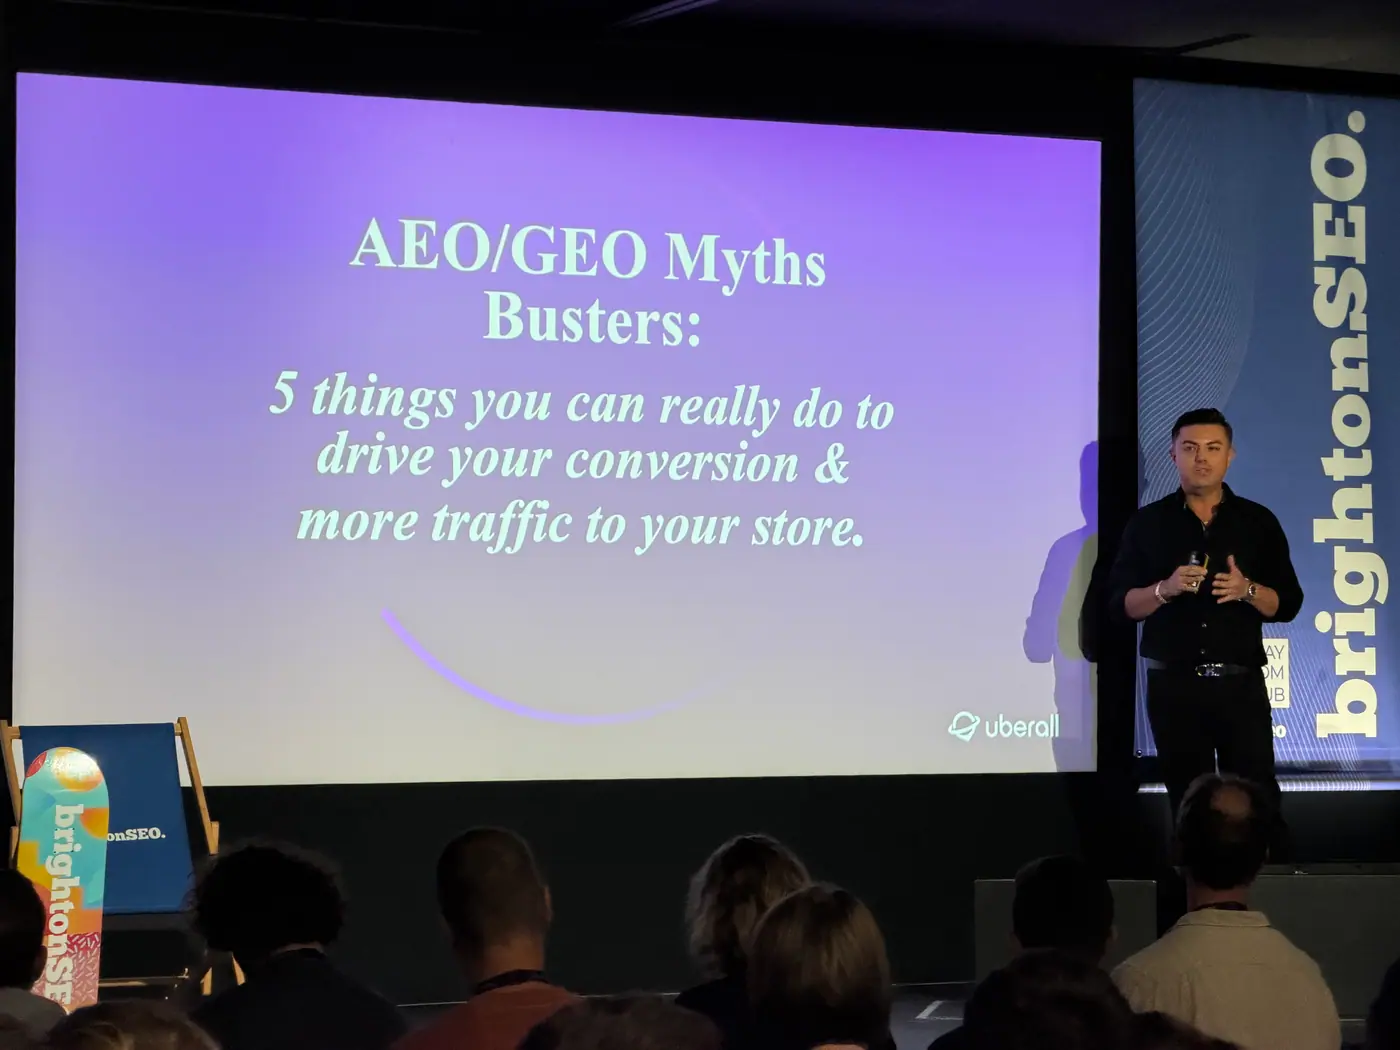
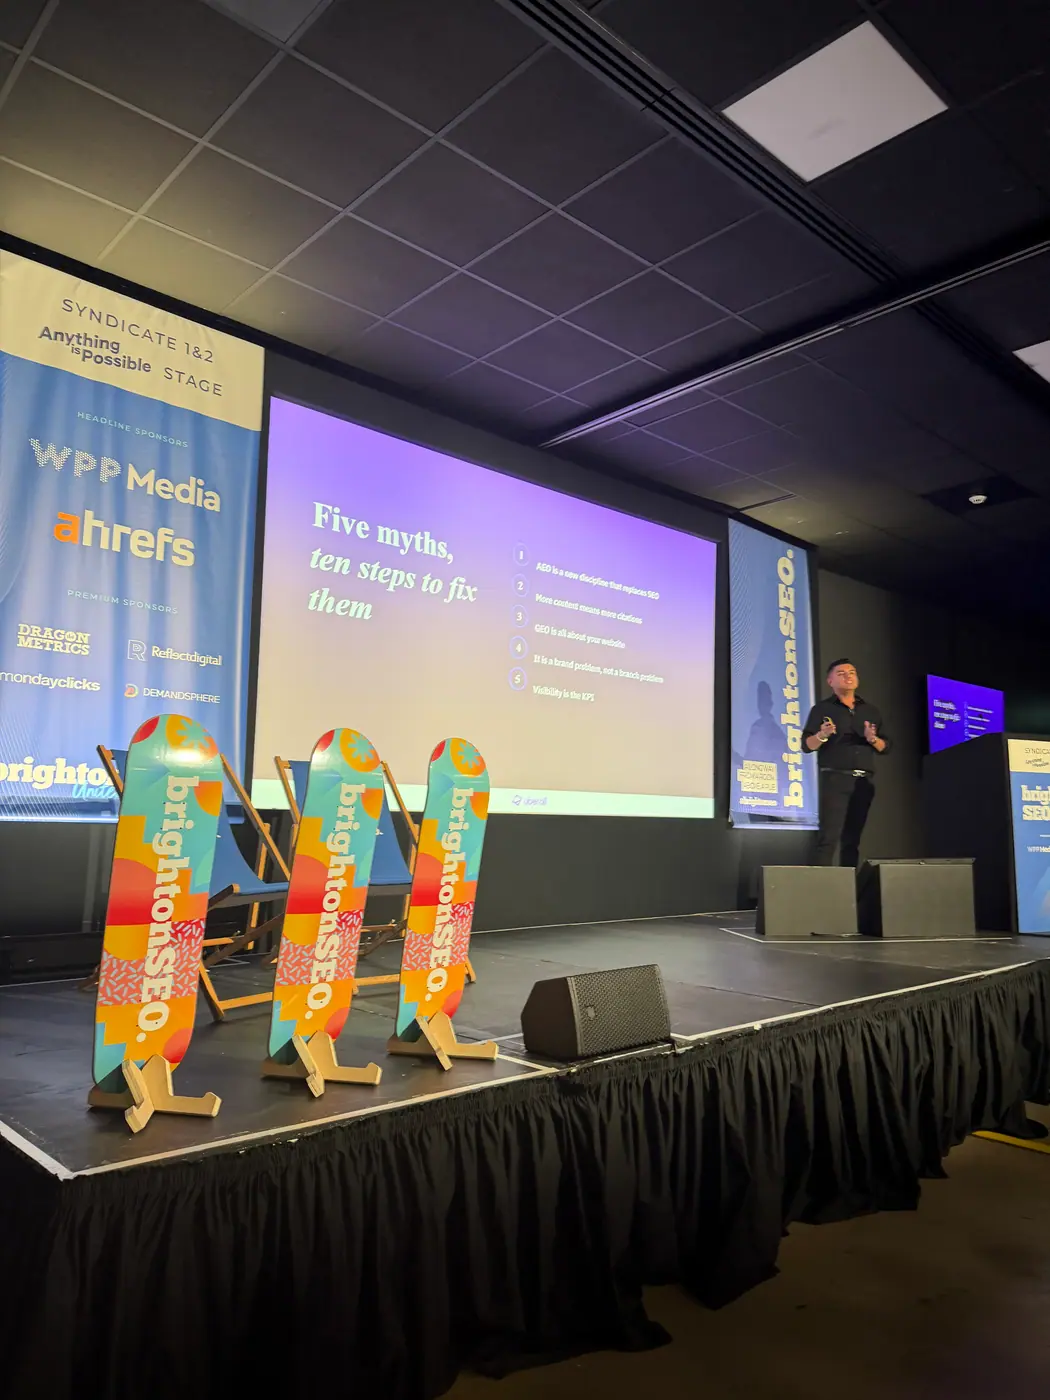
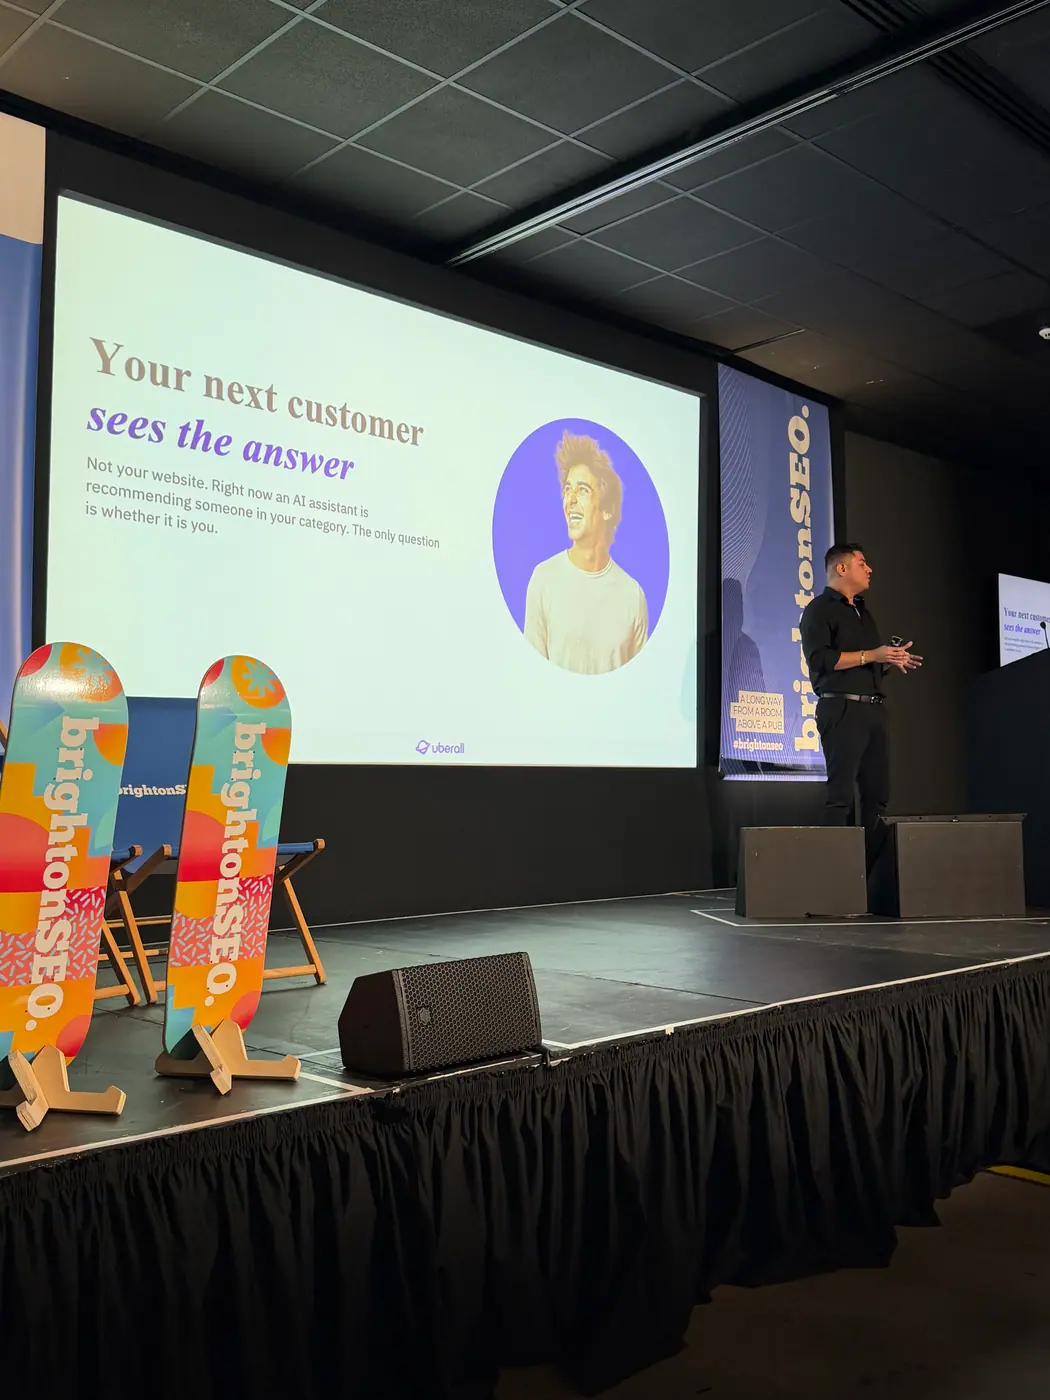
Jessica Hulbert: Stop Training Links, Start Training AI: Your Guide For E-E-A-T First Digital PR
15:50 · Auditorium 2
Streszczenie
Na brightonSEO 8 października 2026 r. Jessica Hulbert przekonywała, że digital PR (Digital Public Relations / cyfrowe działania budujące relacje z otoczeniem) powinien wspierać rozpoznawalność marki w AI (Artificial Intelligence / sztuczna inteligencja), a nie tylko pozyskiwać linki dla SEO (Search Engine Optimization / optymalizacja pod wyszukiwarki).
Zaproponowała konkretny schemat: własne dane + komentarz wskazanego z nazwiska eksperta + publikacje w wiarygodnych mediach. Powiązała go z E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness / doświadczenie, eksperckość, autorytet i wiarygodność). Uzupełnieniem miało być mierzenie cytowań oraz obecności marki i ekspertów w odpowiedziach AI.
Najważniejsze wnioski
- Rekomendacja strategiczna: rozszerzyć cel, nie porzucać linki. Hulbert podkreśliła, że dotychczasowe kompetencje zespołów PR pozostają przydatne. Zmienić powinien się przede wszystkim zakres oczekiwanych rezultatów i raportowania.
- Rekomendacja redakcyjna: dostarczać wiedzę, którą można przypisać do konkretnego źródła. Prelegentka stawiała na oryginalne badania, nazwiska ekspertów i ich kompetencje zamiast ogólnych stanowisk firmy oraz powielania branżowych trendów.
- Przykład z audytu: doświadczenie biznesowe nie gwarantowało obecności w odpowiedzi. W pokazanym zapytaniu o zaufanych ekspertów motoryzacyjnych model wskazał osoby związane z firmą badawczo-analityczną, a nie przedstawicieli producentów samochodów czy grup dealerskich.
- Rekomendacja pomiarowa: cytowanie źródła i rekomendowanie marki to różne rezultaty. Warto sprawdzać zarówno obecność własnych stron wśród źródeł, jak i występowanie marki lub jej ekspertów w treści odpowiedzi.
- Interpretacja prelegentki, nie potwierdzony mechanizm: Hulbert opisywała publikacje jako „trenowanie AI”. Nie należy przekładać tej metafory na obietnicę, że pojedynczy artykuł aktualizuje model albo że określona liczba zgodnych publikacji automatycznie zapewnia rekomendację.
Dane liczbowe i przykłady
| Wartość | Czego dotyczyła | Źródło przywołane przez prelegentkę |
|---|---|---|
| 35–55% | Zbieżność marek rekomendowanych przez silniki AI porównywane parami. Hulbert zwróciła uwagę, że różne cytowane źródła mogą prowadzić do rekomendowania tych samych marek. | Badanie opisane w Search Engine Journal |
| 239% | Mediana wzrostu cytowań w AI związana z dystrybucją earned media, czyli publikacji pozyskanych w zewnętrznych mediach. | Badania Stacker |
Te wartości dotyczyły rekomendacji i cytowań, nie wzrostu ruchu, liczby zapytań ofertowych czy sprzedaży.
Praktyczne rady
- Zacznij od audytu ekspertów w swojej kategorii. Zapytaj wybrany model językowy, kogo uznaje za zaufanych specjalistów w branży. Sprawdź, czy pojawiają się przedstawiciele Twojej firmy.
- Znajdź własny materiał źródłowy. Punktem wyjścia mogą być dane z firmowej platformy lub badanie ankietowe. Przykładem z wystąpienia była ankieta dotycząca nawyków ładowania samochodów elektrycznych.
- Połącz dane z człowiekiem i marką. Przygotuj interpretację wyniku przez wskazanego z nazwiska eksperta. W materiale dla mediów wyraźnie powiąż statystykę, jej źródło i autora komentarza.
- Rozszerz raportowanie. Obok linków sprawdzaj cytowania w AI Overviews (przeglądach generowanych przez AI w wynikach wyszukiwania), obecność ekspertów w odpowiedziach oraz współwystępowanie danych, nazwiska i marki w publikacjach.
Knowledge bombs
1. Silniki AI cytują różne źródła, ale polecają te same marki.
Prelegentka powołuje się na badanie Search Engine Journal z tego roku: różne silniki AI, porównywane parami, pokazują te same marki w około 35–55% przypadków. Jej wniosek: źródła się zmieniają, ale lista polecanych marek jest stabilna. Dlatego cel to dostać się do tego zestawu marek, a nie gonić pojedyncze cytowania.
„And they found that AI engines surface the same brands across pairs by about 35% to 55%, which is a really big brand overlap,”
„and the key takeaway from both of these things is that AI engines wonder on what they cite, but they hold fast onto who they recommend.”
2. „Consensus engineering”: trzy niezależne media z najwyższej półki z tym samym faktem dają AI „prawdę konsensusu”.
Systemy RAG szukają zgodności między zaufanymi źródłami. Jeśli trzy niezależne publikacje tier 1 podają ten sam fakt o marce albo cytują jej dane, AI uznaje to za prawdę. Według prelegentki jedna wzmianka tier 1 uczy model więcej niż 50 linków z niskiej półki, co odwraca logikę kampanii nastawionych na wolumen.
„Therefore, if three independent tier one publications state the same facts about your brand or site your data set, the AI engine accepts this as a consensus truth.”
„We need to understand that one tier reference trains the model far better than 50 low-tier links.”
3. Kampania, która streszcza znany trend, nie ma szans na cytowanie, bo liczy się information gain.
Prelegentka łączy „trustworthiness” z information gain: modele odfiltrowują przetworzone, powtarzalne treści. Kampania, która powtarza to, co opisało już 20 serwisów, nie daje LLM-owi powodu do cytowania. Szansę daje dopiero własne badanie albo nowy zbiór danych.
„If your PR campaign simply summarizes an industry trend that 20 other sites have already covered, the LLM has zero incentive to cite you.”
4. „Pakiet treningowy”: dane, nazwisko eksperta i marka w jednym akapicie publikacji.
Przepis na kampanię: (1) unikalna statystyka z danych wewnętrznych lub ankiety (np. nawyki ładowania aut elektrycznych), (2) nazwany rzecznik, który ją interpretuje (np. szef zarządzania flotą), (3) dystrybucja do mediów tier 1 w branży, tak żeby dane i ekspert pojawili się w pierwszym akapicie. Jej zdaniem ta współwystępowalność (semantic co-occurrence) uczy AI, że marka jest źródłem wiedzy.
„So when a journalist publishes your data, expert name, and brand in the same paragraph, you deliver a complete training bundle to the AI.”
5. Audyt encji: zapytaj LLM o „najbardziej zaufanych ekspertów” w swojej niszy. Wynik może zaskoczyć.
Prelegentka zrobiła to dla motoryzacji. ChatGPT pominął producentów i grupy dealerskie, a jako ekspertów wskazał osoby z S&P Global, firmy od danych i badań. Jej interpretacja: AI stawia niezależne platformy danych i badaczy ponad treści promocyjne marek. To prosty test na początek współpracy.
„As you can see on screen, ChatGPT completely filtered out traditional car manufacturers and dealer groups.”
„is because AI prioritizes independent data platforms and primary researchers over promotional brand content.”
6. Nazwany ekspert w pitchu wiąże autorytet konkretnej osoby z encją marki.
Prelegentka nazywa to „human vector”: AI śledzi ludzi jako osobne encje, więc cytaty z imieniem i nazwiskiem oraz kwalifikacje autora przenoszą autorytet tej osoby na markę. Wniosek praktyczny: zamiast ogólnych korporacyjnych oświadczeń pitchuj wiedzę konkretnych ludzi. To jej model działania, nie wynik badania.
„When you include name expert quotes and author credentials in your pitches, LLMs will bind that executive’s authority directly to your brand entity in its vector space.”
7. Nowe KPI w raportach PR: czy pojawia się nasz ekspert i jak często współwystępujemy z tematem w mediach tier 1.
Raporty miesięczne liczące tylko linki i DA trzeba uzupełnić o warstwę AI: cytowania URL-i w AI Overviews, obecność eksperta firmy w odpowiedziach na promptach branżowych i wskaźnik współwystępowania w mediach tier 1. Search Console tych danych nie daje, więc prelegentka poleca Ahrefs Brand Radar i podobne narzędzie w Semrush.
„Does our executive appear when clients run industry prompts? And what is our semantic co-occurrence rate in tier one publications?”
Zdjęcia: Jessica Hulbert
7 kadrów · Fot. Robert Nowaczyk
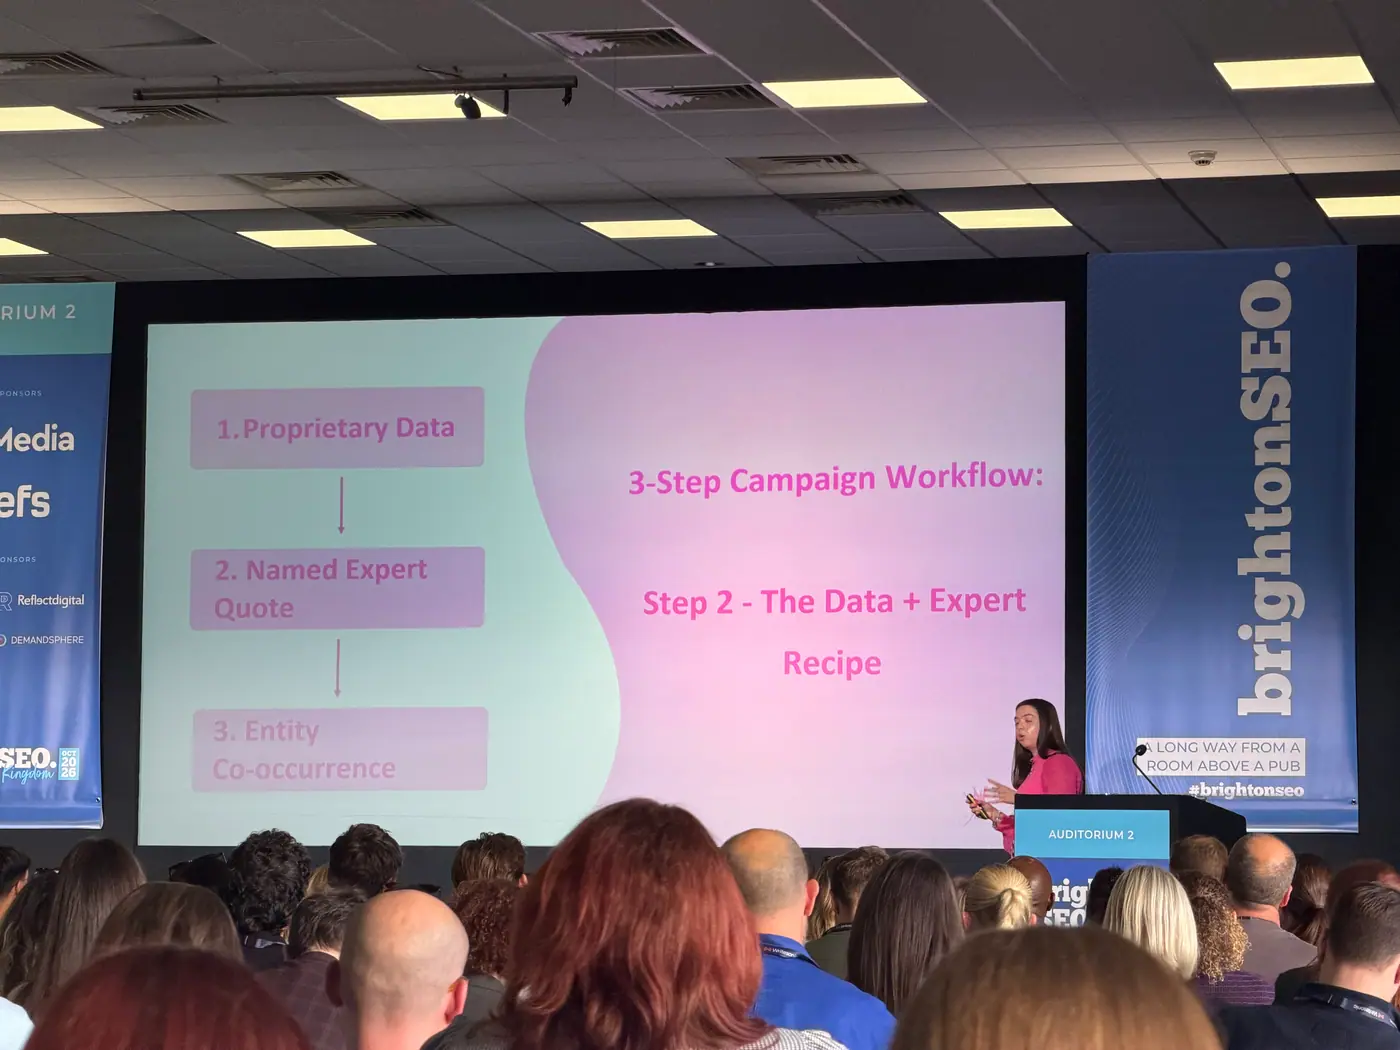
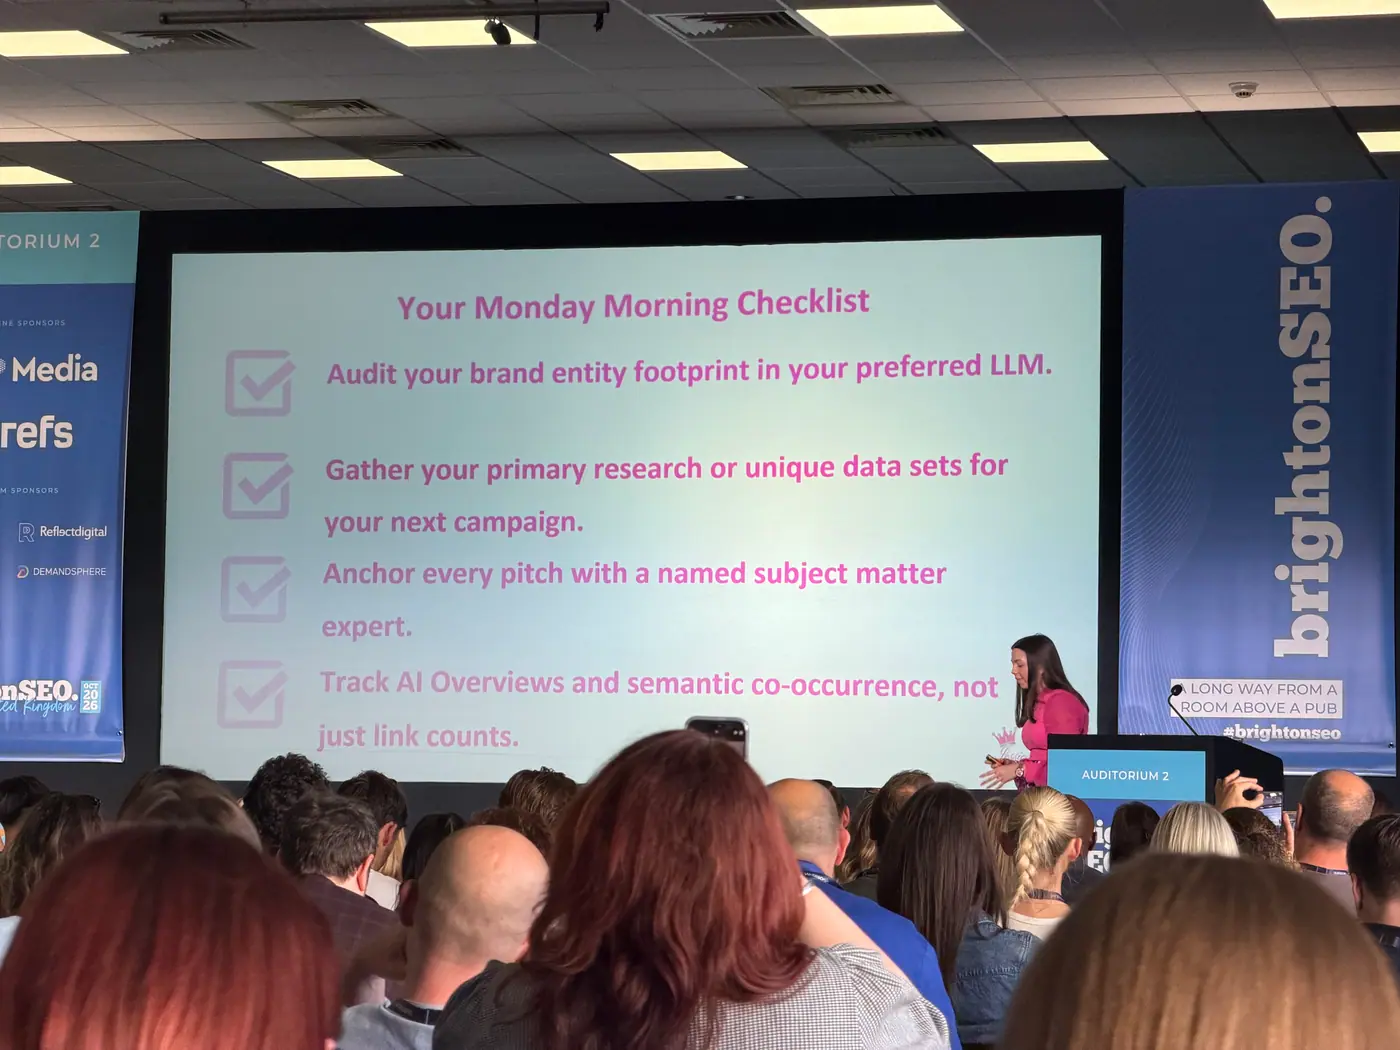
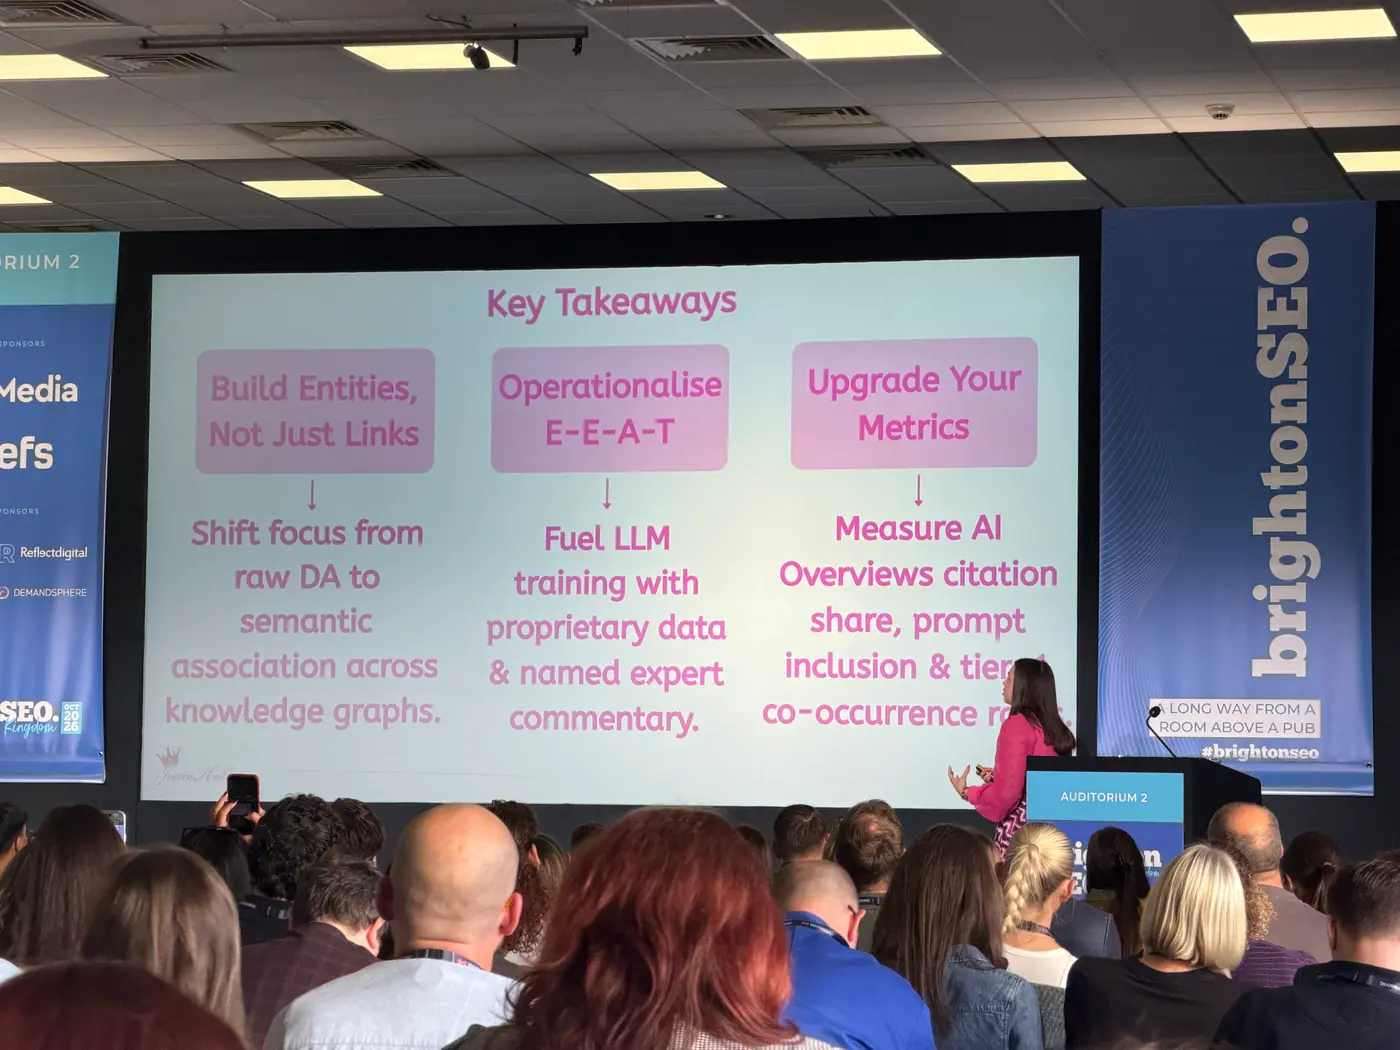
Jane Hunt: Prove It: A Digital PR Playbook for Winning AI Citations and Reporting GEO Impact
16:10 · Auditorium 2
Streszczenie
Jane Hunt podczas brightonSEO przedstawiła model digital PR (Public Relations / relacje z otoczeniem) nastawiony na widoczność w wyszukiwarkach AI (Artificial Intelligence / sztuczna inteligencja). Punktem wyjścia były pytania klientów, a nie pomysły na kampanie zdobywające linki.
Prelegentka uporządkowała proces w modelu 3P: prompts, publishers, proof, czyli pytania klientów, wydawcy i dowody wpływu. Na przykładach marki z branży zdrowotnej pokazała zarówno wzrosty widoczności, jak i mieszane wyniki. Podkreśliła też różnicę między udokumentowaniem rekomendacji produktu a udowodnieniem wpływu publikacji na przychód.
Najważniejsze wnioski
Brief powinien zaczynać się od konkretnego pytania zakupowego.
Hunt rekomendowała wybór pytań na podstawie ich znaczenia biznesowego, dopasowania produktu, intencji klienta, luki widoczności i możliwości dostarczenia wiarygodnych informacji. Sam potencjał zdobycia publikacji nie wystarczał.Właściwy format i konkretna strona mogą być ważniejsze niż prestiż wydawcy.
Przywołane badania wskazywały na znaczenie poradników zakupowych, porównań i zestawień. Prelegentka zalecała analizowanie stron już cytowanych przy wybranych pytaniach, zamiast budowania listy mediów wyłącznie według rozpoznawalności czy autorytetu domeny.Wzmianka, cytowanie i rekomendacja to różne rezultaty.
Hunt za najważniejszy cel uznała rekomendację marki lub produktu. Sama obecność źródła w odpowiedzi nie oznaczała jeszcze, że system polecił klientowi konkretną ofertę.Wynik zbiorczy może ukrywać utratę widoczności przy ważnych pytaniach.
W jednym z przykładów produkt zajmował pierwszą pozycję względem konkurencji, ale jednocześnie tracił widoczność dla części monitorowanych potrzeb klientów.Raportowanie GEO wymaga oddzielenia obserwacji od przypisania przyczyny.
W GEO (Generative Engine Optimization / optymalizacja widoczności w wyszukiwarkach generatywnych) można dokumentować zmiany odpowiedzi, rekomendacje i udział względem konkurencji. Przypisanie całego wzrostu jednej kampanii albo przełożenie go na przychód wymaga dodatkowych dowodów.
Dane liczbowe i przykłady
Poniżej rozdzielono wyniki przywołanych badań, obserwacje z działań oraz przykład raportowania.
| Obszar | Dane przedstawione przez Hunt |
|---|---|
| Zakres testu marki zdrowotnej | 50 pytań o znaczeniu komercyjnym, 4 produkty i 4 platformy AI. |
| Format cytowanych treści – przywołane badanie | 58% cytowań pochodziło z treści komercyjnych, m.in. zestawień, poradników zakupowych i recenzji. Artykuły newsowe stanowiły 5%. |
| Rozpoznawalność wydawcy a cytowania | Blisko połowa cytowań Forbes dotyczyła poradników zakupowych i zestawień. W analizie 825 tys. cytowań zdrowotnych udział WebMD wynosił 0,2%. |
| Umowy licencyjne – badanie z 2026 roku | Wydawcy z umowami z OpenAI otrzymywali o 48% więcej cytowań w ChatGPT na cytowaną stronę. Hunt zaznaczyła, że była to zależność statystyczna, nie dowód wpływu samej umowy. |
| Media niszowe i branżowe | W 16 branżowych zestawach pytań zdobyły 75% nowych cytowań, wobec 24% dla mediów głównego nurtu. |
| Kampania dotycząca steroli roślinnych | 8 publikacji regionalnych, 25 linków do odpowiednich stron produktów. Liczba cytowań domeny wzrosła ze 172 do 225, a wskaźnik „brand coverage” o 3%. |
| Mieszane wyniki suplementu laktazy | 41% share of voice, czyli udziału widoczności marki na tle konkurencji, i pierwsza pozycja. Jednocześnie raportowany wskaźnik „coverage” spadł z 32 do 28, a kierunek zmian zależał od pytania. |
| Publikacja dotycząca L-teaniny | Dzień po publikacji w BBC Good Food odnotowano rekomendację w AI Overviews, czyli generowanych przez AI podsumowaniach w Google. Pięć dni później wydawca należał do najważniejszych źródeł dla tego produktu w narzędziu monitorującym. |
| Przykład raportu za trzy miesiące | Cytowania domeny wzrosły z 589 do 1500, a share of voice osiągnął 42%. Jednocześnie wskazany zakres śledzonych pytań zwiększył się z 9 do 26, więc nie było to porównanie przy niezmienionym zakresie pomiaru. |
Ocena dowodów: sekwencja publikacja → rekomendacja → obecność wydawcy wśród źródeł była wartościową obserwacją. Nie dowodziła jednak sama w sobie, że publikacja była jedyną przyczyną zmiany.
Rekomendacja prelegentki, nie uniwersalny próg: Hunt sugerowała analizowanie danych z 6–12 miesięcy, zamiast oceniania trwałych efektów wyłącznie po trzymiesięcznym pilotażu.
Praktyczne rady
- Zbuduj zestaw pytań obejmujący pięć etapów: problem, edukację, porównanie, rekomendację i weryfikację, czy produkt pasuje do konkretnej osoby.
- Ustal priorytety biznesowe. Oceń znaczenie pytania dla sprzedaży, dopasowanie produktu, intencję, obecność konkurencji i jakość dowodów, które możesz dostarczyć.
- Zamroź zestaw przed rozpoczęciem działań. Zapisz punkt wyjścia i definicje wskaźników, aby późniejsze porównania dotyczyły tego samego zakresu.
- Buduj listę mediów na poziomie konkretnych stron. Sprawdź cytowany artykuł, autora lub zespół recenzujący, częstotliwość aktualizacji i wymagania dotyczące włączenia produktu.
- Po publikacji ponów pomiar. Sprawdzaj osobno wzmianki, cytowania i rekomendacje, z podziałem na pytania, produkty oraz platformy.
- Raportuj trzy warstwy: widoczność, zmianę względem konkurencji oraz sygnały biznesowe, takie jak wyszukiwania marki, ruch i konwersje wspomagane. Nie traktuj ich automatycznie jako efektu jednej publikacji.
Knowledge bombs
1. Ponad połowa cytowań AI pochodzi z treści zakupowych, a nie z newsów.
Prelegentka powołuje się na badanie (bez nazwy w nagraniu), według którego 58% cytowań pochodzi z treści komercyjnych: rankingów „best of”, list top, poradników zakupowych i recenzji produktów. Datowane newsy to około 5%. Wniosek: miejsce w poradniku zakupowym bywa cenniejsze niż duży news, pod który PR zwykle zdobywał linki.
„So, one study showed that 58% of citations come from commercial content alone. And that’s the best of, top lists, buying guides, product reviews, etc.”
2. Forbes jest cytowany głównie za poradniki zakupowe, a WebMD prawie wcale.
Według prelegentki prawie 50% cytowań Forbesa w AI to poradniki zakupowe i listy „best of” (Forbes Vetted, Advisor, Forbes Health), a nie treści biznesowe. WebMD, kojarzony z branżą zdrowotną, ma tylko 0,2% z 825 000 cytowań zdrowotnych, a YouTube 3%. Rozpoznawalność wydawcy nie przekłada się więc na cytowania.
„It’s actually nearly 50% of citations on there are buying guides and best of lists.”
„And across 825,000 health citations, WebMD only was cited 0.2%, which is so low.”
3. Pitchuj konkretną stronę, nie tytuł: lista mediów to strony, które AI już cytuje dla promptu.
Dla każdego promptu zapisz cytowane domeny i konkretne URL-e (np. „11 of the best collagen supplements” na Vogue i Health.com), ich format, źródła, które się powtarzają, i konkurentów obecnych w zestawieniu. Następnie sprawdź redaktora i zespół recenzentów, jak często artykuł jest aktualizowany i jakich dowodów wymaga, żeby dodać produkt.
„And then, instead of targeting the publication, you want to target the page.”
4. Wydawcy z umowami licencyjnymi OpenAI mają o 48% więcej cytowań w ChatGPT na cytowaną stronę, ale to korelacja.
Prelegentka powołuje się na badanie Otterly (w nagraniu „Otterley”) i Press Ranger z 2026 r. Sama zaznacza, że badanie pokazuje związek, a nie dowód, że to umowa powoduje różnicę. Licencja to więc jeden z sygnałów przy priorytetyzacji mediów, nie skrót. Wspomina też, że w Copilocie ta różnica jest większa.
„they found that publishers with OpenAI licensing deals received 48% more ChatGPT citations per cited page.”
5. Media niszowe i branżowe zdobyły 75% nowych cytowań, a mainstream około 24%.
Dane z 16 zestawów promptów branżowych (prelegentka nie mówi wprost, czy to to samo badanie co wyżej). To mocny argument przeciw gonieniu wyłącznie dużych tytułów, zwłaszcza w B2B i niszach.
„And across 16 industry prompt sets, niche and trade media received 75% of new citations.”
6. Zestaw promptów: pięć typów, scoring i „zamrożenie” przed startem działań.
Pięć typów promptów: problem, edukacja, porównanie, rekomendacja, walidacja („czy to zadziała u mnie i dlaczego”). Każdy oceniasz pod kątem znaczenia komercyjnego, dopasowania produktu, intencji, obecnej luki w widoczności (i kto z konkurencji się pojawia) oraz tego, czy masz wiarygodne dowody do wniesienia. Bez takich dowodów nie warto atakować promptu. Zestaw zamrażasz przed rozpoczęciem działań i utrzymujesz w mierzalnej wielkości.
„So, once you’ve got your prompt, you want to freeze that set before any activity begins.”
7. Nie wszystko działa: produkt z 41% share of voice miał mieszane wyniki.
Prelegentka otwarcie pokazała porażkę. Suplement z laktazą na papierze był najmocniejszy (41% share of voice, pierwsza pozycja wśród konkurentów), ale w ramach zestawu promptów widoczność skakała. W jednych promptach (np. wzdęcia w święta) produkt wszedł na pierwsze miejsce, w innych (ukryty nabiał, dolegliwości trawienne) spadał. Wynik trzeba czytać na poziomie promptów, a nie jednej średniej.
„However, within the prompt set, movement was going up and down.”
8. Raport w trzech warstwach i lista „czego nie możemy twierdzić”.
Warstwy raportu: (1) widoczność, czyli wzmianka, cytowanie lub rekomendacja w ważnych promptach, (2) zmiana udziału względem konkurentów, (3) sygnały biznesowe, takie jak wyszukiwania brandowe, ruch i konwersje wspomagane. Osobno trzeba wypisać, czego bez dowodów się nie twierdzi: że jedna publikacja dała przychód, że cały wzrost to zasługa PR, że wynik z jednego miesiąca to trend.
„And then we have to be really careful about what we don’t claim without real evidence.”
Zdjęcia: Jane Hunt
7 kadrów · Fot. Robert Nowaczyk
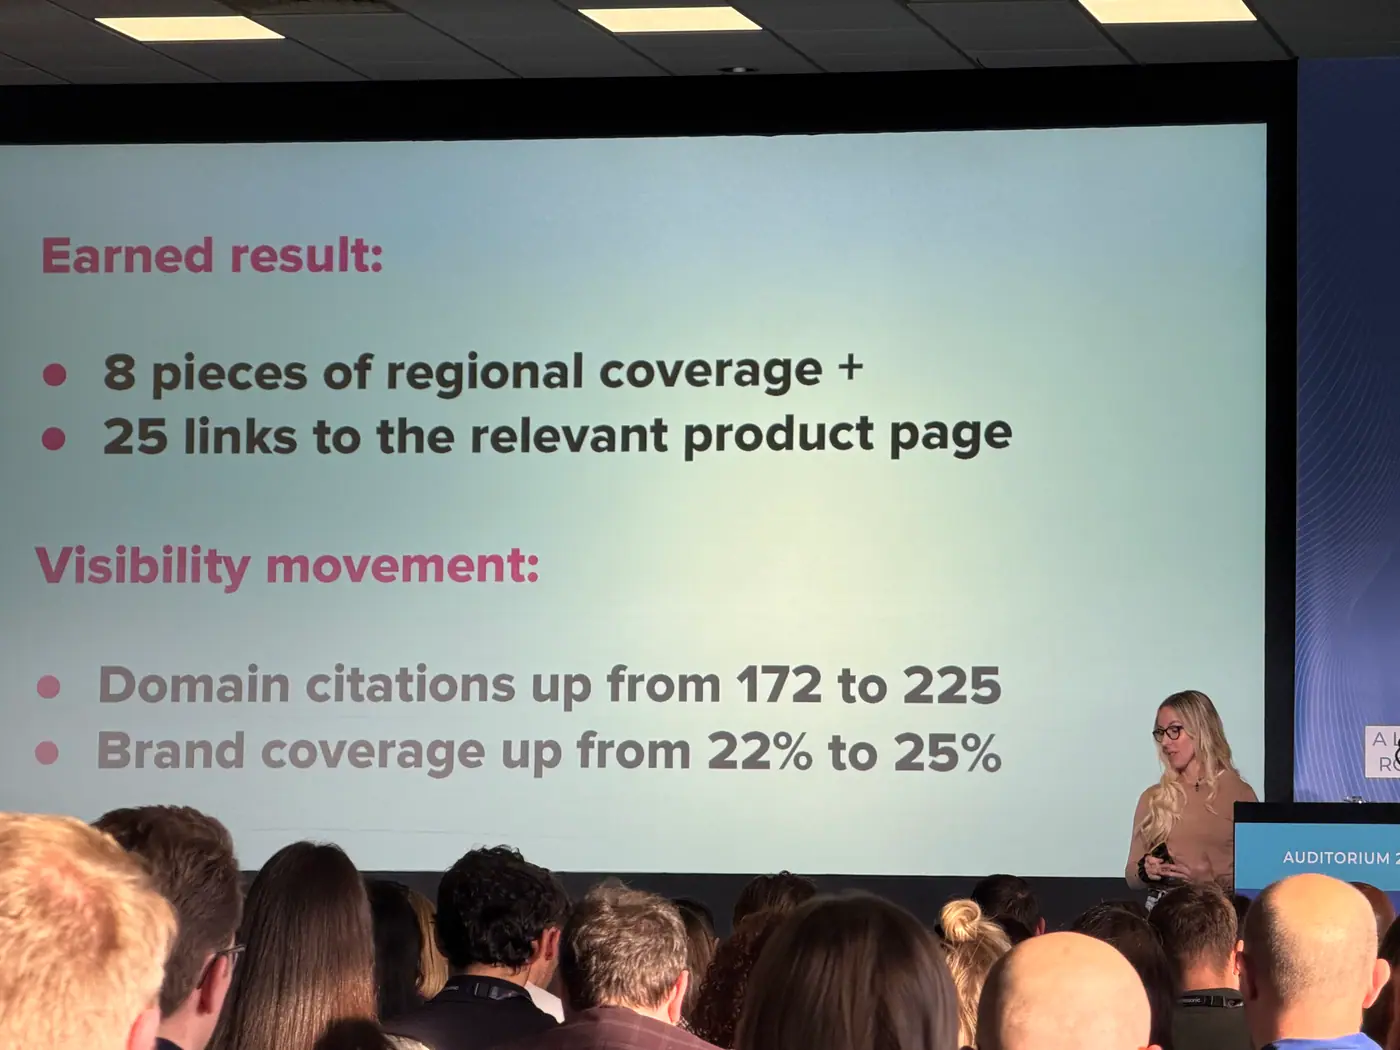
John Iwuozor: 5 Things Google Patents Reveal About Why SEO Feels Harder in 2026
17:00 · Auditorium 1
Streszczenie
John Iwuozor podczas brightonSEO, 8 października 2026, omówił pięć obszarów wpływających na złożoność SEO (Search Engine Optimization / optymalizacja pod wyszukiwarki): rozwijanie zapytań, kontekst użytkownika, interpretację marki jako encji, wybór fragmentów treści oraz sposób prezentowania odpowiedzi.
Najważniejszy wniosek strategiczny: warto optymalizować nie tylko stronę pod frazę, lecz także konkretne odpowiedzi, spójność informacji o marce i dopasowanie do potrzeb użytkownika.
Opisy patentów należy oddzielić od interpretacji prelegenta i prognoz. Sam patent nie potwierdza wdrożenia danego rozwiązania w wyszukiwarce.
Najważniejsze wnioski
Jedno pytanie może uruchamiać wiele wyszukiwań. Prelegent opisał rozwijanie zapytań obejmujące podtematy, tłumaczenia, przeformułowania i pytania doprecyzowujące. Pokazał również wyszukiwania ograniczone do konkretnej domeny operatorem
site:.Kontekst może zmieniać interpretację kolejnego pytania. Omawiając patent Stateful Chat, Iwuozor przedstawił stan użytkownika: reprezentację uwzględniającą wcześniejsze zapytania i odpowiedzi. Wskazał lokalizację, historię, preferencje i pamięć jako elementy kontekstu.
Obraz marki nie powstaje wyłącznie na jej stronie. Według interpretacji prelegenta informacje z własnej domeny, publikacji zewnętrznych i wypowiedzi konkurentów mogą współtworzyć charakterystykę marki jako encji, czyli rozpoznawalnego podmiotu wraz z jego cechami i relacjami.
Trafność strony nie gwarantuje wyboru jej fragmentu. Opisany patent porównywał dwa fragmenty względem zapytania i wykorzystywał decyzję modelu do ustalenia ich kolejności. Iwuozor rekomendował odpowiedzi, które zachowują sens także poza kontekstem całego artykułu.
Interfejs odpowiedzi może być budowany wokół zadania użytkownika. Prelegent omówił grupowanie treści w tematy oraz stronę odpowiedzi dopasowaną do zapytania. Dalszy rozwój takich rozwiązań przedstawił jako kierunek, nie jako pewną zmianę z konkretnym terminem.
Sama liczba cytowań nie wystarcza do oceny widoczności. Iwuozor zalecił mierzenie również wzmianek, rekomendacji i ich wydźwięku. Obecność marki w odpowiedzi nie musi oznaczać pozytywnego przedstawienia jej oferty.
Dane liczbowe i przykłady
- 85% wzmianek o markach miało pochodzić z treści podmiotów trzecich w badaniu AirOps przywołanym przez prelegenta. To argument za analizowaniem informacji o marce poza własną domeną.
- 0,95 i 0,81 na skali 0–1 były ilustracyjnymi ocenami dwóch porównywanych fragmentów. Służyły wyjaśnieniu mechanizmu, a nie przedstawieniu wyników eksperymentu czy progów widoczności.
Praktyczne rady
- Rozbuduj analizę zapytań: obok frazy zapisz podtematy, pytania doprecyzowujące i możliwe kontynuacje rozmowy.
- Uwzględnij kontekst: sprawdź, jak lokalizacja, preferencje i wcześniejsze wymagania zmieniają potrzebną odpowiedź.
- Sprawdź spójność marki: porównaj własne opisy z recenzjami, porównaniami i innymi publikacjami zewnętrznymi.
- Testuj samodzielność fragmentów: po wyjęciu z artykułu odpowiedź powinna nadal jasno wyjaśniać temat, zawierać potrzebny kontekst i uzasadnienie.
- Rozdziel miary widoczności: osobno oceniaj cytowanie, wzmiankę, rekomendację oraz pozytywny lub negatywny wydźwięk.
Knowledge bombs
1. Fan-out to nie tylko synonimy – to także tłumaczenia, przeformułowania, pytania doprecyzowujące, a w ChatGPT nawet zapytania z operatorem site:.
Rozbijając pytanie na podzapytania, systemy AI generują zapytania różnych typów: przeformułowania, pytania doprecyzowujące i uzupełniające, warianty „specification”. Prelegent pokazywał, że ChatGPT potrafi wysyłać zapytania z operatorem site: – czyli wprost celuje w konkretne domeny, a nie tylko w długie frazy.
„So, and these are not just synonyms, so you could have like translations, it could be rewrites, it could be clarification questions.”
„For example, if you look at this from ChatGPT, the query format, it could also produce site-specific searches, so it’s not just some very lengthy queries, it could also produce things with the site operator.”
2. Patent „Stateful Chat”: stan użytkownika zasila silnik kontekstu, który generuje syntetyczne zapytania.
Według opisu prelegenta Google buduje „user state” (użytkownik zapisany jako liczby) z wcześniejszych zapytań i odpowiedzi, a ten stan napędza generowanie syntetycznych wyszukiwań. Przykład: po pytaniu o hotel w Londynie kolejne pytanie o „coś blisko Oxfordu” jest już interpretowane w kontekście Londynu. Wniosek: to samo zapytanie u dwóch użytkowników uruchamia inne podzapytania – klasyczne śledzenie pozycji fraz tego nie odda.
„The user state feeds your context engine, which then generates synthetic searches.”
3. Google składa obraz marki z atrybutów i relacji wyciąganych z domeny – i z tego, co mówią inni.
Prelegent opisuje patent, w którym Google crawluje domenę, wyciąga z niej atrybuty i relacje, a następnie łączy to z wypowiedziami stron trzecich i konkurencji w „interpreted characterization” marki. Brakujące, sprzeczne lub źle wyrażone informacje bezpośrednio kształtują to, jak encja zostanie scharakteryzowana – stąd nacisk na spójność komunikatów o marce w całej sieci.
„Google would crawl your domain and use an element to extract attributes and relationships from that particular domain to be able to put things together. The whole point is they’re trying to turn it into an interpreted characterization.”
4. Pasaże walczą „head-to-head”: model porównuje dwa kandydujące fragmenty i wybiera lepszą odpowiedź.
Opisany patent porównuje parami dwa pasaże względem zapytania i decyzją modelu ustala, który jest wyżej (prelegent podał przykładowe wyniki 0,95 vs 0,81 w skali 0–1). Wniosek: trafność już nie wystarcza – strona może być relewantna i mimo to przegrać ze „sharper page”, czyli fragmentem, który odpowiada wprost i precyzyjniej.
„I looked at a particular patent, and this patent compares two candidates’ passages against a query and uses the model decision to determine which one ranks higher.”
„So in other words, your page can be relevant and still lose to a sharper page.”
5. Pasaż musi „stać sam” – klarowna definicja + kontekst + dowody i liczby.
Na przykładzie własnego artykułu o LLMO dla firmy Progress prelegent pokazuje wzorzec fragmentu, który wygrywa porównanie: jasna odpowiedź na pytanie „co to jest”, kontekst, dowody i liczby. Projektuj sekcje tak, by po wyjęciu z artykułu nadal były kompletną odpowiedzią.
„I provided context, there was evidence, numbers, so you want to be able to build passages that, when Google retrieves this and compares it against your competitors, yours is able to be recommended to readers.”
6. Generative UI i patent „thematic search”: wyniki układane w dynamiczne tematy zamiast listy linków.
Prelegent łączy wprowadzone przez Google „generative UI” z patentem „thematic search”, który pobiera dokumenty, streszcza pasaże i grupuje je w tematy (przykład „moving to Denver” → dzielnice, koszty życia, atrakcje, plusy i minusy). Wspomina też patent opisujący stronę alternatywną generowaną przez AI pod zapytanie użytkownika – sam zastrzega, że to raczej sygnał kierunku niż coś, co już działa.
„So this patent, thematic search, retrieves documents, summarizes the passages, and then, you know, turn posters into themes.”
7. Mierz nie tylko cytowania, ale też to, czy i jak (pozytywnie/negatywnie) jesteś rekomendowany.
Kluczowe rozróżnienie do raportowania GEO: cytowanie ≠ rekomendacja, a rekomendacja może mieć negatywny wydźwięk. Prelegent wymienia jako metryki: cytowania, wzmianki, sentyment i rekomendacje.
„you need to measure whether you’ve been recommended, because you could be cited, and you could also be recommended negatively.”
Zdjęcia: John Iwuozor
23 kadrów · Fot. Robert Nowaczyk
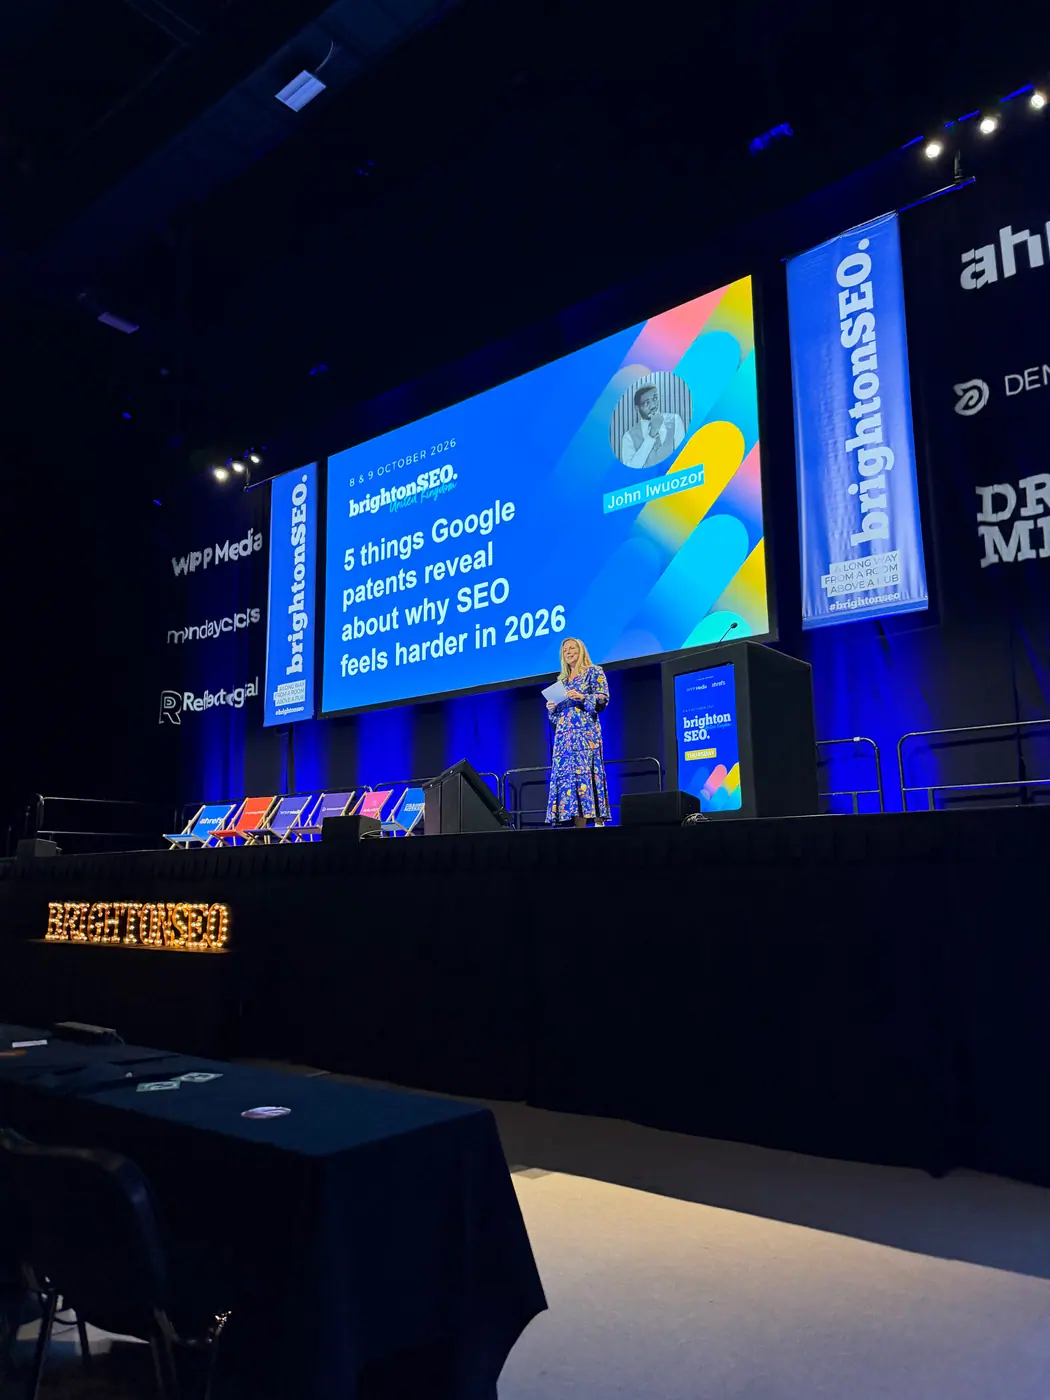
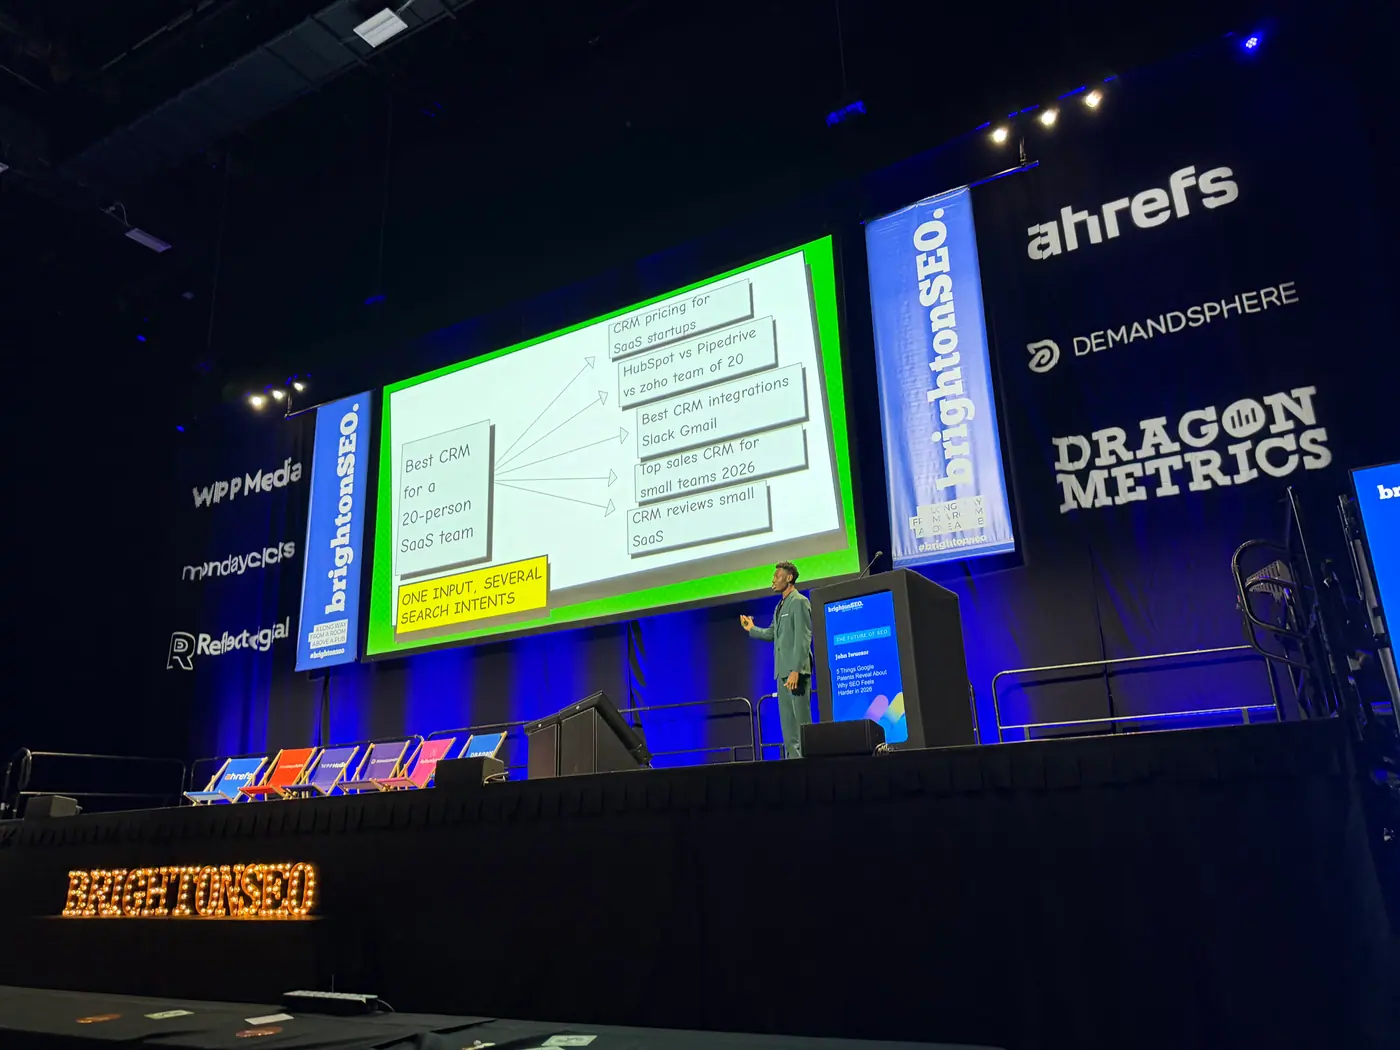
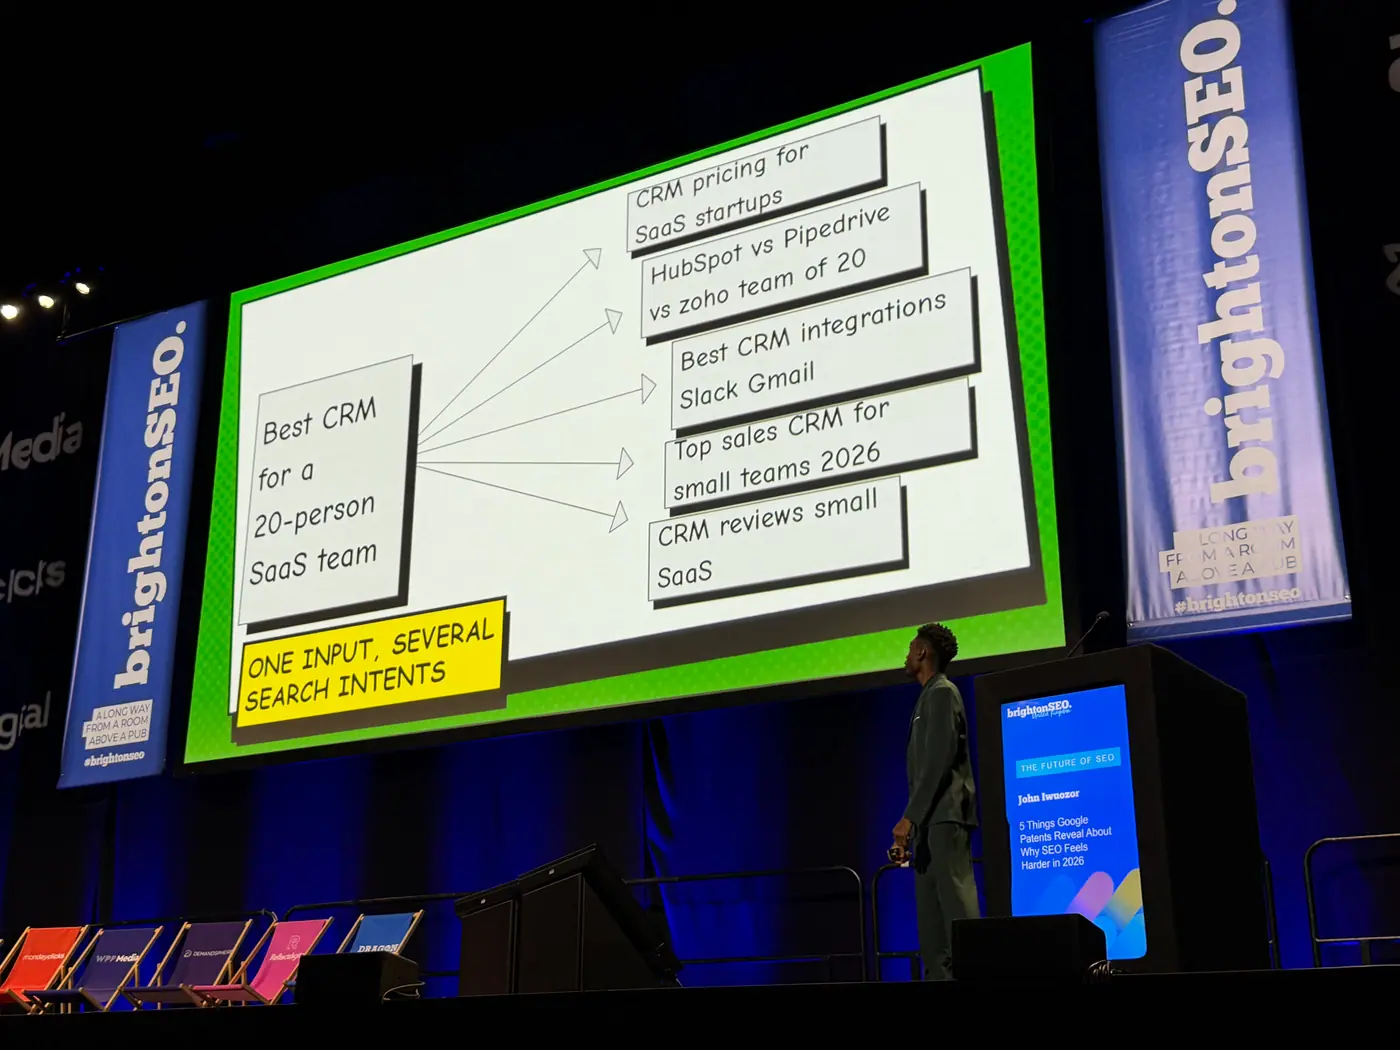
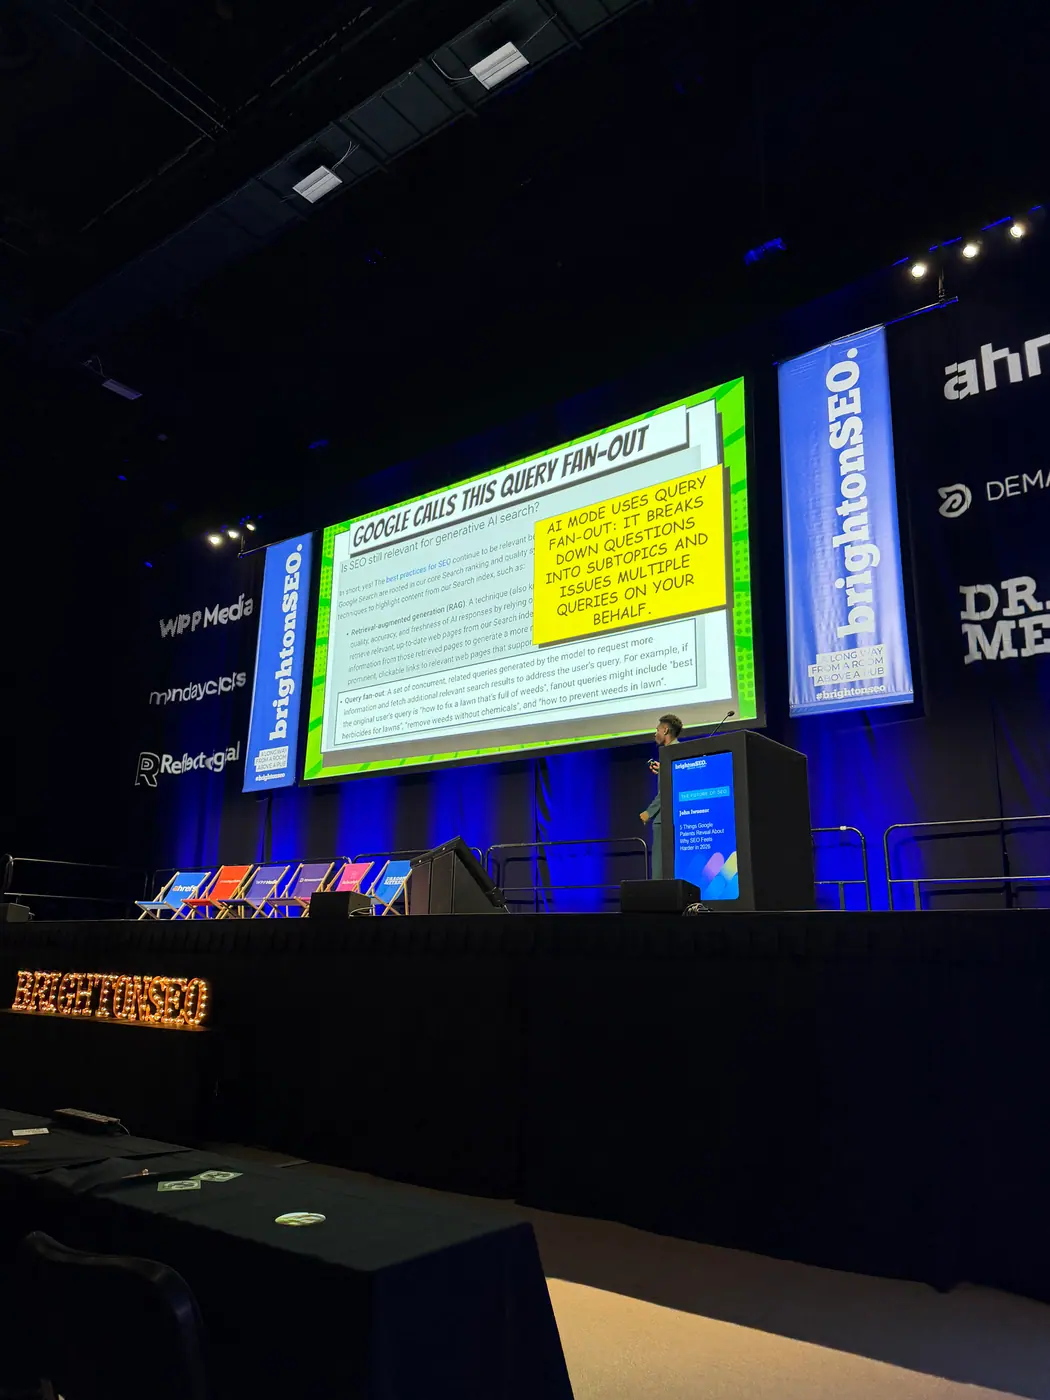
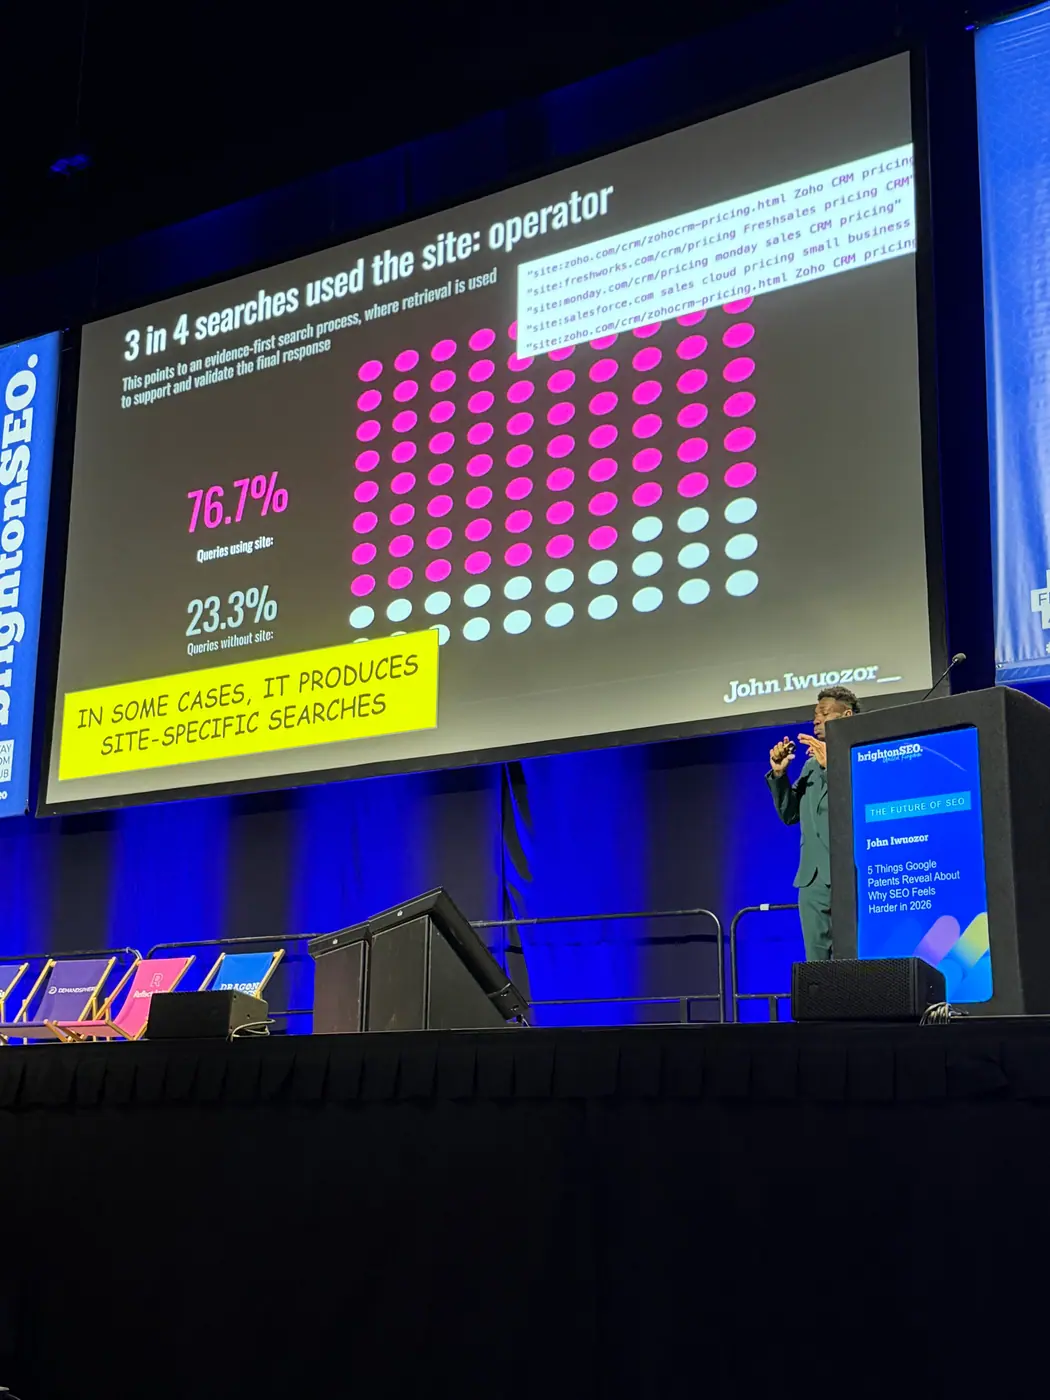
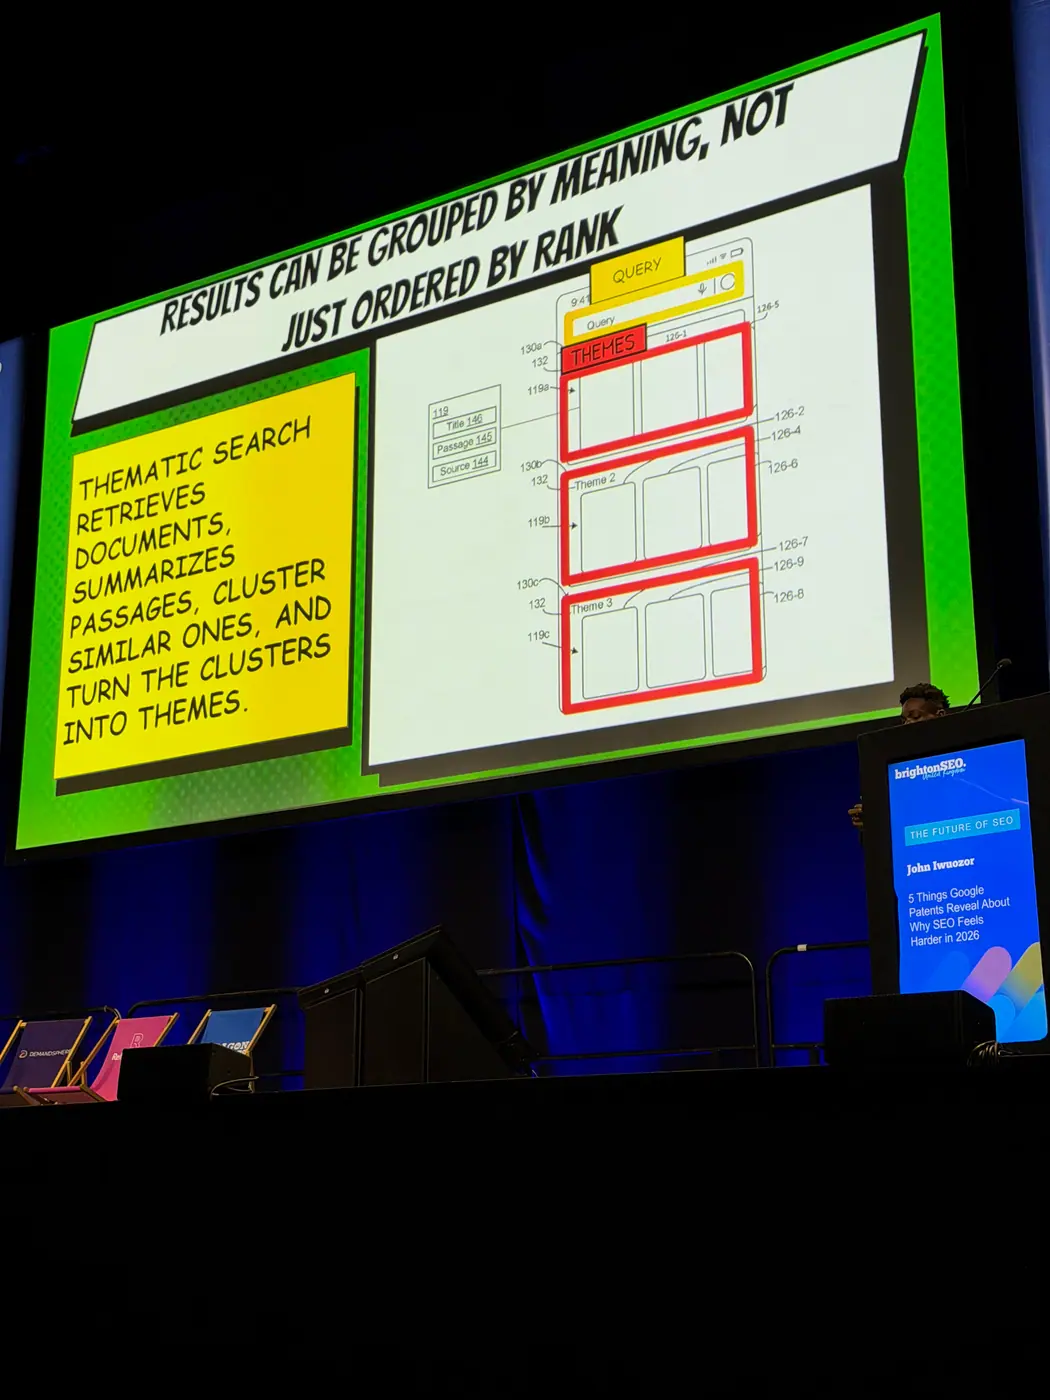
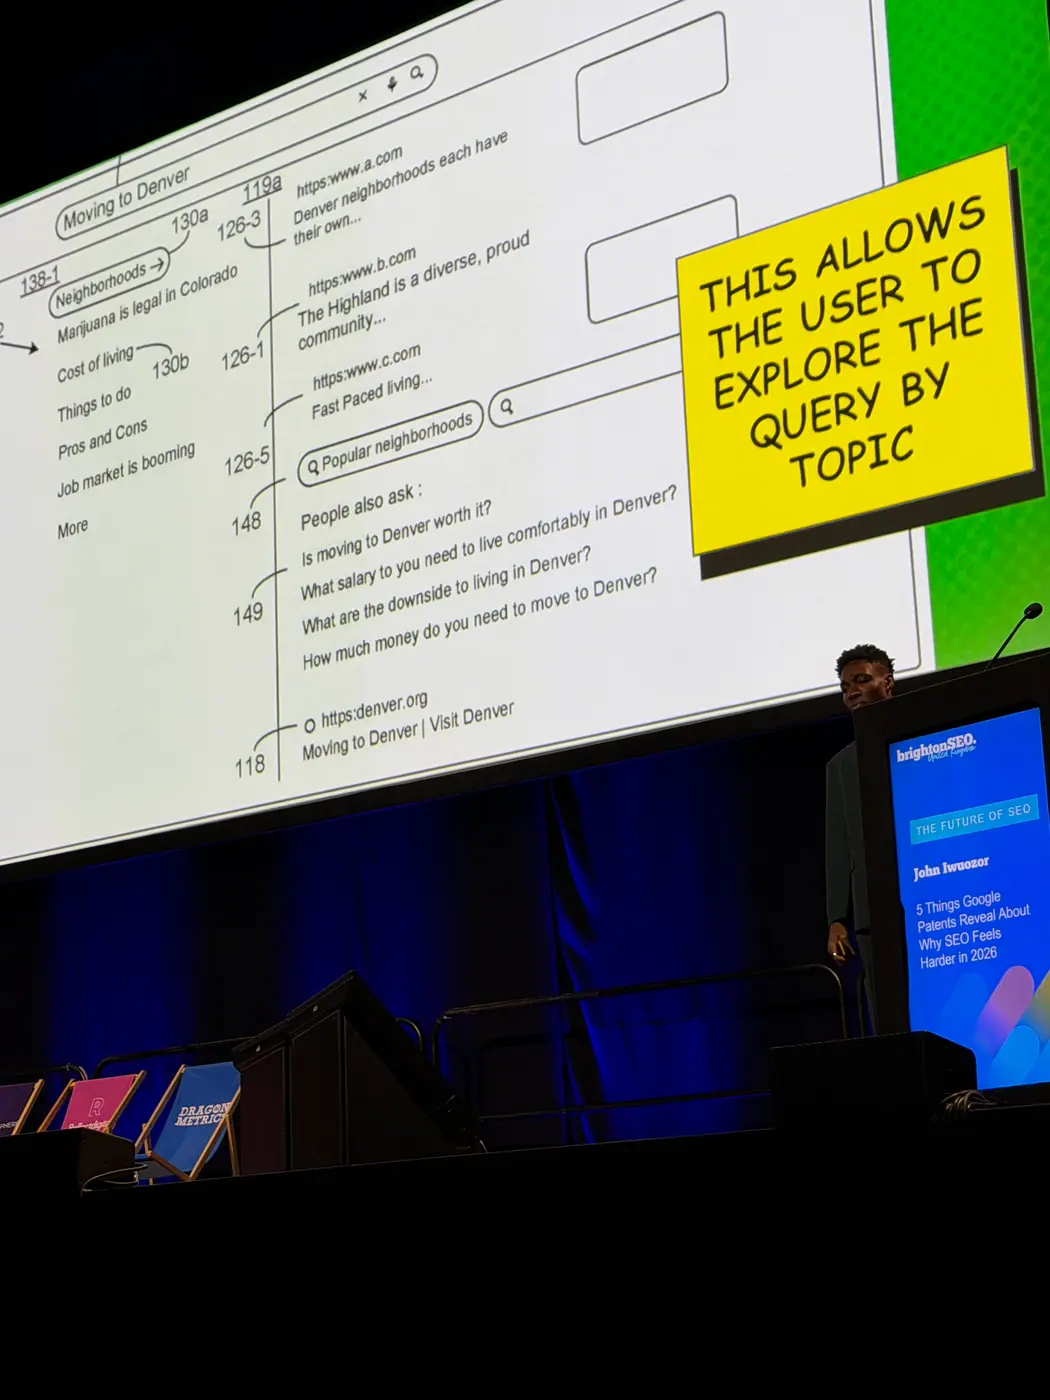
Ryan Law: How We Built a Content Engineering System for the Ahrefs Blog
17:20 · Auditorium 1
Streszczenie
Ryan Law przedstawił, jak zespół bloga Ahrefs zbudował system wykorzystujący AI (Artificial Intelligence / sztuczna inteligencja) do tworzenia informacyjnych treści SEO (Search Engine Optimization / optymalizacja pod kątem wyszukiwarek). Proces obejmował działania od analizy słów kluczowych do publikacji, ale pozostawał pod nadzorem ludzi.
Celem nie było masowe zwiększenie liczby artykułów. Chodziło o ograniczenie powtarzalnej pracy, utrzymanie standardów redakcyjnych i uwolnienie czasu na badania oraz inne działania wymagające wiedzy zespołu. Prelegent pokazał też, jak wyjść poza generowanie tekstu: tworzyć aktualizowane zestawienia, interaktywne rekomendacje i narzędzia osadzone w artykułach.
Najważniejsze wnioski
Opis wdrożenia: automatyzacja miała wąskie zastosowanie.
System obsługiwał informacyjne treści pozyskujące ruch z wyszukiwarki, a nie całą działalność redakcyjną. Według Lawa część wygenerowanych artykułów należała do najlepiej działających publikacji, a część osiągała słabsze wyniki. Zespół nie zwiększył znacząco częstotliwości publikacji.Opis procesu: jakość wynikała z zapisania pracy redakcyjnej w małych procedurach.
Analiza fraz, konkurencji, źródeł, przygotowanie konspektu i pisanie zostały rozdzielone na skill files, czyli pliki opisujące procedury wykonywane przez model. Wynik jednego etapu zasilał kolejny. Zespół zapisywał rezultaty poszczególnych kroków, żeby ustalać źródła błędów.Opis nadzoru: człowiek dostarczał wiedzę przed generowaniem i oceniał rezultat.
Autorzy przekazywali kontekst, przykłady, doświadczenia i kierunek artykułu na początku pracy. Mogli też korygować konspekt oraz wersję roboczą. Prelegent przyznał, że zespół odrzucał teksty dotyczące tematów, których nie znał wystarczająco dobrze, aby ocenić jakość.Opis źródeł: system korzystał z materiałów wykraczających poza wyniki wyszukiwania.
Uwzględniał wypowiedzi ekspertów, publikacje branżowe w mediach społecznościowych, archiwum bloga i udokumentowane zastosowania produktów. Osobne wzorce opisywały styl autorów. Wykresy i diagramy powstawały najczęściej programistycznie, zamiast przez generowanie obrazów.Opinia prelegenta: mniejszy zwrot z treści wymagał zmiany kosztów ich produkcji.
Law uznał, że AI osiągnęła poziom wystarczający do tworzenia dobrych treści informacyjnych. Przekonywał, że przy malejącej liczbie kliknięć trzeba ograniczać koszty powtarzalnej pracy, a kompetencje ludzi kierować tam, gdzie automatyzacja radzi sobie gorzej.Wdrożenie i oczekiwania należy rozdzielić.
Comiesięczna aktualizacja rankingu startupów była konkretnym przykładem działającej automatyzacji. Quiz rekomendujący narzędzia i narzędzie poprawiające prompty pojawiły się jako pomysły na rozszerzenie artykułów. Większe zaangażowanie, niższy współczynnik odrzuceń i lepsze pozycje były oczekiwanymi korzyściami, nie przedstawionymi wynikami tych rozwiązań.
Dane liczbowe i przykłady
| Liczba | Znaczenie w prezentacji |
|---|---|
| 58% | Średni spadek klikalności wyniku na pierwszej pozycji związany z obecnością AI Overviews, według badania Ahrefs przywołanego przez prelegenta. |
| Około 10 minut | Deklarowany czas wykonania procesu przez system. |
| Około 2 dolarów | Deklarowany koszt uruchomienia procesu, zależny od użytego modelu. |
| Około 1100 artykułów | Archiwum bloga wykorzystywane jako źródło wiedzy. Zespół przeanalizował również te publikacje, aby wyodrębnić zastosowania produktów i powiązane z nimi zrzuty ekranu. |
| 2–3 artykuły autora | Materiał wyjściowy do opracowania indywidualnych zasad stylu pisania. |
| Aktualizacja co miesiąc | Częstotliwość automatycznego odświeżania zestawienia najszybciej rosnących startupów. |
Praktyczne rady
- Rozpisz dobry proces redakcyjny przed jego automatyzacją. Zdefiniuj zadanie i oczekiwany rezultat każdego etapu. Łącz małe procedury zamiast umieszczać wszystkie wymagania w jednej instrukcji.
- Przenieś wkład eksperta na początek, ale zachowaj kontrolę jakości. Dostarczaj własne obserwacje, przykłady i źródła przed generowaniem. Nie publikuj tekstu, którego poprawności nie potrafisz ocenić.
- Podłącz rzeczywiste dane i uporządkuj wiedzę o produkcie. W prezentacji służyły temu dane z narzędzi, dokument z informacjami produktowymi oraz biblioteka sprawdzonych zastosowań.
- Zapisuj wyniki pośrednie i poprawiaj źródło błędu. Jeśli konspekt prowadzi do słabego artykułu, popraw procedurę jego tworzenia, zamiast za każdym razem naprawiać gotowy tekst.
- Dobieraj format do zadania użytkownika. Aktualizowana tabela, quiz lub proste narzędzie mogą być bardziej użyteczne niż kolejne akapity instrukcji.
Knowledge bombs
1. Pipeline Ahrefs: od keyword researchu do publikacji w ok. 10 minut i za ok. 2 dolary – ale tylko dla treści informacyjnych.
Kluczowe jest zawężenie: system jest dobry w jednej rzeczy (informational search content), nie zastępuje całej produkcji treści, nie służył do zwiększenia częstotliwości publikacji i działa pod nadzorem człowieka, bo nadal zdarzają się słabe artykuły.
„And this is an automated SEO content pipeline that literally runs from keyword research all the way through to publishing an article. It takes about 10 minutes or so to run. It costs about $2 maybe, depending on the model that you use.”
2. Wiele małych skilli połączonych w łańcuch zamiast jednego wielkiego promptu.
Najpierw rozpisz mechanicznie, co robi człowiek tworzący dobry tekst (keyword research, analiza konkurencji, research tematu, szukanie information gain), zamień każdy etap na osobny plik skill, a nadrzędny skill „blog pipeline” wywołuje je w kolejności – wyjście jednego jest wejściem następnego. Ryan poleca do tego skill-creator w Claude i funkcję „record and replay” w Codex.
„don’t cram too much into a single skill file. It’s much better to have a series of smaller, more specific skill files, and then chain them together. The output of one is the input of the next one.”
3. Zasada MECE wpisana w skill do konspektów.
Każdy konspekt (pisany przez człowieka lub maszynę) musi mieć punkty wzajemnie rozłączne i łącznie wyczerpujące temat – i to jest jawnie zapisane w skillu, którym kieruje się AI. W transkrypcji Whisper przekręcił „MECE” na „missing”, ale definicja pada wprost.
„So all the ideas in the article have to be mutually exclusive. There is no overlap between them, but together they are collectively exhaustive.”
4. Człowiek na początku procesu, nie na końcu – i naprawiaj system, nie artykuł.
Zamiast redagować „AI slop” na końcu, Ahrefs ładuje na start kierunek, kontekst, anegdoty i przykłady. Gdy tekst wychodzi zły, nie poprawia się go ręcznie, tylko wraca do etapu pipeline’u, który zawiódł (dlatego zapisują wynik każdego etapu i mogą wznowić proces od danego punktu). Zastrzeżenie: trzeba znać temat – artykuły z obszarów, w których zespół nie potrafi ocenić jakości, są wyrzucane.
„Instead of backloading human involvement in that process, I think it’s much more fruitful to frontload it.”
„the kind of key tenet of content engineering is to stop thinking about individual articles, and start thinking about the systems that make articles.”
5. Information gain na skalę: luki u konkurencji, biblioteka influencerów i wywiady z ekspertami generowane przez AI.
Osobne procesy researchu: narzędzie AI Content Helper szuka tematów nieobecnych w topowych wynikach; biblioteka feedów ekspertów z social mediów dostarcza cytatów; AI generuje pytania, które wysyła się mailem do ekspertów z bazy, by zdobyć unikalne cytaty. Do tego dane z MCP Ahrefs (dane SERP, metryki słów, parent topics, PAA), żeby brief nie był halucynowany.
„With a library of subject matter experts, you can email them questions generated by the AI to get their quotes to add into the article. Those quotes do not exist anywhere else in the world.”
6. Styl autora odtwarzany z 2–3 tekstów, a konkretne przykłady działają lepiej niż abstrakcyjne zasady.
Każdy autor ma własny style guide wygenerowany przez AI z 2–3 jego najlepszych tekstów. Zamiast pisać „pisz z humorem”, daj przykład, kiedy to zrobiłeś – to język, który LLM rozumie. Ta sama metoda działa dla grafik: AI „rozkłada” profesjonalne projekty na reguły (fonty, kolory, layout, logo).
„And another thing we’ve learned, concrete writing examples are much better than abstract principles.”
7. Grafiki generuje kod (biblioteka Pythona), a nie model obrazkowy – dopiero potem „design skill” nadaje im wygląd marki.
Ahrefs ogranicza formaty grafik do tych, które AI robi powtarzalnie dobrze: diagramy przepływu, wykresy i tabele, grafiki z cytatami, zrzuty ekranu. Dzięki generowaniu z kodu są dokładne i spójne.
„This is like a Python library that is using maths to build this, which is why they come out accurate and consistent every time.”
8. Biblioteka przypadków użycia produktu wyciągnięta z 1100 artykułów bloga.
Oprócz prostego dokumentu markdown o produktach (co to jest, ile kosztuje, co robi, linki + przykłady naturalnych wzmianek) zespół zeskrapował wszystkie ok. 1100 artykułów i wyciągnął AI każdy opisany proces użycia produktu wraz ze zrzutami ekranu. Dzięki temu AI ma gotowe, sprawdzone scenariusze, gdy pisze o konkretnym narzędziu.
„we scraped all 1100 pages from our blog, and we used AI, unsurprisingly, to extract every use case.”
9. Interaktywne elementy zamiast kolejnych słów: quiz doboru narzędzi, optymalizator promptów, automatycznie aktualizowany ranking.
Artykuł o najszybciej rosnących startupach aktualizuje się co miesiąc sam (dane z API Ahrefs, nowe firmy, przeliczone wzrosty, wykresy). Do listy narzędzi AI dodają quiz z rekomendacją, do artykułu o optymalizacji promptów – działające narzędzie, osadzane przez iframe. Cel: dłuższy czas na stronie i lepsze zaangażowanie.
„You can build this in Claude Code, or anything you like, and embed it with an iframe in your blog post. Trivial.”
10. Żartobliwy „generator llms.txt” od Ahrefs zawsze odpowiada: nie rób llms.txt.
Ryan zbudował narzędzie, które po wpisaniu dowolnej domeny odpowiada, że llms.txt nie jest potrzebny, powołując się na badania Ahrefs (z nagrania wynika, że plik praktycznie nie jest pobierany) i podaje bardziej wartościowe alternatywy. Dobry argument w dyskusji o „szybkich trikach GEO”.
„And what it does, you put in your domain, it has a little think, and then it says, don’t have an llms.txt. It does nothing, regardless of what domain you’ve entered.”
Zdjęcia: Ryan Law
78 kadrów · Fot. Robert Nowaczyk